ลองนึกถึงสายพานคัดผลไม้ของสหกรณ์ชื่อ FruitLine กล้องถ่ายภาพมะม่วงแต่ละลูก แล้วระบบต้องตอบว่า “ลูกนี้ผ่านมาตรฐานส่งออกหรือไม่” วิธีหนึ่งมองหาลักษณะที่ช่วยแบ่งคำตอบโดยตรง เช่น สี ผิว รอยช้ำ และน้ำหนัก จากนั้นวางเส้นแบ่งระหว่างกลุ่มผ่านกับไม่ผ่าน อีกวิธีพยายามเรียนก่อนว่า “มะม่วงที่ผ่านมาตรฐานมักมีข้อมูลหน้าตาอย่างไร” และ “มะม่วงที่ไม่ผ่านมักเกิดรูปแบบใด” แล้วจึงใช้ภาพรวมเหล่านั้นย้อนกลับมาตัดสินลูกใหม่
วิธีแรกคือสัญชาตญาณของ Discriminative Model หรือโมเดลเชิงแยกแยะ ส่วนวิธีหลังคือสัญชาตญาณของ Generative Model หรือโมเดลเชิงกำเนิด ทั้งสองอาจจำแนกผลไม้ได้เหมือนกัน แต่เรียนคนละสิ่ง ใช้สมมติฐานต่างกัน และพลาดด้วยเหตุผลไม่เหมือนกัน ความต่างจึงไม่ได้อยู่ที่ว่าโมเดลหนึ่ง “ทำนาย” และอีกโมเดล “วาดภาพ” เท่านั้น
บทเรียนนี้จะพา FruitLine เดินผ่านเส้นทางเดียวกันตั้งแต่คำถาม ข้อมูล ความน่าจะเป็น การฝึก การประเมิน ไปจนถึงวันที่กล้องเปลี่ยน แสงในโรงคัดเปลี่ยน และผลไม้จากสวนใหม่มีรูปแบบไม่เหมือนข้อมูลเดิม เป้าหมายคือทำให้คุณมองชื่อโมเดลแล้วถามต่อได้ว่า มันเรียนการแจกแจงใด ต้องมีหลักฐานอะไร และควรเชื่อผลลัพธ์ภายใต้เงื่อนไขไหน
อ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบายความต่างระหว่างการเรียนเส้นแบ่งกับการเรียนการกระจายข้อมูลด้วยตัวอย่างเดียวกันได้
- แปล P(y|x), P(x), P(x|y) และ P(x,y) เป็นภาษาธรรมดาโดยไม่ทำให้ความหมายผิด
- แยก Generative Model ออกจากผลิตภัณฑ์ Generative AI และอธิบายบทบาทของ Naive Bayes, VAE และ GAN ได้
- เลือกข้อมูล Metric และ Failure Test ให้ตรงกับสิ่งที่โมเดลเรียนและต้นทุนความผิดพลาด
- ใช้คำถามห้าข้อเพื่อตัดสินใจว่าจะเริ่มจาก Discriminative, Generative, Hybrid หรือวิธีที่ง่ายกว่า
ภาพจำเริ่มต้น: คนลากเส้นกับคนสร้างแผนที่
สมมติเราวางจุดสีน้ำเงินและสีชมพูบนกระดาษ จุดแต่ละจุดคือมะม่วงหนึ่งลูก ตำแหน่งแนวนอนแทนความหวาน ตำแหน่งแนวตั้งแทนระดับรอยช้ำ สีน้ำเงินคือผ่านมาตรฐาน สีชมพูคือไม่ผ่าน หากเราต้องการตัดสินลูกใหม่ให้เร็วที่สุด เราอาจลากเส้นที่แยกสองกลุ่มออกจากกัน แล้วดูว่าจุดใหม่ตกอยู่ฝั่งไหน นี่คือภาพจำของการเรียนแบบ Discriminative: สนใจขอบเขตที่ช่วยตอบเป้าหมายโดยตรง
อีกคนไม่รีบลากเส้น แต่สร้างแผนที่ว่าจุดสีน้ำเงินมักหนาแน่นตรงไหน กระจายกว้างเพียงใด และจุดสีชมพูมีรูปร่างการกระจายแบบใด เมื่อจุดใหม่เข้ามา เขาถามว่าจุดนี้สอดคล้องกับแผนที่ของกลุ่มใดมากกว่า นี่คือภาพจำของการเรียนแบบ Generative: สนใจโครงสร้างของข้อมูลหรือกระบวนการที่อาจสร้างข้อมูลขึ้นมา
อุปมานี้ช่วยเปิดประตู แต่ไม่ใช่ของจริงทั้งหมด โมเดล Discriminative ไม่จำเป็นต้องวาดเส้นตรง และโมเดล Generative ไม่จำเป็นต้องสร้างภาพให้เราเห็น ขอบเขตอาจโค้งซับซ้อนอยู่ในพื้นที่หลายพันมิติ ส่วนการกระจายอาจเป็นสูตรความน่าจะเป็น เครือข่ายประสาท หรือกระบวนการสุ่มที่ค่อย ๆ สร้างตัวอย่าง สิ่งที่ต้องจำคือ คำถามที่ใช้ฝึก ไม่ใช่รูปทรงที่เราใช้วาดอธิบาย
เส้นแบ่งยังไม่บอกว่าจุดหนึ่ง “เป็นไปได้ในโลกจริง” แค่ไหน หากจุดประหลาดมากแต่อยู่ฝั่งผ่าน ระบบอาจยังตอบว่าผ่านได้ ตรงกันข้าม แผนที่การกระจายพยายามให้ความสำคัญกับความเป็นไปได้ของข้อมูลเอง แต่ต้องเรียนงานที่กว้างกว่าและอาจเสียทรัพยากรไปกับรายละเอียดที่ไม่ช่วยการตัดสินเป้าหมาย นี่คือข้อแลกเปลี่ยนพื้นฐานที่เราจะเห็นซ้ำตลอดบท
กรณีศึกษา: FruitLine ต้องตอบมากกว่าคำว่า “ผ่าน”
FruitLine รับมะม่วงจากหลายสวน กล้องบันทึกภาพ สี รูปร่าง และรอยช้ำ เครื่องชั่งให้ค่าน้ำหนัก เซนเซอร์ให้ค่าความแน่น เจ้าหน้าที่ตรวจตัวอย่างบางส่วนและให้ป้ายกำกับว่า “ผ่านมาตรฐานส่งออก” หรือ “ส่งตลาดภายใน” ในช่วงแรก ทีมมีเป้าหมายชัดคือคัดแยกให้ทันสายพานโดยรักษาอัตราการพลาดผลเสียรุนแรงให้อยู่ในระดับยอมรับได้
ถ้าทีมฝึก Logistic Regression หรือโครงข่ายประสาทให้รับฟีเจอร์แล้วคืนโอกาสผ่านมาตรฐาน โมเดลกำลังเรียนทางลัดจากข้อมูล x ไปยังป้าย y เมื่อได้คะแนน ทีมตั้ง Threshold เช่น มากกว่า 0.8 จึงส่งออก ระหว่าง 0.5–0.8 ให้คนตรวจ และต่ำกว่า 0.5 ส่งตลาดภายใน การใช้งานนี้ต้องสนใจ Precision, Recall, Calibration และปริมาณงานที่ไหลเข้าสู่คิวมนุษย์
แต่ FruitLine ยังมีคำถามอื่น บางวันเซนเซอร์ความแน่นขาดหาย บางสวนส่งพันธุ์ใหม่ที่ไม่เคยเห็น และบางล็อตมีจุดข้อมูลที่ดูไม่เหมือนทั้งกลุ่มผ่านและไม่ผ่าน ทีมจึงอยากเรียนภาพรวมของข้อมูลแต่ละกลุ่ม เพื่อเติมค่าที่หาย ตรวจความผิดปกติ หรือสร้างตัวอย่างสมมติสำหรับทดสอบระบบ งานเหล่านี้เอนไปทางโมเดลเชิงกำเนิดมากขึ้น แม้ผลปลายทางบางครั้งยังเป็นการจำแนก
เส้นเรื่องนี้ทำให้เห็นว่าคำว่า Generative ไม่ได้แปลว่า FruitLine ต้องสร้าง “ภาพมะม่วงสวย ๆ” เสมอไป โมเดลเชิงกำเนิดอาจไม่แสดงสื่อให้ผู้ใช้เลย แต่ช่วยคำนวณว่าข้อมูลหนึ่งมีความเป็นไปได้ภายใต้แต่ละกลุ่มเท่าไร หรือช่วยค้นว่าตัวอย่างใดอยู่นอกการกระจายเดิม ส่วนโมเดล Discriminative อาจอยู่ในระบบสร้างเนื้อหาได้ เช่น Discriminator ใน GAN หรือโมเดลจัดอันดับที่เลือกคำตอบของระบบ Generative AI
ก่อนเลือกโมเดล FruitLine จึงต้องเขียนสัญญาของระบบให้ชัด: อินพุตมาจากไหน ป้ายถูกสร้างอย่างไร เอาต์พุตถูกใช้ตัดสินอะไร ความผิดแบบใดแพง ใครตรวจข้อก้ำกึ่ง และระบบจะหยุดเมื่อข้อมูลเปลี่ยนอย่างไร หากข้ามคำถามเหล่านี้ ต่อให้เลือกตระกูลโมเดลถูก ชิ้นงานก็ยังล้มเหลวในโลกจริงได้
กลไก Discriminative Model: เรียนคำตอบโดยตรง
ให้ x แทนข้อมูลของมะม่วง เช่น สี น้ำหนัก รอยช้ำ และความแน่น ให้ y แทนป้ายผ่านหรือไม่ผ่าน โมเดล Discriminative แบบน่าจะเป็นพยายามประมาณ P(y|x) หรือ “เมื่อเห็นข้อมูลชุดนี้ โอกาสเป็นแต่ละป้ายเท่าไร” ส่วนบางวิธีไม่เขียนความน่าจะเป็นชัดเจน แต่เรียนฟังก์ชันตัดสินหรือคะแนนที่แยกกลุ่มได้โดยตรง
ระหว่างฝึก โมเดลรับตัวอย่างพร้อมป้าย เปรียบเทียบคำตอบกับป้ายที่ถือเป็น Ground Truth คำนวณ Loss แล้วปรับพารามิเตอร์ให้ความผิดลดลง ตัวอย่างที่อยู่ไกลจากเส้นแบ่งมักตอบง่าย ส่วนตัวอย่างใกล้ขอบเขต รอยช้ำไม่ชัด หรือมีสัญญาณขัดกันจะกดดันให้โมเดลปรับขอบเขต การฝึกไม่ได้ทำให้โมเดล “เข้าใจมะม่วง” แบบมนุษย์ แต่ทำให้พารามิเตอร์เหมาะกับเกณฑ์ที่ข้อมูลและ Loss กำหนด
ข้อดีคือทรัพยากรถูกใช้กับเป้าหมายที่เราต้องการ หากโจทย์คือผ่านหรือไม่ผ่าน โมเดลไม่ต้องเรียนทุกวิธีที่ภาพมะม่วงอาจเกิดขึ้น จึงมักให้ผลดีเมื่อมีข้อมูลติดป้ายเพียงพอ ป้ายมีคุณภาพ และสภาพใช้งานใกล้กับข้อมูลฝึก โมเดลยังสามารถขยายไปสู่งาน Regression เช่น ประมาณจำนวนวันเก็บรักษา หรือ Ranking เช่น เรียงล็อตที่ควรตรวจซ้ำก่อน
อย่างไรก็ตาม คะแนนจากโมเดลไม่จำเป็นต้องเป็นความน่าจะเป็นที่เชื่อถือได้ แม้หน้าจอแสดง 0.9 ก็ไม่ได้รับประกันว่าในมะม่วงหนึ่งร้อยลูกที่ได้คะแนนใกล้ 0.9 จะผ่านจริงประมาณเก้าสิบลูกเสมอ เราต้องตรวจ Calibration บนข้อมูลที่เป็นตัวแทนและติดตามเมื่อสภาพเปลี่ยน การตั้ง Threshold จึงเป็นการตัดสินใจเชิงระบบ ไม่ใช่เพียงนำค่าที่โมเดลคืนมาใช้ทันที
อีกข้อจำกัดคือโมเดลอาจใช้ทางลัดที่สัมพันธ์กับป้ายในข้อมูลฝึก เช่น ฉากหลังของสวนหนึ่ง กล้องตัวหนึ่ง หรือสติกเกอร์บนลัง หากสวนที่มะม่วงดีใช้ฉากสีเฉพาะ โมเดลอาจเรียนฉากแทนคุณภาพ เมื่อเปลี่ยนกล้องหรือสายพาน ผลลัพธ์จึงตกแม้ Accuracy ตอนทดสอบเดิมสูง การตรวจ Slice, Counterfactual และ Shift จึงสำคัญพอ ๆ กับค่าเฉลี่ย
กลไก Generative Model: เรียนว่าข้อมูลเกิดอย่างไร
โมเดล Generative พยายามเรียนการกระจายของข้อมูล หากไม่มีป้าย อาจเรียน P(x) ว่าข้อมูลมะม่วงโดยรวมมีรูปแบบใด หากมีป้าย อาจเรียน P(x|y) ว่ามะม่วงภายใต้แต่ละกลุ่มมีหน้าตาอย่างไร และใช้ P(y) หรือสัดส่วนของแต่ละกลุ่มประกอบกันเป็น P(x,y) การเรียนที่กว้างกว่านี้ทำให้โมเดลตอบคำถามอื่นนอกจากแยกป้ายได้ในบางชนิด
ในกรณี Naive Bayes ทีมอาจประมาณว่าค่าความหวาน รอยช้ำ และความแน่นมีการกระจายอย่างไรเมื่อมะม่วงผ่าน และมีการกระจายอย่างไรเมื่อไม่ผ่าน เมื่อมะม่วงลูกใหม่เข้ามา โมเดลคำนวณความสอดคล้องกับแต่ละกลุ่มแล้วใช้กฎของ Bayes เปลี่ยนกลับเป็นโอกาสของป้าย วิธีนี้เรียกว่า Generative Classifier เพราะสร้างแบบจำลองข้อมูลร่วมกับป้ายก่อนจำแนก
คำว่า “สร้าง” จึงหมายถึงโมเดลมีภาพของการเกิดข้อมูล ไม่ได้หมายความว่าผู้ใช้ต้องกดปุ่มแล้วได้ภาพเสมอ หากแบบจำลองอนุญาตให้สุ่ม เราอาจสร้างตัวอย่างใหม่ เติมข้อมูลที่หาย หรือวัดว่าตัวอย่างหนึ่งพบได้ยากเพียงใด แต่ความสามารถเหล่านี้ขึ้นกับตระกูลโมเดล วิธีฝึก และคุณภาพของการประมาณการกระจาย ไม่ใช่คุณสมบัติอัตโนมัติของทุกโมเดลที่ติดป้ายว่า Generative
งานที่กว้างขึ้นมาพร้อมภาระ โมเดลต้องจับรายละเอียดของ x ที่อาจไม่จำเป็นต่อการตัดสิน y ถ้าสมมติฐานของการกระจายผิด เช่น Naive Bayes สมมติฟีเจอร์เป็นอิสระแบบมีเงื่อนไขทั้งที่สีและความสุกสัมพันธ์กันมาก ค่าความน่าจะเป็นอาจคลาดเคลื่อน โมเดลที่ซับซ้อนกว่าแก้สมมติฐานบางส่วนได้ แต่เพิ่มข้อมูล คอมพิวต์ และความยากในการวิเคราะห์ Failure Mode
การสร้างตัวอย่างสวยไม่ได้พิสูจน์ว่าโมเดลครอบคลุมการกระจายจริง อาจมี Mode Collapse ที่สร้างเพียงรูปแบบยอดนิยม ละเลยมะม่วงบางพันธุ์ หรือสร้างรายละเอียดที่ดูน่าเชื่อแต่ไม่สอดคล้องกับชีววิทยา หากใช้ข้อมูลสังเคราะห์ฝึกตัวจำแนก ต้องตรวจว่าความหลากหลายและความสัมพันธ์สำคัญถูกเก็บไว้ ไม่ใช่ดูเพียงความสวยของภาพ
อ่าน P(y|x), P(x), P(x|y) และ P(x,y) เป็นภาษาคน
P(y|x) อ่านว่า “เมื่อเห็นข้อมูล x แล้ว ป้าย y มีโอกาสเท่าไร” สำหรับ FruitLine คือเมื่อเห็นสี น้ำหนัก และรอยช้ำของลูกนี้แล้ว โอกาสผ่านมาตรฐานเท่าไร เครื่องหมายเส้นตั้งอ่านว่า “เมื่อทราบว่า” จึงไม่ใช่เครื่องหมายหาร และไม่ควรสลับด้านโดยไม่คิด เพราะคำถามจะเปลี่ยนทันที
P(x|y) อ่านว่า “ถ้ารู้ว่าป้ายเป็น y แล้ว ข้อมูล x มักมีรูปแบบอย่างไร” เช่น ในกลุ่มที่ผ่านมาตรฐาน ระดับความหวานและรอยช้ำกระจายอย่างไร นี่เป็นภาพของข้อมูลภายในแต่ละคลาส ส่วน P(y) คือโอกาสพื้นฐานหรือสัดส่วนก่อนเห็นข้อมูล เช่น ในฤดูกาลนี้มะม่วงประมาณเจ็ดในสิบผ่านมาตรฐาน
P(x,y) คือโอกาสที่ข้อมูลและป้ายเกิดร่วมกัน เราสามารถเขียนเป็น P(x|y)P(y) ได้ เมื่อมีภาพร่วมนี้ กฎของ Bayes ช่วยคำนวณกลับไปยัง P(y|x) โดยเปรียบเทียบว่าข้อมูลลูกใหม่สอดคล้องกับแต่ละกลุ่มเพียงใด แล้วปรับด้วยสัดส่วนพื้นฐาน นี่เป็นสะพานจาก “แผนที่การเกิดข้อมูล” กลับสู่ “คำตอบว่าควรอยู่กลุ่มไหน”
P(x) คือความเป็นไปได้ของข้อมูลโดยไม่สนป้าย ในเชิงคำนวณมันทำหน้าที่เป็นตัวปรับให้ผลรวมของความน่าจะเป็นหลังเห็นข้อมูลสมเหตุผล สำหรับผู้เริ่มต้นให้จำว่า P(x) ถามว่า “ข้อมูลแบบนี้พบได้มากน้อยเพียงใดในโลกที่โมเดลเรียน” โมเดล Generative แบบไม่มีป้ายมักมุ่งเรียนส่วนนี้เพื่อสร้างหรือให้คะแนนตัวอย่าง
ข้อควรระวังคือความน่าจะเป็นทั้งหมดอ้างอิงโลกที่ข้อมูลและสมมติฐานสร้างขึ้น หากข้อมูลฝึกมาจากสวนเพียงสองแห่ง ค่าที่คำนวณไม่ใช่กฎธรรมชาติของมะม่วงทุกสวน หากฤดูกาล สายพันธุ์ กล้อง หรือเกณฑ์ผ่านเปลี่ยน การแจกแจงก็เปลี่ยนตาม สูตรที่ถูกต้องทางคณิตศาสตร์ยังให้คำตอบใช้การไม่ได้เมื่อฐานข้อมูลไม่แทนโลกปัจจุบัน
คำถามของ AIKO: โมเดลกำลังตอบ “เมื่อเห็นข้อมูลแล้วควรเลือกป้ายใด” หรือกำลังเรียน “ข้อมูลแต่ละแบบเกิดขึ้นได้อย่างไร” ถ้าตอบข้อนี้ได้ สมการจะเริ่มมีความหมายแทนที่จะเป็นสัญลักษณ์ให้ท่องจำ
ตัวอย่างโมเดล: ชื่อเดียวไม่เล่าเรื่องทั้งหมด
Logistic Regression เป็นตัวอย่าง Discriminative Model ที่ประมาณโอกาสของป้ายจากฟีเจอร์โดยตรง จุดแข็งคือโครงสร้างค่อนข้างตรงไปตรงมา ฝึกเร็ว และอธิบายทิศทางของน้ำหนักได้ภายใต้ข้อจำกัดของโมเดล แต่เส้นแบ่งพื้นฐานเป็นเชิงเส้น หากความสัมพันธ์ซับซ้อนต้องสร้างฟีเจอร์หรือใช้โมเดลที่ยืดหยุ่นขึ้น
Support Vector Machine มุ่งหาเส้นแบ่งที่มีระยะห่างจากตัวอย่างใกล้ขอบมากที่สุด และใช้ Kernel เพื่อสร้างขอบเขตไม่เชิงเส้นได้ ส่วน Conditional Random Field เรียนความสัมพันธ์แบบมีเงื่อนไขสำหรับป้ายที่ต่อเนื่องกัน เช่น การติดป้ายคำในประโยค ทั้งสองมักจัดอยู่ฝั่ง Discriminative เพราะมุ่งคำตอบหรือโครงสร้างป้ายเมื่อเห็นข้อมูล
Naive Bayes เป็น Generative Classifier แบบคลาสสิก เรียนการแจกแจงฟีเจอร์ภายใต้แต่ละคลาสและ Prior แล้วใช้ Bayes จำแนก แม้สมมติฐาน “อิสระแบบมีเงื่อนไข” ดูง่ายเกินจริง แต่วิธีนี้อาจทำงานดีในบางโดเมน โดยเฉพาะเมื่อข้อมูลไม่มากและฟีเจอร์มีโครงสร้างเหมาะสม ผลที่ดีไม่แปลว่าสมมติฐานทุกข้อเป็นจริง แต่แปลว่าความผิดของสมมติฐานยังไม่ทำลายงานภายใต้ข้อมูลนั้น
Gaussian Mixture Model เรียนว่าข้อมูลอาจมาจากหลายกลุ่มการกระจาย ใช้จัดกลุ่มหรือให้คะแนนความเป็นไปได้ได้ Variational Autoencoder หรือ VAE เรียนตัวแปรแฝงพร้อมตัวถอดรหัสเพื่อประมาณกระบวนการสร้างข้อมูล และเพิ่มข้อกำหนดให้พื้นที่แฝงมีโครงสร้างที่สุ่มตัวอย่างได้ เป้าหมายไม่ใช่แค่บีบอัด แต่สร้างกรอบความน่าจะเป็นสำหรับข้อมูลและตัวแปรแฝง
Generative Adversarial Network หรือ GAN มี Generator สร้างตัวอย่างและ Discriminator แยกข้อมูลจริงออกจากข้อมูลที่ Generator สร้าง ทั้งสองฝึกผ่านเกมแข่งขันกัน Discriminator เป็นโมเดลแยกแยะที่ทำหน้าที่ให้สัญญาณฝึก ส่วนระบบรวมมีเป้าหมายเชิงกำเนิด ตัวอย่างนี้เตือนว่า Generative และ Discriminative ไม่ใช่สองค่ายที่ห้ามอยู่ร่วมกัน
โมเดลภาษาแบบ Autoregressive เรียนความน่าจะเป็นของ Token ถัดไปภายใต้ Token ก่อนหน้า เมื่อนำมาสุ่มต่อเนื่องจึงสร้างข้อความใหม่ได้ ในระดับโมเดลมันเป็น Generative Model แต่ผลิตภัณฑ์ Generative AI รอบโมเดลยังประกอบด้วย Prompt, Retrieval, Filter, Policy, Tool และ Human Review เราต้องแยกระดับโมเดลออกจากระดับระบบ มิฉะนั้นจะอธิบายความเสี่ยงและความรับผิดชอบไม่ครบ
เปรียบเทียบทีละมิติ
| มิติ | Discriminative Model | Generative Model |
|---|---|---|
| คำถามหลัก | เมื่อเห็นข้อมูลแล้วควรตอบอะไร | ข้อมูลหรือข้อมูลร่วมกับป้ายเกิดอย่างไร |
| สิ่งที่เรียน | P(y|x) หรือฟังก์ชัน/เส้นแบ่งโดยตรง | P(x), P(x|y) หรือ P(x,y) ตามชนิดงาน |
| ข้อมูลที่มักใช้ | ตัวอย่างพร้อม Target หรือป้ายสำหรับงานปลายทาง | ข้อมูลดิบ หรือข้อมูลพร้อมป้ายและสมมติฐานการกระจาย |
| งานเด่น | จำแนก ถดถอย จัดอันดับ ตรวจจับ | สร้างตัวอย่าง เติมข้อมูล ตัวแปรแฝง ตรวจความผิดปกติ และจำแนกบางกรณี |
| ข้อดี | มุ่งตรงสู่งานปลายทาง ประเมิน Target ได้ชัด | ได้แบบจำลองข้อมูลที่นำไปตอบหลายคำถามหรือใช้กับข้อมูลไม่มีป้ายได้บางวิธี |
| ข้อจำกัด | อาจไม่รู้ว่าข้อมูลใหม่แปลกจากโลกฝึก และใช้ทางลัด | ต้องเรียนงานกว้างกว่า สมมติฐานผิดได้ และประเมินการครอบคลุมยาก |
| หลักฐานความสำเร็จ | Metric งานปลายทาง Calibration ผลแยกกลุ่ม และต้นทุนหลัง Threshold | Likelihood หรือ Proxy, คุณภาพ ความหลากหลาย Coverage และประโยชน์ในงานปลายทาง |
| ตัวอย่าง | Logistic Regression, SVM, CRF, ตัวจำแนกโครงข่ายประสาท | Naive Bayes, GMM, VAE, GAN, Autoregressive Model |
ตารางนี้เป็นแผนที่ ไม่ใช่บัญชีตายตัว โมเดลหนึ่งอาจมีหลายวัตถุประสงค์ วิธีฝึกอาจผสม Loss และระบบจริงอาจนำหลายโมเดลมาต่อกัน การจัดหมวดช่วยให้ตั้งคำถามได้ดีขึ้น แต่ไม่ควรใช้แทนการอ่านวิธีฝึก อินพุต เอาต์พุต และหลักฐานของรุ่นที่กำลังใช้อยู่
ข้อมูลและหลักฐาน: ป้ายที่เห็นอาจไม่ใช่ความจริงทั้งหมด
FruitLine ต้องนิยามก่อนว่า “ผ่านมาตรฐาน” หมายถึงอะไร หากเจ้าหน้าที่แต่ละคนใช้เกณฑ์ต่างกัน ป้ายจะมี Label Noise โมเดล Discriminative อาจเรียนความไม่สม่ำเสมอของผู้ตรวจ ส่วนโมเดล Generative Classifier จะเรียนการกระจายที่ปนกัน ปัญหานี้แก้ไม่ได้ด้วยโมเดลใหญ่ขึ้นเพียงอย่างเดียว ต้องมีคู่มือการติดป้าย การวัดความเห็นพ้อง และทางจัดการกรณีไม่แน่ใจ
Sampling สำคัญไม่แพ้ป้าย หากเก็บข้อมูลเฉพาะมะม่วงที่มาถึงปลายสายพาน เราอาจไม่เห็นผลไม้ที่ถูกคัดทิ้งก่อนหน้า หากข้อมูลฝึกมีสวนขนาดใหญ่เป็นส่วนใหญ่ โมเดลอาจทำงานไม่ดีกับสวนเล็ก การสุ่มตัวอย่างต้องครอบคลุมฤดูกาล พันธุ์ กล้อง กะการทำงาน และสภาพที่ระบบจะพบจริง รวมถึงเก็บ Metadata ที่จำเป็นต่อการวิเคราะห์ Shift โดยไม่เก็บข้อมูลเกินความจำเป็น
การแบ่ง Train, Validation และ Test ต้องกันการรั่วไหล หากภาพของมะม่วงลูกเดียวกันหรือมาจากล็อตเดียวกันกระจายอยู่ทั้ง Train และ Test คะแนนจะดูสูงเกินจริง เพราะโมเดลเห็นรูปแบบใกล้เคียงมาก่อน วิธีที่เหมาะอาจแบ่งตามล็อต สวน หรือช่วงเวลา เพื่อเลียนแบบคำถามจริงว่าโมเดลทำงานกับผลผลิตใหม่ได้หรือไม่
สำหรับ Generative Model การประเมินข้อมูลยากขึ้น เพราะเราไม่ได้ถามเพียงว่าป้ายถูกหรือผิด ต้องตรวจว่าตัวอย่างที่สร้างครอบคลุมกลุ่มหายากหรือไม่ รักษาความสัมพันธ์ที่สำคัญหรือไม่ มีข้อมูลส่วนบุคคลหรือข้อมูลฝึกหลุดออกมาหรือไม่ และช่วยงานปลายทางจริงหรือเปล่า ตัวชี้วัด Proxy ค่าเดียวไม่ควรแทนการตรวจหลายมิติ
Data Documentation ช่วยให้ทีมจำได้ว่าข้อมูลมาจากไหน เก็บเมื่อใด ใครให้ป้าย มีข้อจำกัดใด และไม่ควรใช้ในบริบทไหน เมื่อเกิดปัญหา เอกสารนี้ทำให้ย้อนรอยได้ว่าความผิดมาจากแหล่งข้อมูล การแปลงฟีเจอร์ สมมติฐานโมเดล หรือการตั้ง Threshold หากไม่มี Trace ทีมอาจแก้โมเดลทั้งที่ปัญหาอยู่ที่กล้องหรือกระบวนการปฏิบัติงาน
ประเมินให้ตรงงาน: โมเดลสองแบบต้องมีคำถามต่างกัน
สำหรับตัวจำแนก FruitLine ค่า Accuracy บอกสัดส่วนคำตอบถูกทั้งหมด แต่ซ่อนทิศทางความผิด หากการปล่อยผลไม้เสียไปส่งออกมีต้นทุนสูง เราต้องดู Recall ของกลุ่มไม่ผ่านหรือ False Negative Rate หากการคัดมะม่วงดีทิ้งสร้างความเสียหายต่อเกษตรกร ต้องดู False Positive ในความหมายของระบบให้ชัด และระบุเมทริกซ์ความสับสนพร้อมชื่อกลุ่ม ไม่ใช้คำบวก/ลบอย่างกำกวม
Precision และ Recall ต้องอ่านร่วมกับ Base Rate เมื่อสัดส่วนผลไม้เสียเปลี่ยน ค่าบางตัวเปลี่ยนแม้โมเดลเดิม การเลือก Threshold ต้องคำนวณจำนวนลูกที่ส่งให้คนตรวจ เวลาในสายพาน และความเสียหายแต่ละทิศ ไม่ควรเลือกค่าที่ทำให้กราฟสวยที่สุดโดยไม่ดูผลต่อคนและการดำเนินงาน
Calibration ถามว่าคะแนนสอดคล้องกับความถี่จริงหรือไม่ หากกลุ่มคะแนน 0.8 ผ่านจริงเพียงครึ่งเดียว คะแนนนั้นไม่ควรถูกใช้เป็นความเสี่ยงตรง ๆ การตรวจ Reliability Diagram และ Brier Score บนข้อมูลแยกช่วงเวลาเป็นวิธีหนึ่ง แต่ Calibration อาจเสื่อมเมื่อฤดูกาลหรืออุปกรณ์เปลี่ยน จึงต้องติดตามหลังใช้งาน
สำหรับ Generative Model เราอาจดู Log-likelihood หรือ Bound ตามชนิดโมเดล แต่ค่าดังกล่าวไม่รับรองคุณภาพที่มนุษย์เห็นเสมอไป การสร้างภาพอาจต้องตรวจ Fidelity และ Diversity พร้อมกัน หากภาพสมจริงแต่มีเพียงไม่กี่รูปแบบ โมเดลอาจเกิด Mode Collapse หากหลากหลายแต่ผิดกฎของโดเมน ก็ยังใช้สร้างข้อมูลฝึกไม่ได้
การประเมินที่แข็งแรงควรมีสามชั้น ชั้นแรกตรวจส่วนประกอบ เช่น การแจกแจงหรือคุณภาพตัวอย่าง ชั้นที่สองตรวจงานปลายทาง เช่น เมื่อนำข้อมูลสังเคราะห์ไปเพิ่มชุดฝึก ตัวจำแนกบนข้อมูลจริงดีขึ้นหรือแย่ลง ชั้นที่สามตรวจระบบจริง เช่น เวลาตอบ ภาระมนุษย์ ความเสถียร ความเป็นส่วนตัว และผลต่อกลุ่มผู้มีส่วนได้ส่วนเสีย
ผลจาก Offline Test ยังไม่ใช่ใบอนุญาตให้ปล่อยอัตโนมัติ FruitLine ควรเริ่ม Shadow Mode ให้โมเดลให้คำตอบแต่ไม่ควบคุมสายพาน เปรียบเทียบกับกระบวนการเดิม แล้วค่อยทดลองแบบจำกัดขอบเขต มี Stop Rule เช่น หยุดเมื่อ Missing Rate สูง เมื่อ Calibration หลุดกรอบ หรือเมื่อตัวอย่างนอกการกระจายเพิ่มขึ้นเกินเกณฑ์
ไม่มีผู้ชนะถาวร: ข้อแลกเปลี่ยนขึ้นกับคำถามและข้อมูล
งานของ Andrew Ng และ Michael Jordan เปรียบเทียบ Logistic Regression กับ Naive Bayes ภายใต้กรอบเฉพาะ และพบภาพสองช่วง: Generative Classifier อาจเข้าใกล้ค่าความผิดพลาดปลายทางของตนได้เร็วกว่าเมื่อข้อมูลยังไม่มาก ขณะที่ Discriminative Classifier อาจมีค่าความผิดพลาดปลายทางต่ำกว่าเมื่อข้อมูลมากพอ ข้อค้นพบนี้ไม่ใช่กฎว่า Naive Bayes ชนะเมื่อข้อมูลน้อยทุกกรณี แต่ชี้ว่าความเร็วในการเรียนและระดับผลลัพธ์ปลายทางเป็นคนละมิติ
หาก FruitLine มีป้ายคุณภาพสูงจำนวนมากและงานปลายทางคือจำแนกชัดเจน โมเดล Discriminative อาจเป็นจุดเริ่มที่ตรงกว่า หากมีข้อมูลไม่มีป้ายจำนวนมาก ต้องเติมข้อมูลที่หาย หรือสนใจโครงสร้างของข้อมูล โมเดล Generative อาจเปิดทางเลือกเพิ่ม แต่ต้องพิสูจน์ประโยชน์บนงานจริง ไม่ใช่เลือกเพราะชื่อฟังทันสมัย
ความเรียบง่ายมีคุณค่า Logistic Regression ที่ติดตามได้อาจเหมาะกว่าโมเดลลึกหากผลต่างเล็กแต่ต้นทุนดูแลต่างมาก ในทางกลับกัน สมมติฐานง่ายของ Naive Bayes อาจให้ Baseline ที่ดีและทำให้เห็นว่าฟีเจอร์ใดมีปัญหา การเริ่มจาก Baseline ไม่ได้แปลว่าปฏิเสธเทคโนโลยีใหม่ แต่สร้างจุดอ้างอิงเพื่อพิสูจน์ว่าความซับซ้อนเพิ่มคุณค่าจริง
ต้นทุนต้องรวมตลอดวงจรชีวิต ไม่ใช่ค่า Train เพียงครั้งเดียว ได้แก่ การเก็บและติดป้ายข้อมูล การปรับระบบเมื่อกล้องเปลี่ยน การ Monitor Shift การสอบสวน Incident การตรวจข้อมูลสังเคราะห์ และเวลาของผู้เชี่ยวชาญ หากโมเดลกว้างขึ้นแต่ทีมไม่มีวิธีตรวจความล้มเหลว ความยืดหยุ่นที่เพิ่มอาจกลายเป็นหนี้ทางเทคนิค
เมื่อโมเดลพลาด: หกเหตุการณ์ที่ป้ายชื่อไม่ช่วยเรา
1. ทางลัดจากฉากหลัง
ข้อมูลฝึกบังเอิญให้มะม่วงจากสวน A อยู่บนถาดสีน้ำเงินและสวน B อยู่บนถาดสีเทา ตัวจำแนกจึงใช้สีถาดแทนรอยช้ำ คะแนน Test สูงเพราะการแบ่งข้อมูลสุ่มทำให้ถาดเดิมปรากฏทั้งสองชุด วิธีตรวจคือแบ่งตามสวนหรืออุปกรณ์ สลับฉากหลัง และใช้ Counterfactual เปลี่ยนเฉพาะถาด หากคำตอบเปลี่ยนมาก ระบบยังไม่เรียนสิ่งที่เราตั้งใจ
2. การแจกแจงเปลี่ยนตามฤดูกาล
ฤดูฝนทำให้สีผิวและความชื้นต่างจากฤดูร้อน ทั้ง Discriminative และ Generative Model อาจเสื่อม แต่แสดงอาการต่างกัน ตัวจำแนกอาจมั่นใจผิด ส่วนโมเดลการกระจายอาจให้ Likelihood ต่ำกับข้อมูลจำนวนมาก ทีมต้องติดตาม Input Drift, Performance Drift และอัตราตัวอย่างที่ส่งให้คนตรวจ ไม่ควรรอจนลูกค้าร้องเรียน
3. ป้ายเปลี่ยนความหมาย
มาตรฐานส่งออกประเทศปลายทางแก้เกณฑ์รอยช้ำ ป้าย “ผ่าน” ปีนี้ไม่เท่ากับปีก่อน นี่คือ Concept Drift ที่แก้ด้วยการเพิ่มข้อมูลแบบเดิมอย่างเดียวไม่ได้ ต้อง Version เกณฑ์ ป้าย และโมเดล พร้อมบันทึกว่าคำตัดสินใดใช้กฎรุ่นไหน มิฉะนั้นทีมอาจผสมข้อมูลที่ตอบคนละคำถาม
4. โมเดลเชิงกำเนิดละเลยกลุ่มหายาก
ข้อมูลส่วนใหญ่เป็นมะม่วงพันธุ์ยอดนิยม โมเดลสร้างตัวอย่างสวยแต่ไม่ครอบคลุมพันธุ์ท้องถิ่น เมื่อนำข้อมูลสังเคราะห์ไปฝึก ตัวจำแนกดูดีโดยเฉลี่ยแต่แย่กับสวนเล็ก วิธีตรวจคือวัด Coverage และคุณภาพแยกกลุ่ม เปรียบเทียบกับข้อมูลจริงที่กันไว้ และห้ามใช้การตรวจด้วยตาเพียงไม่กี่ตัวอย่างแทนการวิเคราะห์ระบบ
5. Likelihood สูงแต่ไม่เหมาะกับงาน
โมเดลอาจให้ความเป็นไปได้สูงกับภาพพื้นผิวที่พบทั่วไป แต่สิ่งที่ FruitLine สนใจคือรอยโรคขนาดเล็กที่มีต้นทุนสูง การเรียนภาพรวมข้อมูลไม่ได้รับประกันว่าจะเน้นสัญญาณปลายทาง จึงต้องทดสอบ Utility ว่า Representation หรือตัวอย่างที่สร้างช่วยตรวจรอยโรคจริงหรือไม่ ไม่ใช้ Likelihood เป็นหลักฐานเพียงตัวเดียว
6. ระบบผสมส่งต่อความผิด
โมเดล Generative เติมค่าความแน่นที่หาย แล้วตัวจำแนกใช้ค่าที่เติมให้คะแนน หากการเติมผิดแต่ไม่แสดงธง ตัวจำแนกอาจมั่นใจเกินจริง ความผิดของส่วนแรกถูกซ่อนในผลลัพธ์สุดท้าย ทางแก้คือเก็บ Provenance ของค่าที่เติม ประเมินแต่ละส่วนและ End-to-End แยกสถานะข้อมูลจริงกับข้อมูลประมาณ และกำหนดว่ากรณีใดต้องส่งคนตรวจ
หกเหตุการณ์นี้ชี้ว่า “เลือกตระกูลโมเดลถูก” ยังไม่พอ เราต้องออกแบบ Test ที่พยายามทำให้สมมติฐานล้ม ตรวจกลุ่มหายาก จำลองการเปลี่ยนสภาพ และเตรียมทางหยุด โมเดลที่ดีในชุดทดสอบคงที่อาจไม่ปลอดภัยในกระบวนการที่เปลี่ยนทุกวัน
ระบบผสม และเหตุใด Generative Model ไม่เท่ากับ Generative AI
FruitLine อาจใช้ระบบผสม: กฎตรวจว่าเซนเซอร์ครบหรือไม่ โมเดล Generative เติมค่าที่หายพร้อมช่วงความไม่แน่นอน ตัวจำแนก Discriminative ให้คะแนนผ่าน ระบบตรวจ Out-of-distribution ส่งกรณีแปลกให้ผู้เชี่ยวชาญ และ Dashboard อธิบายหลักฐานแก่เจ้าหน้าที่ ความสำเร็จมาจากการแบ่งหน้าที่ ไม่ใช่บังคับโมเดลเดียวทำทุกอย่าง
GAN เป็นตัวอย่างระดับโมเดลที่มี Generator และ Discriminator ร่วมฝึก แม้ชื่อระบบเป็น Generative แต่ส่วน Discriminator เรียนแยกจริงกับสร้าง ส่วนผลิตภัณฑ์ Generative AI อย่างแชตบอตอาจมีตัวจำแนกความปลอดภัย ตัวจัดอันดับ และตัวตรวจข้อมูลส่วนบุคคลอยู่รอบโมเดลภาษา จึงไม่ควรเทียบ Discriminative Model กับ Generative AI แบบหนึ่งต่อหนึ่ง เพราะเป็นคนละระดับของคำอธิบาย
ให้แยกสามระดับเสมอ ระดับแรกคือ Objective โมเดลถูกฝึกให้ลด Loss อะไร ระดับสองคือ Model รับอะไร คืนอะไร และแทนการแจกแจงใด ระดับสามคือ System มี Retrieval, Rule, Permission, Interface และคนอยู่ตรงไหน คำว่า Generative อาจถูกใช้ต่างระดับ หากไม่ระบุระดับ การอภิปรายจะดูขัดแย้งทั้งที่พูดคนละเรื่อง
ระบบผสมต้องมี Interface Contract ทุกส่วนควรรู้ชนิดข้อมูล หน่วย ช่วงค่า เวอร์ชัน และความหมายของ Missing Value หากส่วน Generative คืนค่าประมาณ ต้องแนบ Confidence หรือธงแหล่งที่มา หากส่วน Discriminative เปลี่ยน Threshold ต้องวัดผลต่อคิวมนุษย์ การเชื่อมโมเดลหลายตัวโดยไม่มีสัญญาทำให้ Cascading Error ตรวจยากกว่าระบบเดี่ยว
ความรับผิดชอบยังอยู่กับคนและองค์กร โมเดลไม่รู้ว่าการคัดมะม่วงผิดกระทบรายได้เกษตรกรอย่างไร ทีมต้องกำหนดสิทธิ์อุทธรณ์ การสุ่มตรวจ การเก็บ Log และการสอบสวนผลกระทบ หากการตัดสินมีเดิมพันสูง ควรใช้โมเดลเป็นหลักฐานประกอบ ไม่ใช่ผู้ตัดสินสุดท้ายโดยอัตโนมัติจนกว่าจะมีหลักฐานเพียงพอ
เกณฑ์เลือกใช้: ถามห้าข้อก่อนถามชื่อโมเดล
ต้องการป้าย คะแนน ค่าอันดับ หรือการแจกแจง ตัวอย่างใหม่ การเติมข้อมูล และตัวแปรแฝง หากต้องการคำตอบจำเพาะ ให้เริ่มประเมิน Discriminative Baseline หากต้องเรียนโลกของข้อมูลเพื่อหลายงาน จึงพิจารณา Generative
มีป้ายคุณภาพสูงมากน้อยเพียงใด มีข้อมูลไม่มีป้ายหรือไม่ ใครกำหนด Ground Truth และกรณีไม่แน่ใจถูกบันทึกอย่างไร ข้อมูลที่ไม่มีคำตอบจริงไม่ควรถูกนำไปอ้างว่าโมเดลถูกต้อง
แยก False Positive, False Negative, การสร้างข้อมูลผิด การละเลยกลุ่มหายาก และความมั่นใจเกินจริง กำหนด Metric, Slice และ Threshold ตามความเสียหาย ไม่เลือกจากค่าเฉลี่ยสูงสุด
ระบุกล้อง ฤดูกาล พันธุ์ ผู้ให้ป้าย และกฎธุรกิจที่อาจเปลี่ยน วาง Monitoring, Shadow Test, Stop Rule และแผน Retrain ก่อนเปิดระบบ ไม่รอให้ Drift เกิดแล้วค่อยคิด
เปรียบเทียบกฎ Logistic Regression Naive Bayes และกระบวนการมนุษย์กับวิธีซับซ้อน หากความซับซ้อนไม่เพิ่มผลลัพธ์ที่มีนัยต่อผู้ใช้ ให้เลือกวิธีที่ตรวจและฟื้นฟูได้ง่ายกว่า
คำตอบอาจเป็น Hybrid แต่คำว่า Hybrid ไม่ใช่ทางหนีจากการตัดสิน ทุกส่วนต้องมีเหตุผลว่าทำไมจำเป็น มี Metric ของตน และมีวิธีดูความผิดที่ส่งต่อ หากโมเดล Generative เพียงเติมข้อมูลเพื่อให้ตัวจำแนกทำงาน ทีมต้องพิสูจน์ว่าการเติมดีกว่าการส่งคนตรวจหรือใช้ค่าปลอดภัยอย่างไร
คำแนะนำควรเป็นเงื่อนไข เช่น “เริ่มจาก Discriminative เมื่อ Target ชัดและมีป้ายพอ” “ลอง Generative เมื่อโครงสร้างข้อมูลมีคุณค่าต่อหลายงานหรือข้อมูลไม่มีป้ายสำคัญ” และ “ยังไม่ควรอัตโนมัติเมื่อ Ground Truth ไม่ชัด ผลกระทบสูง หรือไม่มีทางตรวจ Drift” ภาษานี้สะท้อนหลักฐานดีกว่าคำว่าโมเดลหนึ่งเหนือกว่าเสมอ
แบบฝึกปฏิบัติ: ออกแบบ FruitLine รุ่นเล็ก
- เลือกฟีเจอร์สามอย่างของมะม่วงและเขียน Target หนึ่งประโยค โดยห้ามใช้คำกว้างว่า “คุณภาพดี”
- เขียนคำถามแบบ Discriminative หนึ่งข้อในรูป “เมื่อเห็น x แล้ว y คืออะไร” และคำถามแบบ Generative หนึ่งข้อในรูป “ข้อมูลแบบนี้เกิดอย่างไร”
- ระบุว่าจะเรียน P(y|x), P(x), P(x|y) หรือ P(x,y) พร้อมเหตุผล
- เลือก Metric อย่างน้อยสองตัวและบอกว่าความผิดทิศใดแพงกว่า
- ออกแบบ Failure Test หนึ่งกรณี เช่น เปลี่ยนกล้อง ฤดูกาล ฉากหลัง หรือพันธุ์
- เขียน Stop Rule และระบุว่าใครมีสิทธิ์อนุมัติการกลับมาใช้ระบบ
ตัวอย่างคำตอบย่อ
Target คือ “มะม่วงมีรอยช้ำเกินเกณฑ์ส่งออกที่ผู้ตรวจสองคนยืนยันหรือไม่” คำถาม Discriminative คือเมื่อเห็นภาพและค่าความแน่น โอกาสไม่ผ่านเท่าไร คำถาม Generative คือภาพและค่าความแน่นของแต่ละกลุ่มกระจายอย่างไร เราเริ่ม Logistic Regression และโครงข่ายตัวจำแนกเป็น Baseline ดู Recall ของกลุ่มไม่ผ่าน Precision, Calibration และผลแยกสวน จากนั้นทดลอง Generative Model เฉพาะงานตรวจ Out-of-distribution โดยไม่ให้ตัดสินผ่านอัตโนมัติ
Failure Test คือถ่ายมะม่วงชุดเดิมบนถาดสามสีและกล้องสองตัว หากคำตอบเปลี่ยนมากเกินเกณฑ์ ให้หยุดการปล่อยอัตโนมัติ Stop Rule คือเมื่อ Missing Rate เกิน 5% หรือ Recall ของกลุ่มไม่ผ่านในชุดตรวจรายวันต่ำกว่าค่าที่ทีมกำหนด ระบบส่งทุกลูกให้คนตรวจจนวิศวกรข้อมูลและหัวหน้าคุณภาพอนุมัติการกลับมาใช้ วิธีนี้ทำให้การเลือกโมเดลเชื่อมกับการดำเนินงานจริง
แบบทดสอบหลังเรียน
เลือกคำตอบที่ดีที่สุดให้ครบ 5 ข้อ ระบบจะแสดง Feedback รายข้อ คะแนน และจำนวนข้อที่ยังไม่ตอบ
คำถามที่พบบ่อย
Generative Model ต้องสร้างภาพหรือข้อความเสมอหรือไม่
ไม่ โมเดลเชิงกำเนิดอาจใช้จำแนก เติมข้อมูล ตรวจความผิดปกติ หรืออนุมานตัวแปรแฝง การสร้างสื่อเป็นการใช้งานที่มองเห็นง่าย แต่แก่นคือการเรียนการกระจายหรือกระบวนการเกิดข้อมูลตามนิยามของตระกูลโมเดลนั้น
Discriminative Model ทำนายอนาคตเท่านั้นหรือไม่
ไม่ คำว่า Discriminative พูดถึงการเรียนคำตอบหรือเส้นแบ่งจากอินพุตโดยตรง งานอาจเป็นจำแนกภาพปัจจุบัน ติดป้ายคำ ประมาณค่า หรือจัดอันดับ ไม่จำเป็นต้องเกี่ยวกับอนาคต ความสับสนนี้เกิดจากนำระดับโมเดลไปปนกับคำว่า Predictive AI ระดับระบบ
โมเดลที่คืนความน่าจะเป็นเป็น Generative เสมอหรือไม่
ไม่ ทั้งสองฝั่งคืนความน่าจะเป็นได้ Discriminative Model อาจประมาณ P(y|x) โดยตรง ส่วน Generative Model อาจประมาณ P(x) หรือ Joint Distribution ต้องถามว่าความน่าจะเป็นของอะไรและถูกฝึกด้วยวัตถุประสงค์ใด
Discriminator ใน GAN ใช้เป็นตัวจำแนกปลายทางได้หรือไม่
ใน GAN ดั้งเดิม Discriminator ถูกฝึกให้แยกข้อมูลจริงกับข้อมูลจาก Generator เพื่อให้สัญญาณฝึก เป้าหมายหลักมักเป็น Generator แม้ Representation หรือแนวคิดของ Discriminator จะนำไปประยุกต์ต่อได้ เราไม่ควรถือว่ามันเป็นตัวจำแนกสำหรับป้ายธุรกิจโดยอัตโนมัติ
ควรเริ่มจากโมเดลใดเมื่อยังไม่แน่ใจ
เริ่มจากคำถามและ Baseline ที่ง่ายที่สุด หาก Target ชัดและมีป้าย ให้สร้างกฎหรือ Discriminative Baseline หากต้องเข้าใจโครงสร้างข้อมูลหรือใช้ข้อมูลไม่มีป้าย จึงเพิ่ม Generative Experiment ทุกการเพิ่มความซับซ้อนต้องมี Metric และเงื่อนไขที่ทำให้เรายอมรับหรือปฏิเสธแนวทางนั้น
สรุปบทเรียน: เส้นแบ่งกับภาพรวมข้อมูลตอบคนละคำถาม
Discriminative Model มุ่งเรียนจากข้อมูลไปยังคำตอบ อาจประมาณ P(y|x) หรือเรียนฟังก์ชันตัดสินโดยตรง Generative Model มุ่งเรียนการกระจายของข้อมูล เช่น P(x), P(x|y) หรือ P(x,y) แล้วใช้ภาพรวมนั้นสร้าง อนุมาน เติมข้อมูล ตรวจความผิดปกติ หรือจำแนกตามชนิดโมเดล
FruitLine ทำให้เห็นว่าความต่างนี้มีผลต่อข้อมูลที่ต้องเก็บ สมมติฐานที่ต้องตรวจ และ Metric ที่ควรใช้ ตัวจำแนกต้องตรวจผลผิดสองทิศทาง Calibration, Slice และ Threshold ส่วนโมเดลเชิงกำเนิดต้องตรวจคุณภาพ ความหลากหลาย Coverage และประโยชน์บนงานปลายทาง ทั้งสองต้องเผชิญ Distribution Shift, Label Problem และ Cascading Error เมื่ออยู่ในระบบผสม
ไม่มีผู้ชนะถาวร โมเดลที่มุ่งตรงอาจเหมาะเมื่อ Target ชัดและป้ายดี โมเดลที่เรียนการกระจายอาจเหมาะเมื่อโครงสร้างข้อมูลมีคุณค่าต่อหลายงาน แต่ต้องแลกกับสมมติฐานและภาระประเมินที่กว้างขึ้น วิธีตัดสินที่ดีคือถามคำถาม หลักฐาน ผลผิด การเปลี่ยนสภาพ และ Baseline ก่อนถามชื่อโมเดล
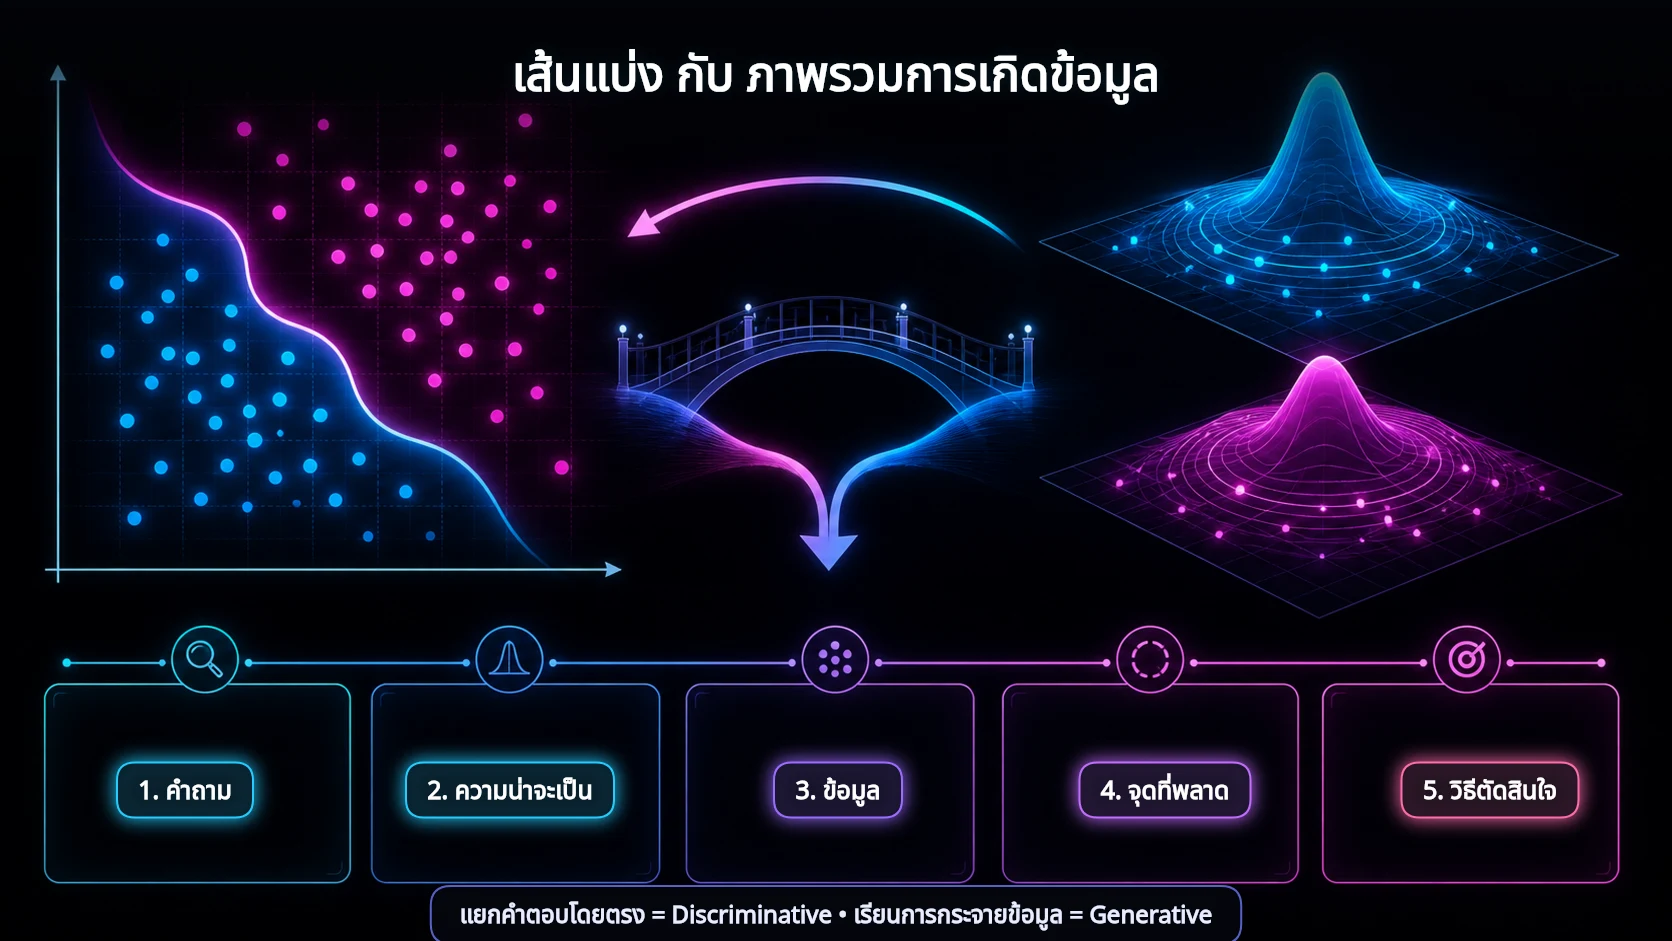
Insight Gate ของบทนี้ไม่ใช่การจำชื่อโมเดลสิบตัว แต่คือการอธิบายมะม่วงลูกเดียวกันได้สองมุม: “เมื่อเห็นข้อมูลแล้วควรอยู่กลุ่มใด” และ “ข้อมูลของแต่ละกลุ่มเกิดอย่างไร” พร้อมบอกได้ว่าสมมติฐานตรงไหนอาจพัง จะวัดอย่างไร และเมื่อใดต้องส่งให้มนุษย์
ภารกิจหลังเรียน: เลือกระบบจำแนกหนึ่งระบบในชีวิตจริง แล้วเขียนคำถามแบบ Discriminative และ Generative อย่างละหนึ่งข้อ ระบุการแจกแจง ข้อมูล Metric Failure Test และ Stop Rule ให้ผู้อื่นตรวจตามได้
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงหลักและหมายเหตุบรรณาธิการ
- Ng & Jordan — On Discriminative vs. Generative Classifiers ใช้รองรับนิยาม Generative Classifier กับ Discriminative Classifier และข้อแลกเปลี่ยนของ Logistic Regression กับ Naive Bayes ภายใต้กรอบงานวิจัย
- Google for Developers — What is a Generative Model? ใช้รองรับคำอธิบาย P(x,y), P(x) และ P(y|x) สำหรับผู้เริ่มต้น
- Kingma & Welling — Auto-Encoding Variational Bayes ใช้รองรับคำอธิบาย VAE และการอนุมานตัวแปรแฝง
- Goodfellow et al. — Generative Adversarial Nets ใช้รองรับบทบาท Generator, Discriminator และการฝึกแบบแข่งขัน
- NIST CSRC — Generative Artificial Intelligence Glossary ใช้แยกระดับผลิตภัณฑ์ Generative AI ที่สร้างเนื้อหาสังเคราะห์ออกจากกรอบโมเดลเชิงสถิติ
- NIST — AI Risk Management Framework 1.0 ใช้รองรับการจัดการความเสี่ยงตลอดวงจร Govern, Map, Measure และ Manage
- Google for Developers — Accuracy, Precision and Recall ใช้รองรับการเลือก Metric ตามทิศทางความผิด
- scikit-learn — Probability Calibration ใช้ประกอบคำอธิบาย Reliability Diagram, Brier Score และความหมายของคะแนนความน่าจะเป็น
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 5 สิงหาคม 2026 · AIKO นำการอธิบายสำหรับผู้เริ่มต้น · SHIRO ตรวจความแม่นของนิยาม หลักฐาน และข้อจำกัด · FruitLine เป็นกรณีสมมติเพื่อการศึกษา ไม่ใช่ผลทดสอบผลิตภัณฑ์ · ภาพสรุปสร้างจาก ImageGen master ที่ไม่มีข้อความ และวางภาษาไทยด้วย Skia/OpenType + Noto Sans Thai
