ความรู้ก่อนเรียน: ควรเข้าใจบทบาทพื้นฐานของ CPU, RAM, Storage และ GPU โดยไม่จำเป็นต้องเขียน CUDA, HIP หรือโค้ดระดับ Hardware
PATH 01 · พื้นฐานคอมพิวเตอร์และภาพรวม AI
คำตอบสั้น: การถามว่า “CPU หรือ GPU อะไรเร็วกว่า” คล้ายถามว่ารถส่งพัสดุกับรถไฟอะไรเร็วกว่า—คำตอบขึ้นกับงาน ปริมาณ จุดหมาย และเวลาเตรียมขบวน CPU เน้นตอบสนองลำดับงานซับซ้อน ส่วน GPU เน้นขนการคำนวณแบบคล้ายกันจำนวนมาก
SHIRO จะใช้แกน Latency vs Throughput และ Control Flow vs Data Parallelism เพื่อเลือกอย่างมีเหตุผล รวมถึงอธิบายว่าระบบ AI จริงมักใช้ CPU และ GPU ร่วมกัน
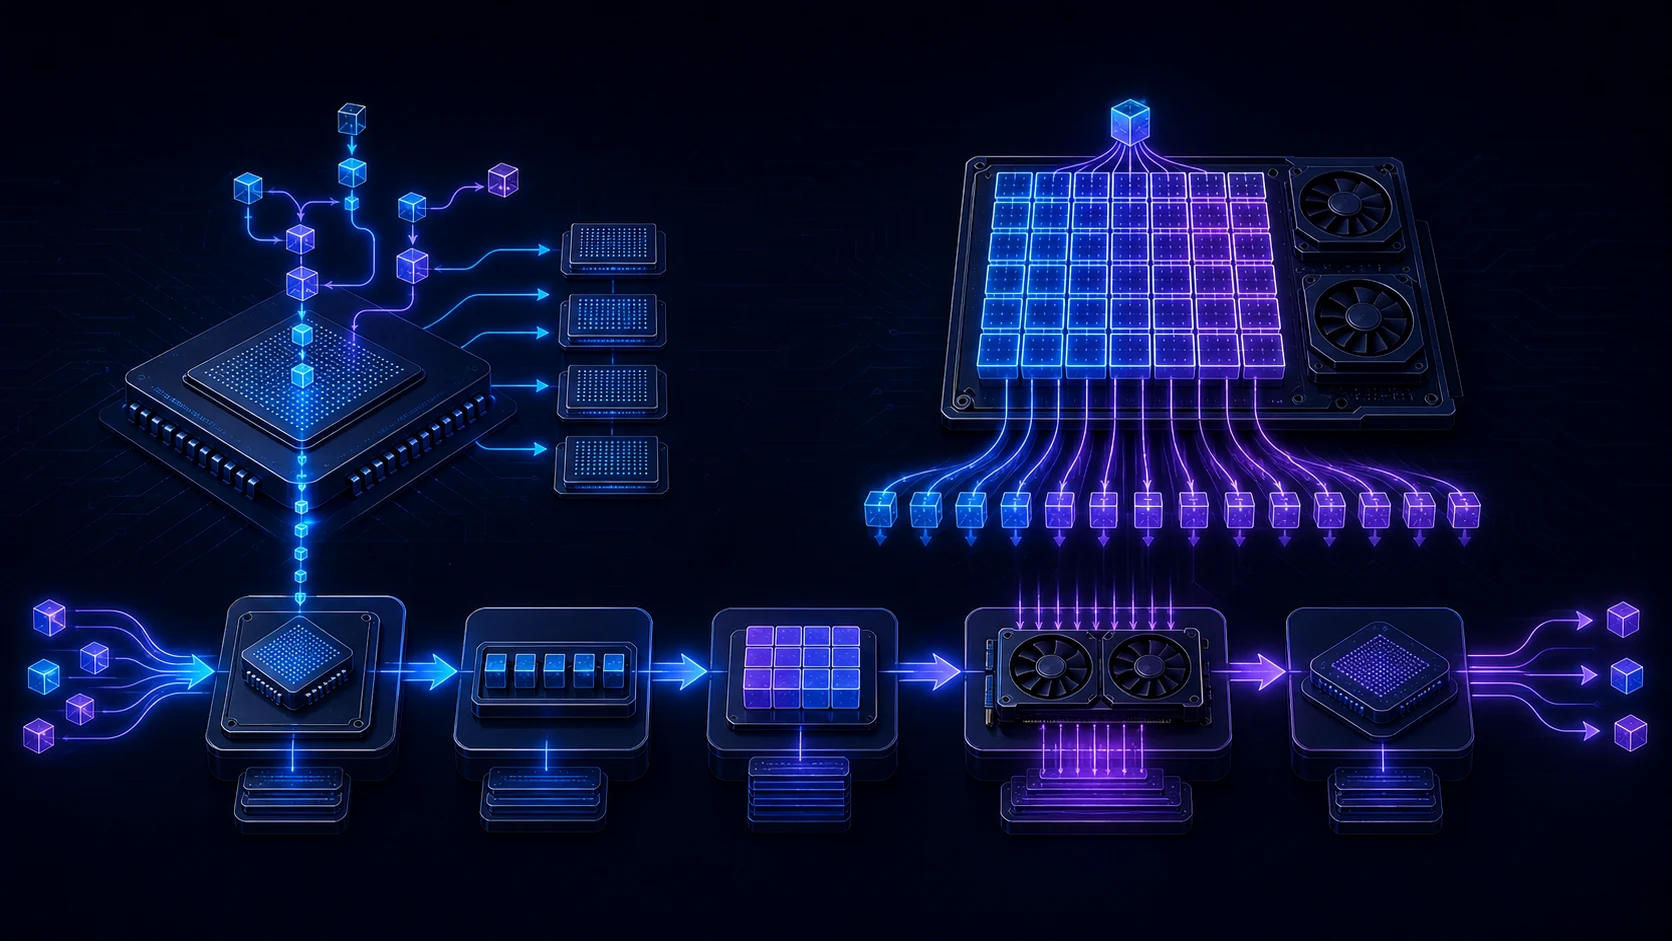
จำภาพนี้ไว้: CPU เหมือนผู้ควบคุมจราจรที่ตัดสินใจเก่งและตอบสนองเร็ว ส่วน GPU เหมือนทางด่วนหลายเลนที่ขนงานรูปแบบเดียวกันได้พร้อมกัน—ระบบที่ดีเลือกใช้ทั้งสองตรงช่วงที่ถนัด
อ่านจบบทนี้ คุณจะทำอะไรได้
- เปรียบเทียบสถาปัตยกรรม CPU/GPU แบบไม่ยึดชื่อรุ่นได้
- แยก Latency, Throughput และ Parallelism ได้
- อธิบาย Branch, Memory และ Data Transfer Bottleneck ได้
- เลือก CPU-only, GPU หรือ Hybrid เบื้องต้นได้
- ออกแบบ Benchmark ให้สะท้อน End-to-end Workflow ได้
อย่าถามว่าอะไรเร็วกว่า ให้ถามว่างานมีรูปร่างแบบไหน
ระบุขนาดงาน จำนวนงานพร้อมกัน ลำดับคำสั่ง ความถี่ Branch, ขนาด Working Set, การใช้ข้อมูลซ้ำ เวลาตอบสนอง และต้นทุนที่ยอมรับได้ งานเดียวกันอาจเหมาะ CPU ใน Batch เล็กและเหมาะ GPU ใน Batch ใหญ่ การตัดสินจึงต้องผูกกับ Input และ Service Goal
สองสถาปัตยกรรมใช้พื้นที่ทรานซิสเตอร์ต่างเป้าหมาย
| มิติ | CPU | GPU |
|---|---|---|
| เป้าหมายหลัก | ตอบสนองเร็วต่อ Thread และ Control Flow | ทำ Operation ขนานจำนวนมากต่อเวลา |
| Core | น้อยกว่า ซับซ้อน มี Cache/Prediction มาก | มากกว่า จัดเป็นกลุ่ม Execution Lane |
| Branch | จัดการเส้นทางซับซ้อนได้ดี | Divergence ลดการใช้ Lane |
| Memory | Hierarchy เน้น Latency และงานทั่วไป | VRAM/Bandwidth สูง เน้น Throughput |
| Programming | โปรแกรมทั่วไปและ OS รองรับโดยตรง | ต้องมี Kernel/Library/Driver ที่เหมาะ |
| Overhead | เริ่มงานเล็กได้รวดเร็ว | มี Launch และ Transfer Cost |
Latency คือเวลาของหนึ่งงาน Throughput คือปริมาณงานต่อเวลา
CPU: Low Latency
เหมาะคำขอสั้น Branch มาก และต้องตอบเร็วโดยไม่รวม Batch
GPU: High Throughput
เหมาะนำงานคล้ายกันมารวม Batch และคำนวณพร้อมกัน
Tail Latency
ดู P95/P99 ไม่ใช่ค่าเฉลี่ย เมื่อคิวและ Batch เปลี่ยน
Utilization
สูงไม่เท่ากับคุ้ม ต้องดู Outcome/Cost ต่อผลลัพธ์
GPU อาจทำ 1,000 รายการต่อวินาทีได้ดี แต่รายการเดียวอาจเสียเวลารอ Batch และ Transfer ส่วน CPU อาจตอบรายการเดียวเร็วกว่าแต่รับปริมาณรวมต่ำกว่า เป้าหมายผลิตภัณฑ์เป็นผู้ตัดสินว่ามิติใดสำคัญ
Data Movement มักแพงกว่าที่จำนวน Core บอก
CPU ใช้ RAM และ Cache; GPU ใช้ VRAM กับ Memory Bandwidth สูง การส่งข้อมูลผ่าน PCIe/Interconnect มีค่าใช้จ่าย หาก Copy ไปกลับทุก Operation ประโยชน์การคำนวณขนานอาจหาย การเก็บข้อมูลไว้บน Device ใช้ Kernel หลายขั้นต่อเนื่อง และเพิ่ม Arithmetic Intensity ช่วยได้ ขณะเดียวกัน VRAM Capacity อาจบังคับให้แบ่ง Model/Batch
ระบบ AI จริงมักเป็น Hybrid Pipeline
รับคำขอ ตรวจสิทธิ Parse/Decode
รวม Batch และจัดลำดับ
Matrix/Tensor Inference
Post-process กฎและ Business Logic
ตอบผล Log และ Monitor
ถ้า Preprocess, Tokenization, Data Loader หรือ Network ช้า GPU จะว่างรอ ถ้า GPU ช้า คิวจะโตและ Tail Latency พุ่ง การเพิ่มเฉพาะ GPU อาจไม่เพิ่ม Throughput เพราะ Bottleneck อยู่ก่อนหรือหลังโมเดล
ตัวอย่างงานที่รูปร่างต่างกัน
| งาน | แนวโน้ม | เหตุผล |
|---|---|---|
| Web/API Logic | CPU | Branch และ I/O หลากหลาย คำขอเล็ก |
| Database Transaction | CPU | Latency, Lock และ Random Access |
| Matrix Training | GPU | Parallelism และ Data Reuse สูง |
| Batch Image Inference | GPU | Operation คล้ายกันจำนวนมาก |
| โมเดลเล็ก Request เดียว | ต้อง Benchmark | Launch/Transfer อาจมากกว่าคำนวณ |
| Production AI Service | Hybrid | มีทั้ง Control Flow, Queue, Model และ Monitoring |
กรณีศึกษา: บริการจัดหมวดหมู่ภาพที่เร็วเฉพาะตัวโมเดล
ทีมหนึ่งย้าย Inference จาก CPU ไป GPU แล้วเวลาคำนวณโมเดลลดจาก 42 เหลือ 8 มิลลิวินาที แต่ P95 ของ API ลดเพียงเล็กน้อย เพราะการ Decode ภาพบน CPU, การรอรวม Batch และการ Copy ข้อมูลใช้เวลารวมมากกว่า Kernel
สิ่งที่กราฟแรกบอก
GPU Compute เร็วขึ้นจริง แต่ GPU Utilization ขึ้นเป็นช่วงและมีช่องว่างยาว จึงยังป้อนงานไม่ต่อเนื่อง
การแก้ที่คุ้มกว่า
ทำ Decode แบบขนาน ใช้ Pinned Memory จำกัดเวลารอ Batch และวัด End-to-end ใหม่ ก่อนเพิ่ม GPU อีกตัว
บทเรียน: Component เร็วขึ้นไม่รับประกันว่า Service จะเร็วขึ้น ต้องดู Critical Path และ Tail Latency ของระบบทั้งหมด
Worksheet: CPU–GPU Fit Card
- Workload: งานย่อยเหมือนกันมากเพียงใด และแบ่งทำพร้อมกันได้กี่ชิ้น
- Service goal: ให้ความสำคัญกับเวลาตอบหนึ่งคำขอหรือปริมาณงานรวมต่อวินาที
- Data path: ข้อมูลเริ่มที่ใด ต้อง Copy กี่ครั้ง และเก็บซ้ำบน Device ได้หรือไม่
- Working set: Model, Batch และ Buffer ใช้ RAM/VRAM สูงสุดเท่าใด
- Control flow: มี Branch, Loop ไม่สม่ำเสมอ หรือ Dependency ต่อเนื่องมากเพียงใด
- Baseline: บันทึก P50/P95/P99, Throughput, Cost และคุณภาพจากระบบเดิม
- Stop rule: กำหนดล่วงหน้าว่าผลแบบใดไม่คุ้มต่อการเพิ่ม GPU หรือปรับระบบต่อ
Benchmark ต้องรวม Warm-up, Transfer, Queue และคุณภาพ
- ใช้ Model, Precision, Batch และ Input Distribution จริง
- แยก Cold Start, Warm Latency และ Steady-state
- วัด P50/P95/P99, Throughput และ Error
- รวม Pre/Post-process และ Data Transfer
- ดู CPU/GPU/RAM/VRAM/Storage/Network พร้อมกัน
- คำนวณ Cost per Successful Result และพลังงาน
- ตรวจคุณภาพหลังเปลี่ยน Precision/Optimization
กรอบเลือก: เริ่มเล็ก วัด แล้วขยายตรงคอขวด
เลือก CPU-only หากงานเล็ก Branch มาก Latency สำคัญ หรือ Library GPU ไม่รองรับ เลือก GPU เมื่อ Parallelism สูง Working Set เหมาะ VRAM และปริมาณงานคุ้ม Overhead ใช้ Hybrid เมื่อ Workflow มีทั้ง Business Logic กับ Tensor Compute ซึ่งเป็นกรณีทั่วไป ทดลองทางเลือกอย่างน้อยสองแบบและตั้ง Stop Rule ก่อนซื้อโครงสร้างถาวร
แบบทดสอบท้ายบท
สรุป: CPU และ GPU เป็นทีมที่เหมาะคนละช่วงของงาน
CPU เน้น Latency และ Control Flow ส่วน GPU เน้น Throughput และ Data Parallelism ความเร็วจริงเกิดจาก Pipeline ทั้งระบบ ไม่ใช่ Core Count หรือ FLOPS แยกตัว เมื่อวาด Data Path วัด End-to-end และรวมต้นทุน คุณจะรู้ว่าควรใช้ CPU, GPU หรือทั้งคู่ตรงจุดใด
เรียนต่ออย่างมีทิศทาง
ใช้ CPU–GPU Fit Card กับ Workflow ของคุณ วัด Baseline แบบ End-to-end แล้วเลือกทรัพยากรจากคอขวดจริง ไม่ใช่จำนวน Core หรือคะแนนสูงสุดเพียงค่าเดียว
ดู Learning Pack PATH 01 →แหล่งอ้างอิงหลัก
- NVIDIA — CUDA C++ Programming Guide — Thread Hierarchy, SIMT, Memory และการทำงานของ Kernel
- NVIDIA — CUDA C++ Best Practices Guide — Data Transfer, Memory Optimization และการวัดประสิทธิภาพ
- Arm — Learn the Architecture — Pipeline, Cache, Branch และแนวคิดสถาปัตยกรรม CPU
- AMD ROCm — HIP Documentation — Execution Model และการประมวลผลขนานบน GPU
- PyTorch — Performance Tuning Guide — Data Loading, Pinned Memory และ Workflow Benchmark
ขอบเขต: Latency, Throughput, Cache, Memory Bandwidth และประสิทธิภาพจริงเปลี่ยนตาม Hardware, Driver, Library, Model, Batch และ Input ควร Benchmark บนระบบเป้าหมายก่อนตัดสินใจ
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 11 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 35 · PATH 01
