ความรู้ก่อนเรียน: ควรเข้าใจบทบาทของ CPU, RAM และ Storage ในระดับพื้นฐาน โดยไม่จำเป็นต้องเขียน CUDA, HIP หรือ OpenCL เป็น
PATH 01 · พื้นฐานคอมพิวเตอร์และภาพรวม AI
คำตอบสั้น: GPU คือหน่วยประมวลผลที่ออกแบบให้ทำการคำนวณคล้ายกันจำนวนมากพร้อมกัน จึงเด่นด้าน Throughput มากกว่าการไล่แก้ลำดับงานซับซ้อนทีละขั้น แต่ GPU จะเร็วได้ก็ต่อเมื่องานแบ่งขนานได้ ข้อมูลป้อนทัน และการย้ายข้อมูลไม่แพงเกินประโยชน์ที่ได้
SHIRO จะพาไล่ตั้งแต่ Thread, Warp/Wave และ Kernel ไปจนถึง VRAM, Memory Bandwidth และ Data Movement เพื่อให้คุณตอบได้ทั้ง “ทำไม AI ใช้ GPU” และ “เมื่อใดไม่ควรรีบซื้อ GPU”
จำภาพนี้ไว้: CPU คือหัวหน้าครัวที่เก่งแก้โจทย์หลายรูปแบบ ส่วน GPU คือไลน์ครัวขนาดใหญ่ที่ทำขั้นตอนเดียวกันกับวัตถุดิบจำนวนมากได้พร้อมกัน—เร็วมากเมื่อจัดงานถูก และว่างรอได้เมื่อวัตถุดิบมาไม่ทัน
เมื่อเรียนจบ คุณจะทำอะไรได้
- อธิบายความต่าง CPU และ GPU จากรูปแบบงาน แทนการเทียบจากคำว่า “แรงกว่า”
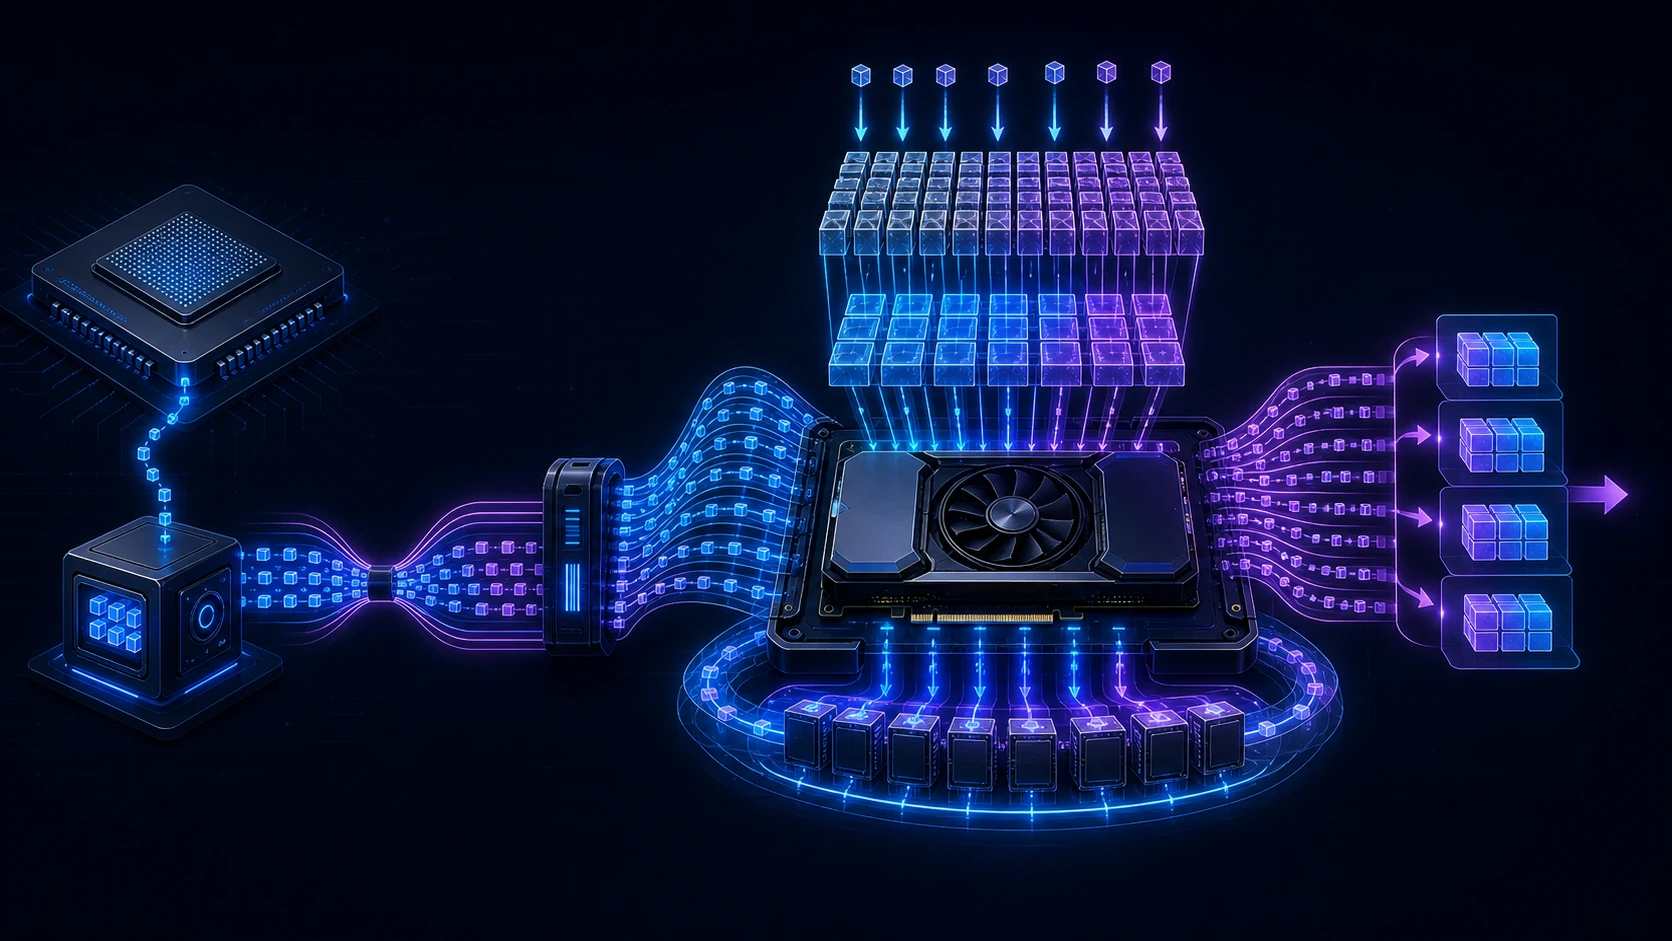
- เล่าเส้นทาง Host → Transfer → Kernel → Result ได้ด้วยภาษาของตนเอง
- แยก VRAM Capacity, Memory Bandwidth และ Compute Throughput ว่าเป็นข้อจำกัดคนละแบบ
- อ่านอาการ Compute-bound, Memory-bound และ Data-starved แบบเบื้องต้นได้
- ใช้ Worksheet วางแผน Benchmark ก่อนเลือก GPU หรือปรับ Workflow
01 · MENTAL MODEL
GPU ไม่ได้ทำทุกอย่างเร็วขึ้น—มันทำ “งานที่มีรูปทรงเหมาะ” เร็วขึ้น
คำว่า GPU ย่อจาก Graphics Processing Unit จุดแข็งไม่ได้มาจาก Core จำนวนมากเพียงตัวเลขเดียว แต่มาจากการจัดสถาปัตยกรรมและ Software Stack ให้หน่วยคำนวณจำนวนมากรับงานย่อยที่คล้ายกันได้ต่อเนื่อง หากงานมีข้อมูลจำนวนมาก ทำ Operation ซ้ำกัน และแต่ละชิ้นพึ่งกันน้อย GPU สามารถซ่อนเวลารอและรักษา Throughput ได้ดี
Parallelism
มีงานย่อยจำนวนมากที่ทำพร้อมกันได้จริง ไม่ใช่แค่เพิ่ม Thread โดยไม่มีงานอิสระ
Regularity
Thread ในกลุ่มเดินคำสั่งคล้ายกัน ลดการแยก Branch และการทำงานซ้ำเป็นรอบ
Data Locality
ข้อมูลถูกจัดให้เข้าถึงเป็นแบบแผนและนำกลับมาใช้ซ้ำ ลดการรอหน่วยความจำ
02 · ORIGIN
จากการวาด Pixel สู่ General-purpose Parallel Computing
การสร้างภาพต้องแปลงจุดยอด เติมสี คำนวณแสง และเขียน Pixel จำนวนมหาศาลด้วย Operation ที่คล้ายกัน GPU จึงเติบโตมากับงานที่มี Data Parallelism สูง ต่อมาแพลตฟอร์มอย่าง CUDA, HIP และ OpenCL เปิดทางให้โปรแกรมทั่วไปส่ง Kernel ไปประมวลผลบน GPU ไม่จำกัดเฉพาะภาพกราฟิก
อย่างไรก็ตาม “เขียนให้รันบน GPU ได้” กับ “รันบน GPU แล้วคุ้ม” เป็นคนละคำถาม ขั้นแรกคือ Compatibility ส่วนขั้นที่สองต้องดูขนาดงาน รูปแบบ Memory Access ค่า Transfer และผลลัพธ์ปลายทาง
03 · ARCHITECTURE
CPU เก่งลำดับซับซ้อน GPU เก่งงานขนานจำนวนมาก
| มิติ | CPU | GPU |
|---|---|---|
| เป้าหมายหลัก | Latency ต่ำและตอบสนองงานหลากหลาย | Throughput สูงกับงานย่อยจำนวนมาก |
| Control Flow | เหมาะกับ Branch ซับซ้อนและลำดับที่เปลี่ยนบ่อย | คุ้มเมื่อ Thread ในกลุ่มทำเส้นทางคล้ายกัน |
| หน่วยคำนวณ | มีน้อยกว่าแต่แต่ละ Core ซับซ้อนและยืดหยุ่น | มีหน่วยทำงานจำนวนมาก จัดกลุ่มเพื่อคำนวณพร้อมกัน |
| หน่วยความจำ | RAM และ Cache รองรับงานทั่วไป | VRAM และระบบ Memory เน้นส่งข้อมูลปริมาณมาก |
| งานตัวอย่าง | OS, Database Logic, Event Handling, Serial Control | Graphics, Matrix, Simulation, Signal Processing, AI |
| คอขวดพบบ่อย | ส่วน Sequential, Cache Miss, I/O และ Lock | Transfer, Divergence, งานเล็ก, Bandwidth และ Data Starvation |
อย่าถามว่า “CPU หรือ GPU อะไรแรงกว่า” ให้ถามว่า “งานนี้มีลำดับซับซ้อนหรืองานย่อยที่คล้ายกันจำนวนมาก”
04 · EXECUTION
Kernel แบ่งงานเป็น Thread จำนวนมากที่เดินเป็นกลุ่ม
Thread คือหน่วยงานเชิงตรรกะของโปรแกรม GPU หลาย Thread ถูกจัดเป็น Block/Work-group และลงไปทำงานเป็นกลุ่มย่อยที่ผู้ผลิตอาจเรียก Warp หรือ Wavefront หาก Thread ในกลุ่มพบเงื่อนไขแล้วแยกไปคนละเส้นทาง การทำงานบางส่วนอาจต้องสลับกัน จึงเสีย Throughput จาก Divergence
Kernel Launch และการ Synchronize มีต้นทุนคงที่ งานเล็กมากจึงอาจเสร็จบน CPU ก่อนที่ GPU จะเริ่มใช้กำลังได้เต็มที่ วิธีที่มักช่วยคือรวมงานเป็น Batch, ลดการ Launch ถี่เกินไป และเก็บข้อมูลไว้บน GPU ระหว่างหลายขั้นตอนเมื่อ Workflow อนุญาต
05 · MEMORY
VRAM Capacity, Memory Bandwidth และ Data Movement เป็นข้อจำกัดคนละแบบ
Capacity
โมเดล Tensor, Activation และ Buffer ต้องใส่ได้ หากไม่พออาจรันไม่ได้ ต้องแบ่ง หรือ Offload
Bandwidth
บอกอัตราที่ระบบป้อนข้อมูลให้หน่วยคำนวณ งานที่ใช้ข้อมูลมากต่อการคำนวณอาจติด Memory-bound
Transfer
การย้าย Host ↔ Device ผ่าน Interconnect อาจกลบประโยชน์ของ Kernel โดยเฉพาะเมื่อส่งข้อมูลชิ้นเล็กถี่ ๆ
ค่า FLOPS สูงไม่ช่วยหากหน่วยคำนวณต้องรอข้อมูล Arithmetic Intensity ช่วยตั้งคำถามว่าแต่ละ Byte ที่นำมาใช้สร้างการคำนวณมากเพียงใด งานที่แบ่ง Tile และนำข้อมูลกลับมาใช้ใน Cache/Shared Memory ได้ดีมักใช้ GPU คุ้มกว่า
06 · AI WORKLOAD
Matrix Multiplication เปิดพื้นที่ให้คำนวณขนานและใช้ข้อมูลซ้ำ
Neural Network จำนวนมากประกอบจาก Matrix Multiplication, Convolution, Attention และ Element-wise Operations ซึ่งสามารถแบ่งข้อมูลเป็น Tile และกระจายให้ Thread จำนวนมากได้ Library ที่ปรับแต่งแล้วช่วยเลือก Kernel, Precision และ Layout ให้เหมาะกับฮาร์ดแวร์ รวมถึงใช้ Matrix/Tensor Units สำหรับ Operation ที่รองรับ
แต่คำว่า “AI ใช้ GPU” ไม่ได้แปลว่า Operation ทุกตัวอยู่บน GPU เสมอ บางขั้นตอนอาจยังอยู่บน CPU, Data Loader หรือ Storage และบาง Operation อาจไม่มี Kernel ที่มีประสิทธิภาพ ผลจริงจึงขึ้นกับ Batch Size, Sequence Length, Model Architecture, Precision, Framework และ End-to-end Pipeline
07 · CASE STUDY
กรณีศึกษา: ระบบจำแนกรูปภาพรับภาพได้ไม่ถึงเป้า
ทีมหนึ่งใช้ GPU ทำ Inference และเห็น GPU Utilization ขึ้นลงเป็นช่วง ๆ จึงเสนอให้เปลี่ยนเป็น GPU รุ่นใหญ่กว่า แต่เมื่อติดตามเส้นทางจริงพบว่า CPU ต้องอ่าน JPEG จาก Storage, Decode, Resize และส่งภาพทีละชิ้นผ่าน Host-to-Device ก่อนเรียก Kernel
สมมติฐานแรก
GPU ช้าเพราะ Compute ไม่พอ จึงควรเพิ่ม FLOPS
หลักฐานที่พบ
Kernel ใช้เวลาสั้น แต่มีช่องว่างยาวระหว่าง Batch ขณะที่ CPU และ Data Loader ทำงานไม่ทัน
การทดลอง
เพิ่ม Worker อย่างพอดี ใช้ Batch, Prefetch และ Pinned Memory พร้อมเก็บขั้นตอน Preprocess ที่เหมาะสมไว้ใกล้ GPU
ผลเชิงตัดสินใจ
Throughput ดีขึ้นโดยไม่เปลี่ยน GPU และทีมได้ Baseline สำหรับทดสอบรุ่นที่ใหญ่กว่าอย่างยุติธรรม
บทเรียนจากกรณีนี้: GPU ว่างไม่ได้แปลว่า GPU อ่อน—อาจแปลว่า Pipeline ป้อนงานไม่ทัน
08 · FAILURE CASES
GPU อาจไม่ช่วยเมื่อโจทย์เล็ก ลำดับมาก หรือส่งข้อมูลแพง
งานเล็ก
เวลา Launch, Transfer และ Synchronize มากกว่าเวลาคำนวณ
Branch มาก
Thread ในกลุ่มเดินคนละทาง ทำให้ประสิทธิภาพจากความขนานลดลง
Data Starvation
CPU, Storage, Network หรือ Data Loader ป้อนข้อมูลไม่ทัน
Unsupported Ops
บาง Operation กลับไป CPU หรือไม่มี Kernel ที่ปรับแต่งดี
VRAM ไม่พอ
ต้องแบ่ง Batch, Offload หรือคัดลอกข้อมูลซ้ำจน Latency สูง
ต้นทุนระบบ
Cooling, Power, Driver, Queue, Cloud Idle Time และการดูแลอาจแพงกว่าผลลัพธ์
Trade-off และบทบาทของมนุษย์
การเพิ่ม Batch อาจเพิ่ม Throughput แต่ทำให้ Latency ต่อคำขอสูงขึ้น การลด Precision อาจเร็วและใช้ VRAM น้อยลง แต่ต้องตรวจคุณภาพเชิงตัวเลข การรวม Kernel อาจลด Overhead แต่ทำให้ Debug และ Portability ซับซ้อนขึ้น มนุษย์จึงต้องกำหนด Metric ที่สัมพันธ์กับผู้ใช้ ยืนยันความถูกต้อง และตัดสินใจบนต้นทุนรวม ไม่ปล่อยให้ Utilization ตัวเดียวเป็นคำตอบ
Human-in-the-loop ก่อนอนุมัติการเปลี่ยนระบบ
- ยืนยันว่าผลลัพธ์และคุณภาพเทียบกับ Baseline ได้
- วัดทั้ง Latency, Throughput, Cost per Result และ Peak VRAM
- แยก Warm-up ออกจาก Steady State และใช้โหลดจริงหลายระดับ
- เปลี่ยนสมมติฐานสำคัญทีละอย่างเพื่อรู้ว่าอะไรสร้างผล
- บันทึก Driver, Framework, Model, Batch, Precision และข้อมูลทดสอบ
09 · OBSERVABILITY
อ่าน Metric เป็นเส้นทาง ไม่ใช่คะแนน
| คำถาม | หลักฐานที่ควรดู | ข้อสรุปที่ยังห้ามรีบทำ |
|---|---|---|
| GPU กำลังคำนวณต่อเนื่องไหม | Kernel Timeline, Compute Utilization, Occupancy/Active Waves ตามเครื่องมือ | Utilization สูงไม่ได้แปลว่า Outcome ดีหรือคุ้มต้นทุน |
| ติดหน่วยความจำหรือไม่ | Memory Throughput, Cache Behavior, Stall และ Arithmetic Intensity | VRAM ใช้เยอะไม่ได้แปลว่า Bandwidth เต็ม |
| ข้อมูลป้อนทันไหม | ช่องว่างระหว่าง Kernel, CPU/Data Loader, Disk/Network, Transfer Timeline | GPU ว่างไม่ได้แปลว่าต้องซื้อ GPU ใหญ่ขึ้น |
| ผลปลายทางดีขึ้นไหม | End-to-end Latency, Throughput, Cost per Result และคุณภาพ | Kernel เร็วขึ้นไม่ได้แปลว่า Workflow เร็วขึ้นเท่ากัน |
เริ่มจาก Timeline ของคำขอหนึ่งชุด แล้วซูมออกไปดูหลาย Batch ภายใต้โหลดจริง วิธีนี้ช่วยเห็นว่าเวลาหายไปใน Compute, Memory, Transfer, Queue หรือระบบก่อนหน้า GPU
10 · DECISION
เลือก GPU จาก Workflow, Precision และระบบรอบข้าง
- Compatibility: Framework, Operator, Driver และ Library รองรับงานจริงหรือไม่
- Memory fit: วัด Peak VRAM ของ Model, Activation, KV Cache, Workspace และ Batch
- Target: ระบุ Latency, Throughput, Quality และ Cost per Result ที่ยอมรับได้
- Precision: ทดลอง FP32, TF32, FP16, BF16 หรือ Quantization เท่าที่ระบบรองรับ พร้อมตรวจคุณภาพ
- Pipeline: รวม CPU, Storage, Network, PCIe/Interconnect และ Multi-GPU Communication
- Operations: คิด Cooling, Power, Availability, Monitoring, Scaling, Queue และเวลาที่ GPU ว่าง
- Benchmark: ใช้ Model, Batch, Sequence/Image Size และข้อมูลที่ใกล้ Production พร้อมเทียบ CPU หรือ GPU ขนาดเล็กกว่า
สำหรับการเรียนหรือโมเดลเล็ก การใช้ Local CPU, Integrated GPU หรือ Notebook/Cloud เป็นครั้งคราวอาจคุ้มกว่าซื้ออุปกรณ์ ส่วน Production ควรตัดสินจาก Capacity Planning และต้นทุนรวมตลอดอายุระบบ
11 · WORKSHEET
Worksheet: GPU Fit Card
เลือกงานจริงหนึ่งงาน แล้วกรอกการ์ดสั้น ๆ นี้ก่อนเปิดหน้าร้านหรือเลือก Instance
- Outcome: ผู้ใช้ต้องการผลอะไร และ Metric ปลายทางคืออะไร
- Parallel unit: งานย่อยใดทำพร้อมกันได้ และพึ่งกันตรงไหน
- Data path: ข้อมูลเริ่มที่ใด ผ่าน CPU/Storage/Network อย่างไร และต้องย้ายเข้าออก GPU กี่ครั้ง
- Memory fit: Peak VRAM เท่าไร และองค์ประกอบใดกินพื้นที่
- Risk: มี Branch, Unsupported Ops, งานเล็ก หรือ Synchronization ตรงไหน
- Baseline: CPU หรือระบบเดิมมี Latency, Throughput, Cost และ Quality เท่าไร
- Experiment: จะเปลี่ยนตัวแปรใดทีละอย่าง และเก็บหลักฐานอะไร
- Decision rule: ผลแบบใดจึงถือว่าคุ้มต่อการเปลี่ยนระบบ
12 · CHECKPOINT
แบบทดสอบความเข้าใจ 5 ข้อ
SUMMARY INFOGRAPHIC
ภาพสรุป: จาก Host และ Data Loader ผ่าน Transfer, VRAM และงานขนานบน GPU
เรียนต่ออย่างมีทิศทาง
นำ GPU Fit Card ไปใช้กับงาน AI หนึ่งงานของคุณ แล้วเทียบ Baseline บน CPU หรือระบบเดิมก่อนดูสเปกอุปกรณ์ บทถัดไปจะเชื่อมจาก GPU ไปสู่บทบาทของ VRAM และการจัดการหน่วยความจำใน Workflow ที่ใหญ่ขึ้น
ดู Learning Pack PATH 01 →แหล่งอ้างอิงหลัก
- NVIDIA — CUDA Programming Guide — Programming Model, Thread Hierarchy, Memory Hierarchy และ SIMT
- NVIDIA — CUDA C++ Best Practices Guide — Memory Optimization, Control Flow และการวัดประสิทธิภาพ
- AMD ROCm — Introduction to the HIP Programming Model — Execution Model และ Memory Model
- Khronos — OpenCL Specification — Work-item, Work-group และ Device Model
- PyTorch — Performance Tuning Guide — Data Loading, Pinned Memory และแนวทางวัด Workflow
ขอบเขต: รายละเอียด Warp/Wave size, Cache, Precision และหน่วยเฉพาะแตกต่างตาม Hardware, Driver และ Software Version ควรอ้างเอกสารของแพลตฟอร์มที่ใช้งานเมื่อลงลึก
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 11 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 34 · PATH 01
