ลองนึกถึงคณะกรรมการทุนการศึกษาที่ได้รับใบสมัครหลายพันฉบับ ทีมงานจึงสร้างระบบ AI ให้ช่วยเรียงลำดับแฟ้มที่ควรอ่านก่อน เช้าวันหนึ่ง “เมย์” นักเรียนที่มีผลการเรียนดีและต้องการความช่วยเหลือจริง กลับถูกจัดไว้ท้ายรายการ เพราะช่องรายได้ครอบครัวของเธอว่าง ระบบไม่ได้รู้ว่าครอบครัวทำงานรับจ้างรายวันและไม่มีเอกสารแบบเดียวกับผู้สมัครส่วนใหญ่ มันเพียงใช้รูปแบบที่คนเลือกให้เรียนรู้ แล้วส่งคะแนนไปยังหน้าจอที่คนออกแบบไว้
ถ้าเมย์พลาดโอกาส ใครควรรับผิดชอบ—โมเดล นักพัฒนา เจ้าหน้าที่ทุน หรือผู้บริหาร? คำตอบสั้นคือ มนุษย์ยังเป็นผู้กำหนดเป้าหมาย ขอบเขต ข้อมูล เกณฑ์ การกระทำ และทางแก้ของระบบเสมอ การมีคนกดปุ่มอนุมัติจึงยังไม่พอ เราต้องรู้ว่าคนใดอยู่ตรงไหน เห็นข้อมูลอะไร มีเวลาและอำนาจจริงหรือไม่ และผู้ได้รับผลกระทบขอให้ทบทวนได้อย่างไร
บทเรียนนี้จะใช้กรณีระบบคัดกรองทุนเป็นเส้นเรื่องเดียว เราจะเดินตั้งแต่ก่อนสร้างระบบ ระหว่างพัฒนา ขณะใช้งาน ไปจนถึงตอนเกิดเหตุ เพื่อเห็นว่าบทบาทมนุษย์ไม่ใช่กล่องสุดท้ายที่เติมไว้หลังโมเดล แต่เป็นโครงสร้างที่ห่อหุ้มวงจร AI ทั้งหมด
ความรู้ก่อนเรียน: หากทบทวนบทบาทของข้อมูล โมเดล และการประมวลผลจากหัวข้อ 15–17 มาก่อน จะช่วยให้เห็นว่ามนุษย์กำหนด ตรวจ และรับผิดชอบในแต่ละช่วงอย่างไร
เมื่ออ่านจบบทนี้ คุณจะทำอะไรได้
- ระบุผู้ตั้งเป้าหมาย ผู้สร้าง ผู้ใช้ ผู้อนุมัติ ผู้กำกับ และผู้ได้รับผลกระทบในระบบ AI ได้
- อธิบายได้ว่าการเลือกข้อมูล ตัวชี้วัด หน้าจอ และขั้นตอนทำงานเปลี่ยนผลลัพธ์อย่างไร
- เปรียบเทียบ Human-in-the-loop, Human-on-the-loop และ Human-out-of-the-loop ด้วยความเสี่ยงและอำนาจของคนได้
- ออกแบบเส้นทางตรวจ แก้ข้อมูล อุทธรณ์ หยุด และกู้คืนระบบได้
- ตรวจระบบหนึ่งระบบด้วยแผนที่บทบาท หลักฐาน เกณฑ์ผ่าน และเจ้าของความเสี่ยงได้
1. มนุษย์ไม่ได้อยู่นอกระบบ แต่ล้อมรอบวงจร AI
เวลาพูดว่า “AI ตัดสินใจ” เรามักย่อสายงานหลายชั้นให้เหลือคำเดียว ในความจริง โมเดลอาจคืนเพียงคะแนน เช่น 0.78 หรือข้อความหนึ่งย่อหน้า จากนั้นซอฟต์แวร์ใช้กฎแปลงคะแนนเป็นสถานะ หน้าจอจัดลำดับแฟ้ม เจ้าหน้าที่เลือกว่าจะอ่านอะไร ผู้จัดการกำหนดโควตา และองค์กรเป็นผู้ส่งจดหมายตอบผู้สมัคร ผลกระทบจึงเกิดจากการต่อกันของการตัดสินใจโดยคนกับการคำนวณของเครื่อง ไม่ได้เกิดจากโมเดลลำพัง
ในกรณีทุน ระบบรับข้อมูลการเรียน รายได้ กิจกรรม และข้อความอธิบายเหตุจำเป็น แล้วแปลงเป็นคุณลักษณะสำหรับโมเดล โมเดลคืนคะแนนความสอดคล้องกับเกณฑ์เดิม ระบบจัดอันดับ ผู้ตรวจเปิดแฟ้มบางส่วน และคณะกรรมการอนุมัติรายชื่อ หากทุกคนเห็นเฉพาะอันดับสุดท้าย คนจะรู้สึกว่า AI เป็นผู้เลือก ทั้งที่คนกำหนดทุกจุดตั้งแต่คำว่า “สมควรได้รับทุน” ไปจนถึงจำนวนแฟ้มที่มนุษย์มีเวลาตรวจ
ภาพจำที่แม่นกว่าคือวงจรที่มีคนอยู่รอบเครื่อง คนตั้งเป้าหมาย คนเลือกสิ่งที่นับเป็นหลักฐาน คนสร้างและทดสอบ คนใช้ผล คนติดตามเหตุผิดปกติ คนรับฟังข้อร้องเรียน และคนที่มีอำนาจหยุดหรือเปลี่ยนระบบ บางคนอยู่ในองค์กร บางคนอยู่นอกองค์กร และบางคนเป็นผู้ได้รับผลกระทบโดยไม่ได้เลือกใช้ระบบเลย
คำว่า “มนุษย์กำกับ” จึงต้องแปลงเป็นคำถามที่ตรวจได้ ใครเป็นผู้ตัดสินใจเรื่องใด เขาเห็นข้อมูลก่อนตัดสินใจมากพอหรือไม่ มีเวลาเท่าไร ถูกกดดันด้วยตัวชี้วัดแบบใด ปฏิเสธคำแนะนำของระบบได้หรือไม่ และเมื่อปฏิเสธแล้วเกิดอะไรต่อ หากตอบไม่ได้ เราเพียงติดป้ายว่ามีมนุษย์ แต่ยังไม่รู้ว่าการกำกับทำงานจริงหรือไม่
เป้าหมายของ AI ไม่เท่ากับคุณค่าของสังคม
โมเดลสามารถปรับตัวให้คะแนนบางอย่างดีขึ้น เช่น ความถูกต้องในการทำนายผู้สมัครที่คณะกรรมการเคยเลือก แต่คะแนนนั้นไม่ตอบเองว่าทุนควรช่วยใคร ความเป็นธรรมหมายถึงอะไร หรือควรยอมรับความผิดพลาดแบบใด เป้าหมายเชิงคุณค่าเหล่านี้ต้องมาจากมนุษย์และต้องเปิดให้ตรวจสอบ เพราะการเลือกตัวชี้วัดหนึ่งตัวเท่ากับเลือกว่าจะมองเห็นอะไรและมองข้ามอะไร
ถ้าเราใช้ “ตรงกับผู้ได้รับทุนในอดีต” เป็นเป้าหมาย โมเดลอาจเรียนรู้รูปแบบของการตัดสินใจเดิม รวมทั้งข้อจำกัดเดิม หากผู้สมัครจากพื้นที่ชนบทเคยส่งเอกสารไม่ครบเพราะเข้าถึงบริการยาก ระบบอาจตีความความไม่ครบเป็นสัญญาณลบ ทั้งที่เป้าหมายจริงของทุนคือช่วยคนที่มีศักยภาพและขาดโอกาส การกำหนดเป้าหมายจึงต้องเริ่มจากผลลัพธ์ที่ต้องการในโลกจริง ไม่ใช่เพียงคอลัมน์ที่หาได้ง่ายในฐานข้อมูล
2. แผนที่ผู้เกี่ยวข้อง: ใครทำอะไร เห็นอะไร และตอบต่อใคร
คำว่า “มนุษย์” รวมคนหลายกลุ่มที่มีอำนาจและแรงจูงใจต่างกัน เจ้าหน้าที่ข้อมูลอาจเน้นความครบถ้วน นักพัฒนาอาจเน้นความเสถียร ผู้บริหารอาจเน้นเวลาการทำงาน ผู้ตรวจอาจต้องรีบปิดงาน และผู้สมัครต้องการความเป็นธรรม หากเราไม่แยกบทบาท ความรับผิดชอบจะละลายไปในคำว่า “ทีม” จนไม่มีใครรู้ว่าใครต้องลงมือเมื่อระบบผิด
| บทบาท | การตัดสินใจหลัก | หลักฐานที่ควรมี |
|---|---|---|
| เจ้าของเป้าหมาย | ทุนต้องช่วยใคร ห้ามใช้ระบบทำอะไร และความผิดแบบใดรับไม่ได้ | วัตถุประสงค์ ขอบเขต Baseline เกณฑ์หยุด และผู้อนุมัติ |
| ทีมข้อมูลและผู้เชี่ยวชาญ | ข้อมูลใดมีความหมาย ป้ายกำกับใดสมเหตุผล และกลุ่มใดอาจไม่ถูกแทน | ที่มาข้อมูล นิยามฟิลด์ คู่มือการติดป้าย ข้อโต้แย้ง และการตรวจกลุ่มย่อย |
| ผู้สร้างระบบ | โมเดล กฎ หน้าจอ และลำดับงานแปลงข้อมูลเป็นคำแนะนำอย่างไร | รุ่น การตั้งค่า ผลทดสอบ Failure Case และบันทึกการเปลี่ยนแปลง |
| ผู้ใช้ผล | ควรรับ เชื่อ ปฏิเสธ หรือส่งต่อคำแนะนำเมื่อใด | คู่มือ เวลา ข้อมูลประกอบ อำนาจปฏิเสธ และช่องทางขอความช่วยเหลือ |
| ผู้ได้รับผลกระทบ | จะรู้ แก้ข้อมูล ขอเหตุผล หรืออุทธรณ์ได้อย่างไร | คำแจ้ง ช่องทางติดต่อ กำหนดเวลา ผู้ทบทวน และบันทึกการเยียวยา |
| เจ้าของความเสี่ยง | เมื่อใดต้องลดขอบเขต หยุด ย้อนรุ่น แจ้งเหตุ หรือชดเชย | Metric Alert อำนาจสั่งการ Runbook และผลการทบทวนหลังเหตุการณ์ |
ตารางนี้ไม่ใช่รายชื่อตำแหน่งตายตัว องค์กรเล็กอาจให้คนเดียวรับหลายบทบาท แต่ต้องแยกหมวกให้ชัด เช่น คนที่สร้างโมเดลสามารถตรวจคุณภาพทางเทคนิคได้ แต่การอนุมัติว่าความเสี่ยงต่อสิทธิยอมรับได้ควรมีเจ้าของที่รับผิดชอบต่อผู้ได้รับผลกระทบด้วย การแยกบทบาทช่วยให้เห็นความขัดแย้งทางผลประโยชน์และทำให้การส่งต่องานไม่หายไปกลางทาง
ในกรณีเมย์ เจ้าหน้าที่รับสมัครรู้ว่าช่องรายได้ว่างอาจเกิดจากรูปแบบงานที่ไม่มีเอกสาร นักพัฒนาอาจไม่รู้บริบทนี้ หากทีมข้อมูลแปลงค่าว่างเป็นศูนย์หรือ “ไม่มีรายได้” โดยไม่ถามผู้เชี่ยวชาญ ความหมายจะเปลี่ยนก่อนถึงโมเดล เมื่อผลผิด การถามว่า “ใครเขียนโค้ด” จึงไม่พอ ต้องย้อนดูว่าใครนิยามฟิลด์ ใครอนุมัตินิยาม ใครทดสอบ และใครมีอำนาจแก้แบบฟอร์ม
3. ก่อนสร้างระบบ: มนุษย์ต้องพิสูจน์ว่าโจทย์สมควรใช้ AI
ขั้นแรกไม่ใช่เลือกโมเดล แต่คืออธิบายการตัดสินใจที่ต้องดีขึ้น ในงานทุน ปัญหาอาจเป็น “เจ้าหน้าที่อ่านใบสมัครไม่ทัน” ไม่ใช่ “ต้องจัดอันดับคนให้แม่นที่สุด” สองประโยคนี้นำไปสู่ระบบต่างกัน ระบบแรกอาจช่วยสรุปและตรวจความครบถ้วนโดยยังให้คนตัดสิน ส่วนระบบหลังอาจสร้างอันดับที่ดูเด็ดขาดและทำให้แฟ้มท้ายรายการไม่ถูกอ่านเลย
ทีมควรบันทึก Baseline หรือวิธีเดิมก่อน เช่น เวลาที่ใช้ต่อแฟ้ม อัตราเอกสารตกหล่น ความสม่ำเสมอระหว่างผู้ตรวจ และจำนวนคำร้องที่แก้ผลได้ Baseline ไม่ได้มีไว้พิสูจน์ว่า AI ดีกว่า แต่มีไว้บอกว่าปัญหาเดิมคืออะไร ถ้าไม่รู้ เราอาจลดเวลาได้จริงแต่เพิ่มการพลาดผู้สมัครกลุ่มหนึ่งโดยไม่เห็น
จากนั้นระบุผลกระทบของความผิดสองทิศ False Positive คือระบบดันแฟ้มที่ไม่ตรงเกณฑ์ขึ้นมา ทำให้เสียเวลาตรวจเพิ่ม False Negative คือระบบกดแฟ้มที่ควรได้รับการพิจารณาลงไป ทำให้คนพลาดโอกาส ความผิดสองแบบมีต้นทุนไม่เท่ากัน การกำหนด Threshold หรือจำนวนแฟ้มที่อ่านจึงเป็นการตัดสินใจเชิงคุณค่า ไม่ใช่เพียงค่าทางเทคนิค
ต้องพิจารณาทางเลือกที่ง่ายกว่า AI ด้วย เช่น ปรับแบบฟอร์ม เพิ่มกติกาตรวจความครบถ้วน แบ่งงานใหม่ หรือสุ่มตรวจแฟ้มจากท้ายรายการ หากกฎธรรมดาแก้คอขวดได้และตรวจสอบง่ายกว่า การใช้ AI อาจเพิ่มภาระโดยไม่เพิ่มคุณค่า ระบบที่เหมาะสมไม่ใช่ระบบที่ใช้เทคโนโลยีมากที่สุด แต่เป็นระบบที่ทำให้ผลลัพธ์ดีขึ้นภายใต้ความเสี่ยงที่จัดการได้
Decision Rule ก่อนเริ่ม
- เป้าหมาย: อธิบายผลลัพธ์ที่ต้องดีขึ้นโดยไม่พูดชื่อเทคโนโลยี
- ผู้ได้รับผล: ระบุคนที่ได้ประโยชน์ คนที่รับความเสี่ยง และคนที่ไม่มีสิทธิ์เลือก
- Baseline: วัดวิธีเดิมด้วยเกณฑ์เดียวกับวิธีใหม่
- ทางเลือก: เปรียบเทียบกฎ กระบวนการ และการเพิ่มทรัพยากรกับ AI
- Stop Rule: ระบุเงื่อนไขที่ทำให้ไม่เริ่ม ทดลองต่อไม่ได้ หรือจำเป็นต้องหยุด
4. ระหว่างพัฒนา: คนเลือกสิ่งที่ระบบจะเรียนและสิ่งที่ใช้วัด
ข้อมูลไม่ใช่ภาพสะท้อนโลกที่เป็นกลาง มันคือร่องรอยของขั้นตอนเดิม ใบสมัครที่บันทึกไว้มีเฉพาะสิ่งที่แบบฟอร์มเคยถาม ป้าย “ผ่าน” สะท้อนการตัดสินใจของคณะกรรมการเดิม และแฟ้มที่ขาดเอกสารอาจหายไปก่อนเข้าสู่ฐานข้อมูล ถ้านำข้อมูลนี้ไปฝึกโดยไม่ทำความเข้าใจ กระบวนการเดิมจะถูกบีบอัดเข้าโมเดลพร้อมข้อจำกัดที่มองไม่เห็น
ทีมข้อมูลต้องถามว่าหนึ่งแถวแทนใคร หนึ่งฟิลด์เกิดขึ้นอย่างไร และค่าที่หายหมายถึงอะไร ในกรณีเมย์ ค่าว่างอาจหมายถึงไม่มีรายได้ ไม่ทราบรายได้ ไม่มีเอกสาร ระบบบันทึกล้มเหลว หรือผู้สมัครไม่สะดวกเปิดเผย ความหมายเหล่านี้ต้องการการจัดการต่างกัน การแทนทุกกรณีด้วยเลขศูนย์ทำให้โมเดลเห็นเรื่องคนละแบบเป็นสิ่งเดียวกัน
การติดป้ายก็เป็นการใช้ดุลยพินิจ หากผู้ตรวจสองคนตีความ “ความจำเป็นทางการเงิน” ต่างกัน ป้ายไม่ได้เป็นความจริงสมบูรณ์ ทีมควรมีคู่มือติดป้าย ตัวอย่างกรณีขอบ ช่องให้ระบุความไม่แน่ใจ และการวัดความสอดคล้องระหว่างผู้ตรวจ เมื่อเห็นความขัดแย้ง ไม่ควรรีบเฉลี่ยทิ้ง แต่ใช้เป็นสัญญาณว่านิยามเป้าหมายยังไม่ชัด
ตัวชี้วัดรวมอาจซ่อนกลุ่มย่อย สมมติระบบเรียงแฟ้มได้ตรงกับการตัดสินเดิม 90% แต่ความสอดคล้องในผู้สมัครชนบทต่ำกว่ามาก ค่าเฉลี่ยเดียวไม่บอกปัญหา ทีมต้องตรวจตามกลุ่มที่เกี่ยวข้องกับบริบทและกฎหมายโดยไม่สร้างการแบ่งกลุ่มที่ละเมิดความเป็นส่วนตัว เป้าหมายไม่ใช่บังคับให้ทุกตัวเลขเท่ากันเสมอ แต่คือมองเห็นว่าความผิดเกิดกับใคร ผ่านกลไกใด และยอมรับได้หรือไม่
นอกจากโมเดล ต้องทดสอบกฎและหน้าจอด้วย โมเดลอาจคืนคะแนนถูก แต่หน้าจอปัดเศษ ซ่อนความไม่แน่นอน หรือเรียงอันดับแบบทำให้ผู้ตรวจคิดว่าคะแนนต่างกันมาก หากปุ่ม “อนุมัติ” ใหญ่และ “ขอข้อมูลเพิ่ม” ถูกซ่อนไว้ พฤติกรรมคนจะเปลี่ยน การประเมินระบบจึงต้องทดสอบ Input → Model → Rule → Interface → Human Action → Outcome ครบสาย ไม่หยุดที่ Accuracy ของโมเดล
ทุกการเปลี่ยนแปลงควรมี Version และเหตุผล รุ่นข้อมูล รุ่นโมเดล Threshold ข้อความบนหน้าจอ และคู่มือผู้ใช้ต่างเปลี่ยนผลได้ หากแก้ค่าหนึ่งโดยไม่บันทึก เราจะย้อนอธิบายไม่ได้ว่าเหตุใดผู้สมัครสองคนที่คล้ายกันจึงได้รับการปฏิบัติต่างกัน หลักฐานที่ดีไม่ต้องเก็บข้อมูลส่วนตัวทุกอย่าง แต่ต้องพอเชื่อมเหตุการณ์กับรุ่นและขั้นตอนที่เกี่ยวข้อง
Golden Case และ Counterexample
ก่อนเปิดใช้ ทีมควรสร้างชุดตัวอย่างที่รู้เหตุผลล่วงหน้า Golden Case คือกรณีปกติที่ระบบต้องจัดการได้ Counterexample คือกรณีที่คล้ายกันแต่ควรได้ผลต่าง เช่น ผู้สมัครสองคนมีช่องรายได้ว่างเหมือนกัน คนหนึ่งเลือกไม่เปิดเผย อีกคนไม่มีเอกสารเพราะทำงานนอกระบบ ถ้าระบบปฏิบัติเหมือนกันโดยไม่มีเส้นทางขอข้อมูลเพิ่ม แปลว่าสายงานตัดความหมายสำคัญทิ้ง
ชุดทดสอบต้องรวมกรณีเคยพลาด กรณีขอบ ภาษาที่หลากหลาย เอกสารรูปแบบต่างกัน และข้อมูลที่ขัดแย้งกัน ผลทดสอบควรบอกไม่เพียงว่าถูกหรือผิด แต่บอกว่าความผิดอยู่ขั้นไหนและใครต้องรับต่อ เมื่อพบกรณีใหม่จากคำร้องที่ยืนยันแล้ว ควรเพิ่มเข้าชุดทดสอบแบบไม่เปิดเผยข้อมูลเกินจำเป็น เพื่อให้ระบบเรียนรู้จากเหตุจริงโดยไม่ทำให้ผู้ร้องเสียความเป็นส่วนตัวซ้ำอีก
5. Human-in, on และ out of the loop ต่างกันที่จุดตัดสินใจและความเสี่ยง
คำสามคำนี้ช่วยอธิบายตำแหน่งของคน แต่ไม่ใช่มาตรฐานเดียวที่ใช้เหมือนกันทุกองค์กร เราจึงควรระบุความหมายที่ใช้ในบทเรียนนี้ให้ชัด Human-in-the-loop หมายถึงคนตัดสินใจหรืออนุมัติในขั้นตอนปกติ Human-on-the-loop หมายถึงระบบทำงานได้เองในขอบเขตหนึ่ง ขณะที่คนติดตามและแทรกแซงเมื่อเกิดสัญญาณ Human-out-of-the-loop หมายถึงไม่มีคนตรวจรายกรณีระหว่างการทำงาน แต่ยังต้องมีคนกำหนดขอบเขต ติดตามผล และรับผิดชอบระบบ
| รูปแบบ | คนตัดสินใจเมื่อใด | เหมาะเมื่อ | จุดล้มเหลวที่ต้องระวัง |
|---|---|---|---|
| Human-in-the-loop | ตรวจหรืออนุมัติทุกกรณีสำคัญก่อนเกิดการกระทำ | ผลกระทบสูง ต้องใช้บริบท หรือข้อยกเว้นเกิดบ่อย | คนอาจกดตามระบบเพราะเวลาไม่พอ ข้อมูลไม่ครบ หรือไม่มีอำนาจปฏิเสธ |
| Human-on-the-loop | ติดตามภาพรวมและเข้าแทรกเมื่อ Metric หรือ Alert เกินเกณฑ์ | งานปริมาณสูง ขอบเขตชัด และสามารถหยุดหรือย้อนกลับได้เร็ว | Alert ช้า สัญญาณไม่สัมพันธ์กับผลกระทบ หรือคนหนึ่งดูระบบมากเกินไป |
| Human-out-of-the-loop | ไม่ตรวจรายกรณี แต่กำหนดขอบเขต ทดสอบ ติดตาม และทบทวนเป็นรอบ | งานความเสี่ยงต่ำ ผลย้อนกลับได้ และความผิดไม่กระทบสิทธิสำคัญ | ระบบค่อย ๆ ออกจากขอบเขตโดยไม่มีใครเห็น หรือผู้ได้รับผลไม่มีทางขอแก้ |
คำถามสำคัญไม่ใช่ “แบบใดทันสมัยกว่า” แต่คือ “ถ้าระบบผิด คนจะเห็นทันหรือไม่ และหยุดความเสียหายได้หรือไม่” ระบบคัดกรองทุนไม่ควรใช้คะแนนปิดสิทธิ์โดยไม่มีการทบทวน เพราะผลกระทบสูงและข้อมูลมีข้อยกเว้นมาก การใช้ AI ช่วยจัดลำดับเพื่อให้คนอ่านก่อนอาจทำได้ แต่ต้องสุ่มตรวจท้ายรายการ เปิดทางขอข้อมูลเพิ่ม และห้ามใช้คะแนนเป็นเหตุผลเดียวในการปฏิเสธ
การมีคนในลูปไม่ได้ทำให้ปลอดภัยอัตโนมัติ หากคนไม่มีเวลา ไม่มีบริบท ถูกวัดจากความเร็ว หรือเชื่อว่าคอมพิวเตอร์ต้องถูกกว่า เขาอาจกลายเป็นตราประทับให้ระบบ การออกแบบต้องมองคนเป็นส่วนหนึ่งของกลไก ไม่ใช่เครื่องมือสำรองที่ไม่มีข้อจำกัด
6. การตรวจโดยมนุษย์มีความหมายเมื่อมีข้อมูล เวลา ทักษะ และอำนาจ
ลองให้เจ้าหน้าที่ทุนตรวจแฟ้มหนึ่งภายในห้าวินาที หน้าจอแสดงเพียง “คะแนน 0.32 — ไม่แนะนำ” และผู้จัดการติดตามจำนวนแฟ้มที่ปิดได้ต่อชั่วโมง แม้มีปุ่มปฏิเสธคำแนะนำ แต่สภาพงานผลักให้กดตามระบบ นี่คือ Automation Bias หรือแนวโน้มเชื่อคำแนะนำอัตโนมัติมากเกินไป ซึ่งไม่ได้เกิดจากนิสัยคนอย่างเดียว แต่เกิดจากการออกแบบข้อมูล แรงกดดัน และความรับผิดที่ไม่สมดุล
ผู้ตรวจควรเห็นข้อมูลที่จำเป็นต่อเหตุผล ไม่ใช่ข้อมูลทั้งหมดจนล้น ในกรณีเมย์ หน้าจอควรแยกว่าช่องรายได้ “ไม่มีข้อมูล” ไม่ใช่ “รายได้ศูนย์” แสดงแหล่งและวันที่ของข้อมูล ชี้ว่าคะแนนส่วนใดไม่แน่นอน และเสนอการกระทำหลายทาง เช่น ขอเอกสารเพิ่ม ส่งต่อผู้เชี่ยวชาญ หรือสุ่มตรวจ ไม่ควรแสดงคะแนนทศนิยมที่ดูแม่นเกินความหมายโดยไม่มีคำอธิบาย
เวลาเป็นส่วนของความปลอดภัย ถ้ากรณีหนึ่งต้องอ่านคำอธิบายและตรวจเอกสารสิบหน้า การจัดสรรเวลาสองนาทีทำให้ขั้นตอนมนุษย์เป็นพิธี ทีมต้องทดสอบงานกับคนจริงในสภาพใกล้การใช้งาน วัดเวลาที่ต้องใช้ ความเข้าใจคำอธิบาย ความสอดคล้องของการตัดสินใจ และสัญญาณเมื่อคนเหนื่อย ไม่ใช่ทดสอบว่าปุ่มกดได้เท่านั้น
ทักษะและการฝึกต้องตรงกับงาน เจ้าหน้าที่ควรรู้ว่าคะแนนคืออะไร ไม่ใช่อะไร โมเดลเคยทดสอบกับข้อมูลแบบใด กรณีใดอยู่นอกขอบเขต และเมื่อใดต้องส่งต่อ การอบรมครั้งเดียวก่อนเปิดระบบไม่พอเมื่อรุ่น ข้อมูล หรือกฎเปลี่ยน ทุกการเปลี่ยนที่มีผลต่อการตัดสินใจควรมาพร้อมการสื่อสาร ตัวอย่าง และช่วงตรวจติดตาม
อำนาจคือเงื่อนไขที่มักหาย ผู้ตรวจต้องปฏิเสธคำแนะนำได้โดยไม่ถูกลงโทษ ต้องมีทางส่งต่อที่มีคนรับจริง และต้องรู้ว่าใครอนุมัติข้อยกเว้น หากระบบบันทึกการ Override เป็น “ความผิดของพนักงาน” โดยไม่เปิดให้บันทึกเหตุผล คนจะหลีกเลี่ยงการใช้ดุลยพินิจ ระบบที่ดีจึงเก็บเหตุผลอย่างเป็นธรรมและใช้ข้อมูลนั้นปรับปรุงงาน ไม่ใช้เพื่อตำหนิคนโดยอัตโนมัติ
Checklist การตรวจที่มีความหมาย
- ผู้ตรวจเห็นอินพุตสำคัญ แหล่งข้อมูล วันที่ และความไม่แน่นอนหรือไม่
- มีเวลาพออ่านหลักฐานตามความซับซ้อนของกรณีหรือไม่
- เข้าใจขอบเขตโมเดลและความหมายของคะแนนหรือไม่
- เลือกปฏิเสธ ขอข้อมูลเพิ่ม ส่งต่อ หรือหยุดได้จริงหรือไม่
- เหตุผลการ Override ถูกนำไปเรียนรู้โดยไม่สร้างแรงลงโทษที่ผิดทิศหรือไม่
- มีเจ้าของรับงานต่อและกำหนดเวลาตอบกลับหรือไม่
7. ผู้ได้รับผลกระทบต้องรู้ แก้ข้อมูล ขอทบทวน และอุทธรณ์ได้
ผู้สมัครทุนไม่ได้เป็นผู้ซื้อระบบ แต่ผลของระบบอาจเปลี่ยนโอกาสทางการศึกษา การออกแบบจึงต้องเริ่มจากมุมของคนที่ถูกประเมิน เขารู้หรือไม่ว่า AI มีบทบาทสำคัญ ข้อมูลใดถูกใช้ ข้อมูลผิดแก้อย่างไร ขอให้คนทบทวนได้ที่ไหน และจะได้รับคำตอบเมื่อใด การมีอีเมลทั่วไปที่ไม่มีเจ้าของไม่ใช่กลไกอุทธรณ์ที่ใช้งานได้
คำอธิบายที่มีประโยชน์ไม่จำเป็นต้องเปิดโค้ดหรือรายละเอียดโมเดลทั้งหมด แต่ต้องช่วยให้คนทำอะไรต่อได้ เช่น “ใบสมัครถูกส่งไปขอข้อมูลเพิ่มเพราะไม่พบหลักฐานรายได้ตามรูปแบบที่กำหนด คุณสามารถส่งเอกสารทางเลือกหรือคำรับรองได้ภายในวันที่…” ข้อความนี้ต่างจาก “คะแนนไม่ถึงเกณฑ์” เพราะบอกปัจจัย การกระทำ และเวลา
การแก้ข้อมูลกับการอุทธรณ์ไม่เหมือนกัน การแก้ข้อมูลใช้เมื่อข้อเท็จจริงผิดหรือไม่ครบ เช่น ชื่อ รายได้ หรือเอกสาร การอุทธรณ์ใช้เมื่อข้อมูลอาจถูกต้องแต่การตีความหรือเกณฑ์ไม่เป็นธรรม ผู้ทบทวนควรมีอำนาจพิจารณาหลักฐานใหม่ ไม่ใช่เพียงกดรันโมเดลเดิมอีกครั้ง หากระบบส่งคำร้องกลับเข้ากลไกเดิมโดยไม่มีคนอ่าน ผลเดิมจะถูกทำซ้ำพร้อมภาพลวงว่ามีการทบทวนแล้ว
ช่องทางต้องเข้าถึงได้ ภาษาต้องชัด ใช้ได้บนมือถือ รองรับผู้พิการ และมีทางเลือกสำหรับคนที่ไม่มีอินเทอร์เน็ตหรือเอกสารมาตรฐาน ระยะเวลาตอบควรสัมพันธ์กับเส้นตายจริง หากผลทุนประกาศพรุ่งนี้แต่คำอุทธรณ์ใช้สามสิบวัน สิทธิ์นั้นไม่มีผลในทางปฏิบัติ
ข้อร้องเรียนยังเป็นข้อมูลคุณภาพที่สำคัญ แต่ต้องใช้อย่างระมัดระวัง ทีมควรจัดหมวดเหตุ เช่น ข้อมูลผิด นิยามไม่ชัด ระบบอ่านเอกสารพลาด หรือผู้ตรวจไม่มีข้อมูล แล้วเชื่อมกับรุ่นและขั้นตอนที่เกี่ยวข้อง ไม่ควรคัดลอกเรื่องราวส่วนตัวทั้งหมดเข้าสู่ชุดฝึกโดยอัตโนมัติ การปรับปรุงคุณภาพต้องไม่สร้างการละเมิดความเป็นส่วนตัวรอบใหม่
8. ความรับผิดชอบต้องมีเจ้าของ สัญญาณ อำนาจ และทางกู้คืน
คำว่า Accountability ไม่ได้หมายถึงหาคนรับโทษเมื่อเกิดเหตุเท่านั้น มันหมายถึงการกำหนดล่วงหน้าว่าใครต้องรักษาคุณภาพ ใครดูผลกระทบ ใครรับคำร้อง ใครตัดสินใจหยุด และใครสื่อสารกับผู้ได้รับผล หากบทบาทเหล่านี้ไม่มีชื่อ งานจะค้างระหว่างทีมและความเสียหายจะดำเนินต่อในระหว่างที่ทุกคนคิดว่าเป็นหน้าที่คนอื่น
แยกเจ้าของคุณภาพข้อมูล โมเดล กระบวนการ สิทธิผู้ใช้ และเหตุการณ์ร้ายแรง พร้อมผู้สำรอง
เลือก Metric ที่เชื่อมกับผลกระทบ เช่น อัตราคำร้องที่ยืนยันว่าข้อมูลผิด ความต่างระหว่างกลุ่ม เวลาแก้ และจำนวน Override
ระบุว่าใครลดขอบเขต ปิดฟังก์ชัน ย้อนรุ่น หยุดการตัดสินใจ หรือขอให้ตรวจย้อนหลังได้
เตรียมวิธีกลับไปใช้กระบวนการเดิม แจ้งผู้เกี่ยวข้อง แก้ผลที่เกิดแล้ว และติดตามคนที่อาจพลาดโอกาส
วิเคราะห์สาเหตุระดับระบบ เพิ่มกรณีทดสอบ แก้นโยบายและหน้าจอ แล้วตรวจว่าการแก้ลดความเสี่ยงจริง
สัญญาณต้องไม่หยุดที่สถานะเซิร์ฟเวอร์ ระบบอาจออนไลน์ 100% แต่เลือกคนผิดอย่างสม่ำเสมอ Metric จึงต้องมีทั้งสุขภาพระบบ คุณภาพคำแนะนำ พฤติกรรมผู้ตรวจ ผลลัพธ์ต่อคน และภาระการเยียวยา ในกรณีทุน อาจดูอัตราแฟ้มค่าว่างที่ตกท้าย อัตราการสุ่มตรวจแล้วเปลี่ยนผล เวลาเฉลี่ยในการอุทธรณ์ และสัดส่วนคำร้องที่พบข้อผิดพลาดจริง
Threshold สำหรับหยุดต้องสัมพันธ์กับความรุนแรง เหตุการณ์หนึ่งที่ตัดสิทธิ์ผิดอย่างร้ายแรงอาจสำคัญกว่าความคลาดเคลื่อนเล็กน้อยหลายสิบครั้ง ทีมควรกำหนดระดับเหตุและการตอบสนอง เช่น ระดับเฝ้าดู ระดับลดขอบเขต และระดับหยุดทันที พร้อมบันทึกว่าใครตัดสินใจและใช้หลักฐานใด
Rollback หรือการย้อนกลับไม่ใช่เพียงเปลี่ยนรุ่นโมเดล หากกฎ หน้าจอ หรือกระบวนการคนเปลี่ยนพร้อมกัน ต้องรู้ว่าจะย้อนส่วนใดและผลเก่าที่เกิดแล้วแก้อย่างไร ในกรณีเมย์ การแก้ระบบในอนาคตยังไม่คืนโอกาสให้เธอ ต้องมีการค้นหาแฟ้มที่ได้รับผลจากเงื่อนไขเดียวกัน ติดต่อผู้สมัคร เปิดการทบทวน และบันทึกการเยียวยา
NIST AI RMF จัดการความเสี่ยงผ่านหน้าที่ Govern, Map, Measure และ Manage ซึ่งเตือนว่าการกำกับไม่ใช่ด่านสุดท้าย ส่วน OECD และ UNESCO เน้นความรับผิดชอบ ความโปร่งใส การติดตามย้อนกลับ และการไม่ผลักความรับผิดชอบขั้นสุดท้ายออกจากมนุษย์ หลักเหล่านี้ไม่ใช่ Checklist สำเร็จรูป องค์กรต้องแปลงให้เป็นเจ้าของ หลักฐาน และการกระทำที่เหมาะกับบริบทของตน
9. ย้อนรอยกรณีเมย์: ความผิดหนึ่งครั้งเกิดจากหลายชั้นอย่างไร
ขั้นรับข้อมูล: เมย์เว้นช่องรายได้เพราะครอบครัวไม่มีสลิปเงินเดือน แบบฟอร์มไม่ได้อธิบายเอกสารทางเลือกและระบบรับสมัครไม่แยก “ไม่ทราบ” จาก “ไม่มีรายได้” จุดนี้เจ้าของแบบฟอร์มและทีมข้อมูลมีหน้าที่นิยามความหมายและให้ทางเลือกที่เข้าถึงได้
ขั้นเตรียมข้อมูล: สายงานแทนค่าว่างด้วยศูนย์เพื่อให้โมเดลรับตัวเลขได้ การแปลงทางเทคนิคเปลี่ยนความหมายโดยไม่มี Alert นักพัฒนาควรใช้ Data Contract ตรวจค่าที่ขาด แยกสถานะ และส่งกรณีที่ตีความไม่ได้ไปขอข้อมูลเพิ่มแทนการเดา
ขั้นโมเดล: ข้อมูลอดีตมีผู้สมัครลักษณะเดียวกันน้อย โมเดลจึงให้คะแนนต่ำและความไม่แน่นอนสูง แต่ API ส่งออกเพียงคะแนนเดียว ทีมโมเดลควรบันทึกข้อจำกัด ตรวจกลุ่มย่อย และส่งสัญญาณความไม่แน่นอนให้ขั้นถัดไป ไม่ใช่ซ่อนอยู่ในรายงานที่ผู้ใช้ไม่เห็น
ขั้นกฎและหน้าจอ: ระบบเรียงจากคะแนนสูงไปต่ำและเจ้าหน้าที่มีเวลาตรวจเพียงครึ่งบนของรายการ หน้าจอไม่บอกว่าข้อมูลขาด ผลลัพธ์จึงเปลี่ยนจาก “คะแนนไม่แน่นอน” เป็น “แฟ้มไม่ได้รับการอ่าน” ผู้กำหนดกฎและออกแบบ Workflow ต้องรับผิดชอบการแปลงนี้
ขั้นมนุษย์ตรวจ: เจ้าหน้าที่เห็นคะแนนแต่ไม่เห็นเหตุผล ถูกวัดจากความเร็วและไม่มีปุ่มขอข้อมูลเพิ่ม การบอกว่ามี Human-in-the-loop จึงไม่สะท้อนความจริง ผู้จัดการต้องจัดเวลา เครื่องมือ การฝึก และอำนาจให้การตรวจมีความหมาย
ขั้นแจ้งผล: เมย์ได้รับข้อความว่า “ไม่ผ่านเกณฑ์” โดยไม่มีข้อมูลว่าแก้อะไรได้ ช่องทางติดต่อใช้เวลานานกว่ากำหนดรับทุน เจ้าของบริการต้องออกแบบคำอธิบายและการอุทธรณ์ที่ทำงานทันเวลา
ขั้นเรียนรู้: เมื่อคำร้องมาถึง ทีมไม่ควรแก้เพียงแฟ้มเดียว ต้องค้นหาว่ามีผู้สมัครอื่นได้รับผลจากค่าว่างแบบเดียวกันหรือไม่ หยุดหรือจำกัดกฎที่ผิด แก้ Data Contract เพิ่มชุดทดสอบ และติดตามว่าการแก้ลดปัญหาจริงหรือสร้างปัญหาใหม่
สิ่งที่กรณีนี้สอน
ไม่มีจุดใดจุดหนึ่งที่เรียกว่า “AI ผิด” แล้วจบ ความผิดเกิดจากนิยามฟิลด์ การแปลงข้อมูล ข้อจำกัดโมเดล กฎจัดอันดับ หน้าจอ ภาระงาน และช่องทางอุทธรณ์ต่อกัน การรับผิดชอบจึงต้องติดตามสายเหตุและผล ไม่ใช่ผลักปัญหาไปยังคนที่อยู่ใกล้ปุ่มสุดท้ายที่สุด
10. สัญญาณอันตรายที่บอกว่ามนุษย์เป็นเพียงตราประทับ
- ไม่รู้ว่าใครเป็นเจ้าของ: ทุกทีมบอกว่าตนดูเพียงส่วนหนึ่งและไม่มีคนรับผลกระทบปลายทาง
- มีคะแนนแต่ไม่มีบริบท: ผู้ใช้เห็นความมั่นใจหรืออันดับโดยไม่เห็นแหล่งข้อมูล ความใหม่ หรือเหตุที่ต้องส่งต่อ
- Override ได้แต่ถูกลงโทษ: การปฏิเสธคำแนะนำทำให้ KPI แย่หรือเพิ่มงานโดยไม่มีการสนับสนุน
- อุทธรณ์กลับเข้าระบบเดิม: ไม่มีคนอ่านหลักฐานใหม่และไม่มีอำนาจแก้ผล
- Metric ดีแต่คำร้องเพิ่ม: ทีมดู Accuracy รวม ขณะที่ข้อร้องเรียนจากกลุ่มหนึ่งเพิ่มต่อเนื่อง
- เปลี่ยนรุ่นโดยไม่เปลี่ยนคู่มือ: ผู้ใช้ยังตีความคะแนนด้วยความหมายเก่า
- ไม่มี Stop Rule: ทุกเหตุถูกแก้เป็นรายกรณีโดยระบบยังทำงานเต็มขอบเขต
- บันทึกมากเกินหรือไม่พอ: เก็บข้อมูลส่วนตัวทั้งหมดโดยไม่จำเป็น หรือไม่มี Version/เหตุผลให้ย้อนตรวจ
เมื่อพบสัญญาณเหล่านี้ ไม่ควรเริ่มด้วยการอบรมให้คน “ระวัง AI” เพียงอย่างเดียว ต้องแก้โครงสร้างที่สร้างพฤติกรรม เช่น ลดปริมาณงาน เพิ่มข้อมูลที่หน้าจอ เปลี่ยน KPI เพิ่มอำนาจหยุด และสร้างเส้นทางส่งต่อ การออกแบบที่ดีช่วยให้คนทำสิ่งที่ถูกได้ง่ายและมองเห็นเมื่อเงื่อนไขไม่เหมาะกับระบบ
อีกความเข้าใจผิดคือคิดว่าการเพิ่มคนตรวจมากขึ้นย่อมปลอดภัยกว่า หากงานซ้ำมาก คนเหนื่อยและเห็นผลของ AI ก่อนคิดเอง ความผิดอาจถูกขยายอย่างสม่ำเสมอ ทางแก้อาจเป็นการสุ่มตรวจแบบมีเป้าหมาย ปิดคะแนนชั่วคราวเพื่อให้คนประเมินอิสระ ใช้ผู้ตรวจสองคนในกรณีผลกระทบสูง หรือออกแบบให้ระบบขอข้อมูลเพิ่มแทนการบังคับตัดสินใจ
11. แบบฝึกลงมือทำ: วาดแผนที่มนุษย์รอบระบบหนึ่งระบบ
โจทย์
เลือกระบบ AI ที่คุณรู้จักหนึ่งระบบ เช่น ระบบคัดกรองใบสมัคร แชตบอตบริการลูกค้า ระบบแนะนำวิดีโอ หรือระบบช่วยอ่านเอกสาร แล้วทำแผนที่หนึ่งหน้า ใช้กระดาษ ตาราง หรือโปรแกรมวาดภาพก็ได้
- เขียนการกระทำปลายทาง: ระบบทำให้ใครเห็น ตัดสินใจ หรือได้รับอะไร อย่าเริ่มจากชื่อโมเดล
- ระบุผู้เกี่ยวข้อง: ใครตั้งเป้าหมาย เลือกข้อมูล สร้าง ใช้ อนุมัติ กำกับ และได้รับผล
- วาดสายข้อมูล: ข้อมูลมาจากใคร แปลงตรงไหน และผลใดถูกส่งให้คนใด
- ใส่อำนาจ: ใครปฏิเสธ ขอข้อมูลเพิ่ม ส่งต่อ หยุด ย้อนรุ่น หรือเยียวยาได้
- ใส่หลักฐาน: ระบุ Version, Log, Metric หรือเอกสารที่ต้องเห็นเมื่อผลผิด
- เพิ่ม Failure Case: เลือกหนึ่งจุดที่ข้อมูลผิดหรือคนไม่มีเวลา แล้วลากผลกระทบไปถึงผู้ใช้
- ออกแบบ Recovery: เขียน Action แรก เจ้าของ กำหนดเวลา และวิธีตรวจว่าการแก้สำเร็จ
เกณฑ์สำเร็จ
แผนที่ผ่านเมื่อคนอื่นอ่านแล้วตอบได้ว่า ใครรับผิดชอบการตัดสินใจแต่ละชั้น ผู้ได้รับผลกระทบขอแก้หรืออุทธรณ์ที่ไหน เหตุใดมนุษย์จึงปฏิเสธ AI ได้ และเมื่อระบบผิดใครหยุดความเสียหายกับแก้ผลย้อนหลัง
ถ้าติดขัด
หากหาเจ้าของไม่พบ อย่าเขียนว่า “ทีม AI” ให้ใช้ชื่อบทบาทชั่วคราว เช่น เจ้าของบริการหรือผู้อนุมัติความเสี่ยง แล้วทำเครื่องหมายว่านี่คือช่องว่างที่ต้องถาม หากไม่รู้ Metric ให้เริ่มจากเหตุที่ไม่อยากให้เกิด แล้วถามว่าสัญญาณใดจะปรากฏก่อน ระหว่าง และหลังเหตุ หากไม่มีทางย้อนกลับ ให้ลดขอบเขตการใช้งานจนผลกระทบย้อนแก้ได้
ตัวอย่างคำตอบย่อจากกรณีเมย์
การกระทำปลายทางคือจัดลำดับแฟ้มเพื่อให้เจ้าหน้าที่อ่าน ผู้กำหนดเป้าหมายคือคณะกรรมการทุน ทีมข้อมูลนิยามเอกสาร นักพัฒนาสร้างคะแนน เจ้าหน้าที่ใช้ผล ผู้จัดการอนุมัติกระบวนการ ผู้สมัครได้รับผล และเจ้าของความเสี่ยงมีอำนาจหยุด เกณฑ์ส่งต่อคือข้อมูลสำคัญว่าง ความไม่แน่นอนสูง หรือข้อมูลขัดแย้ง Recovery คือหยุดใช้กฎจัดอันดับกับแฟ้มลักษณะเดียวกัน ค้นหาแฟ้มย้อนหลัง ติดต่อผู้สมัคร และเพิ่มกรณีทดสอบก่อนเปิดอีกครั้ง
12. แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่ดีที่สุดให้ครบทุกข้อ แล้วกด “ตรวจคำตอบ” เพียงครั้งเดียว ระบบจะแสดง Feedback รายข้อ คะแนน และจำนวนข้อที่ยังไม่ได้ตอบ
13. สรุปและภาพจำ: ทุกบทบาทต้องมีข้อมูล เวลา อำนาจ และความรับผิดชอบ
กลับมาที่เมย์อีกครั้ง ปัญหาไม่ได้เริ่มเมื่อโมเดลให้คะแนนต่ำ และไม่ได้จบเมื่อเจ้าหน้าที่กดตามคำแนะนำ มันเริ่มตั้งแต่คนออกแบบแบบฟอร์ม นิยามค่าว่าง เลือกข้อมูล ตั้งเป้าหมาย สร้างกฎ จัดหน้าจอ และกำหนดภาระงาน จากนั้นยังต่อไปถึงคำแจ้ง ช่องทางอุทธรณ์ การค้นหาผู้ได้รับผลย้อนหลัง และการแก้ระบบไม่ให้เกิดซ้ำ
บทบาทของมนุษย์ในระบบ AI จึงมีสี่เงื่อนไขที่ควรจำ ข้อมูล เพื่อเห็นสิ่งที่จำเป็นต่อการตัดสินใจ เวลา เพื่อใช้ดุลยพินิจจริง อำนาจ เพื่อปฏิเสธ ส่งต่อ หยุด หรือเยียวยา และ ความรับผิดชอบ เพื่อให้รู้ว่าใครต้องลงมือเมื่อผลกระทบเกิดขึ้น หากขาดข้อใดข้อหนึ่ง คำว่า Human Oversight อาจเหลือเพียงป้ายสวยงาม
ระบบที่รับผิดชอบไม่ได้รับประกันว่าจะไม่ผิด แต่ทำให้ความผิดมองเห็นได้เร็ว จำกัดขอบเขตได้ ย้อนตรวจได้ และแก้ผลต่อคนได้ การออกแบบเช่นนี้ไม่ลดคุณค่าของ AI ตรงกันข้าม มันทำให้เรารู้ว่าควรเชื่อระบบเมื่อใด ไม่ควรใช้เมื่อใด และจะรักษาประโยชน์โดยไม่ผลักความเสี่ยงให้คนที่มีอำนาจน้อยที่สุดอย่างไร
Insight Gate: หากคุณวาดวงจรหนึ่งระบบแล้วระบุได้ว่าใครกำหนด ใครสร้าง ใครตรวจ ใครได้รับผล ใครรับคำร้อง และใครหยุด พร้อมบอกข้อมูล เวลา อำนาจ และหลักฐานของแต่ละบทบาท คุณเข้าใจบทบาทของมนุษย์ในระบบ AI แล้ว
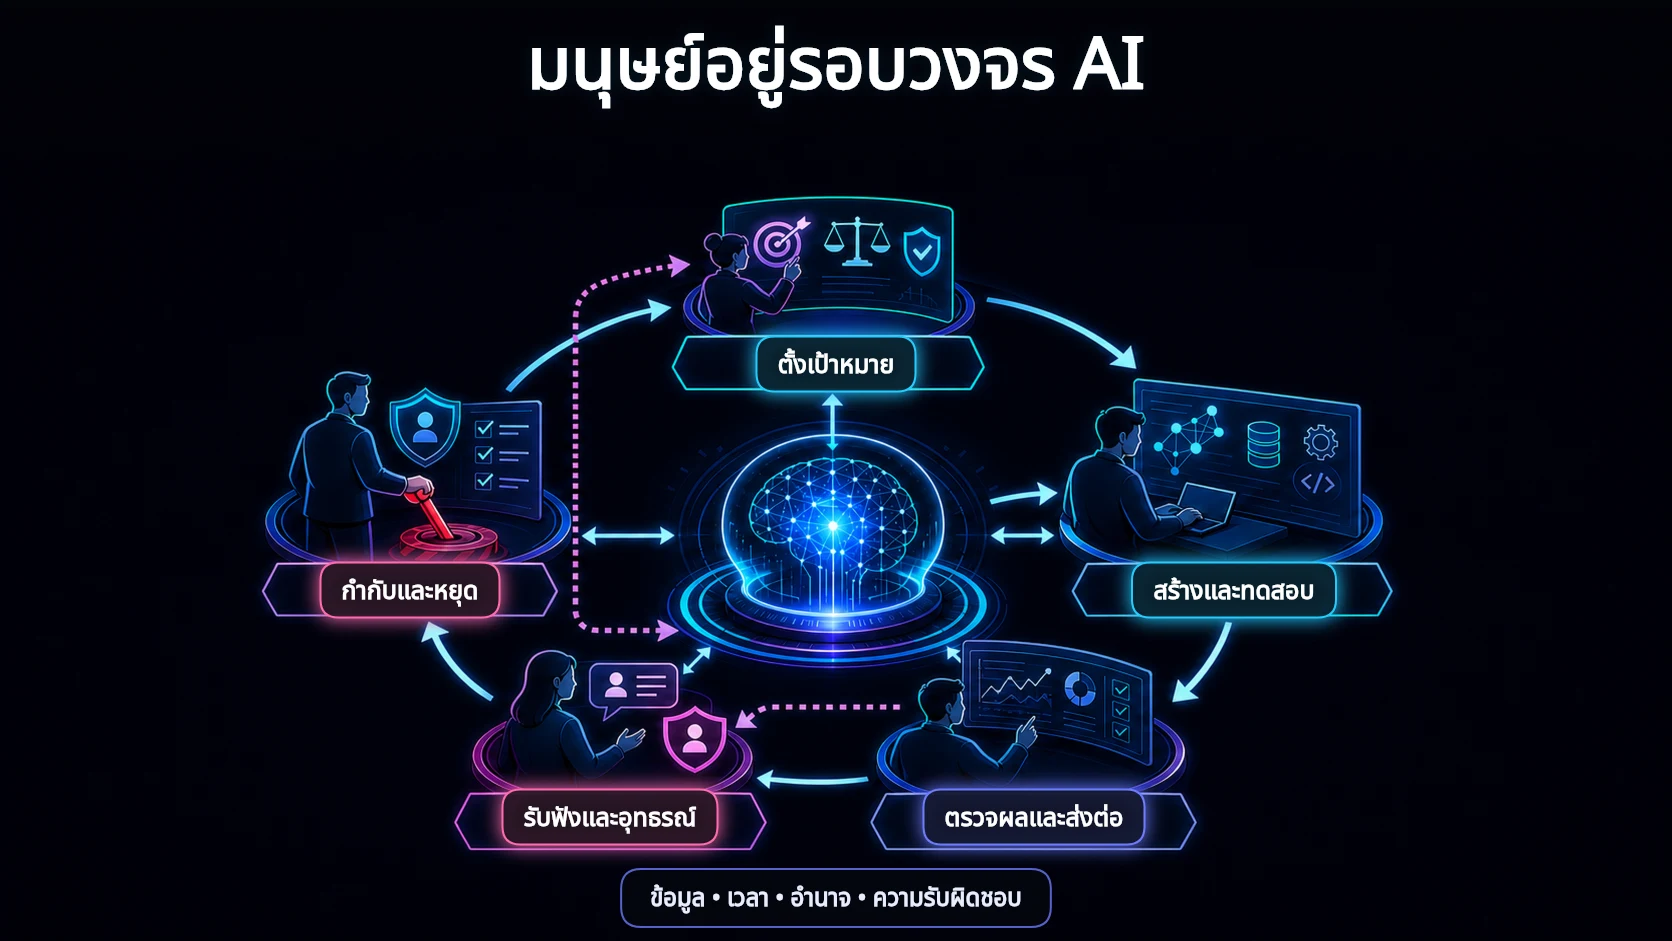
ภาพนี้สรุปวงจรเดียวกับกรณีเมย์: มนุษย์ไม่ได้อยู่ปลายทางเพียงจุดเดียว แต่ทำหน้าที่ตั้งแต่กำหนดเป้าหมายและขอบเขต สร้างและทดสอบระบบ ตรวจผล รับฟังคำอุทธรณ์ ไปจนถึงกำกับ แก้ หรือหยุดระบบเมื่อพบสัญญาณอันตราย
- ก่อนระบบทำงาน: กำหนดสิ่งที่ต้องการวัด ข้อมูลที่ใช้ และความผิดพลาดที่ยอมรับไม่ได้
- ระหว่างระบบทำงาน: ตรวจหลักฐาน ดูผลกระทบ และตัดสินใจว่าจะรับ ปฏิเสธ หรือส่งต่อคำแนะนำ
- เมื่อเกิดปัญหา: จำกัดขอบเขต ค้นหาผลย้อนหลัง เปิดทางเยียวยา และแก้สาเหตุไม่ให้เกิดซ้ำ
เรียนต่ออย่างเป็นระบบ
เชื่อมบทบาทของมนุษย์กับข้อมูล โมเดล การประมวลผล และองค์ประกอบอื่นของระบบ AI ใน PATH 01
แหล่งอ้างอิงหลักและขอบเขต
- NIST — Artificial Intelligence Risk Management Framework 1.0
- NIST AI RMF Playbook — Govern, Map, Measure, Manage
- OECD AI Principles — Human agency, transparency, robustness and accountability
- UNESCO Recommendation on the Ethics of Artificial Intelligence
ขอบเขต: กรณีเมย์และระบบคัดกรองทุนเป็นตัวอย่างสมมติเพื่ออธิบายกลไก ไม่ใช่ผลทดสอบของระบบจริง คำว่า Human-in/on/out-of-the-loop ใช้ตามนิยามที่ประกาศในบทเรียนนี้ เนื่องจากรายละเอียดอาจต่างกันตามมาตรฐานและองค์กร
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 6 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 18 · PATH 01 · เนื้อหาเพื่อการศึกษา
