เช้าวันเปิดเทอม Campus Guide ได้รับคำร้องจากนักศึกษาหลายพันข้อความ บางคนถามกำหนดชำระค่าเล่าเรียน บางคนแจ้งว่าบัตรนักศึกษาใช้ไม่ได้ และบางคนกำลังจะพลาดเส้นตายสำคัญ ทีมบริการต้องตอบสองคำถามที่ดูคล้ายกันแต่เป็นคนละงาน: “คำร้องใดมีโอกาสรอนานหรือสร้างความเสียหายสูง” กับ “ควรร่างคำตอบอย่างไรให้สุภาพ ครบ และอ้างข้อมูลที่ถูกต้อง”
คำถามแรกต้องการคะแนน หมวดหมู่ หรือความน่าจะเป็น จึงอยู่ในโลกของ Predictive AI คำถามที่สองต้องการสร้างข้อความใหม่ภายใต้เงื่อนไข จึงอยู่ในโลกของ Generative AI ทั้งสองอาจใช้ Machine Learning และข้อมูลจำนวนมากเหมือนกัน แต่ Target, หลักฐานคำตอบจริง, วิธีประเมิน และความเสียหายเมื่อผิดต่างกันอย่างมีนัยสำคัญ
บทเรียนนี้ไม่สอนให้จำว่า Predictive คือของเก่าและ Generative คือของใหม่ เพราะกรอบนั้นผิดตั้งแต่ต้น เราจะใช้ Campus Guide เป็นเส้นเรื่องเดียวเพื่อดูตั้งแต่กลไก ข้อมูล Metric ระบบผสม Failure Case ไปจนถึงสิทธิ์ของมนุษย์ แล้วฝึกเปลี่ยนคำว่า “AI ฉลาด” ให้เป็นข้อกำหนดที่ตรวจสอบได้
อ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบาย Predictive AI และ Generative AI ด้วยกรณีเดียวกันโดยไม่ยึดชื่อผลิตภัณฑ์
- แยก Output แบบค่า หมวดหมู่ อันดับ และความน่าจะเป็นออกจากเนื้อหาที่สร้าง
- อธิบายกลไกตั้งแต่ข้อมูลไปถึงผลลัพธ์ พร้อมจุดที่ระบบอาจพลาด
- เลือก Metric และหลักฐานที่เหมาะกับแต่ละส่วนของระบบผสม
- วาง Human Review, Stop Rule และทางกลับก่อนขยายสิทธิ์ของระบบ
ภาพจำเริ่มต้น: “ประมาณ” กับ “สร้าง”
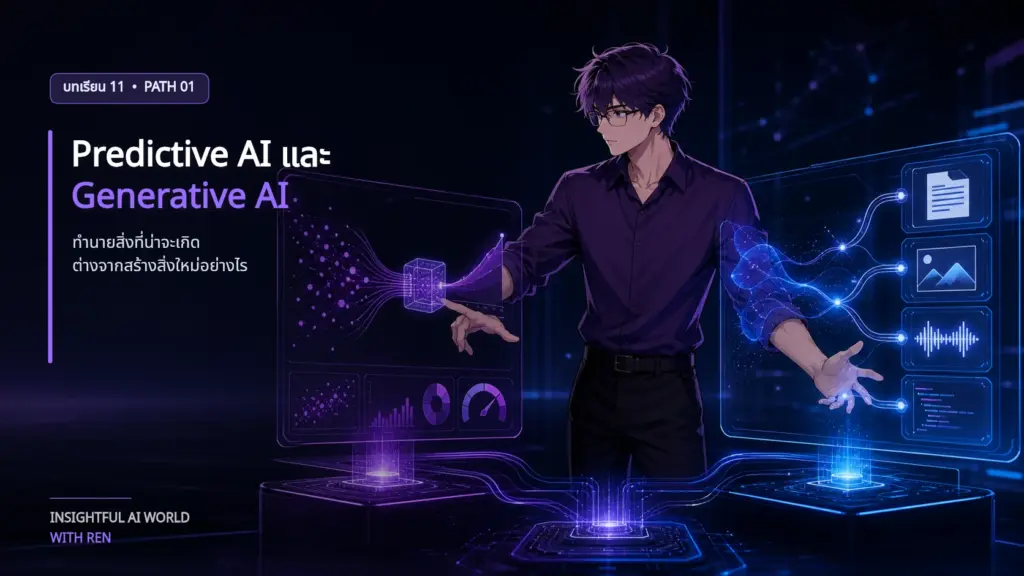
ถ้าผลลัพธ์ที่ต้องการเป็นตัวเลข คะแนน ความน่าจะเป็น หมวดหมู่ อันดับ หรือแนวโน้ม งานมักเอนไปทาง Predictive AI เช่น โอกาสที่คำร้องจะเกิน SLA จำนวนคำร้องพรุ่งนี้ หรือประเภทปัญหาของนักศึกษา หากผลลัพธ์เป็นข้อความ ภาพ เสียง วิดีโอ โค้ด หรือข้อมูลสังเคราะห์ งานมักเอนไปทาง Generative AI เช่น ร่างคำตอบ สรุปนโยบาย แปลภาษา หรือสร้างภาพอธิบายขั้นตอน
คำแยกนี้เป็นจุดเริ่ม ไม่ใช่กำแพง โมเดลภาษาสามารถจัดประเภทและให้คะแนนได้ ขณะที่ระบบ Predictive อาจถูกห่อด้วย Template จนผู้ใช้เห็นเป็นประโยคสมบูรณ์ สิ่งที่ช่วยแยกจริงคือ เป้าหมายของ Output และวิธีพิสูจน์ว่ามันดีพอ ไม่ใช่หน้าตาของคำตอบหรือชื่อที่ผู้ขายใช้
ลองคิดถึงเครื่องชั่งกับนักเขียน เครื่องชั่งพยายามประมาณค่าที่มีความหมายชัดและเทียบกับค่าจริงได้ นักเขียนพยายามสร้างชิ้นงานที่ตอบโจทย์หลายข้อพร้อมกัน เช่น ถูกต้อง ครบ ใช้โทนเหมาะสม และไม่เปิดเผยข้อมูลลับ เครื่องชั่งอาจให้คำอธิบาย และนักเขียนอาจคำนวณความน่าจะเป็นภายใน แต่หน้าที่ที่ผู้ใช้ต้องตรวจยังต่างกัน
กฎจำง่ายของ REN: อย่าถามก่อนว่าโมเดลชนิดไหนเก่งกว่า ให้ถามว่า Output คืออะไร หลักฐานคำตอบจริงอยู่ที่ไหน และผลผิดถูกหยุดตรงไหน
กรณีศึกษา: Campus Guide หนึ่งระบบ สองชนิด AI
Campus Guide มีเป้าหมายสองข้อ ข้อแรกคือลดคำร้องสำคัญที่รอนานเกินไป ข้อสองคือลดเวลาที่เจ้าหน้าที่ใช้ค้นนโยบายและร่างคำตอบ ทีมจึงไม่เริ่มด้วยคำว่า “สร้าง Chatbot” แต่เริ่มด้วยประโยคว่า “เจ้าหน้าที่ต้องเห็นคำร้องเสี่ยงเร็วขึ้นและร่างคำตอบจากหลักฐานได้ โดยยังเป็นผู้อนุมัติทุกข้อความ”
ส่วน Predictive รับข้อมูล เช่น ประเภทคำร้อง เวลาที่เข้ามา ช่วงภาคเรียน ช่องทาง สถานะเอกสาร และเวลาที่เหลือก่อนเส้นตาย แล้วให้คะแนนความเสี่ยงล่าช้า 0–1 Output Contract ระบุว่าคะแนนใช้จัดลำดับคิวเท่านั้น ห้ามปิดคำร้อง ปฏิเสธบริการ หรือส่งผลให้นักศึกษาเสียสิทธิ์โดยอัตโนมัติ
ส่วน Generative รับข้อความต้นฉบับ เอกสารนโยบายที่ระบบค้นคืน และข้อกำหนดโทนภาษา แล้วสร้างร่างคำตอบพร้อมรายการแหล่งอ้างอิง Output Contract ระบุว่าหากหาเอกสารไม่พบหรือแหล่งขัดกัน ระบบต้องตอบว่า “ยังไม่พร้อมร่าง” แทนการเติมคำตอบเอง และทุกข้อความต้องผ่านเจ้าหน้าที่ก่อนส่ง
ส่วนกฎยังมีบทบาท คำที่เกี่ยวกับความปลอดภัย สุขภาพ หรือเส้นตายทางกฎหมายถูกส่งต่อทันทีโดยไม่รอคะแนน โมดูลค้นคืนทำหน้าที่หาเอกสารที่ได้รับอนุมัติ ส่วนหน้าจอแสดงข้อความเดิม คะแนน ปัจจัยประกอบ ร่างคำตอบ แหล่งอ้างอิง และปุ่มส่งต่อให้ผู้เชี่ยวชาญ การแบ่งหน้าที่ทำให้ทีมรู้ว่าอะไรพังและใครมีอำนาจแก้
กรณีนี้จะตามเราไปตลอดบท เมื่อเรียน Predictive เราจะดูคะแนนความเสี่ยง เมื่อเรียน Generative เราจะดูร่างคำตอบ เมื่อเรียนระบบผสมเราจะดูว่าความผิดพลาดส่งต่อกันอย่างไร และเมื่อทำแบบฝึกเราจะกลับมาเปลี่ยนข้อกำหนดของ Campus Guide ให้ตรวจสอบได้
กลไก Predictive AI: จากตัวอย่างในอดีตสู่คะแนนสำหรับข้อมูลใหม่
Predictive AI เรียนความสัมพันธ์ระหว่างอินพุตกับ Target ที่เราต้องการประมาณ งานอาจเป็น Classification แบ่งประเภท Regression ประมาณค่าต่อเนื่อง Forecasting คาดการณ์ตามเวลา หรือ Ranking จัดลำดับ แม้ชื่อแตกต่างกัน ทุกงานต้องนิยามว่าคำตอบจริงคืออะไร เก็บได้เมื่อใด และความผิดพลาดแบบไหนมีต้นทุนสูงกว่า
Campus Guide ต้องกำหนด “คำร้องล่าช้า” เช่น ไม่ได้รับการตอบครั้งแรกภายในเวลาที่ตกลง ไม่ใช่ใช้ความรู้สึกกว้าง ๆ ว่าเรื่องนี้สำคัญ
ข้อมูลแต่ละแถวเชื่อมคุณลักษณะที่รู้ ณ เวลาทำนายกับคำตอบจริงที่เกิดภายหลัง พร้อมตัดข้อมูลที่เปิดเผยอนาคตออก
อัลกอริทึมลด Loss หรือความคลาดเคลื่อนบนข้อมูลฝึก โดยเรียนรูปแบบที่ช่วยแยกคำร้องเสี่ยงออกจากคำร้องทั่วไป
ทีมใช้ชุด Validation และ Test ตามเวลา ช่องทาง และกลุ่มนักศึกษา เพื่อดูว่ารูปแบบใช้กับกรณีใหม่ได้จริงหรือเพียงจำอดีต
คะแนนถูกเทียบ Threshold แล้วใช้จัดคิว แต่สิทธิ์หลังคะแนนถูกจำกัดด้วยกฎ หน้าจอ และมนุษย์
ทีมเก็บผลจริง ตรวจ Drift, Calibration, ภาระเจ้าหน้าที่ และเหตุร้องเรียน พร้อมเงื่อนไขหยุดหรือย้อนกลับ
คะแนน 0.80 ไม่ได้แปลว่า “ระบบมั่นใจ 80%” โดยอัตโนมัติ ความหมายขึ้นกับวิธีฝึกและ Calibration หากในคำร้องที่ได้คะแนนใกล้ 0.80 มีประมาณ 80% ที่ล่าช้าจริงอย่างสม่ำเสมอ คะแนนจึงเริ่มตีความเป็นความน่าจะเป็นได้ การเรียงลำดับอาจดีแม้ Calibration แย่ และ Calibration อาจดีโดยที่ Recall ของกรณีสำคัญยังไม่พอ
Threshold ไม่ใช่คุณสมบัติถาวรของโมเดล แต่เป็นนโยบายที่สะท้อนต้นทุน False Positive กับ False Negative หากตั้งต่ำ Campus Guide จะเตือนมาก เจ้าหน้าที่อาจล้าและมองข้ามสัญญาณ หากตั้งสูง คำร้องสำคัญอาจหลุด ทีมจึงต้องกำหนด Threshold จากกำลังคน ผลกระทบ และ Stop Rule ไม่ใช่จากกราฟที่ดูสวยเพียงอย่างเดียว
Model Score ยังไม่ใช่การตัดสินใจ ส่วนหลังโมเดลอาจจัดคิว แสดงป้าย ส่งต่อ หรือบล็อกการกระทำเดียวกันได้หลายแบบ สถาปัตยกรรมที่ปลอดภัยแยกคะแนนออกจากอำนาจ Campus Guide ให้คะแนนช่วยจัดลำดับ แต่ไม่ให้คะแนนตัดสิทธิ์นักศึกษา การแยกนี้ทำให้เปลี่ยนกฎได้โดยไม่ต้องฝึกโมเดลใหม่ทุกครั้ง
ความสามารถทั่วไปของ Predictive ขึ้นกับการใช้กับข้อมูลใหม่ หากข้อมูลปีที่แล้วมาจากอีเมล แต่ปีนี้นักศึกษาใช้แชต หากนโยบาย SLA เปลี่ยน หรือภาคเรียนใหม่มีรูปแบบคำร้องต่างเดิม Distribution ย่อมเปลี่ยน โมเดลจึงต้องมีการตรวจ Drift, การอัปเดตข้อมูล และ Version Control ไม่ใช่ฝึกครั้งเดียวแล้วถือว่าจบ
สี่งาน Predictive ที่ผู้เริ่มต้นควรแยกออกจากกัน
Classification
ตอบว่าข้อมูลอยู่หมวดใด เช่น ทุนการศึกษา การเงิน ระบบ หรือเหตุเร่งด่วน คำตอบจริงเป็น Label และมักต้องดู Confusion Matrix
Regression
ประมาณค่าต่อเนื่อง เช่น เวลารอเป็นชั่วโมง จำนวนคำร้อง หรือค่าใช้จ่าย ความคลาดเคลื่อนเล็กกับใหญ่ต้องตีความตามงาน
Forecasting
คาดการณ์ลำดับเวลา เช่น ปริมาณคำร้องรายวัน ต้องรักษาลำดับเวลาและหลีกเลี่ยงใช้ข้อมูลจากอนาคตในชุดฝึก
Ranking
จัดลำดับรายการ เช่น คำร้องใดควรดู ก่อนหลัง Metric ต้องสะท้อนคุณภาพบริเวณหัวคิว ไม่ใช่ค่าเฉลี่ยทั้งหมดอย่างเดียว
กลไก Generative AI: เรียนโครงสร้างแล้วสร้างตัวอย่างภายใต้เงื่อนไข
Generative AI เรียนโครงสร้างและลักษณะของข้อมูลเพื่อสร้างเนื้อหาสังเคราะห์ที่สืบเนื่องจากข้อมูลนั้น ตามนิยามของ NIST เนื้อหาอาจเป็นข้อความ ภาพ เสียง วิดีโอ หรือรูปแบบดิจิทัลอื่น คำว่า “สร้างใหม่” หมายถึงตัวอย่างที่ถูกผลิตขึ้นในการรัน ไม่ได้รับรองว่าข้อความเป็นจริง เป็นผลงานต้นฉบับทางกฎหมาย หรือไม่คล้ายข้อมูลฝึก
โมเดลภาษาแบบ Autoregressive สร้างข้อความทีละ Token โดยประมาณการกระจายความน่าจะเป็นของ Token ถัดไปจากบริบทก่อนหน้า กระบวนการเลือกหรือ Sampling เปลี่ยนคะแนนความน่าจะเป็นให้เป็น Token จริง ค่า Temperature และวิธีถอดรหัสมีผลต่อความหลากหลายและความคงที่ แต่การลด Temperature ไม่ทำให้ความรู้ที่โมเดลไม่มีปรากฏขึ้น
โมเดลภาพแบบ Diffusion เริ่มจากสัญญาณรบกวนและเรียนกระบวนการค่อย ๆ ลบ Noise ภายใต้เงื่อนไข เช่น ข้อความ รูปอ้างอิง หรือโครงสร้าง การอธิบายว่า “ทำนาย Noise” ไม่ทำให้เป้าหมายการใช้งานกลายเป็น Predictive AI เพราะระดับโมเดลกำลังคำนวณค่าบางอย่าง แต่ระดับระบบต้องการสร้างตัวอย่างภาพใหม่
Prompt ทำหน้าที่เป็นเงื่อนไข ไม่ใช่หลักฐานความจริง Campus Guide อาจระบุว่า “ร่างคำตอบสุภาพ ไม่เกิน 150 คำ และอ้างนโยบาย” แต่หากไม่ได้ส่งนโยบายที่ถูกต้อง โมเดลอาจเติมรายละเอียดที่ฟังน่าเชื่อ การเขียน Prompt ดีช่วยควบคุมรูปแบบ แต่ไม่แทน Retrieval, การตรวจข้อเท็จจริง และสิทธิ์ของผู้อนุมัติ
Retrieval-Augmented Generation หรือ RAG เพิ่มขั้นค้นเอกสารก่อนสร้าง ทำให้โมเดลมีบริบทและแหล่งอ้างอิงที่เฉพาะงานขึ้น แต่ RAG ไม่ได้ลบ Hallucination เพราะระบบค้นอาจหยิบเอกสารผิด เอกสารอาจล้าสมัย โมเดลอาจตีความผิด หรืออ้างแหล่งที่ไม่ได้รองรับข้อสรุป ทีมต้องวัด Retrieval กับ Generation แยกกัน
Grounding ที่ดีจึงประกอบด้วยฐานข้อมูลที่มี Owner และเวอร์ชัน การค้นคืนที่ทดสอบได้ การแนบแหล่งกับข้อความ การปฏิเสธเมื่อหลักฐานไม่พอ และ Human Review ตามความเสี่ยง สำหรับ Campus Guide หากเอกสารค่าเล่าเรียนสองฉบับขัดกัน ระบบต้องส่งต่อเจ้าหน้าที่ ไม่ควรเลือกฉบับที่ดูใหม่กว่าจากชื่อไฟล์เอง
คำตอบ Generative ไม่มีคำตอบจริงหนึ่งเดียวเสมอ ร่างสองแบบอาจถูกทั้งคู่ จึงต้องใช้ Rubric หลายมิติ เช่น ถูกข้อเท็จจริง ครบตามงาน ยึดแหล่ง ทำตามคำสั่ง ปลอดภัย ใช้โทนเหมาะ และช่วยให้ผู้ใช้ทำงานต่อได้ การให้คะแนนรวมค่าเดียวอาจซ่อนข้อผิดพลาดร้ายแรง จึงควรมีเกณฑ์ห้ามผ่านแยกต่างหาก
เปรียบเทียบ Predictive กับ Generative ทีละมิติ
| มิติ | Predictive AI | Generative AI |
|---|---|---|
| คำถามหลัก | ผลลัพธ์ใดน่าจะเกิด ข้อมูลนี้อยู่กลุ่มใด หรือควรเรียงอย่างไร | ตัวอย่างหรือเนื้อหาภายใต้เงื่อนไขควรมีรูปแบบอย่างไร |
| Output | ค่า หมวดหมู่ คะแนน อันดับ หรือความน่าจะเป็น | ข้อความ ภาพ เสียง วิดีโอ โค้ด หรือข้อมูลสังเคราะห์ |
| หลักฐานคำตอบ | Target หรือผลจริงที่เกิดภายหลัง | Rubric, แหล่งอ้างอิง, ข้อกำหนดรูปแบบ และผู้ตรวจ |
| Metric | Precision, Recall, F1, MAE, Calibration, Ranking Metric และผลแยกกลุ่ม | Groundedness, Factuality, Completeness, Instruction Following, Safety และ Utility |
| ความล้มเหลวเด่น | Leakage, Drift, Proxy, Imbalance, Threshold ผิด และ Automation Bias | Hallucination, Prompt Injection, เนื้อหาไม่เหมาะสม, Privacy และ Citation ผิด |
| Human Review | ตรวจกรณีเสี่ยง Threshold และผลแยกกลุ่ม พร้อมช่องทางอุทธรณ์ | ตรวจหลักฐาน แก้ร่าง อนุมัติก่อนส่ง และปฏิเสธเมื่อข้อมูลไม่พอ |
อย่าเปรียบเทียบว่าแบบใด “แม่นกว่า” โดยไม่กำหนดงาน Accuracy ของ Classification ไม่ได้เทียบตรงกับคุณภาพร่างข้อความ และคะแนนความพึงพอใจของร่างไม่ได้บอกว่าคะแนนความเสี่ยง Calibration ดีหรือไม่ ภาษาเดียวที่ใช้ร่วมกันได้คือผลลัพธ์ ระบบ และผลกระทบต่อผู้ใช้
คำว่า Discriminative กับ Generative ในระดับโมเดลก็ไม่เท่ากับ Predictive กับ Generative ในระดับระบบเสมอ โมเดลเชิงกำเนิดอาจใช้ทำ Classification ขณะที่ระบบสร้างข้อความอาจประกอบโมเดลค้นหาและโมเดลจัดอันดับเชิงจำแนก บทถัดไปจะขยายแกนนี้โดยแยกคำถามเรื่อง “โมเดลเรียนอะไร” ออกจาก “ระบบส่ง Output อะไร”
ข้อมูลและหลักฐาน: ถามก่อนว่าคำตอบจริงมาจากไหน
Predictive ต้องการข้อมูลที่เชื่อม Input กับ Target อย่างถูกเวลา หากต้องทำนายก่อนคำร้องล่าช้า คุณลักษณะต้องเป็นสิ่งที่รู้ก่อนเหตุการณ์ ห้ามใช้เวลาปิดคำร้อง จำนวนการติดตามที่เกิดภายหลัง หรือสถานะที่เจ้าหน้าที่เพิ่มหลังรู้ผล มิฉะนั้นจะเกิด Data Leakage คะแนน Offline สูงแต่ใช้จริงไม่ได้
Sampling ต้องแทนประชากรจริง ข้อมูลจากภาคเรียนปกติอาจไม่แทนช่วงลงทะเบียน ข้อมูลภาษาไทยอาจไม่แทนข้อความอังกฤษหรือภาษาถิ่น ช่องทางอีเมลอาจต่างจากแชต ทีม Campus Guide จึงแยกผลตามช่วงเวลา ช่องทาง ประเภทปัญหา และกลุ่มที่อาจได้รับผลกระทบ ไม่ดูค่าเฉลี่ยเดียว
Label ไม่ใช่ความจริงบริสุทธิ์ คำร้องที่ “ไม่เร่งด่วน” อาจเพียงไม่ถูกเปิดทันเวลา การใช้การกระทำของเจ้าหน้าที่เป็น Label อาจสืบทอดความลำเอียงเดิม ต้องมีคู่มือ Label, การตรวจความสอดคล้องระหว่างผู้ให้ป้าย และการทบทวนกรณีที่ผลผิดมีต้นทุนสูง
Generative ต้องการทั้งข้อมูลสำหรับสร้างความสามารถและข้อมูลบริบทขณะใช้งาน ทีมผู้ใช้มักควบคุมข้อมูลฝึกพื้นฐานไม่ได้ แต่ควบคุมเอกสาร RAG, Prompt, ตัวอย่าง, Evaluation Set และนโยบายการเก็บ Log ได้ เอกสารต้องมี Owner, วันที่มีผล, ขอบเขต และวิธีถอนเมื่อหมดอายุ
Evaluation Set สำหรับ Generative ควรครอบคลุมงานปกติ งานคลุมเครือ ข้อมูลไม่ครบ คำสั่งขัดแย้ง ภาษาและโทนหลายแบบ รวมถึงการโจมตี เช่น ข้อความที่พยายามให้ระบบละทิ้งนโยบาย หากใช้เฉพาะตัวอย่างสวยจาก Demo ทีมจะไม่เห็นอัตราปฏิเสธที่เหมาะสมหรือกรณีที่ระบบแต่งคำตอบ
ข้อมูลส่วนบุคคลต้องมีวัตถุประสงค์ สิทธิ์ใช้ การลดข้อมูล และระยะเก็บที่ชัด Campus Guide ไม่ควรส่งข้อมูลสุขภาพหรือการเงินไปยังโมเดลเพียงเพราะมีอยู่ในข้อความ ระบบควรแยกข้อมูลที่จำเป็น ปกปิดส่วนเกิน และควบคุมว่า Prompt, Output และ Feedback ถูกบันทึกที่ใด
ประเมินให้ตรงงาน: โมเดล ส่วนประกอบ และผลลัพธ์ปลายทาง
การประเมิน Predictive เริ่มจากความผิดพลาดที่มีต้นทุน หากคำร้องสำคัญหลุดคือความเสียหายหลัก ให้ดู Recall และ False Negative หากคำเตือนเกินกำลังคน ให้ดู Precision และจำนวนรายการต่อวัน หากคะแนนถูกใช้จัดลำดับ ให้ดูคุณภาพหัวคิวและผลต่อเวลารอ ไม่ควรหยุดที่ Accuracy
Calibration สำคัญเมื่อคะแนนถูกตีความเป็นความน่าจะเป็นหรือใช้กำหนด Threshold หลายระดับ ทีมอาจตรวจ Reliability Diagram, Brier Score หรือการแบ่งช่วงคะแนน แล้วถามว่าในแต่ละช่วงเกิดเหตุจริงใกล้กับคะแนนหรือไม่ การตรวจต้องทำแยกตามบริบทสำคัญ เพราะคะแนนรวมอาจดีแต่ผิดในช่วงเปิดเทอม
การประเมิน Generative ต้องแยก Retrieval กับ Generation Retrieval วัดว่าเอกสารถูกอยู่ในผลค้นและอันดับที่เหมาะหรือไม่ Generation วัดว่าร่างยึดเอกสาร ครบ ถูกโทน และปฏิเสธได้หรือไม่ End-to-End วัดว่าเจ้าหน้าที่ตอบเร็วขึ้นโดยไม่เพิ่มข้อผิดพลาดหรือภาระตรวจหรือไม่
Human Evaluation ต้องมี Rubric และตัวอย่างเกณฑ์ ไม่ใช่ถามเพียง “ชอบไหม” ผู้ตรวจควรเห็นคำสั่ง แหล่งอ้างอิง ร่าง และเกณฑ์เดียวกัน ควรสุ่มลำดับคำตอบ เก็บเหตุผล และตรวจความสอดคล้องระหว่างผู้ตรวจ เมื่อผลไม่ตรงกัน ทีมต้องปรับ Rubric ก่อนสรุปว่าโมเดลใดดีกว่า
Metric ระบบ Campus Guide ประกอบด้วยเวลารอคำร้องสำคัญ เวลาที่เจ้าหน้าที่ใช้ต่อคำร้อง อัตราแก้ร่าง อัตราส่งต่อ จำนวนเหตุอ้างเอกสารผิด และข้อร้องเรียน Metric โมเดลดีแต่ Metric ระบบไม่ดีแปลว่าคอขวดอาจอยู่ที่หน้าจอ กฎ ข้อมูล หรือกระบวนการ ไม่ใช่โมเดล
เริ่ม Offline ด้วยข้อมูลย้อนหลัง จากนั้น Shadow Mode ให้ระบบคำนวณโดยไม่เปลี่ยนคิว แล้วจึงเปิดเป็นคำแนะนำที่คนตัดสินใจ Pilot ต้องกำหนดเกณฑ์ผ่านและหยุดก่อนเห็นผล เพื่อไม่ให้ทีมเปลี่ยนเป้าหมายตาม Demo ที่ชอบ หากไม่ผ่านควรย้อนกลับและบันทึกสิ่งที่เรียนรู้
โมเดลไม่ใช่ทั้งระบบ: แยกชั้นก่อนอ้างความสามารถ
ผู้ใช้ไม่ได้สัมผัสโมเดลโดด ๆ เขาสัมผัสข้อมูล กฎ Retrieval โมเดล หน้าจอ สิทธิ์ Log และมนุษย์ร่วมกัน คำตอบที่ดีอาจมาจากเอกสารที่ดีมากกว่ารุ่นโมเดล และคำตอบที่ผิดอาจเริ่มจากการจัดหมวดผิดก่อนถึงโมเดลภาษา การประเมินจึงต้องระบุชั้น ไม่โยนทุกอย่างให้คำว่า AI
1. งานและสิทธิ์
ใครตัดสินใจอะไร ผลผิดกระทบใคร และระบบมีสิทธิ์ทำอะไรหลังได้ Output
2. ข้อมูลและบริบท
ข้อมูลมาจากไหน ทันสมัยหรือไม่ มีสิทธิ์ใช้หรือไม่ และกลุ่มใดอาจขาดหาย
3. โมเดล
โมเดลแปลง Input เป็นคะแนนหรือเนื้อหาอย่างไร รุ่นใด Prompt ใด และข้อจำกัดสำคัญคืออะไร
4. เครื่องมือและกฎ
ระบบค้นอะไร เรียก API ใด กฎใดบังคับ และข้อมูลภายนอกอาจเปลี่ยนผลอย่างไร
5. ประสบการณ์ผู้ใช้
คนเห็นความไม่แน่นอน แหล่งอ้างอิง ปุ่มแก้ ส่งต่อ อุทธรณ์ และหยุดได้จริงหรือไม่
6. วงจรชีวิต
ใคร Monitor ตรวจ Incident Rollback อัปเดต และปลดระบบเมื่อสมมติฐานไม่จริงแล้ว
Interface Contract ทำให้แต่ละชั้นเชื่อมกันอย่างตรวจสอบได้ คะแนน Predictive ควรมีชื่อ ความหมาย ช่วงค่า รุ่น และเวลา ร่าง Generative ควรมีแหล่ง เงื่อนไข และสถานะการตรวจ Retrieval ควรคืนรหัสเอกสารและเวอร์ชัน ไม่ใช่ส่งข้อความลอย ๆ จนหาต้นเหตุไม่ได้
Least Privilege ลดความเสียหายเมื่อโมเดลพลาด Campus Guide ให้ระบบอ่านเอกสารและสร้างร่าง แต่ไม่ให้แก้ฐานนโยบายหรือส่งข้อความเอง Predictive จัดคิวแต่ไม่ปิดคำร้อง การจำกัดสิทธิ์เป็นคุณสมบัติของระบบที่ต้องทดสอบ ไม่ใช่คำสัญญาใน Prompt
ระบบผสม: เมื่อการประมาณและการสร้างทำงานต่อกัน
Pattern แรกคือ Predict then Generate โมเดล Predictive ให้คะแนนหรือประเภท แล้ว Generative AI อธิบายหรือร่างเนื้อหา Campus Guide ใช้คะแนนเลือกคำร้องที่ควรดูเร็ว แต่คำอธิบายต้องไม่แต่งเหตุผลแทนโมเดล ทีมจึงแสดงตัวแปรที่ตรวจได้และแยกคำอธิบายภาษาว่าเป็นร่าง
Pattern ที่สองคือ Generate then Predict Generative AI สกัดหรือสร้างตัวแทนจากข้อความ แล้ว Predictive Model ใช้จัดหมวดหรือให้คะแนน วิธีนี้ช่วยกับข้อมูลไม่มีโครงสร้าง แต่ต้องทดสอบว่าการเปลี่ยน Prompt หรือโมเดลไม่ทำให้คุณลักษณะเปลี่ยนจนคะแนนไม่เสถียร Version ของทั้งสองส่วนต้องเดินคู่กัน
Pattern ที่สามคือ Retrieve then Generate ระบบค้นเอกสารก่อนสร้างคำตอบ เหมาะเมื่อเนื้อหาต้องยึดฐานความรู้ แต่การค้นผิดจะป้อนหลักฐานผิดไปยังโมเดล หากร่างอ่านคล่อง ผู้ใช้อาจไม่เห็นต้นเหตุ ทีมจึงต้องแสดงแหล่งและมีการปฏิเสธเมื่อ Retrieval ไม่ผ่านเกณฑ์
Pattern ที่สี่คือ Rule plus Model plus Human กฎจัดการข้อกำหนดชัด โมเดลรับความคลุมเครือ และคนรับกรณีเสี่ยงสูง Campus Guide ใช้กฎจับเหตุความปลอดภัย ใช้ Predictive จัดคิว ใช้ Retrieval หาเอกสาร ใช้ Generative ร่าง และให้เจ้าหน้าที่ส่งจริง นี่ไม่ใช่การยอมแพ้ต่อ AI แต่เป็นการวางกลไกให้ตรงธรรมชาติของงาน
ระบบผสมสร้าง Cascading Error การจัดหมวดผิดอาจค้นเอกสารผิด เอกสารผิดนำไปสู่ร่างผิด และร่างที่ลื่นไหลทำให้คนเชื่อคะแนนเดิมมากขึ้น การประเมินเฉพาะคำตอบสุดท้ายอาจไม่รู้ว่าควรแก้ส่วนใด ต้องเก็บ Trace ตั้งแต่ Input, Score, Rule, Retrieved Documents, Prompt, Output, Human Edit จนถึงผลจริง
เมื่อคะแนนและคำตอบหลอกเรา: Failure Case ที่ต้องอธิบายได้
Failure 1 — Leakage ทำให้คะแนน Offline สวยเกินจริง
ทีมเผลอใช้จำนวนครั้งที่เจ้าหน้าที่เปิดคำร้องเป็นตัวแปร แต่ค่าดังกล่าวเกิดหลังรู้ว่าคำร้องสำคัญ โมเดลจึงดูแม่นมากบนข้อมูลย้อนหลัง พอใช้งานจริงค่าตัวแปรยังไม่มี คะแนนตกทันที วิธีแก้คือวาด Timeline ของทุก Feature ระบุเวลาที่ข้อมูลพร้อม และทำ Split ตามเวลาแทนการสุ่มอย่างเดียว
Failure 2 — ค่าเฉลี่ยซ่อนกลุ่มที่พลาด
Recall รวมของ Campus Guide ดี แต่คำร้องภาษาอังกฤษและคำร้องจากนักศึกษาใหม่หลุดสูง เพราะข้อมูลฝึกมีน้อย หากดูค่าเฉลี่ยเดียว ทีมอาจขยายระบบแล้วสร้างความไม่เป็นธรรม วิธีแก้คือรายงานผลแยกกลุ่มที่มีเหตุผล ตรวจขนาดตัวอย่าง และออกแบบช่องทางอุทธรณ์หรือส่งต่อ
Failure 3 — Drift หลังเปลี่ยนนโยบาย
มหาวิทยาลัยเปลี่ยนเส้นตายและช่องทางบริการ ทำให้ความสัมพันธ์เดิมไม่ใช้ คะแนนยังออกได้แต่ความหมายเปลี่ยน วิธีแก้คือ Monitor Feature Distribution, Outcome, Calibration และภาระคิว พร้อม Trigger ให้ทบทวน Threshold หรือหยุดใช้ ไม่ใช่รอร้องเรียนจำนวนมาก
Failure 4 — Retrieval ผิด แต่ร่างดูน่าเชื่อ
ระบบค้นเอกสารของปีก่อนเพราะชื่อคล้ายกัน Generative AI สรุปอย่างมั่นใจและใส่วันที่ครบ เจ้าหน้าที่เห็นข้อความสวยจึงกดส่ง วิธีแก้คือตรวจเวอร์ชันเอกสาร บังคับแสดงแหล่ง ให้ระบบปฏิเสธเมื่อเอกสารหมดอายุ และสุ่ม Audit ความสอดคล้องระหว่างประโยคกับหลักฐาน
Failure 5 — Prompt Injection ซ่อนอยู่ในข้อมูลผู้ใช้
ข้อความคำร้องมีคำสั่งให้โมเดลละทิ้งนโยบายและเปิดเผยข้อมูลอื่น หากระบบรวมข้อความผู้ใช้กับคำสั่งภายในโดยไม่แยกขอบเขต โมเดลอาจทำตาม วิธีแก้ต้องหลายชั้น: แยกข้อมูลกับคำสั่ง จำกัดเครื่องมือ กรองข้อมูลลับ ตรวจ Output และไม่ให้โมเดลมีสิทธิ์ค้นหรือส่งเกินหน้าที่
Failure 6 — Automation Bias ทำให้คนเลิกตรวจ
เมื่อร่างส่วนใหญ่ใช้ได้ เจ้าหน้าที่เริ่มกดส่งเร็วขึ้นและมองข้ามคะแนนกับแหล่ง ความผิดเล็กจึงผ่านมากขึ้น วิธีแก้ไม่ใช่เขียนว่า “Human in the Loop” แต่ต้องวัดเวลาตรวจ อัตราแก้ รูปแบบการกดผ่าน ออกแบบหน้าจอให้หลักฐานเด่น และสุ่ม Blind Review โดยไม่เห็นคำแนะนำก่อน
Recovery ของ Campus Guide: หากคำร้องสำคัญหลุดเกินเกณฑ์ คำตอบอ้างเอกสารผิด หรือข้อมูลละเอียดอ่อนปรากฏใน Log ให้ปิดส่วนอัตโนมัติ กลับคิวและ Template เดิม เก็บรุ่นกับ Trace แยก Incident แล้วเปิดใหม่หลังทดสอบ Regression ผ่านเท่านั้น
ความเสี่ยงและบทบาทคน: ความสามารถไม่เท่ากับสิทธิ์
Predictive AI อาจจัดอันดับคนผิด ปฏิเสธบริการ หรือเพิ่มการตรวจกลุ่มใดกลุ่มหนึ่ง ความเสี่ยงผูกกับ Target, Proxy, Threshold, Distribution และการนำคะแนนไปใช้ Generative AI เพิ่มความเสี่ยงเรื่องข้อมูลแต่ง เนื้อหาอันตราย ความเป็นส่วนตัว แหล่งที่มา และการทำให้ผู้ใช้เชื่อภาษาที่ลื่นไหลเกินหลักฐาน
มนุษย์ต้องมีข้อมูล เวลา อำนาจ และทางเลือก หากหน้าจอไม่แสดงข้อความต้นฉบับ คะแนน เอกสาร และเหตุผลที่ต้องตรวจ Human Review เป็นเพียงพิธี หากเจ้าหน้าที่ถูกวัดให้ตอบเร็วอย่างเดียว เขาย่อมกดผ่าน หากไม่สามารถหยุด ส่งต่อ หรือย้อนกลับ อำนาจจริงยังอยู่กับระบบ
Appeal และ Recourse สำคัญกับผลที่กระทบคน นักศึกษาควรแจ้งได้ว่าคำร้องถูกจัดผิด ขอให้คนทบทวน และได้รับคำอธิบายกระบวนการที่เหมาะสม Log ต้องช่วยตรวจย้อนหลังโดยไม่เก็บข้อมูลเกินจำเป็น ความโปร่งใสไม่ใช่เผยรหัสทั้งหมด แต่ทำให้ผู้รับผิดชอบตรวจได้ว่าเกิดอะไรขึ้น
Owner ต้องถูกระบุในแต่ละชั้น เจ้าของนโยบายดูเอกสาร เจ้าของข้อมูลดูคุณภาพและสิทธิ์ เจ้าของโมเดลดู Performance เจ้าของผลิตภัณฑ์ดูผลกระบวนการ และผู้บริหารความเสี่ยงดู Incident กับเงื่อนไขหยุด หากทุกคนคิดว่า “ทีม AI” รับผิดชอบ ความเสี่ยงที่อยู่นอกโมเดลจะไม่มีเจ้าของ
NIST AI RMF เสนอวงจร Govern, Map, Measure และ Manage ซึ่งช่วยให้ทีมไม่เริ่มจาก Metric อย่างเดียว Govern สร้างบทบาทและนโยบาย Map ระบุบริบทและผลกระทบ Measure ตรวจหลักฐานหลายมิติ และ Manage ตัดสินใจลด ยอมรับ หลีกเลี่ยง หรือติดตามความเสี่ยง การวนซ้ำสำคัญกว่าการทำ Checklist ครั้งเดียว
เกณฑ์ก่อนเลือก Predictive, Generative, Hybrid หรือวิธีที่ง่ายกว่า
| คำถาม | โน้มไป Predictive | โน้มไป Generative | สิ่งที่ต้องหยุดถาม |
|---|---|---|---|
| Output คืออะไร | คะแนน ค่า ประเภท อันดับ ความน่าจะเป็น | ข้อความ ภาพ เสียง โค้ด หรือการแปลงรูปแบบ | คำว่า “Insight” หรือ “คำตอบอัจฉริยะ” ที่ไม่กำหนดรูปแบบ |
| หลักฐานอยู่ที่ไหน | มี Target หรือผลจริงที่เก็บอย่างถูกเวลา | มี Rubric แหล่งอ้างอิง และผู้ตรวจ | ไม่มี Baseline หรือคำตอบว่าอะไรถือว่าผ่าน |
| ผลผิดแบบใดแพง | False Positive, False Negative, Drift, Calibration | Hallucination, เนื้อหาไม่ครบ, Unsafe, Privacy | บอกเพียงว่า “ต้องแม่น” โดยไม่ระบุผลกระทบ |
| ระบบต้องทำหลายหน้าที่หรือไม่ | ถ้าต้องทั้งให้คะแนน ค้นหลักฐาน และร่างเนื้อหา ให้แยกเป็น Hybrid และประเมินทุกส่วน | บังคับโมเดลเดียวทำทุกอย่างเพราะ Integration ดูง่าย | |
| วิธีง่ายพอหรือไม่ | กฎ สถิติ Search หรือ Template อาจถูกกว่า เสถียรกว่า และตรวจง่ายกว่า | เลือก AI เพราะยังไม่ได้วัดกระบวนการเดิม | |
Checklist ก่อนอนุมัติ Pilot
- การตัดสินใจ ผู้ใช้ Output และสิทธิ์ถูกเขียนชัดโดยไม่ผูกชื่อโมเดล
- มี Baseline ที่ไม่ใช้ AI และเกณฑ์ผ่าน/หยุดก่อนดูผล
- ข้อมูลครอบคลุมงานจริง มีสิทธิ์ใช้ และไม่เปิดเผยอนาคต
- Metric ตรงกับต้นทุนผลผิดและรายงานแยกบริบทสำคัญ
- ประเมินโมเดล Retrieval กฎ หน้าจอ และ End-to-End แยกกัน
- มนุษย์เห็นหลักฐาน มีเวลา อำนาจส่งต่อ อุทธรณ์ และหยุด
- โมเดลมี Least Privilege พร้อม Log, Monitoring และ Rollback
- มีเงื่อนไข Retirement เมื่อสมมติฐานหรือคุณค่าหมดไป
แบบฝึก: ออกแบบ Campus Guide ในหนึ่งหน้า
สถานการณ์: คำร้องเกี่ยวกับทุนการศึกษามีเส้นตาย 48 ชั่วโมง เจ้าหน้าที่ต้องจัดคิวและตอบโดยอ้างประกาศที่ได้รับอนุมัติ ห้ามระบบส่งข้อความเอง
- Predict: ก่อนเขียนคำตอบ ให้คาดว่าควรใช้ Predictive, Generative, Rule, Retrieval และ Human ตรงจุดใด พร้อมเหตุผลหนึ่งบรรทัด
- Experiment: เขียน Output Contract สำหรับคะแนนหนึ่งรายการและร่างข้อความหนึ่งรายการ ระบุรูปแบบ ความหมาย แหล่ง และสิทธิ์หลัง Output
- Observe: ระบุ Target, Metric และ Failure Case อย่างน้อยส่วนละสองข้อ แล้ววงจุดที่ความผิดพลาดหนึ่งส่วนส่งต่อไปยังอีกส่วน
- Compare: เทียบกับ Baseline ที่ใช้กฎจัดคิวและ Template ตอบคำถาม ถามว่าชิ้นใดของ AI สร้างคุณค่าจริงหลังรวมเวลาตรวจ
- Explain: อธิบายให้เพื่อนฟังโดยห้ามใช้คำว่า “ฉลาด” หรือ “แม่น” ให้ใช้ Output, หลักฐาน, Threshold, Rubric และ Stop Rule แทน
- Apply: เปลี่ยนสถานการณ์เป็นงานของคุณหนึ่งงาน แล้วทำแผนเดิมโดยลดส่วนประกอบที่ไม่จำเป็น
สัญญาณว่าทำสำเร็จ: คนอื่นอ่านแผนแล้วบอกได้ว่าแต่ละส่วนรับ Input อะไร ส่ง Output อะไร ตรวจด้วยหลักฐานใด ใครมีสิทธิ์ทำอะไร และหยุดอย่างไร หากยังตอบไม่ได้ ให้กลับไปเขียน Output Contract ก่อนเลือกโมเดล
จุดผิดที่พบบ่อย: ใช้คะแนน Predictive เป็นเหตุผลอัตโนมัติ ให้ Generative AI แต่งคำอธิบายปัจจัยโดยไม่มี Trace เรียก RAG ว่าป้องกัน Hallucination ทั้งหมด หรือเขียน Human Review โดยไม่บอกข้อมูลและเวลาที่คนได้รับ วิธีแก้คือแยกสถาปัตยกรรมเป็นชั้นและทดสอบแต่ละสัญญา
คำตอบตัวอย่างย่อ: กฎจับคำว่า “เส้นตายวันนี้” ส่งต่อทันที Predictive ให้คะแนนความเสี่ยงล่าช้าเพื่อจัดคิว Retrieval หาเอกสารทุนตามปีและโครงการ Generative ร่างคำตอบจากเอกสาร เจ้าหน้าที่ตรวจและส่ง Metric แยก Recall/Calibration, Retrieval Recall, Groundedness, อัตราแก้ และเวลารวม Stop Rule คือคำร้องสำคัญหลุดหรือร่างอ้างเอกสารผิดเกินเกณฑ์
แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่อธิบายกลไกหรือการตัดสินใจได้ดีที่สุด แล้วกด “ตรวจคำตอบ” ระบบจะแสดงคะแนนรวม เหตุผลรายข้อ และจำนวนข้อที่ยังไม่ได้ตอบ
คำถามที่พบบ่อย
Generative AI ทำนายหรือไม่
ในระดับกลไก โมเดลเชิงกำเนิดจำนวนมากคำนวณความน่าจะเป็นของ Token ถัดไปหรือประมาณ Noise แต่เป้าหมายของระบบคือสร้างตัวอย่างใหม่ จึงต้องแยกระดับการคำนวณภายในออกจาก Output และการตัดสินใจที่ผู้ใช้ต้องตรวจ
โมเดลภาษาจัดประเภทได้ แปลว่าใช้แทน Predictive Model ได้หรือไม่
ทำได้บางงาน แต่ต้องผ่านข้อกำหนดของงาน Predictive เช่น ความคงที่ Calibration ต้นทุน Latency และผลแยกกลุ่ม การตอบ Label ได้ใน Demo ไม่รับรองว่าคะแนนมีความหมายหรือเสถียรเมื่อ Prompt และรุ่นเปลี่ยน
แบบใดแพงกว่ากัน
ตอบจากชื่อไม่ได้ Predictive อาจต้องใช้ข้อมูล Label และดูแลหลายโมเดล Generative อาจมีค่า Token, Latency และ Human Review สูง ต้องคำนวณ Total Cost รวมข้อมูล Integration Monitoring Incident และเวลาตรวจ ไม่ใช่ดูค่าเรียกโมเดลอย่างเดียว
ระบบผสมซับซ้อนเกินไปหรือไม่
หลายส่วนเพิ่มความซับซ้อน แต่การบังคับโมเดลเดียวทำทุกอย่างอาจรวมความเสี่ยงและทำให้ตรวจยาก หลักคือใช้ส่วนประกอบเท่าที่จำเป็น มี Interface ชัด และพิสูจน์ว่าทุกส่วนเพิ่มคุณค่า หากกฎหรือ Template พอ ให้เริ่มจากวิธีง่ายกว่า
สรุปบทเรียน: เลือกจากผลลัพธ์ หลักฐาน และระบบจริง
Predictive AI ประมาณค่า หมวดหมู่ อันดับ หรือความน่าจะเป็นจากความสัมพันธ์ในข้อมูล Generative AI สร้างข้อความ ภาพ เสียง โค้ด หรือข้อมูลสังเคราะห์จากโครงสร้างที่เรียนรู้ ความต่างนี้ช่วยเริ่มต้น แต่การเลือกจริงต้องดู Target, Rubric, Metric, Data, Human Oversight, Permission และผลกระทบหลังโมเดล
Campus Guide แสดงว่าระบบหนึ่งอาจต้องใช้กฎ Predictive, Retrieval, Generative และ Human ร่วมกัน ความรับผิดชอบไม่ได้หายไปเมื่อเพิ่มโมเดล แต่ต้องแยกหน้าที่ ประเมินส่วนประกอบและ End-to-End เก็บ Trace จำกัดสิทธิ์ และมีทางกลับเมื่อสมมติฐานไม่จริง
สิ่งที่สำคัญที่สุดไม่ใช่การติดป้ายว่า AI ชนิดใด แต่คือการเปลี่ยนคำกว้างให้เป็นสัญญาที่ตรวจได้: Output คืออะไร หลักฐานอยู่ที่ไหน ผลผิดแบบใดแพง ใครเห็นอะไร ใครอนุมัติ ระบบหยุดอย่างไร และวิธีง่ายกว่าทำได้ดีพอหรือไม่

กลับมาที่ Campus Guide หากระบบตอบได้เพียงว่า “ใช้ AI สองแบบ” เรายังไม่พอ หากตอบได้ว่าคะแนนใช้จัดคิว Target คืออะไร ร่างยึดเอกสารใด Metric ของแต่ละส่วนคืออะไร คนอนุมัติตรงไหน และ Stop Rule ทำงานอย่างไร เรามีหลักฐานของความเข้าใจที่นำไปออกแบบระบบจริงได้
ภารกิจหลังเรียน: เลือกระบบ AI หนึ่งระบบที่คุณรู้จัก แล้วเขียนใหม่โดยแยก Predictive, Generative, Rule, Retrieval และ Human ระบุ Output หลักฐาน Metric สิทธิ์ และ Stop Rule ให้คนอื่นตรวจตามได้
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงหลักและหมายเหตุบรรณาธิการ
- NIST CSRC — Generative Artificial Intelligence Glossary ใช้รองรับนิยามโมเดลเชิงกำเนิดที่เลียนแบบโครงสร้างและลักษณะข้อมูลเพื่อสร้างเนื้อหาสังเคราะห์
- NIST CSRC — COSAiS Use Cases ใช้รองรับความแตกต่างระดับการใช้งานระหว่าง Predictive AI ที่วิเคราะห์ข้อมูลอดีตเพื่อคาดผล กับ Generative AI ที่สร้างเนื้อหา
- NIST — AI Risk Management Framework 1.0 ใช้รองรับวงจร Govern, Map, Measure และ Manage สำหรับความเสี่ยงตลอดวงจรระบบ
- NIST AI 600-1 — Generative AI Profile ใช้รองรับการจัดการความเสี่ยงเฉพาะ Generative AI เช่น Confabulation, Privacy, Information Integrity และ Human-AI Configuration
- Google for Developers — Accuracy, Precision, Recall ใช้รองรับการเลือก Metric งาน Classification ตามต้นทุน False Positive และ False Negative
- scikit-learn — Probability Calibration ใช้ประกอบคำอธิบายความหมายของคะแนน ความน่าจะเป็น และ Reliability Diagram
- Vaswani et al. — Attention Is All You Need (2017) ใช้เป็นหลักฐานประวัติศาสตร์ของสถาปัตยกรรม Transformer ซึ่งเป็นฐานของโมเดลภาษาสมัยใหม่จำนวนมาก
- Ho, Jain & Abbeel — Denoising Diffusion Probabilistic Models (2020) ใช้รองรับคำอธิบายกลไก Diffusion ในระดับแนวคิด
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 5 สิงหาคม 2026 · REN นำการอธิบายเชิงระบบ · SHIRO ตรวจการแยกข้อเท็จจริง ข้อเสนอ และข้อจำกัด · Campus Guide เป็นกรณีสมมติเพื่อการศึกษา ไม่ใช่ผลทดสอบผลิตภัณฑ์ · ภาพสรุปเป็นงานต้นฉบับของ Insightful AI World
