เช้าวันเปิดภาคเรียน ศูนย์บริการนักศึกษาของมหาวิทยาลัยได้รับข้อความหลายพันฉบับ บางคนถามกำหนดชำระค่าเทอม บางคนต้องการเปลี่ยนกลุ่มเรียน บางคนส่งใบรับรองแพทย์ และบางคนเล่าว่ากำลังเผชิญเหตุฉุกเฉิน เจ้าหน้าที่มีผู้ช่วย AI ชื่อสมมติว่า “Campus Guide” ซึ่งคัดหมวดข้อความและร่างคำตอบคำถามที่พบบ่อยได้เร็วมาก ในงานที่เตรียมไว้ ระบบดูเหมือนผู้เชี่ยวชาญที่ไม่เคยเหนื่อย
แต่เมื่อคณะหนึ่งเปลี่ยนแบบฟอร์ม เมื่อมีนักศึกษาพิมพ์ภาษาถิ่น หรือเมื่อข้อความเดียวมีทั้งคำถามเรื่องทุนและสัญญาณความเสี่ยง ระบบเริ่มสับสน ความเก่งในงานเดิมไม่ได้ย้ายไปสู่งานใหม่เองโดยอัตโนมัติ เจ้าหน้าที่จึงต้องถามคำถามที่ลึกกว่า “AI ตัวนี้ฉลาดไหม” นั่นคือ ระบบเก่งเรื่องใด ภายใต้เงื่อนไขใด และต้องเตรียมเฉพาะงานมากเพียงใด
Narrow AI คือระบบที่มีความสามารถเชื่อถือได้ภายในขอบเขตงานและเงื่อนไขที่กำหนด ส่วน General AI หรือ AGI เป็นแนวคิดของระบบที่ถ่ายโอนความรู้ เรียนงานใหม่ และปรับตัวข้ามบริบทได้กว้างกว่ามาก อย่างไรก็ตาม ไม่มีนิยามหรือแบบทดสอบ AGI ชุดเดียวที่ทุกฝ่ายยอมรับ บทเรียนนี้จึงไม่พยายามติดป้ายว่าโมเดลใด “ถึง AGI” แต่จะสอนวิธีอ่านหลักฐานอย่างเป็นระบบ
กรณี Campus Guide เป็น สถานการณ์สมมติเพื่อการอธิบาย ไม่ใช่ผลทดสอบของผลิตภัณฑ์จริง เราจะใช้กรณีเดียวนี้ตลอดบท เพื่อดูตั้งแต่อินพุต กลไก ผลลัพธ์ ความล้มเหลว การวัด การกำกับของมนุษย์ และสิ่งที่ต้องพิสูจน์ก่อนขยายขอบเขต
อ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบาย Narrow AI และ General AI ด้วยขอบเขต การถ่ายโอน และการปรับตัว แทนการใช้คำกว้าง ๆ ว่าเก่งหรือไม่เก่งได้
- แยกโมเดล ระบบ ผลิตภัณฑ์ General-purpose AI และแนวคิด AGI พร้อมบอกว่าส่วนใดทำให้ความสามารถดู “กว้าง” ได้
- วาดเส้นทาง Input → Process → Output → Feedback/Human ของระบบหนึ่งตัว และระบุจุดที่ความสามารถอาจพังได้
- ประเมินคำกล่าวอ้างเรื่องความทั่วไปด้วยหลักฐานด้านงานใหม่ การถ่ายโอน การปรับตัว ความทนทาน เครื่องมือ และทรัพยากรได้
- กำหนดขอบเขต สิทธิ์ Stop Rule และแผนเฝ้าระวังสำหรับการใช้ AI อย่างรับผิดชอบได้
ภาพจำเริ่มต้น: ผู้เชี่ยวชาญในห้องหนึ่ง กับผู้เรียนที่ข้ามห้องได้
ลองนึกถึงอาคารที่มีห้องทำงานหลายห้อง ห้องแรกคัดเอกสาร ห้องที่สองตอบคำถาม ห้องที่สามวางแผนตาราง และห้องที่สี่รับมือเหตุการณ์ที่ไม่เคยเกิด ผู้เชี่ยวชาญคนหนึ่งอาจทำงานในห้องแรกได้เร็วและแม่นยำมาก เพราะรู้รูปแบบเอกสาร เครื่องมือ และกฎของห้องนั้น แต่เมื่อย้ายไปห้องใหม่ เขาอาจต้องเริ่มเรียนเกือบทั้งหมด ความเชี่ยวชาญเดิมยังมีคุณค่า เพียงแต่ขอบเขตของมันมีรั้ว
Narrow AI คล้ายผู้เชี่ยวชาญที่ทำงานภายในห้องหรือกลุ่มห้องที่เตรียมไว้ ความแคบไม่ได้หมายถึงระบบเล็ก ราคาถูก หรือไม่มีผลกระทบ ระบบเฉพาะทางอาจควบคุมเครื่องจักร มองหาความผิดปกติในภาพทางการแพทย์ หรือจัดอันดับผู้สมัครงานหลายล้านคน ความเสี่ยงอาจสูงมาก แม้งานจะถูกนิยามแคบ สิ่งที่คำว่า Narrow เตือนเราคือ อย่านำผลงานในขอบเขตหนึ่งไปสรุปว่าระบบจะทำได้ดีทุกขอบเขต
General AI ใช้ภาพของผู้เรียนที่นำความรู้จากห้องหนึ่งไปช่วยอีกห้อง เรียนกติกาใหม่จากคำอธิบายหรือประสบการณ์ไม่กี่ครั้ง ปรับแผนเมื่อสภาพแวดล้อมเปลี่ยน และยังรู้ว่าเมื่อใดควรถามคน การเปรียบเทียบนี้ช่วยเริ่มต้น แต่มีขอบเขต: ระบบ AI ไม่จำเป็นต้องเรียนเหมือนสมองมนุษย์ ไม่จำเป็นต้องมีอารมณ์หรือร่างกายเหมือนคน และคำว่า “ทั่วไป” ต้องผูกกับเกณฑ์ที่ระบุชัด ไม่ใช่ความรู้สึกจากการสนทนาที่ลื่นไหล
ภาพจำที่แม่นกว่าปุ่มเปิด–ปิดคือ แผนที่ความสามารถ ระบบหนึ่งอาจกว้างด้านภาษาแต่แคบด้านการลงมือทำ อาจแก้โจทย์หลายชนิดแต่ไม่เรียนจากข้อผิดพลาดระหว่างใช้งาน อาจวางแผนได้ดีเมื่อมีเครื่องมือครบแต่พังเมื่อเครื่องมือหนึ่งหายไป การอธิบายระบบด้วยโปรไฟล์หลายมิติจึงซื่อสัตย์กว่าป้ายเดียว
อย่าถามเพียงว่า “มันเป็น AGI หรือยัง” ให้ถามว่า “มันทำงานใหม่อะไรได้ ต้องเตรียมอะไรให้ และเมื่อเงื่อนไขเปลี่ยนยังเชื่อถือได้แค่ไหน”
กรณีศึกษา: Campus Guide ทำอะไร และยังทำอะไรไม่ได้
Campus Guide เริ่มจากงานคัดข้อความเข้าห้าหมวด ได้แก่ การเงิน การลงทะเบียน ทุนการศึกษา สุขภาพ และเรื่องทั่วไป ทีมพัฒนามีข้อความเก่าที่เจ้าหน้าที่เคยจัดหมวด จึงใช้ข้อมูลเหล่านั้นฝึกโมเดลจำแนก เมื่อข้อความใหม่เข้ามา ระบบแปลงข้อความเป็นตัวแทนเชิงตัวเลข คำนวณคะแนนของแต่ละหมวด แล้วส่งหมวดที่ได้คะแนนสูงสุดไปยังคิวงานที่เกี่ยวข้อง หากคะแนนต่ำกว่าค่าที่กำหนด ระบบส่งให้เจ้าหน้าที่ตรวจแทน
อินพุตจึงไม่ใช่ “ปัญหาของนักศึกษา” โดยตรง แต่เป็นข้อความและ Metadata ที่ระบบได้รับ กระบวนการไม่ใช่การเข้าใจชีวิตทั้งหมดของผู้ส่ง แต่เป็นการใช้รูปแบบที่เรียนรู้เพื่อประมาณหมวด ผลลัพธ์ไม่ใช่คำตัดสินสุดท้าย แต่เป็นคะแนน หมวด และคำแนะนำเส้นทาง ต่อจากนั้นกฎ Workflow และมนุษย์ตัดสินว่าจะส่งต่อ ตอบกลับ หรือหยุดไว้ตรวจ
เมื่อทีมเพิ่มโมเดลภาษาให้ Campus Guide ร่างคำตอบ ระบบดูทำได้กว้างขึ้น มันอ่านข้อความ ค้นคู่มือ สรุปเงื่อนไข และสร้างข้อความสุภาพ แต่ความสามารถนี้เกิดจากหลายส่วนร่วมกัน: โมเดลภาษา ฐานความรู้ เครื่องมือค้นเอกสาร สิทธิ์เข้าถึง ระบบคัดกรองความปลอดภัย แม่แบบคำตอบ และการอนุมัติของเจ้าหน้าที่ หากหน้าจอเดียวทำได้หลายอย่าง เราไม่ควรให้เครดิตทั้งหมดแก่โมเดลแกนเดียว
ความท้าทายเกิดขึ้นเมื่อคณะสถาปัตยกรรมเปลี่ยนชื่อวิชาและแบบฟอร์ม เอกสารใหม่ไม่ได้อยู่ในฐานความรู้ ระบบอาจตอบจากคู่มือเก่าอย่างมั่นใจ อีกกรณีคือข้อความ “หนูไม่ไหวแล้ว ขอพักการเรียนก่อน” ซึ่งมีทั้งเรื่องทะเบียนและสัญญาณด้านสุขภาวะ ถ้าระบบเลือกเพียงหมวดที่มีคะแนนสูงสุด อาจส่งข้อความไปคิวงานช้าและพลาดการช่วยเหลือที่เร่งด่วน ปัญหานี้ไม่ได้เกิดเพราะ AI “โง่” แต่เกิดจากนิยามงาน ป้ายกำกับ เกณฑ์ตัดสิน และ Workflow ไม่ครอบคลุมโลกจริง
กรณีศึกษานี้จะติดตามหกองค์ประกอบตลอดบท: ขอบเขตงาน อินพุต กลไก ผลลัพธ์ เงื่อนไขล้มเหลว และบทบาทมนุษย์ เมื่อองค์ประกอบใดเปลี่ยน ข้อสรุปเรื่องความสามารถก็อาจเปลี่ยนตาม นี่คือเหตุผลที่รายงานระบบควรบันทึกรุ่น วันที่ เครื่องมือ และสภาพการทดสอบทุกครั้ง
Narrow AI ทำงานอย่างไร: เก่งได้มากเพราะกรอบชัด
Narrow AI มักเริ่มจากการนิยามงานให้วัดได้ เช่น จำแนกข้อความ ทำนายความต้องการ ตรวจวัตถุ วางเส้นทาง หรือสร้างคำตอบจากฐานข้อมูล งานอาจใช้กฎ Search, Machine Learning, Deep Learning หรือหลายวิธีร่วมกัน คำว่า Narrow จึงไม่ได้บอกเทคนิคการสร้าง แต่บอกขอบเขตที่ความสามารถถูกออกแบบ ฝึก และประเมิน
Campus Guide รับข้อความ ภาษา ชนิดช่องทาง และข้อมูลบริบทเท่าที่ได้รับอนุญาต หากอินพุตขาดหรือผิดรูปแบบ สิ่งที่โมเดลเห็นย่อมต่างจากเหตุการณ์จริง
ระบบทำความสะอาดข้อความ เรียกโมเดล ค้นฐานความรู้ และใช้กฎประกอบ แต่ละส่วนมีเวอร์ชันและข้อจำกัดของตน
ผลลัพธ์อาจเป็นหมวด คะแนน ข้อความร่าง หรือคำสั่งเรียกเครื่องมือ ไม่ควรเหมารวมทุกอย่างว่าเป็น “คำตอบของ AI”
Threshold กฎธุรกิจ และเจ้าหน้าที่ตัดสินว่าจะส่งต่อ อนุมัติ แก้ไข หรือหยุด ระบบที่ดีเปิดเผยความไม่แน่นอนและเส้นทางอุทธรณ์
ทีมบันทึกการแก้หมวด ข้อร้องเรียน และการเปลี่ยนข้อมูล แล้วทดสอบก่อนอัปเดตโมเดล Feedback ไม่ได้ทำให้ระบบเรียนทันทีเสมอไป เพราะต้องตรวจคุณภาพและความปลอดภัยก่อน
ความเก่งของระบบเฉพาะทางมาจากการลงทุนในกรอบนี้ ทีมเลือกข้อมูลที่เกี่ยวข้อง สร้างป้ายกำกับ กำหนด Metric ปรับ Threshold และออกแบบเครื่องมือให้ตรงงาน การจำกัดขอบเขตช่วยลดจำนวนสถานการณ์ที่ต้องรับมือ ทำให้ทดสอบได้ละเอียดและสร้าง Stop Rule ได้ชัด นี่ไม่ใช่จุดอ่อน แต่เป็นวิธีวิศวกรรมที่มีประสิทธิภาพ
อย่างไรก็ตาม ขอบเขตที่เขียนบนเอกสารไม่เท่ากับขอบเขตที่ผู้ใช้จะนำไปใช้ นักศึกษาอาจถามเรื่องกฎหมาย สภาพจิตใจ หรือข้อมูลส่วนบุคคลผ่านช่องทางเดียวกัน เจ้าหน้าที่อาจเชื่อคำตอบเพราะภาษาดูมั่นใจ ระบบจึงต้องตรวจทั้ง Intended Use และ Foreseeable Misuse หรือการใช้นอกวัตถุประสงค์ที่คาดได้
คำว่า Weak AI บางครั้งใช้เป็นคำใกล้เคียง Narrow AI แต่คำว่า “อ่อน” ทำให้คนเข้าใจผิดว่าระบบไม่ทรงพลัง บทเรียนนี้จึงใช้ Narrow AI เป็นหลัก และอธิบายขอบเขตอย่างเจาะจงแทนการวัดคุณค่าด้วยคำว่าแข็งหรืออ่อน
General AI หรือ AGI เป็นเป้าหมายแบบใด
Artificial General Intelligence เป็นคำที่มีนิยามหลายแบบ บางกรอบเน้นความกว้างของงาน บางกรอบเน้นระดับฝีมือเทียบมนุษย์ บางกรอบเน้นการเรียนงานใหม่ การใช้ทรัพยากรอย่างมีประสิทธิภาพ หรือความสามารถทำงานในสภาพแวดล้อมเปิด ความแตกต่างเหล่านี้ทำให้ประโยค “ระบบนี้เป็น AGI” ไม่มีความหมายพอ หากไม่บอกว่านิยามใดและหลักฐานใดถูกใช้
รายงาน Stanford AI100 ปี 2021 อธิบาย Narrow AI ว่าเป็นระบบที่เป็นเลิศในงานเฉพาะ และวาง General AI เป็นเป้าหมายด้านความยืดหยุ่นและการปรับตัว ข้อความนี้มีประโยชน์ในฐานะกรอบจากรายงานปี 2021 ไม่ควรถูกนำมาอ้างเหมือนเป็นการสำรวจสถานะล่าสุดของทุกระบบในปี 2026
งานของ François Chollet ปี 2019 เสนอให้มองความฉลาดผ่านประสิทธิภาพในการได้มาซึ่งทักษะ ไม่ใช่คะแนนทักษะปลายทางเพียงอย่างเดียว แนวคิดสำคัญคือ ระบบที่เห็นตัวอย่างจำนวนมหาศาลหรือได้รับความรู้เฉพาะงานมาก อาจทำคะแนนสูงโดยไม่ได้แสดงพลังการสร้างความสามารถใหม่เท่าที่คะแนนบอก เราจึงต้องบันทึก Priors ประสบการณ์ และทรัพยากรที่ระบบได้รับก่อนทดสอบ
กรอบ Levels of AGI ของ Google DeepMind ปี 2023 เป็นข้อเสนอให้แยกสองแกน คือความกว้างของความสามารถและระดับฝีมือ พร้อมแยกความสามารถออกจาก Autonomy หรือระดับที่ระบบลงมือเอง ข้อเสนอนี้ช่วยเตือนว่า ระบบอาจเก่งขึ้นโดยยังไม่ควรได้รับสิทธิ์กว้างขึ้น และคำว่า “ทั่วไป” ไม่ได้แปลว่า “ทำงานโดยไม่มีมนุษย์”
Preprint ของ Bowen Xu ปี 2024 เสนอว่าความฉลาดทั่วไปเกี่ยวข้องกับการปรับตัวในสภาพแวดล้อมเปิดภายใต้ทรัพยากรจำกัด นี่เป็นข้อเสนอเชิงนิยามชิ้นหนึ่ง ไม่ใช่ฉันทามติสุดท้าย คุณค่าของมันคือการชี้ให้เห็นว่าโลกจริงไม่หยุดนิ่ง การวัดระบบเฉพาะชุดข้อสอบคงที่อาจไม่ตอบว่าระบบเรียนและปรับตัวได้อย่างไร
เมื่อนำกรอบเหล่านี้กลับมาที่ Campus Guide คำถามสำคัญไม่ใช่ว่าระบบตอบคำถามได้กี่เมนู แต่คือ เมื่อเจองานใหม่ ระบบใช้ความรู้เดิมได้หรือไม่ ต้องให้ตัวอย่างเฉพาะงานมากเท่าไร เรียนจาก Feedback โดยไม่ทำลายทักษะเดิมหรือไม่ และยังทำงานเมื่อภาษา แบบฟอร์ม หรือเป้าหมายเปลี่ยนหรือไม่
ความสามารถเป็นสเปกตรัม: General-purpose AI ยังไม่เท่ากับ AGI
ระบบสมัยใหม่อาจรองรับข้อความ ภาพ เสียง โค้ด และเครื่องมือหลายชนิด จึงไม่พอดีกับภาพ “หนึ่งโมเดลต่อหนึ่งงาน” แบบเดิม แต่การทำได้หลายงานไม่ได้บังคับให้เราเลือกเพียงสองป้ายว่า Narrow หรือ General เราสามารถอธิบายเป็นสเปกตรัมและโปรไฟล์หลายมิติได้
ทำงานหนึ่งชนิดภายใต้ข้อมูลและเงื่อนไขที่กำหนด เช่น คัดหมวดข้อความห้าประเภท
ใช้โมเดลหรือชุดโมดูลทำหลายงาน แต่แต่ละงานมี Prompt เครื่องมือ หรือข้อมูลเฉพาะ
โมเดลมีความทั่วไปอย่างมีนัยสำคัญและรองรับงานหลากหลาย สามารถนำไปประกอบในระบบปลายทางหลายชนิด
ถ่ายโอน เรียน และปรับตัวข้ามงานกว้างตามนิยามที่ระบุ พร้อมหลักฐานในงานใหม่จริง
กฎหมาย AI Act ของสหภาพยุโรปปี 2024 ให้นิยาม General-purpose AI model ในเชิงกำกับดูแลว่าเป็นโมเดลที่แสดงความทั่วไปอย่างมีนัยสำคัญ ทำงานที่แตกต่างกันได้กว้าง และนำไปบูรณาการในระบบหรือแอปพลิเคชันปลายทางหลายแบบ นิยามนี้มีหน้าที่ทางกฎหมายและห่วงโซ่ความรับผิดชอบ ไม่ใช่คำประกาศว่าโมเดลดังกล่าวมีความฉลาดทั่วไประดับมนุษย์
AI Act ยังแยกโมเดลออกจากระบบ โมเดลต้องมีส่วนประกอบเพิ่มเติม เช่น ส่วนติดต่อ ฐานข้อมูล กฎ และ Workflow จึงกลายเป็นระบบที่ผู้ใช้ใช้งานได้ Campus Guide อาจใช้ General-purpose AI model เป็นแกน แต่ตัวผลิตภัณฑ์ยังถูกจำกัดด้วยเอกสารมหาวิทยาลัย สิทธิ์ เครื่องมือ และขั้นตอนอนุมัติ ความกว้างของโมเดลจึงไม่เท่ากับขอบเขตที่ระบบปลายทางเชื่อถือได้
อีกแหล่งของภาพลวงตาคือการรวมผู้เชี่ยวชาญหลายตัวไว้หลังหน้าจอเดียว ผู้ใช้พิมพ์คำสั่งเดียว แต่เบื้องหลังมีโมเดลคัดหมวด โมเดลภาษา เครื่องคำนวณ ระบบค้นหา และมนุษย์ตรวจ ความสำเร็จของทีมรวมเป็นหลักฐานของสถาปัตยกรรมระบบ ไม่ใช่หลักฐานว่าโมเดลหนึ่งตัวเรียนรู้ทุกทักษะเอง
ดังนั้นรายงานที่ดีควรใช้ประโยคเช่น “ระบบรองรับงาน A, B และ C ด้วยโมเดลฐานรุ่น X เครื่องมือ Y และฐานข้อมูล Z ภายใต้การตรวจของเจ้าหน้าที่” แทนประโยค “AI ทำได้ทุกอย่าง” ประโยคแรกยาวกว่า แต่ตรวจสอบและตัดสินใจได้จริง
โมเดลไม่ใช่ทั้งระบบ: แยกหกชั้นก่อนประเมินความสามารถ
เมื่อ Campus Guide ตอบถูก เราต้องรู้ว่าความสำเร็จมาจากส่วนใด เพราะการแก้ปัญหาและการขยายขอบเขตขึ้นกับคำตอบนี้ หากฐานความรู้มีคำตอบตรง ๆ โมเดลอาจเพียงค้นและเรียบเรียง หากเครื่องมือปฏิทินคำนวณวัน ระบบไม่ได้เรียนปฏิทินทั้งหมดไว้ในพารามิเตอร์ หากเจ้าหน้าที่แก้คำตอบก่อนส่ง ผลลัพธ์สุดท้ายสะท้อนความร่วมมือระหว่างคนกับระบบ
1. งานและเป้าหมาย
ใครต้องตัดสินใจ ผลลัพธ์ที่ดีคืออะไร และความผิดพลาดชนิดใดมีต้นทุนสูง งานที่นิยามกว้างเกินไปทำให้ Metric และผู้รับผิดชอบไม่ชัด
2. ข้อมูลและบริบท
ระบบเห็นข้อความ เอกสาร ประวัติ หรือข้อมูลส่วนบุคคลอะไร ข้อมูลใดขาด ล้าสมัย หรือไม่ได้รับอนุญาตให้ใช้
3. โมเดล
โมเดลแปลงอินพุตและสร้างคะแนนหรือเนื้อหาอย่างไร รุ่นใด ถูกปรับแต่งอย่างไร และมีข้อจำกัดที่ผู้ให้บริการระบุอะไร
4. เครื่องมือและกฎ
ระบบเรียกค้นเว็บ ฐานข้อมูล เครื่องคำนวณ หรือ API ใด Threshold และกฎใดหยุดหรือเปลี่ยนเส้นทางผลลัพธ์
5. มนุษย์และสิทธิ์
ใครตรวจ อนุมัติ Override และอุทธรณ์ ระบบมีสิทธิ์เพียงร่างคำตอบหรือส่งข้อความและเปลี่ยนข้อมูลได้จริง
6. การเฝ้าระวัง
เก็บ Metric ข้อร้องเรียน เหตุการณ์ผิดปกติ และการเปลี่ยนข้อมูลอย่างไร ใครมีอำนาจลดสิทธิ์หรือย้อนกลับรุ่น
หกชั้นนี้ช่วยอธิบายว่าความสามารถกับ Autonomy เป็นคนละเรื่อง Campus Guide อาจร่างคำตอบได้ดี แต่ไม่มีสิทธิ์ส่งเอง ระบบอีกตัวอาจมีความสามารถจำกัดแต่เชื่อม API ที่เปลี่ยนสถานะการลงทะเบียนได้ ผลกระทบของตัวหลังอาจสูงกว่าเพราะลงมือกับโลกจริงได้ การประเมินความเสี่ยงจึงต้องดูทั้งสิ่งที่ระบบ “ทำเป็น” และสิ่งที่ระบบ “ได้รับอนุญาตให้ทำ”
การแยกชั้นยังช่วยกู้คืนเมื่อผิด หากเอกสารล้าสมัย เราอัปเดตฐานความรู้และทดสอบ Retrieval หากการจัดหมวดผิดเฉพาะภาษาถิ่น เราตรวจข้อมูลและป้ายกำกับ หากปุ่มส่งอัตโนมัติทำให้ความผิดพลาดไปถึงผู้ใช้ เราลดสิทธิ์และเพิ่มจุดอนุมัติ การฝึกโมเดลใหม่ไม่ใช่คำตอบเริ่มต้นทุกครั้ง
กลไกที่ต้องพิสูจน์: การถ่ายโอน การเรียนงานใหม่ และการปรับตัว
การถ่ายโอน หมายถึงการนำความรู้หรือทักษะจากบริบทเดิมไปช่วยงานใหม่ ตัวอย่างเช่น Campus Guide เคยเรียนการแยกคำขอ “เพิ่ม–ถอนวิชา” แล้วสามารถใช้แนวคิดเอกสารประกอบและกำหนดเวลาไปช่วยงาน “ย้ายคณะ” โดยไม่ต้องเขียนทุกกฎใหม่ แต่ถ้าทีมสร้าง Prompt และตัวอย่างเฉพาะงานย้ายคณะจำนวนมาก การทำได้ดีอาจมาจากการเตรียมงานใหม่ ไม่ใช่การถ่ายโอนของระบบเองทั้งหมด
การเรียนงานใหม่ ต้องดูจำนวนตัวอย่าง เวลา การคำนวณ และความช่วยเหลือที่ใช้ ระบบที่เรียนจากคำอธิบายหนึ่งหน้าแตกต่างจากระบบที่ต้องรวบรวมข้อมูลหลายหมื่นตัวอย่างและ Fine-tune ใหม่ทั้งชุด ทั้งสองอาจทำงานปลายทางได้เท่ากัน แต่แสดงประสิทธิภาพการได้มาซึ่งทักษะต่างกัน
การปรับตัว หมายถึงการเปลี่ยนพฤติกรรมเมื่อสภาพแวดล้อมหรือ Feedback เปลี่ยน Campus Guide อาจพบว่าปฏิทินการศึกษาปีใหม่เลื่อนวัน ระบบที่ดีต้องอัปเดตแหล่งข้อมูล ตรวจความขัดแย้ง และใช้ข้อมูลใหม่โดยไม่ทำลายคำตอบส่วนอื่น อย่างไรก็ตาม การอัปเดตทันทีจาก Feedback ทุกชิ้นอาจเปิดทางให้ข้อมูลผิดหรือการโจมตี การปรับตัวที่รับผิดชอบจึงต้องมีการคัดกรองและย้อนกลับได้
ความทนทาน ทดสอบว่าระบบยังทำงานเมื่อถ้อยคำ ภาษา ลำดับข้อมูล หรือช่องทางเปลี่ยนหรือไม่ ถ้าคะแนนสูงเฉพาะข้อความภาษาไทยมาตรฐาน แต่ตกมากเมื่อมีคำสะกดผิดหรือข้อความผสมภาษา รายงานต้องแสดงโปรไฟล์นี้ ไม่ควรใช้ค่าเฉลี่ยเดียวปิดบัง
การรักษาทักษะเดิม สำคัญเช่นกัน ระบบอาจเรียนงานใหม่แล้วลืมงานเดิม หรือการแก้ Prompt เรื่องทุนทำให้คำตอบด้านทะเบียนเสีย การทดสอบ Regression จึงต้องรวมกรณีเดิมที่สำคัญ ไม่ใช่ดูเฉพาะตัวอย่างใหม่ที่ทีมกำลังแก้
เมื่อรวมกลไกเหล่านี้ คำกล่าวเรื่องความทั่วไปจึงต้องตอบเป็นลำดับ: งานใหม่คืออะไร ระบบได้รับอะไรล่วงหน้า ใช้ความช่วยเหลือเท่าไร ทำซ้ำได้หรือไม่ ทักษะเดิมยังอยู่หรือไม่ และล้มเหลวตรงไหน หากข้อมูลเหล่านี้หายไป เราเห็นเพียงเดโม ไม่ใช่หลักฐานของความทั่วไป
จะวัดความทั่วไปอย่างไรโดยไม่หลอกตัวเอง
การวัดเริ่มจากนิยาม Claim ให้แคบพอทดสอบ หาก Claim คือ “ทำงานภาษาได้ทั่วไป” ทีมต้องกำหนดกลุ่มงาน ระดับฝีมือ ภาษา เครื่องมือ และขอบเขตเวลา หาก Claim คือ “เรียนงานใหม่ได้” ต้องกำหนดว่างานใหม่แค่ไหน จำนวนตัวอย่างที่อนุญาต และสิ่งที่ระบบเคยเห็น การปล่อยคำว่า “ทั่วไป” ไว้กว้างทำให้เลือกเฉพาะผลที่ดูดีได้ง่าย
| มิติ | คำถามทดสอบกับ Campus Guide | หลักฐานที่ควรเก็บ | สิ่งที่ทำให้คะแนนลวง |
|---|---|---|---|
| ความกว้าง | รองรับงานคนละชนิดกี่กลุ่ม ไม่ใช่เพียงหัวข้อย่อยของงานเดียว | Taxonomy งานและผลแยกรายกลุ่ม | นับ Prompt หลายแบบเป็นหลายความสามารถ |
| งานใหม่ | ทำโจทย์ที่ไม่เปิดเผยล่วงหน้าและไม่คล้ายแม่แบบเดิมได้หรือไม่ | ชุดทดสอบปิดและประวัติการเข้าถึง | ข้อมูลรั่วหรือข้อสอบคล้ายข้อมูลฝึก |
| การถ่ายโอน | ใช้หลักจากงานทะเบียนไปช่วยงานใหม่ได้มากเพียงใด | Baseline ก่อน–หลังและทรัพยากรที่เพิ่ม | ให้ตัวอย่างเฉพาะงานจนแทบเขียนคำตอบให้ |
| การปรับตัว | เมื่อกฎและเอกสารเปลี่ยน ระบบเรียนรู้โดยใช้ข้อมูลใหม่เท่าไร | เวลา จำนวนตัวอย่าง การคำนวณ และการแทรกแซงคน | Fine-tune ใหม่โดยไม่รายงานต้นทุน |
| ความทนทาน | ยังทำงานเมื่อภาษา รูปแบบ และกลุ่มผู้ใช้เปลี่ยนหรือไม่ | ผลรายบริบทและช่วงความไม่แน่นอน | รายงานค่าเฉลี่ยและซ่อนกลุ่มที่พัง |
| ความปลอดภัย | รู้ขอบเขต ขอคนช่วย และหยุดเมื่อความเสี่ยงสูงได้หรือไม่ | อัตราส่งต่อ เหตุการณ์ผิดปกติ และผลกระทบ | ให้คะแนนเฉพาะคำตอบสำเร็จ ไม่วัดความเสียหาย |
ชุดทดสอบต้องแยกจากชุดพัฒนา ผู้สร้างระบบไม่ควรเห็นคำตอบทั้งหมดล่วงหน้า และต้องบันทึกเครื่องมือที่อนุญาต การให้ระบบค้นเว็บหรือใช้เครื่องคิดเลขไม่ใช่การโกง หากนั่นคือเงื่อนไขจริง แต่ต้องเปิดเผยเพื่อให้เปรียบเทียบได้อย่างยุติธรรม ระบบที่มีเครื่องมือกับระบบที่ไม่มีเครื่องมือกำลังถูกวัดคนละเงื่อนไข
การทำซ้ำสำคัญเพราะโมเดลสร้างอาจให้คำตอบต่างกันในแต่ละครั้ง หนึ่งตัวอย่างที่สวยไม่พอ ทีมควรทดสอบหลายรอบ รายงานการกระจายผล และดู Worst-case ที่สัมพันธ์กับความเสียหาย หาก Campus Guide ตอบถูก 98 ครั้งแต่สองครั้งเปิดเผยข้อมูลส่วนบุคคล ค่าเฉลี่ย 98% ไม่ได้ทำให้ระบบพร้อมส่งอัตโนมัติ
Baseline ช่วยป้องกันการหลงกับความใหม่ เปรียบเทียบกับการค้นคู่มือแบบเดิม เจ้าหน้าที่มนุษย์ ระบบกฎ หรือโมเดลรุ่นก่อน หากระบบใหม่เพิ่มความเร็วเล็กน้อยแต่สร้างภาระตรวจมากขึ้น Outcome อาจไม่ดีขึ้น Metric ของโมเดลต้องเชื่อมกับ Metric ของบริการ เช่น เวลารอ จำนวนเคสที่แก้ได้ครั้งแรก ความเป็นธรรม และความสามารถอุทธรณ์
สุดท้ายต้องบอกสิ่งที่ยังไม่รู้ ตัวอย่างเช่น ยังไม่ได้ทดสอบภาษาถิ่น ยังไม่มีข้อมูลช่วงวิกฤต หรือยังไม่ทราบผลเมื่อผู้ใช้ตั้งใจหลอกระบบ การเปิดเผยช่องว่างไม่ได้ลดความน่าเชื่อถือ กลับช่วยให้ผู้อ่านรู้ว่าข้อสรุปใช้ได้ไกลแค่ไหน
Failure Case: เมื่อคะแนนดี แต่ข้อสรุปเรื่องความทั่วไปผิด
กรณีที่ 1 — ข้อมูลรั่วทำให้งานใหม่ไม่ใหม่จริง
ทีมสร้างชุดทดสอบจากคำถามในคู่มือปีที่แล้ว แต่คู่มือเดียวกันอยู่ในฐานข้อมูลที่ Campus Guide ค้นได้ ระบบตอบถูกสูงมาก ทีมจึงสรุปว่ามันแก้โจทย์ใหม่ได้ ที่จริงระบบอาจค้นประโยคคำตอบตรง ๆ การทดสอบนี้วัดความสามารถค้นและจับคู่ ไม่ได้วัดการถ่ายโอนสู่สถานการณ์ใหม่
วิธีตรวจคือสร้างโจทย์ที่ต้องใช้หลักเดียวกันในบริบทใหม่ เก็บชุดทดสอบไว้ต่างหาก ตรวจเส้นทาง Retrieval และเปรียบเทียบกับ Baseline ค้นคำ หากโมเดลไม่ดีกว่าการค้นตรง เราควรรายงานตามนั้น ไม่ควรขยาย Claim
กรณีที่ 2 — ส่วนติดต่อเดียวซ่อนผู้เชี่ยวชาญหลายตัว
Campus Guide ตอบเรื่องทุน คำนวณค่าธรรมเนียม และนัดหมายได้ ผู้ใช้จึงคิดว่าโมเดลเดียวมีความเข้าใจทั่วไป แต่เบื้องหลังงานแรกใช้ฐานความรู้ งานที่สองเรียกเครื่องคำนวณ และงานที่สามเรียกปฏิทิน ความสำเร็จเกิดจาก Orchestration ที่ดี นี่เป็นคุณค่าของระบบ แต่ไม่ใช่หลักฐานว่าโมเดลแกนเรียนทักษะทั้งหมดเอง
วิธีตรวจคือทำ System Card แยกส่วนประกอบ ปิดเครื่องมือทีละตัวอย่างปลอดภัย และบันทึกว่าความสามารถใดหายไป การทดสอบแบบนี้ช่วยออกแบบ Recovery เช่น หากปฏิทินล่ม ให้ระบบหยุดนัดหมายและส่งต่อ ไม่ใช่เดาวันขึ้นมา
กรณีที่ 3 — ค่าเฉลี่ยซ่อนผู้ใช้ที่ได้รับผลเสีย
Accuracy การคัดหมวดเท่ากับ 94% แต่ข้อความภาษาถิ่นจากวิทยาเขตภูมิภาคถูกจัดผิดมากกว่ากลุ่มอื่นสามเท่า ทีมที่ดูค่าเฉลี่ยอาจประกาศระบบพร้อมใช้ทั่วมหาวิทยาลัย ทั้งที่การขยายพื้นที่เพิ่มความเหลื่อมล้ำ การวัดแยกตามบริบทและกลุ่มผู้ใช้จึงจำเป็นเมื่อผลลัพธ์กระทบสิทธิ์หรือโอกาส
วิธีแก้ไม่ใช่เพียงเพิ่มข้อมูลโดยอัตโนมัติ ต้องตรวจความยินยอม คุณภาพป้ายกำกับ และกลไกความเสียหาย ระหว่างแก้ควรลด Automation ให้เจ้าหน้าที่ตรวจเคสจากบริบทที่ระบบยังไม่น่าเชื่อถือ พร้อมเปิดช่องทางอุทธรณ์และบันทึกเหตุผล
กรณีที่ 4 — เรียนงานใหม่ แต่ลืมงานเดิม
หลังปรับ Campus Guide ให้ตอบกฎทุนใหม่ คะแนนเรื่องทุนดีขึ้น แต่ระบบเริ่มใช้คำตอบทุนกับคำถามค่าเทอมบางแบบ ทีมที่ทดสอบเฉพาะงานใหม่อาจไม่เห็น Regression การปรับตัวที่ดีต้องรักษาความสามารถเดิมที่สำคัญ หรืออย่างน้อยตรวจพบและลดผลกระทบเมื่อเกิดการแลกเปลี่ยน
Recovery Step คือย้อนกลับรุ่น ลดสิทธิ์เป็นร่างคำตอบ ตรวจชุด Regression ครอบคลุมงานเดิม และหาสาเหตุว่าปัญหาอยู่ที่ข้อมูล Prompt Retrieval หรือโมเดล การเปิดใช้อัตโนมัติอีกครั้งต้องผ่านเกณฑ์เดิมและเกณฑ์ใหม่ ไม่ใช่เพียงทำให้กราฟล่าสุดสูงขึ้น
ข้อจำกัด ความเสี่ยง และบทบาทของมนุษย์
ระบบที่กว้างขึ้นมีพื้นที่ใช้งานมากขึ้น จึงมีพื้นที่ล้มเหลวและผู้ได้รับผลกระทบมากขึ้นด้วย ความสามารถทั่วไปไม่ใช่ใบรับรองความปลอดภัย ในทางกลับกัน ระบบเฉพาะทางก็ไม่ปลอดภัยโดยอัตโนมัติ Campus Guide แบบ Narrow อาจส่งข้อมูลสุขภาพผิดคน หากสิทธิ์และ Workflow ออกแบบไม่ดี
ผู้ได้รับผลกระทบไม่ได้มีเพียงผู้ใช้ที่พิมพ์ข้อความ นักศึกษาอาจถูกเลื่อนการช่วยเหลือ เจ้าหน้าที่อาจต้องรับภาระตรวจที่ซ่อนอยู่ ผู้ดูแลระบบอาจได้รับ Alert มากเกินไป และมหาวิทยาลัยอาจตัดสินใจจากสถิติที่มีอคติ การประเมินต้องถามว่าใครได้ประโยชน์ ใครรับความเสี่ยง และใครมีสิทธิ์อุทธรณ์
ข้อมูลส่วนบุคคลเป็นขอบเขตสำคัญ ระบบควรได้รับข้อมูลเท่าที่จำเป็น มีการแยกสิทธิ์ บันทึกการเข้าถึง และกำหนดระยะเวลาเก็บ การเพิ่มความสามารถด้วยการให้ข้อมูลมากขึ้นอาจเพิ่มความเสี่ยงมากกว่าประโยชน์ ต้องประเมินตามงาน ไม่ใช่สมมติว่าโมเดลกว้างต้องเห็นทุกอย่าง
มนุษย์ต้องมีบทบาทที่ทำได้จริง ไม่ใช่คำว่า Human-in-the-loop ที่อยู่บนเอกสาร เจ้าหน้าที่ต้องเห็นข้อมูลที่ใช้ตัดสิน เหตุผลหรือหลักฐานอ้างอิง จุดไม่แน่นอน และมีเวลาพอจะตรวจ หากระบบส่งงานจำนวนมากจนคนกดอนุมัติอัตโนมัติ การมีปุ่มอนุมัติไม่ได้ทำให้การกำกับมีความหมาย
Stop Rule ของ Campus Guide อาจกำหนดว่า ข้อความที่มีสัญญาณฉุกเฉิน ข้อมูลสุขภาพ ความขัดแย้งของเอกสาร หรือคะแนนความมั่นใจต่ำต้องหยุดส่งอัตโนมัติและเข้าสู่คิวคน หากอัตราการแก้คำตอบเกินเกณฑ์ หรือผลรายกลุ่มตกเกินระดับที่กำหนด ต้องลดสิทธิ์ทั้งระบบและสอบสวน
NIST AI RMF แนะนำการจัดการความเสี่ยงตลอดวงจรผ่านการกำหนดบริบท การวัด การจัดการ และการกำกับ กรอบนี้ไม่ตัดสินว่าระบบเป็น AGI หรือไม่ แต่ช่วยให้ทีมไม่ปล่อยคำถามเรื่องความทั่วไปแยกจากความน่าเชื่อถือและผลกระทบจริง
Readiness Checklist: ก่อนขยายขอบเขตหรือเพิ่มสิทธิ์
- ระบุ Claim ให้ทดสอบได้: บอกกลุ่มงาน ระดับฝีมือ ภาษา เครื่องมือ และรุ่น ห้ามใช้ “ทำได้ทุกอย่าง” เป็นเกณฑ์ผ่าน
- แยกงานใหม่ออกจากงานเดิม: ตรวจว่าชุดทดสอบไม่รั่ว ไม่ซ้ำแม่แบบ และไม่ถูกเตรียมเฉพาะจน Claim เปลี่ยน
- บันทึกทรัพยากร: จำนวนตัวอย่าง เวลา Compute เครื่องมือ Prompt และการช่วยของมนุษย์ต้องอยู่ในรายงาน
- เทียบ Baseline: เปรียบเทียบกับวิธีเดิม รุ่นก่อน และคนภายใต้เงื่อนไขที่เป็นธรรม
- วัดรายบริบท: ดูภาษา รูปแบบ กลุ่มผู้ใช้ และกรณีชายขอบ ไม่ใช้ค่าเฉลี่ยเดียว
- ทดสอบ Regression: งานใหม่ดีขึ้นแล้วงานเดิมที่สำคัญยังผ่านเกณฑ์
- แยกความสามารถจากสิทธิ์: ระบบทำเป็นไม่ได้แปลว่าควรได้รับอนุญาตให้ทำเอง
- กำหนด Human Review: ใครตรวจ เห็นข้อมูลอะไร มีเวลาพอหรือไม่ และ Override ได้จริง
- กำหนด Stop Rule: สัญญาณใดต้องหยุด ลดสิทธิ์ ย้อนรุ่น หรือแจ้งเหตุ
- ระบุเจ้าของระบบ: ใครรับผิดชอบ Metric เอกสาร ข้อร้องเรียน และการอัปเดตหลังเปิดใช้
เกณฑ์ผ่านไม่จำเป็นต้องเป็น “ระบบสมบูรณ์แบบ” แต่ต้องสอดคล้องกับความเสี่ยง ตัวช่วยร่างข้อความที่คนตรวจทุกครั้งอาจยอมรับข้อผิดพลาดมากกว่าระบบที่ส่งคำสั่งเปลี่ยนสถานะการลงทะเบียน การเพิ่มสิทธิ์ควรเกิดหลังหลักฐาน ไม่ใช่หลังเดโมดูฉลาด
หากข้อใดไม่ผ่าน ให้ลดขอบเขตหรือสิทธิ์ก่อน ตัวอย่างเช่น เปลี่ยนจากส่งคำตอบอัตโนมัติเป็นร่าง เปลี่ยนจากทุกภาษาเป็นเฉพาะภาษาที่ทดสอบ หรือเปิดใช้กับงานข้อมูลสาธารณะก่อนข้อมูลสุขภาพ การจำกัดอย่างตั้งใจเป็นสัญญาณของระบบรับผิดชอบ ไม่ใช่ความล้มเหลวของนวัตกรรม
แบบฝึกปฏิบัติ: วาดแผนที่ขอบเขตของ AI ที่คุณใช้
ภารกิจ 25 นาที
สิ่งที่ต้องเลือก: เลือกระบบ AI ที่คุณใช้จริงหนึ่งระบบ อาจเป็นผู้ช่วยเขียน แชตบอต ระบบแนะนำ หรือเครื่องมือสร้างภาพ หลีกเลี่ยงการใส่ข้อมูลลับในแบบฝึก
- เขียนงานที่คุณมีหลักฐานว่าระบบทำได้ดีสามข้อ ระบุอินพุต ผลลัพธ์ และวิธีที่คุณตรวจ
- เขียนงานสามข้อที่ระบบดูเหมือนทำได้ แต่คุณยังไม่มีหลักฐานเพียงพอ
- วาดหกชั้น: งาน ข้อมูล โมเดล เครื่องมือ มนุษย์ และการเฝ้าระวัง
- เลือกงานใหม่หนึ่งงาน เปลี่ยนภาษา รูปแบบ หรือบริบท แล้วคาดการณ์ว่าส่วนใดจะพัง
- ออกแบบการทดสอบถ่ายโอน ระบุสิ่งที่อนุญาตให้ระบบเห็น จำนวนตัวอย่าง และ Baseline
- กำหนด Stop Rule หนึ่งข้อ ผู้รับผิดชอบ และ Recovery Step
หลักฐานว่าสำเร็จ: คนอีกคนอ่านแผนที่แล้วสามารถบอกได้ว่าอะไรคือความสามารถของโมเดล อะไรเกิดจากเครื่องมือ ขอบเขตใดยังไม่ทดสอบ และเมื่อใดต้องหยุด โดยไม่ต้องใช้คำว่า “ฉลาดมาก” หรือ “เป็น AGI”
คำถาม Why/How: เหตุใดงานใหม่จึงต่างจากงานเดิมจริง ระบบถ่ายโอนหลักใดไปใช้ ทรัพยากรใดทำให้คะแนนดีขึ้น และข้อสรุปจะเปลี่ยนหากเอาเครื่องมือหนึ่งออกหรือไม่
Recovery Step: หากวาดไม่ออก ให้เริ่มจากการบันทึกหนึ่งรอบการใช้งานจริงแบบไม่ใส่ข้อมูลส่วนตัว เขียน Input → สิ่งที่ระบบทำ → Output → สิ่งที่คุณแก้ จากนั้นค่อยเติมโมเดลและเครื่องมือที่ยังไม่รู้ด้วยคำว่า “ต้องตรวจเพิ่ม” ห้ามเดารายละเอียดภายในผลิตภัณฑ์
ความเข้าใจผิดที่พบบ่อย
“โมเดลใหญ่กว่า จึงทั่วไปกว่าเสมอ”
กลไกที่ทำให้คิดเช่นนั้น: ขนาดและข้อมูลมากขึ้นอาจเพิ่มความสามารถหลายด้านพร้อมกัน ทำให้เดโมดูครอบคลุม สิ่งที่ถูกต้อง: ขนาดไม่รับรองงานใหม่ ความทนทาน ประสิทธิภาพการเรียน หรือความปลอดภัย วิธีตรวจ: ทดสอบโปรไฟล์หลายมิติและรายงานทรัพยากร ไม่ใช้จำนวนพารามิเตอร์แทนผลทั้งหมด
“พูดเหมือนคน แปลว่าเข้าใจทั่วไปเหมือนคน”
กลไกที่ทำให้คิดเช่นนั้น: มนุษย์ใช้ภาษาเป็นสัญญาณของความคิดและความตั้งใจ สิ่งที่ถูกต้อง: ความลื่นไหลเป็นพฤติกรรมที่สังเกตได้ แต่แยกจากความถูกต้อง การเชื่อมโลกจริง และการปรับตัว วิธีตรวจ: เปลี่ยนโจทย์ ตรวจหลักฐาน ให้ระบบอธิบายข้อจำกัด และดูความสม่ำเสมอหลายรอบ
“ทำหลายงานหลังหน้าจอเดียว จึงเป็น AGI”
กลไกที่ทำให้คิดเช่นนั้น: ส่วนติดต่อซ่อนโมเดล เครื่องมือ และมนุษย์หลายส่วน สิ่งที่ถูกต้อง: ผลิตภัณฑ์กว้างอาจมีคุณค่ามาก แต่ต้องแยกความสามารถของระบบรวมออกจากโมเดล วิธีตรวจ: ทำแผนภาพส่วนประกอบและปิดเครื่องมือทีละส่วนอย่างปลอดภัย
“ถ้ายังนิยาม AGI ไม่ลงตัว ก็วัดอะไรไม่ได้”
กลไกที่ทำให้คิดเช่นนั้น: คนต้องการเส้นแบ่งเดียวที่ให้คำตอบง่าย สิ่งที่ถูกต้อง: เรายังวัดงานใหม่ การถ่ายโอน การปรับตัว ความทนทาน และทรัพยากรได้ เพียงต้องระบุนิยามและขอบเขต วิธีตรวจ: เปลี่ยน Claim กว้างให้เป็นคำถามทดสอบที่ทำซ้ำได้
แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่อธิบายกลไกหรือการตัดสินใจได้ดีที่สุด แล้วกด “ตรวจคำตอบ” ระบบจะแสดงคะแนนรวม เฉลย และเหตุผลรายข้อ หากเว้นคำตอบ ระบบจะแจ้งจำนวนข้อที่ยังไม่ได้ตอบ
คำถามที่พบบ่อย
AI ปัจจุบันทั้งหมดเป็น Narrow AI หรือไม่
คำตอบขึ้นกับนิยามและช่วงเวลาของแหล่งอ้างอิง รายงาน Stanford AI100 ปี 2021 จัดแอปพลิเคชันแนวหน้าในเวลานั้นเป็น Narrow AI แต่ระบบรุ่นใหม่รองรับงานกว้างขึ้นมาก การพูดในปี 2026 จึงควรระบุโปรไฟล์ความสามารถและหลักฐานแทนการยกประโยคปี 2021 เป็นสถานะปัจจุบันโดยตรง หากใช้คำว่า Narrow ให้บอกว่าขอบเขตใดและการถ่ายโอนใดยังไม่ผ่าน
LLM คือ AGI หรือไม่
LLM และระบบที่สร้างจาก LLM ทำงานภาษาและเชื่อมเครื่องมือได้กว้าง แต่คำว่า AGI ต้องแนบเกณฑ์ด้านความกว้าง ระดับฝีมือ การถ่ายโอน การปรับตัว ทรัพยากร และความทนทาน การทำหลายงานหรือสนทนาลื่นไหลจึงไม่ใช่คำพิสูจน์ด้วยตัวเอง บทเรียนนี้ไม่ตัดสินโมเดลรายชื่อใด เพราะผลเปลี่ยนตามรุ่น เครื่องมือ และการทดสอบ
General AI ต่างจาก Superintelligence อย่างไร
AGI มักกล่าวถึงความสามารถที่กว้างและทั่วไปตามเกณฑ์หนึ่ง ส่วน Artificial Superintelligence กล่าวถึงระดับความสามารถที่เหนือมนุษย์อย่างกว้างขวาง สองคำนี้เป็นคนละ Claim ระบบอาจถูกเรียกทั่วไปโดยยังไม่เหนือมนุษย์ทุกด้าน และการพูดถึง Superintelligence ต้องระบุขอบเขตเช่นเดียวกัน
ระบบเฉพาะทางปลอดภัยกว่าระบบทั่วไปเสมอหรือไม่
ไม่เสมอ ความเสี่ยงขึ้นกับงาน ข้อมูล อำนาจ ขนาดการใช้ และการควบคุม ระบบเฉพาะทางที่ตัดสินสินเชื่อหรือช่วยจัดลำดับการรักษาอาจกระทบคนรุนแรง ระบบกว้างที่ใช้เพียงร่างข้อความและมีคนตรวจอาจมีผลย้อนกลับได้มากกว่า ต้องประเมินตามเส้นทางความเสียหายจริง
ถ้าไม่มีเกณฑ์ AGI เดียว เราควรเลิกใช้คำนี้หรือไม่
ไม่จำเป็น แต่ควรใช้แบบมีเงื่อนไข ระบุนิยาม แหล่งที่มา งาน ระดับฝีมือ และสิ่งที่ยังไม่รู้ การถกเถียงเรื่องนิยามมีประโยชน์เมื่อช่วยออกแบบการวัด ไม่ใช่เมื่อใช้เป็นป้ายโฆษณาที่หลีกเลี่ยงการตรวจสอบ
สรุปบทเรียน: ความทั่วไปต้องพิสูจน์ด้วยการข้ามขอบเขต
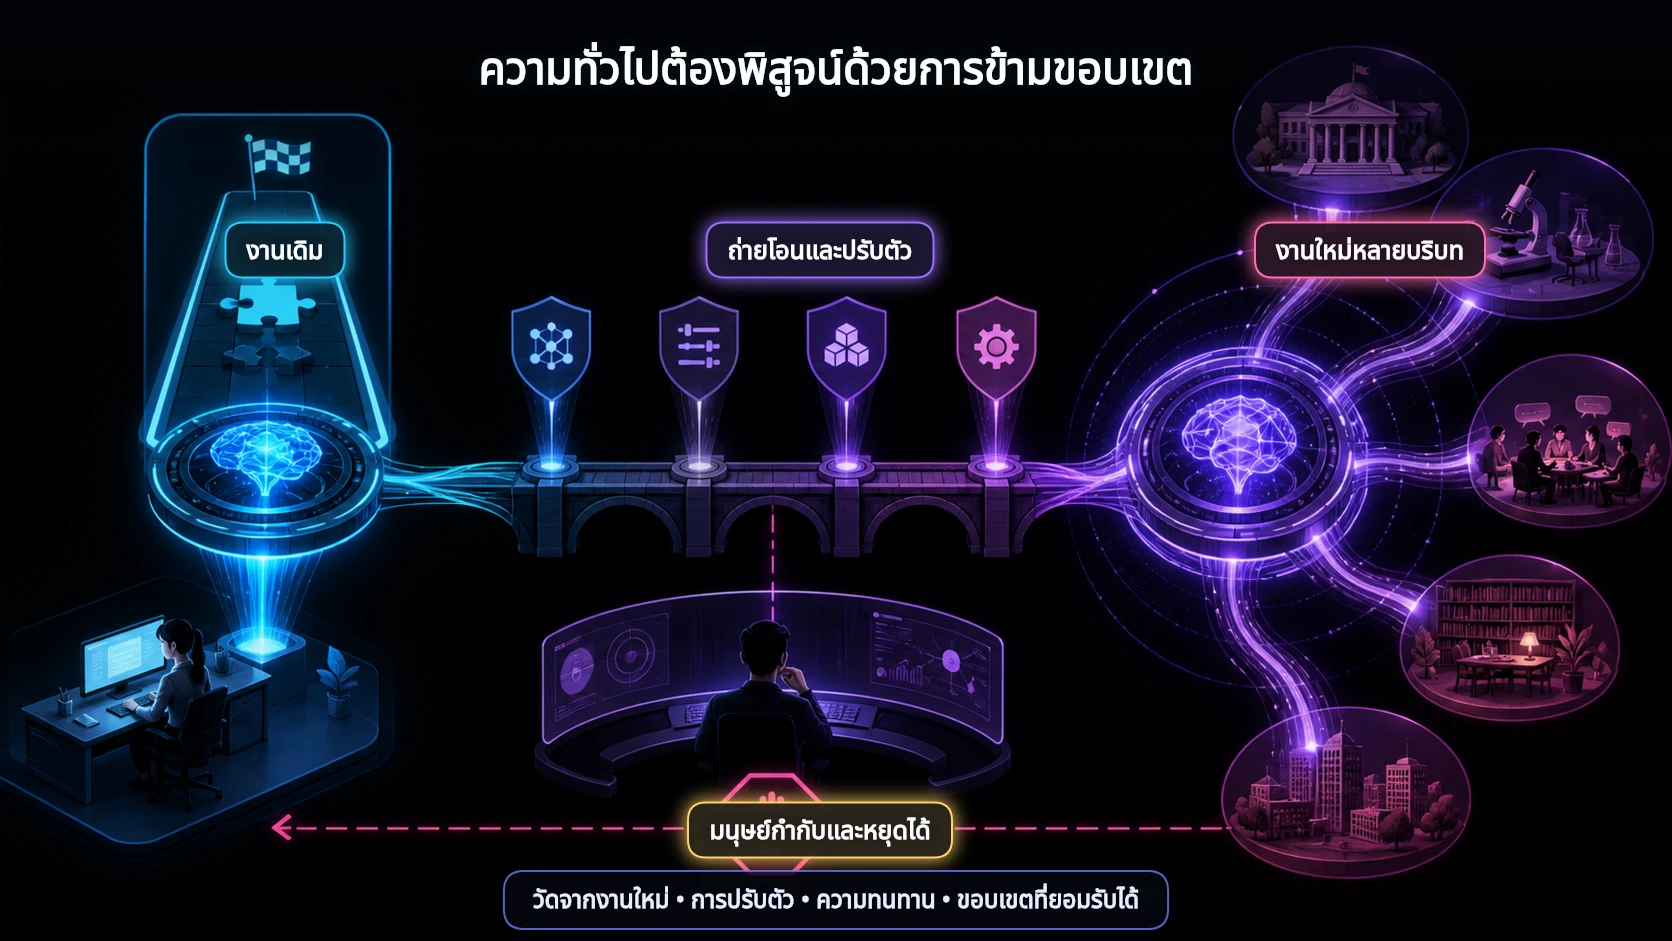
กลับมาที่ Campus Guide หากระบบคัดหมวดห้าประเภทได้ดี เรามีหลักฐานของความสามารถเฉพาะงาน หากเพิ่มฐานความรู้และเครื่องมือแล้วตอบหลายเรื่องได้ เรามีหลักฐานของระบบที่กว้างขึ้น หากต้องการอ้างความทั่วไป เราต้องแสดงว่างานใหม่ต่างจริง ระบบถ่ายโอนความรู้ได้โดยใช้ทรัพยากรสมเหตุผล ปรับตัวโดยไม่ลืมงานเดิม และยังทำงานเมื่อบริบทเปลี่ยน
Narrow AI ไม่ใช่คำดูถูก มันคือการยอมรับขอบเขตที่ทำให้เราทดสอบ ออกแบบ Workflow และรับผิดชอบได้ General-purpose AI เป็นคำที่มีหน้าที่ด้านการนำไปใช้และกำกับโมเดลกว้าง แต่ไม่ใช่คำพ้องกับ AGI ส่วน AGI เป็นแนวคิดที่ต้องแนบนิยามและหลักฐาน ไม่ควรตัดสินจากภาษาที่ลื่นไหลหรือเดโมหนึ่งครั้ง
ถ้าจำได้เพียงกฎเดียว ให้จำว่า ความสามารถกับสิทธิ์เป็นคนละเรื่อง ระบบเก่งขึ้นไม่ได้แปลว่าควรลงมือเองมากขึ้น ขยายสิทธิ์หลังผ่านการทดสอบ มี Human Review ที่ทำได้จริง มี Stop Rule และมีเจ้าของที่เฝ้าระวังผลกระทบ
บทถัดไปจะเปลี่ยนจากคำถามเรื่อง “ขอบเขตกว้างเพียงใด” ไปสู่คำถามว่า “ผลลัพธ์ชนิดใด” โดยแยก Predictive AI ที่ประมาณค่าหรือเหตุการณ์ออกจาก Generative AI ที่สร้างตัวอย่างใหม่ การแยกสองแกนนี้ช่วยให้เลือก Metric และความเสี่ยงได้แม่นขึ้น
ภารกิจหลังเรียน: เลือก AI หนึ่งระบบแล้วเขียนประโยคใหม่โดยไม่ใช้คำว่า “ฉลาด” ระบุงาน อินพุต เครื่องมือ ขอบเขตที่ทดสอบ และ Stop Rule ให้คนอื่นตรวจตามได้
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงหลักและหมายเหตุบรรณาธิการ
- Stanford AI100 — What are the prospects for more general artificial intelligence? (2021) ใช้รองรับความต่างเชิงเป้าหมายระหว่าง Narrow AI กับ General AI โดยระบุปีเพื่อไม่ตีความเป็นสถานะล่าสุด
- François Chollet — On the Measure of Intelligence (2019) ใช้รองรับแนวคิดว่าคะแนนทักษะปลายทางไม่พอ ต้องดู Priors ประสบการณ์ และประสิทธิภาพการได้มาซึ่งทักษะ
- Google DeepMind — Levels of AGI for Operationalizing Progress on the Path to AGI (2023) ใช้เป็นกรอบข้อเสนอเรื่องความกว้าง ระดับฝีมือ และการแยก Capability ออกจาก Autonomy
- Regulation (EU) 2024/1689 — EU AI Act ใช้รองรับนิยามทางกฎหมายของ General-purpose AI model และการแยกโมเดลออกจากระบบ
- Bowen Xu — What is Meant by AGI? (2024 preprint) ใช้เป็นตัวอย่างข้อเสนอเชิงนิยามที่เน้นการปรับตัวในสภาพแวดล้อมเปิดและทรัพยากรจำกัด ไม่ได้นำเสนอเป็นฉันทามติ
- NIST — AI Risk Management Framework 1.0 ใช้รองรับการกำหนดบริบท วัด จัดการ และกำกับความเสี่ยงตลอดวงจร
ข้อเท็จจริง แหล่งอ้างอิง และถ้อยคำภาษาไทยตรวจล่าสุด: 5 สิงหาคม 2026 · AIKO นำการอธิบายสำหรับผู้เริ่มต้น · SHIRO ตรวจการแยกข้อเท็จจริง ข้อเสนอเชิงนิยาม และข้อจำกัด · Campus Guide เป็นกรณีสมมติเพื่อการศึกษา ไม่ใช่ผลทดสอบผลิตภัณฑ์จริง · ภาพสรุปเป็นงานต้นฉบับสำหรับบทเรียนนี้
