ลองถ่ายภาพใบเสร็จค่าอาหารแล้วส่งให้แอปบันทึกรายจ่าย ภายในไม่กี่วินาที หน้าจอแสดงชื่อร้าน วันที่ และยอดรวม แต่คราวนี้แอปอ่านยอด 1,280 บาท เป็น 12,800 บาท หากเราพูดเพียงว่า “AI อ่านผิด” เราจะยังไม่รู้ว่าควรแก้โมเดล กล้อง การหมุนภาพ การตัดขอบ การอ่านจุดทศนิยม กฎตรวจยอด หรือหน้าจอที่ให้ผู้ใช้ยืนยัน
บทเรียนนี้จะพาใบเสร็จฉบับเดียวเดินผ่านสายงานทั้งหมด ตั้งแต่ไฟล์ภาพดิบจนกลายเป็นข้อมูลรายจ่ายที่ระบบนำไปใช้ เราจะหยุดดูทุกจุดที่ข้อมูลเปลี่ยนรูป ถามว่าสัญญาของขั้นนั้นคืออะไร ถ้าพลาดจะส่งผลอย่างไร และต้องเก็บหลักฐานใดจึงย้อนตรวจได้ เป้าหมายคือทำให้คำว่า การประมวลผล กลายเป็นแผนที่ที่มองเห็น ไม่ใช่กล่องดำอีกคำหนึ่ง
ความรู้ก่อนเรียน: หากทบทวนบทบาทของข้อมูลและโมเดลจากหัวข้อ 15–16 มาก่อน จะช่วยให้เห็นว่าอินพุตถูกแปลงและส่งต่ออย่างไรในแต่ละช่วง
เมื่ออ่านจบบทนี้ คุณจะทำอะไรได้
- วาดสายงาน Raw Input → Validate → Transform → Model → Policy → Output → Feedback ได้
- เขียน Data Contract ขั้นพื้นฐาน โดยระบุรูปแบบ ช่วงค่า หน่วย สิทธิ์ และพฤติกรรมเมื่อข้อมูลผิดได้
- แยก Pre-processing, Inference และ Post-processing พร้อมอธิบาย Training–Serving Skew ได้
- ออกแบบ Timeout, Retry, Idempotency, Fallback และ Rollback ให้เหมาะกับผลกระทบของระบบได้
- วาง Log และ Metric ที่ช่วยย้อนตรวจโดยไม่เก็บข้อมูลส่วนบุคคลเกินจำเป็นได้
1. การประมวลผลคือสายงานที่เปลี่ยนสถานะของข้อมูล
คำว่า “ประมวลผล” หมายถึงการรับสิ่งหนึ่งเข้ามา ทำบางอย่างตามวัตถุประสงค์ แล้วส่งสิ่งที่เปลี่ยนแล้วให้ขั้นถัดไป การกระทำนั้นอาจง่ายเหมือนตรวจนามสกุลไฟล์ หรือซับซ้อนเหมือนให้โมเดลอ่านตัวอักษรจากภาพ จุดสำคัญคือทุกขั้นมีอินพุต เอาต์พุต เงื่อนไขสำเร็จ และเงื่อนไขล้มเหลวของตัวเอง
ในระบบอ่านใบเสร็จ ผู้ใช้ส่งภาพ JPEG แต่โมเดลอาจรับเมทริกซ์พิกเซลที่ถูกหมุน ตัดขอบ ลดสัญญาณรบกวน ปรับความสว่าง และย่อให้มีขนาดเฉพาะ หลังโมเดลอ่านตัวอักษร ระบบยังต้องหาเขตข้อมูลว่าเลขใดคือวันที่ เลขใดคือยอดรวม แปลงสกุลเงิน ตรวจสมการยอดย่อยกับภาษี และขอให้ผู้ใช้ยืนยันเมื่อความมั่นใจต่ำ
สายงานจึงเริ่มก่อนโมเดลและจบหลังโมเดล หากภาพถูกหมุนผิด 90 องศา โมเดลอาจเห็นข้อความด้านข้าง หากตัวตัดขอบตัดเลขตัวแรกออก โมเดลไม่มีทางเดาเลขที่หายอย่างน่าเชื่อถือ หากกฎหลังโมเดลเอาจุดทศนิยมออก คำตอบดิบจากโมเดลอาจถูกแต่ยอดสุดท้ายผิด การระบุชั้นทำให้การแก้ตรงสาเหตุ
ในโลกจริงยังมีงานส่งมอบและ Feedback ต่อท้าย เช่น บันทึกข้อมูลลงบัญชี แสดงหน้าจอให้แก้ เก็บสัญญาณว่าผู้ใช้แก้ช่องใด และติดตามว่าความผิดพลาดเพิ่มขึ้นหรือไม่ การวาดแผนภาพควรใส่แหล่งข้อมูลภายนอก Queue, Cache, Database และบริการอื่นที่เรียกใช้ เพราะคอขวดหรือความผิดพลาดอาจอยู่นอกโค้ด AI
แต่ละลูกศรในแผนภาพควรตอบได้ว่า “ส่งอะไร” ไม่ใช้คำกว้างอย่าง “ข้อมูล” อย่างเดียว ตัวอย่างเช่น จากตัวตรวจไฟล์ไปตัวปรับภาพส่งวัตถุที่มีรหัสงาน ภาพถอดรหัสแล้ว ความกว้าง ความสูง ทิศทาง และผลตรวจมัลแวร์ จากโมเดลไปตัวแยกเขตข้อมูลส่งข้อความ ตำแหน่ง และคะแนน ไม่ใช่ยอดรวมที่ตัดสินแล้ว
การตั้งชื่อสถานะช่วยลดความสับสน เช่น Raw Image, Validated Image, Normalized Image, OCR Tokens, Candidate Fields, Verified Receipt และ Posted Expense เมื่อทีมพูดว่า “ข้อมูลใบเสร็จ” ทุกคนจะรู้ว่าหมายถึงสถานะใด หากไม่มีชื่อเดียวกัน คนหนึ่งอาจตรวจภาพดิบ แต่อีกคนเชื่อว่ากำลังตรวจผลหลังโมเดล
หลักจำง่าย: ทุกครั้งที่ข้อมูลเปลี่ยนรูป ให้ถามว่าอะไรหายไป อะไรถูกเพิ่ม และย้อนกลับไปยังต้นฉบับได้หรือไม่
2. Data Contract: ข้อตกลงที่กันความผิดพลาดก่อนมันไหลต่อ
Data Contract คือข้อตกลงว่าอินพุตหรือเอาต์พุตต้องมีหน้าตาและความหมายอย่างไร สำหรับไฟล์ภาพ อาจกำหนดชนิด JPEG หรือ PNG ขนาดไม่เกินค่าหนึ่ง ความละเอียดขั้นต่ำ มีรหัสผู้ใช้ที่ผ่านการอนุญาต และต้องถอดรหัสได้ หากไม่ผ่าน ระบบต้องปฏิเสธอย่างอธิบายได้ ไม่ปล่อยค่าผิดเข้าโมเดลเงียบ ๆ
สัญญาไม่ใช่เพียงชนิดข้อมูล ต้องรวมความหมายหรือ Semantics ช่อง total_amount อาจเป็นเลขทศนิยมสกุลบาท ไม่รวมเครื่องหมายพัน และห้ามติดลบ ช่อง date ต้องระบุรูปแบบและเขตเวลา ช่อง confidence ต้องบอกว่าเป็นคะแนนชนิดใด ผ่าน Calibration หรือไม่ หากสองบริการตีความต่างกัน ระบบอาจทำงานได้แต่ให้ผลผิด
Schema Validation ตรวจว่าฟิลด์มีครบและชนิดถูก Range Validation ตรวจค่าที่สมเหตุสมผล Cross-field Validation ตรวจความสัมพันธ์ เช่น subtotal + tax – discount ควรใกล้ total การใช้หลายระดับช่วยจับความผิดต่างชนิด เลข 12,800 เป็นตัวเลขถูกชนิดและอยู่ในช่วง แต่ผิดเมื่อเทียบกับยอดรายการบนใบเสร็จ
เมื่อข้อมูลไม่ผ่านสัญญา ระบบมีทางเลือก Reject, Quarantine, Repair หรือ Ask for Confirmation การซ่อมอัตโนมัติสะดวกแต่เสี่ยงซ่อนข้อผิดพลาด เช่น เดาเขตเวลาหรือเติมเลขศูนย์ ควรซ่อมเฉพาะกรณีที่กฎชัด บันทึกว่าซ่อมอะไร และเก็บค่าก่อนซ่อมในขอบเขตที่จำเป็นต่อการตรวจสอบ
การเปลี่ยน Schema ต้องจัดเวอร์ชัน หากบริการใหม่เปลี่ยนชื่อ merchant เป็น vendor แต่ผู้ใช้ปลายทางยังอ่าน merchant ข้อมูลอาจหาย การเปลี่ยนแบบเพิ่มฟิลด์มักปลอดภัยกว่าเปลี่ยนความหมายฟิลด์เดิม แต่ก็ต้องทดสอบความเข้ากันได้ การเปิดใช้ควรมีช่วงที่รองรับสองเวอร์ชันและ Metric ว่าผู้ใช้เก่ายังเหลือเท่าไร
Data Contract ยังเกี่ยวกับสิทธิ์และความเป็นส่วนตัว ภาพใบเสร็จอาจมีชื่อ เลขท้ายบัตร ที่อยู่ หรือรายการสุขภาพ ระบบต้องกำหนดว่าใครอ่านภาพได้ เก็บนานเท่าไร ฟิลด์ใดส่งให้บริการภายนอก และลบอย่างไร สัญญาที่ดีจึงบอกทั้งโครงสร้างและข้อจำกัดการใช้ ไม่ใช่เพียง JSON Schema
| จุดส่งต่อ | สิ่งที่ต้องรับประกัน | เมื่อไม่ผ่าน |
|---|---|---|
| Upload → Validator | เจ้าของงานถูกต้อง ไฟล์อนุญาต ขนาดอยู่ในขอบเขต | ปฏิเสธพร้อมเหตุผล ไม่เรียกโมเดล |
| Validator → Preprocessor | ภาพถอดรหัสได้ มีทิศทางและมิติที่ทราบ | กักงานหรือขอภาพใหม่ |
| Preprocessor → Model | สี สเกล ขนาด และลำดับช่องตรงกับตอนฝึก | หยุดและแจ้งรุ่น Pipeline ที่ไม่เข้ากัน |
| Model → Field Extractor | ข้อความ ตำแหน่ง คะแนน และรุ่นโมเดลครบ | ใช้ Fallback หรือส่งตรวจ |
| Verifier → Ledger | ยอด สกุลเงิน วันที่ และสถานะยืนยันครบ | ไม่บันทึกรายจ่ายอัตโนมัติ |
3. Pre-processing: งานก่อนโมเดลกำหนดว่าโมเดลจะเห็นอะไร
ภาพจากโทรศัพท์มีความหลากหลาย ทั้งแนวตั้ง แนวนอน เงามือ แสงสะท้อน พื้นหลังรก และใบเสร็จเอียง ขั้น Pre-processing พยายามทำให้ภาพอยู่ในรูปที่โมเดลคาดหวัง เช่น อ่าน Orientation หมุนภาพ ตรวจขอบ ตัดพื้นที่ใบเสร็จ ปรับ Perspective และ Normalize ค่าพิกเซล การเลือกแต่ละขั้นต้องอิงการทดสอบ ไม่ใช่ยิ่งแต่งภาพมากยิ่งดี
การย่อภาพช่วยลดเวลาและหน่วยความจำ แต่ทำให้ตัวอักษรเล็กหาย หากย่อก่อนตัดขอบ พื้นโต๊ะอาจใช้พิกเซลส่วนใหญ่จนข้อความเหลือน้อย หากเพิ่ม Contrast แรงเกินไป จุดทศนิยมอาจหายหรือเลข 8 กลายเป็น 3 Pipeline ควรเก็บภาพตัวอย่างก่อนและหลังเพื่อทดสอบแบบ Offline โดยปกป้องข้อมูลจริง
Training–Serving Skew เกิดเมื่อการเตรียมข้อมูลตอนใช้งานจริงไม่เหมือนตอนฝึก เช่น ตอนฝึกใช้ภาพ RGB ขนาดหนึ่งและ Normalize ด้วยสูตรหนึ่ง แต่บริการใหม่ส่ง BGR หรือใช้ค่าเฉลี่ยคนละชุด โมเดลยังคืนผลได้จึงอันตรายกว่าข้อผิดพลาดที่ระบบล้มทันที วิธีลดคือใช้โค้ดแปลงร่วมกัน ล็อกเวอร์ชัน และมี Golden Test ที่เทียบค่า Intermediate Output
Golden Test ใช้ตัวอย่างที่อนุมัติแล้วและผลลัพธ์ที่คาดหวังในแต่ละขั้น ไม่ตรวจเฉพาะยอดสุดท้าย สำหรับใบเสร็จตัวอย่าง เราอาจเก็บ Hash ของภาพหลังหมุน พิกัดกรอบ ขนาดหลังย่อ โทเคนหลัก และยอดรวม เมื่อเปลี่ยนไลบรารีหรือฮาร์ดแวร์ หากค่าระหว่างทางเปลี่ยน ทีมเห็นจุดเริ่มของความต่างได้ทันที
ข้อมูลสูญหายบางอย่างย้อนกลับไม่ได้ การตัดภาพผิดทำให้ส่วนที่หายไม่อยู่ในขั้นต่อไป การแปลงเป็นขาวดำทำให้สัญญาณสีหาย การบีบอัดซ้ำสร้าง Artifact จึงควรเก็บต้นฉบับชั่วคราวตามนโยบายที่ชัด และส่ง Metadata ว่าผ่านการแปลงใด ไม่ควรเขียนทับต้นฉบับแล้วหวังว่าจะตรวจย้อนหลังได้
การจัดการค่าหายต้องแยก “ไม่มีจริง” จาก “อ่านไม่ได้” หากใบเสร็จไม่มีภาษี ช่อง tax อาจเป็นศูนย์ แต่ถ้าโมเดลหาไม่พบ ค่าควรเป็น Unknown พร้อมเหตุผล การเติมศูนย์ทุกกรณีทำให้ระบบดูครบแต่ซ่อนความไม่แน่นอน กฎธุรกิจอาจบันทึกยอดผิดโดยไม่รู้ว่าข้อมูลขาด
Pre-processing อาจรวมการแบ่งหน้า การแยกตาราง และการสร้าง Context จากข้อมูลร้าน ขั้นเหล่านี้เพิ่มคุณภาพแต่เพิ่ม Dependency ถ้าบริการค้นหาร้านล่ม ระบบจะทำอย่างไร หากใช้ชื่อร้านจากฐานข้อมูลเก่าแทนข้อความบนภาพ ต้องระบุแหล่งที่มาของแต่ละฟิลด์ เพื่อให้ผู้ใช้รู้ว่าแก้ตรงไหนและทีมตรวจได้ว่าใครเปลี่ยนค่า
4. Orchestration: ใครเรียกใคร และงานเดินต่อเมื่อไร
Orchestration คือการจัดลำดับและเงื่อนไขของงาน ระบบอาจทำงานแบบ Synchronous ที่ผู้ใช้รอผลในคำขอเดียว หรือ Asynchronous ที่รับงานแล้วส่งผ่าน Queue ก่อนแจ้งผลภายหลัง แบบแรกเข้าใจง่ายและตอบเร็วเมื่อทุกขั้นสั้น แต่เสี่ยง Timeout หากโมเดลช้า แบบหลังรองรับงานหนักและ Retry ได้ดี แต่ต้องจัดการสถานะและงานซ้ำ
ระบบอ่านใบเสร็จอาจตอบทันทีว่า “รับภาพแล้ว” พร้อม Job ID จากนั้น Worker ตรวจไฟล์ เตรียมภาพ เรียกโมเดล และบันทึกผล ผู้ใช้ถามสถานะด้วย Job ID หรือได้รับ Notification การออกแบบต้องระบุสถานะ เช่น received, validating, processing, needs_review, completed และ failed ไม่ใช้คำว่า processing ตั้งแต่ต้นจนจบจนไม่รู้ว่าค้างตรงไหน
Queue ช่วยกันภาระพุ่งและแยกผู้รับงาน แต่ไม่รับประกันว่างานถูกประมวลผลครั้งเดียวเสมอ ข้อความอาจถูกส่งซ้ำเมื่อ Worker ทำเสร็จแต่ยืนยันไม่ทัน หากการบันทึกรายจ่ายไม่เป็น Idempotent ใบเสร็จเดียวอาจถูกลงบัญชีสองครั้ง ระบบจึงต้องมี Idempotency Key เช่น Hash ของผู้ใช้กับรหัสงาน และตรวจผลเดิมก่อนสร้างรายการใหม่
ขั้นบางอย่างทำขนานได้ เช่น ตรวจมัลแวร์กับอ่าน Metadata แต่ขั้นที่พึ่งผลต้องรอ การทำขนานลดเวลาแต่เพิ่มความซับซ้อน หากผลหนึ่งล้มเหลวต้องยกเลิกอีกผลหรือใช้ต่อได้ การเขียน Dependency Graph และ Critical Path ช่วยเห็นว่างานใดเป็นคอขวดจริง ไม่เร่งทุกส่วนโดยไม่มีเหตุผล
Batch Processing เหมาะกับใบเสร็จจำนวนมากที่ไม่ต้องตอบทันที ใช้ทรัพยากรคุ้มและทำซ้ำได้ง่ายกว่า Online Processing เหมาะเมื่อผู้ใช้ต้องตรวจในขณะถ่ายภาพ แต่ต้องคุม Latency และความพร้อมใช้งาน ระบบเดียวอาจใช้ Online สำหรับ Preview และ Batch สำหรับตรวจคุณภาพซ้ำตอนกลางคืน ต้องระบุว่าผลใดเป็นชั่วคราวและผลใดเป็นทางการ
Cache ลดการเรียกซ้ำ แต่ Key และอายุข้อมูลต้องถูกต้อง หาก Cache อ้างเพียง Hash ภาพโดยไม่รวมรุ่น Preprocessor กับโมเดล ระบบอาจคืนผลเก่าหลังอัปเกรด หากภาพเหมือนกันแต่ผู้ใช้ต่างกัน การใช้ Cache ร่วมอาจรั่วข้อมูล ควรรวมขอบเขตผู้ใช้ รุ่น และการตั้งค่าที่เปลี่ยนผล พร้อมนโยบายลบ
Workflow ควรมีเส้นทาง Happy Path และเส้นทางผิดพลาดอย่างชัดเจน เช่น ภาพเบลอให้ขอถ่ายใหม่ โมเดลไม่พร้อมให้เข้าคิวหรือใช้บริการสำรอง คะแนนต่ำให้ผู้ใช้ตรวจ และกฎยอดรวมไม่ผ่านให้หยุดก่อนลงบัญชี การมีลูกศรสีแดงในแผนภาพสำคัญพอ ๆ กับลูกศรสีเขียว เพราะระบบจริงใช้เวลามากกับข้อยกเว้น
5. ช่วงเรียกโมเดล: ตรึงรุ่น อินพุต และการตั้งค่า
เมื่อภาพพร้อม ระบบต้องเลือก Endpoint, Model Version และ Runtime โมเดล OCR อาจคืนข้อความพร้อมกรอบตำแหน่ง โมเดลแยกเขตข้อมูลอาจคืน Candidate ของชื่อร้าน วันที่ ยอดย่อย ภาษี และยอดรวม การบันทึกเพียงชื่อโมเดลไม่พอ ต้องรู้เวอร์ชัน Tokenizer, Preprocessor, Library และ Configuration ที่มีผลต่อคำตอบ
ค่าการทำงานแตกต่างตามโมเดล เช่น ขนาดอินพุต จำนวนหน้าสูงสุด Beam Size หรือระดับการสุ่ม สำหรับงานอ่านยอดเงิน เรามักต้องการผลเสถียรและทำซ้ำได้ จึงควรลดความสุ่มและตรึง Seed เมื่อทำได้ โมเดล Generative ที่ใช้แปลงข้อความเป็น JSON ควรมี Schema Validation หลังผล ไม่เชื่อรูปแบบเพียงเพราะข้อความดูสมเหตุสมผล
Decision Threshold ที่เปลี่ยนคะแนนเป็นการยอมรับหรือส่งตรวจควรอยู่ในชั้นนโยบายหลังโมเดล แม้บาง API รับ Threshold เป็นพารามิเตอร์เพื่อกรอง Candidate ทีมต้องแยก Threshold ภายในเพื่อประหยัดผลออกจาก Threshold ธุรกิจที่สร้างการกระทำ มิฉะนั้นเปลี่ยนค่าหนึ่งแล้วไม่มีใครรู้ว่าพฤติกรรมใดเปลี่ยน
Latency ควรแยกเวลารอ Queue, ดาวน์โหลดโมเดล, เตรียม Batch, คำนวณ และส่งผล ค่าเฉลี่ยอย่างเดียวซ่อนหางยาว ควรดู Percentile เช่น p95 หรือ p99 ตามความต้องการผู้ใช้ ถ้าโมเดลตอบเร็วแต่เวลารอ Queue สูง การเพิ่ม GPU อาจไม่ช่วย หากงานช้าที่สุดมาจากภาพใหญ่ ระบบควรแก้ Validation หรือ Resize
Resource Limit ป้องกันงานหนึ่งใช้หน่วยความจำทั้งหมด กำหนดขนาดภาพ จำนวนหน้า เวลา และ Concurrent Request พร้อมพฤติกรรมเมื่อเกิน การตัดงานโดยไม่มีผลสถานะทำให้ผู้ใช้รอไม่จบ การตอบข้อผิดพลาดควรแยก Retryable เช่นบริการชั่วคราวล่ม จาก Non-retryable เช่นไฟล์เสีย เพื่อไม่วน Retry งานที่ไม่มีวันสำเร็จ
โมเดลอาจคืนผลที่อยู่ Out of Distribution แต่ยังมีคะแนนสูง ตัวอย่างเช่น รูปเมนูอาหารหรือเอกสารอื่นถูกส่งเข้า OCR ใบเสร็จ ระบบควรมี Document Type Check หรือ Unknown Path ไม่บังคับแปลงทุกภาพเป็นใบเสร็จ ความสามารถในการ “ไม่รู้” ลดความเสียหายมากกว่าการให้คำตอบทุกครั้ง
การทดสอบช่วง Inference ต้องใช้ Artifact ที่ Deploy จริง ไม่ใช่ Notebook ต้นฉบับ การ Quantization, Conversion, Accelerator และ Serving Library อาจเปลี่ยนผลเล็กน้อยซึ่งกระทบตัวเลขใกล้ Threshold ควรเปรียบเทียบ Output Distribution และกรณีสำคัญก่อนเปิดใช้ พร้อมเกณฑ์ความต่างที่ยอมรับได้
6. Post-processing: จากผลดิบสู่ข้อมูลที่ใช้ตัดสินใจ
โมเดล OCR อาจคืนรายการข้อความกับพิกัด เช่น “1,280.00” ที่มุมล่างขวา แต่ระบบยังไม่รู้ว่าคือยอดรวม ต้องใช้ตำแหน่ง คำใกล้เคียง และ Candidate อื่นเพื่อแยกเขตข้อมูล ขั้นนี้อาจเป็นกฎ โมเดลอีกตัว หรือทั้งสองอย่าง จึงควรระบุว่าแต่ละฟิลด์มาจากแหล่งใดและผ่านการแก้ไขอะไร
การ Normalize ตัวเลขต้องระวังรูปแบบท้องถิ่น เครื่องหมายจุลภาคอาจเป็นตัวแบ่งหลักพันหรือทศนิยม สัญลักษณ์สกุลเงินอาจอยู่หน้า หรือหลัง จุดที่จางอาจหาย การแปลง String เป็น Decimal ควรใช้ Locale ที่ระบุ ไม่ใช้ Floating Point สำหรับเงินโดยไม่เข้าใจการปัดเศษ และไม่ลบเครื่องหมายทุกตัวด้วยกฎกว้าง
Cross-field Check ช่วยจับความผิดที่แต่ละฟิลด์ดูถูก เช่น ผลรวมรายการ 1,000 ภาษี 70 และค่าบริการ 100 ไม่สอดคล้องกับยอด 12,800 ระบบไม่ควรเดาว่ายอดใดถูก แต่ควรลดความมั่นใจ ขอให้ผู้ใช้ตรวจ หรือส่งงานไป Review Queue การสร้างกฎต้องดูใบเสร็จหลายรูปแบบ เพราะบางร้านรวมภาษีแล้วหรือมีส่วนลดหลายชั้น
คะแนนโมเดลเป็นหลักฐานชิ้นหนึ่ง ไม่ใช่คำสั่งให้ลงบัญชี หากยอดมีผลทางการเงิน Threshold ควรผูกกับความเสี่ยง เช่น ยอดต่ำและสมการผ่านอาจเสนอให้ยืนยันครั้งเดียว ส่วนยอดสูง สมการไม่ผ่าน หรือร้านใหม่ให้ตรวจทุกฟิลด์ Human Review ต้องมีภาพต้นฉบับ พื้นที่ที่โมเดลอ่าน และเหตุผลที่ถูกส่งตรวจ ไม่ใช่มีเพียงตัวเลขให้กดยอมรับ
การจัดรูปแบบเพื่อแสดงผลเป็นอีกชั้น วันเดียวกันอาจแสดง 06/08/2026 หรือ 6 สิงหาคม 2569 แต่ข้อมูลภายในควรใช้รูปแบบมาตรฐานและเก็บเขตเวลา การแสดงเงินบาทไม่ควรเปลี่ยนค่าจริง การคัดลอกข้อความเพื่อ UI ต้อง Escape เพื่อป้องกันเนื้อหาอันตรายจากเอกสารที่ถูกสร้างมาโจมตีระบบ
การแก้ของผู้ใช้ควรเก็บเป็น Event แยกจากการเขียนทับผลโมเดล เช่น model_total=12800, verified_total=1280, correction_reason=decimal_missed วิธีนี้ช่วยประเมินและปรับปรุง แต่ต้องจำกัดสิทธิ์และอายุข้อมูล ไม่ควรนำ Feedback ไปฝึกทันทีโดยไม่มีการตรวจ เพราะผู้ใช้ผิดได้และผู้โจมตีอาจป้อนค่าหลอก
Post-processing ต้องมีเวอร์ชันเหมือนโมเดล การเปลี่ยน Regex, Locale, Threshold หรือกฎยอดรวมเปลี่ยนพฤติกรรมระบบ แม้ไฟล์โมเดลเดิม การ Release ควรรวม Pipeline Version ที่ชี้ทุกองค์ประกอบ ไม่ใช้ประโยคว่า “ไม่ได้เปลี่ยน AI” เป็นเหตุผลข้ามการทดสอบ
7. Reliability: ออกแบบให้ล้มแล้วหยุดอย่างปลอดภัยและกลับมาได้
ระบบภายนอกล่มเป็นเรื่องปกติ คำถามคือระบบตอบอย่างไร Timeout ป้องกันการรอไม่สิ้นสุด แต่ค่าที่สั้นเกินไปทำให้งานปกติล้ม Retry ช่วยเหตุชั่วคราว แต่การลองถี่พร้อมกันทำให้บริการที่ล่มหนักขึ้น จึงใช้ Exponential Backoff, Jitter และจำนวนครั้งสูงสุด พร้อมแยกข้อผิดพลาดที่ควรลองใหม่
Retry ต้องจับคู่กับ Idempotency หาก Worker เรียกโมเดลซ้ำอาจเสียค่าใช้จ่ายแต่ไม่สร้างผลซ้ำที่อันตราย ทว่าถ้า Retry ขั้นลงบัญชี อาจสร้างรายการสองรายการ ทุก Side Effect ควรมีรหัสคำขอและข้อกำหนดว่าการเรียกซ้ำให้คืนผลเดิมหรือไม่ทำซ้ำ การทดสอบควรจำลองการขาดการเชื่อมต่อหลังบันทึกแต่ก่อนตอบกลับ
Fallback อาจเป็นโมเดลรุ่นก่อน บริการสำรอง กฎง่าย หรือการส่งให้มนุษย์ การมี Fallback ไม่ได้แปลว่าคุณภาพเท่ากัน ต้องบอกผู้ใช้หรือระบบปลายทางว่างานอยู่โหมดใด ตัวอย่างเช่น เมื่อ OCR หลักล่ม แอปอาจให้ผู้ใช้กรอกยอดเองแทนการใช้โมเดลคุณภาพต่ำแบบเงียบ ๆ
Circuit Breaker หยุดเรียกบริการที่ล้มซ้ำ ๆ ชั่วคราว ลดการกระจายปัญหา Bulkhead แยกทรัพยากรเพื่อให้งานประเภทหนึ่งไม่กินทั้งหมด เช่น ใบเสร็จหลายหน้าจำนวนมากไม่ควรทำให้ภาพปกติรอ ระบบต้องมี Queue Limit และ Backpressure เมื่อรับงานเร็วเกินกำลัง ไม่รับไม่จำกัดแล้วปล่อยให้ล่าช้าหลายชั่วโมงโดยไม่แจ้ง
Rollback คือการกลับไปชุดรุ่นที่รู้ว่าปลอดภัย ต้องรวมโมเดล Preprocessor Post-processor Schema และ Configuration ที่เข้ากัน หากถอยเฉพาะโมเดลแต่ใช้ Tokenizer ใหม่ ปัญหาอาจแย่กว่าเดิม การ Deploy แบบ Canary ให้ผู้ใช้ส่วนน้อยและกำหนด Metric หยุด ช่วยเห็นปัญหาก่อนขยาย
Disaster Recovery พิจารณาว่าถ้าฐานข้อมูล Queue หรือ Storage เสีย จะเสียงานเท่าไรและกลับภายในเวลาใด Backup ต้องทดสอบ Restore ไม่ใช่เพียงเห็นไฟล์สำรอง งานที่อยู่ระหว่างทางต้องตรวจได้ว่าเสร็จ ค้าง หรือต้องทำซ้ำ โดยไม่สร้างรายการบัญชีซ้ำ
ความทนทานไม่ใช่การทำให้ทุกอย่างไม่เคยล้ม แต่คือจำกัดผลกระทบ รักษาความถูกต้อง และสื่อสารสถานะได้ ระบบอ่านใบเสร็จที่บอกว่า “ยังประมวลผลไม่ได้ กรุณาตรวจยอดเอง” อาจน่าเชื่อถือกว่าระบบที่คืนยอดผิดอย่างรวดเร็วและมั่นใจ
8. Observability: เห็นสิ่งที่เกิดโดยไม่เฝ้าดูข้อมูลเกินจำเป็น
Observability คือความสามารถในการอนุมานสภาพภายในจากสัญญาณที่ระบบปล่อยออกมา สามเสาหลักที่มักใช้คือ Logs, Metrics และ Traces Logs บอกเหตุการณ์ Metrics บอกแนวโน้มเชิงจำนวน และ Trace เชื่อมเวลาของคำขอผ่านหลายบริการ ระบบ AI ยังต้องมีสัญญาณคุณภาพและข้อมูล เช่น อัตราภาพอ่านไม่ได้ การกระจายคะแนน และอัตราที่ผู้ใช้แก้ยอด
ทุกงานควรมี Correlation ID ที่ไม่เปิดเผยตัวตนเกินจำเป็น ทำให้ตามจาก Upload ผ่าน Queue, Preprocessor, Model และ Ledger ได้ บันทึก Pipeline Version, Model Version, Schema Version, เวลาแต่ละขั้น สถานะ และรหัสข้อผิดพลาด ไม่ควรบันทึกภาพใบเสร็จเต็มหรือข้อความทั้งหมดใน Log ทั่วไปเพียงเพื่อความสะดวก
Metric ด้านระบบรวม Request Rate, Error Rate, Latency, Queue Depth, Retry และ Resource Use Metric ด้านข้อมูลรวมขนาดภาพ ภาษา มุมเอียง และสัดส่วนฟิลด์หาย Metric ด้านคุณภาพรวม Correction Rate, Review Rate และความสอดคล้องของยอด การดูเพียง Uptime อาจสรุปว่าระบบดีทั้งที่อ่านยอดผิดเพิ่มขึ้น
ค่าเฉลี่ยซ่อนกลุ่มย่อย ควรแยกตามประเภทอุปกรณ์ ภาษา รูปแบบใบเสร็จ และเวอร์ชัน แต่การติด Label มากเกินไปทำให้ระบบ Metric แพงและอาจรั่วข้อมูล อย่าใช้ User ID หรือชื่อร้านทุกแห่งเป็น Label ค่าที่มีจำนวนไม่จำกัดควรอยู่ใน Log ที่ควบคุมสิทธิ์หรือถูกสรุปเป็นกลุ่ม
Alert ต้องนำไปสู่การกระทำได้ เช่น Correction Rate ของยอดเพิ่มเกิน Baseline หลัง Release ใหม่ และมีจำนวนตัวอย่างเพียงพอ ผู้รับผิดชอบต้องรู้ว่าจะตรวจ Dashboard ใด หยุด Release หรือ Rollback เมื่อไร Alert ที่ดังทุกวันจนคนปิดเสียงไม่ช่วยความน่าเชื่อถือ ควรทบทวน False Alarm และ Missed Incident
ความเป็นส่วนตัวใช้หลัก Data Minimization เก็บเท่าที่จำเป็น แยกข้อมูลระบุตัวตน จำกัดสิทธิ์ เข้ารหัส และกำหนดการลบ หากต้องเก็บตัวอย่างสำหรับแก้บั๊ก ควรมีเหตุผล การอนุมัติ การปกปิด และพื้นที่ควบคุม ไม่คัดลอกไป Chat หรือ Ticket โดยไม่จำเป็น ผู้ใช้ควรรู้ว่าข้อมูลถูกใช้เพื่อให้บริการหรือปรับปรุงโมเดลต่างกันอย่างไร
Trace ที่ดีทำให้ตอบคำถามกรณี 12,800 บาทได้ว่าไฟล์ผ่าน Validator รุ่นใด ภาพถูกหมุนและตัดอย่างไร โมเดลคืน Token อะไร กฎ Locale เปลี่ยนค่าอย่างไร และผู้ใช้แก้อะไร โดยไม่จำเป็นต้องเปิดเผยใบเสร็จของผู้ใช้ทุกคน การออกแบบหลักฐานตั้งแต่ต้นดีกว่าเพิ่ม Logging มากเกินไปหลังเกิดเหตุ
9. เมื่อข้อมูลหรือระบบเปลี่ยน: คุณภาพอาจลดแม้โค้ดไม่ล้ม
Data Drift คือการกระจายอินพุตเปลี่ยน เช่น ผู้ใช้ถ่ายใบเสร็จผ่านแอปกล้องรุ่นใหม่ที่บีบอัดแรงขึ้น หรือร้านเริ่มใช้กระดาษสีเข้ม Concept Drift คือความสัมพันธ์ระหว่างรูปแบบกับคำตอบเปลี่ยน เช่น รูปแบบใบเสร็จใหม่ย้ายยอดรวมไปตำแหน่งที่เคยเป็นยอดย่อย ระบบอาจยังทำงานและไม่มี Error แต่คุณภาพลด
Dependency Drift เกิดเมื่อไลบรารี Decoder, OCR Runtime หรือบริการภายนอกเปลี่ยน Version การอัปเดต Security Patch อาจเปลี่ยนการจัดการ Orientation การเปลี่ยน Font Rendering อาจกระทบข้อมูลสังเคราะห์ จึงต้องล็อกเวอร์ชัน ทดสอบก่อนอัปเกรด และบันทึก Software Bill of Materials ตามความเหมาะสม
Configuration Drift คือค่าระหว่างสภาพแวดล้อมต่างกัน เช่น Test ใช้ Locale ไทยแต่ Production ใช้ค่าปริยายอังกฤษ หรือเครื่องหนึ่งมี Threshold 0.8 อีกเครื่อง 0.7 Configuration ควรอยู่ภายใต้ Version Control มี Schema และ Review ไม่แก้ค่าบน Server แบบไม่ทิ้งร่องรอย
การตรวจ Drift ต้องเชื่อมกับผลกระทบ ความแตกต่างของขนาดภาพอาจไม่เปลี่ยนคุณภาพเพราะ Preprocessor รองรับ แต่ Correction Rate ที่เพิ่มควรเร่งตรวจ การแจ้งเตือน Drift ทุกค่าโดยไม่รู้ความหมายสร้างภาระ ควรเลือก Feature ที่สัมพันธ์กับความเสี่ยงและมีขั้นตอนตรวจคุณภาพเมื่อสัญญาณเปลี่ยน
ผู้โจมตีอาจใช้ไฟล์ผิดรูปแบบ ภาพขนาดมหาศาล ข้อความซ่อน หรือ Prompt Injection ในเอกสารหากระบบส่ง OCR เข้าโมเดลภาษา Validation, Sandbox, Resource Limit และการแยกคำสั่งระบบจากเนื้อหาเอกสารช่วยลดความเสี่ยง แต่ไม่มีชั้นเดียวป้องกันทั้งหมด ต้องมี Monitoring และ Incident Response
เมื่อคุณภาพลด อย่ารีบฝึกโมเดลใหม่เสมอ หากสาเหตุคือ Locale ผิดให้แก้ Post-processing หาก Decoder เปลี่ยนให้แก้ Pipeline หากรูปแบบร้านใหม่จริงอาจต้องเพิ่มข้อมูลและประเมินโมเดล การหาสาเหตุก่อนเลือกวิธีลดการเปลี่ยนหลายอย่างพร้อมกันจนไม่รู้ว่าอะไรช่วยหรือทำร้าย
10. กรณีศึกษา: แกะยอด 1,280 ที่กลายเป็น 12,800
เริ่มจากยืนยันอาการ เก็บ Job ID เวลา ผู้ใช้ที่ได้รับผล รุ่น Pipeline และยอดที่คาดหวังโดยจำกัดการเข้าถึงภาพ จากนั้นทำซ้ำในสภาพแวดล้อมใกล้เหตุการณ์ หากทำซ้ำไม่ได้ ให้ตรวจว่าไฟล์ต้นฉบับยังเหมือนเดิมหรือถูกแอปบีบอัดก่อน Upload และตรวจว่าบริการใดเปลี่ยนหลังเหตุการณ์
ดูผล Validator: ไฟล์ชนิดถูก ขนาดปกติ และ Orientation อ่านได้ ต่อไปดูภาพหลัง Pre-processing พบว่าการเพิ่ม Contrast ทำให้จุดทศนิยมบางลงแต่ยังมองเห็น ดู OCR Tokens พบโมเดลคืน “1,280.00” ถูกต้องพร้อมคะแนนสูง แสดงว่าโมเดลไม่ใช่จุดที่สร้างเลข 12,800
ดู Field Extractor พบข้อความ total_candidate ถูกต้อง แต่ Post-processor รุ่นใหม่ลบเครื่องหมายทั้งหมดแล้วหารด้วยจำนวนตำแหน่งทศนิยมไม่สอดคล้องกับ Locale ในเส้นทางหนึ่ง จึงเปลี่ยน “1,280.00” เป็น 128000 แล้วขั้นแสดงผลตีความเป็น 12,800 สาเหตุอยู่ที่กฎแปลงตัวเลขและการทดสอบรูปแบบ ไม่ใช่ OCR
การแก้ระยะสั้นคือ Rollback Post-processor ไปเวอร์ชันก่อน ตรวจงานที่ผ่านรุ่นผิด และแจ้งผู้ใช้ที่ได้รับผลกระทบตามความเหมาะสม การแก้ถาวรคือใช้ Decimal Parser ที่กำหนด Locale เพิ่ม Golden Cases สำหรับ 1,280.00, 1.280,00 และรูปแบบไม่มีทศนิยม พร้อม Cross-field Check กับยอดรายการ
จากนั้นวัด Correction Rate และ Error Code หลัง Deploy แบบ Canary หากค่าไม่กลับสู่ Baseline ให้หยุดขยาย ทีมควรเขียน Incident Note ที่แยก Timeline, Impact, Root Cause, Contributing Factors และ Action Items ไม่สรุปว่า “ความผิดพลาดของมนุษย์” เพราะเป้าหมายคือปรับระบบให้ความผิดหนึ่งไม่ไหลถึงผู้ใช้ได้ง่าย
กรณีนี้แสดงว่าคำตอบดิบจากโมเดลอาจถูกแต่ระบบสุดท้ายผิด หากทีมเก็บเฉพาะยอดปลายทางโดยไม่มี Intermediate Output จะเสียเวลาฝึก OCR ใหม่และอาจสร้าง Regression การเก็บหลักฐานพอดีช่วยลดทั้งเวลาสอบสวนและการเข้าถึงข้อมูลส่วนตัวเกินจำเป็น
ลำดับไล่ตรวจที่นำไปใช้ซ้ำได้
- ยืนยันผลกระทบและสร้างตัวอย่างที่ทำซ้ำได้
- ตรึงรุ่น Code, Config, Data Contract, Model และ Dependency
- ไล่จาก Output ย้อนหา Intermediate Output ทีละชั้น
- เปรียบเทียบกับ Golden Case และรุ่นก่อนด้วยเงื่อนไขเดียวกัน
- แก้จุดต้นเหตุ พร้อม Fallback และ Rollback
- เพิ่ม Regression Test และ Metric ป้องกันการกลับมา
- ทบทวนความเป็นส่วนตัวของหลักฐานหลังเหตุการณ์จบ
11. ลงมือวิเคราะห์: วาดสายงานและตรวจคำตอบตนเอง
โจทย์
ระบบรับภาพใบเสร็จ PNG ขนาด 8,000 × 6,000 พิกเซล ตรวจชนิดไฟล์ผ่าน จากนั้นย่อเป็น 1,024 พิกเซลก่อนตัดขอบ โมเดล OCR คืนยอด “280.00” เพราะเลข 1 อยู่ในพื้นที่ที่ถูกตัด กฎหลังโมเดลเห็นว่ายอดรวมไม่ตรงกับรายการ แต่ระบบยังบันทึกอัตโนมัติเนื่องจากคะแนน OCR สูง
- ระบุความผิดพลาดอย่างน้อยสามชั้น
- เขียน Data Contract ก่อนเข้า Preprocessor สองข้อ
- กำหนด Intermediate Output ที่ต้องเก็บเพื่อทำซ้ำ
- เสนอ Fallback เมื่อ Cross-field Check ไม่ผ่าน
- ออกแบบ Regression Test หนึ่งกรณีและ Metric หนึ่งค่า
เปิดดูแนวคำตอบและเกณฑ์ตรวจตนเอง
ชั้น Pre-processing ผิดลำดับเพราะย่อก่อนตัดขอบจนข้อมูลสำคัญหาย ชั้น Model รับภาพที่ขาดจึงไม่มีทางอ่านเลข 1 ชั้น Post-processing ใช้คะแนน OCR เป็นเงื่อนไขเดียวและละเลยกฎยอดรวม Data Contract อาจกำหนดความละเอียดตัวอักษรขั้นต่ำหลัง Resize และบังคับให้ตรวจกรอบใบเสร็จก่อนย่อ
Intermediate Output ควรมีภาพหลังอ่าน Orientation พิกัดกรอบ ภาพหลัง Crop และ Resize OCR Tokens พร้อมกรอบและคะแนน รวมถึงผล Cross-field Check โดยเก็บตามนโยบายความเป็นส่วนตัว Fallback คือส่งให้ผู้ใช้ยืนยันหรือ Review Queue ไม่บันทึกอัตโนมัติ Regression Test ใช้ภาพขอบชิดที่รู้ยอด 1,280 และ Metric คืออัตรา Cross-field Failure หรือ Correction Rate แยกตาม Pipeline Version
ผ่านเมื่อ: คุณไม่โทษโมเดลเพียงจุดเดียว ระบุว่าข้อมูลหายก่อนโมเดล และออกแบบด่านหลังโมเดลที่หยุดผลผิดก่อนลงบัญชีได้
นำไปใช้กับระบบของคุณ
เลือกหนึ่งระบบ AI แล้วเขียนตารางสี่คอลัมน์: ขั้น, อินพุต, เอาต์พุต, เมื่อผิดทำอย่างไร จากนั้นวงสามจุดที่ต้องมี Version วงสองจุดที่ต้องมี Test และขีดเส้นใต้หนึ่งจุดที่มีข้อมูลอ่อนไหว หากแผนภาพไม่มีทางออกเมื่อบริการล่ม ให้เพิ่ม Retry, Fallback หรือ Manual Path ก่อนถือว่าสายงานสมบูรณ์
12. แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่ดีที่สุดให้ครบทุกข้อ แล้วกด “ตรวจคำตอบ” ระบบจะแสดง Feedback รายข้อ คะแนน และจำนวนข้อที่ยังไม่ตอบ
13. สรุปภาพใหญ่: ทุกชั้นต้องมีสัญญา หลักฐาน และทางออก
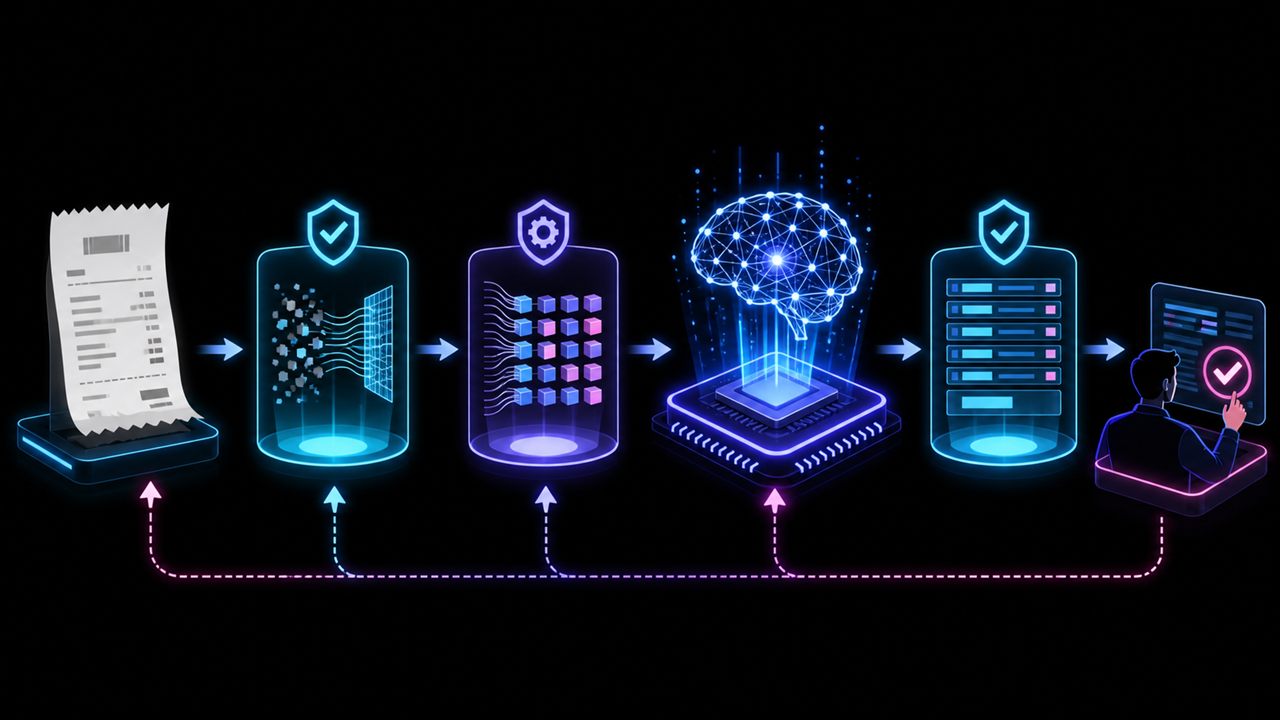
อ่านภาพจากซ้ายไปขวาเป็นสายงานหลักของระบบ ส่วนเส้นประด้านล่างแสดงทางย้อนกลับเมื่อผลลัพธ์ผิดหรือจำเป็นต้องทบทวนหลักฐานของแต่ละช่วง
- เอกสารดิบ: รับข้อมูลต้นทางเข้าสู่ระบบ
- ตรวจและแปลง: ตรวจความถูกต้อง จัดรูปแบบ และเตรียมข้อมูลให้พร้อม
- โมเดล: ประมวลผลข้อมูลและส่งผลลัพธ์กลับมาให้ระบบตรวจต่อ
- ผลลัพธ์และมนุษย์: ตรวจความสมเหตุผล ยืนยัน และตัดสินใจก่อนนำไปใช้
การประมวลผลในระบบ AI คือสายงานที่เปลี่ยนสถานะข้อมูลหลายครั้ง โมเดลเป็นเพียงช่วงหนึ่ง ก่อนโมเดลมีการรับ ตรวจ แปลง และประกอบบริบท หลังโมเดลมีการแปลคะแนน ตรวจความสมเหตุผล ใช้นโยบาย ขอให้มนุษย์ยืนยัน และส่งผลไปยังระบบจริง ทุกขั้นสามารถทำให้ข้อมูลหาย เปลี่ยนความหมาย หรือล้มได้
ระบบที่น่าเชื่อถือจึงต้องมี Data Contract, Version, Golden Test, Intermediate Output, Timeout, Retry, Idempotency, Fallback, Monitoring และ Rollback ที่สัมพันธ์กับผลกระทบ พร้อมหลักฐานที่พอสำหรับย้อนตรวจแต่ไม่ละเมิดความเป็นส่วนตัว เมื่อเข้าใจแผนที่นี้ เราจะไม่ใช้คำว่า “AI ผิด” เป็นปลายทางของการสอบสวน แต่ถามต่อได้ว่าผิดตรงชั้นใดและป้องกันอย่างไร
Insight Gate: หากคุณวาดสายงานหนึ่งระบบ ระบุอินพุตกับเอาต์พุตของทุกขั้น ชี้จุดที่ข้อมูลอาจสูญหาย แยกผลดิบจากโมเดลออกจากการกระทำ และออกแบบทางหยุดหรือย้อนกลับได้ คุณเข้าใจบทบาทของการประมวลผลในระบบ AI แล้ว
เรียนต่ออย่างเป็นระบบ: ทบทวนบทบาทของข้อมูลและโมเดล แล้วใช้แบบฝึกวาดสายงานเพื่อวิเคราะห์ระบบของคุณ
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงหลัก
- Google Machine Learning Crash Course — Production ML Systems
- Google for Developers — Testing and Debugging in Machine Learning
- TensorFlow Data Validation — Get Started
- Sculley et al. — Hidden Technical Debt in Machine Learning Systems
- NIST — Artificial Intelligence Risk Management Framework 1.0
- NIST AI RMF Playbook
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 6 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 17 · PATH 01 · เนื้อหาเพื่อการศึกษา
