เช้าวันหนึ่งคุณเปิดกล่องอีเมล แล้วพบว่าอีเมลแจ้งส่งพัสดุจากบริษัทจริงถูกย้ายไปอยู่ในโฟลเดอร์สแปม ขณะเดียวกันอีเมลหลอกให้กดลิงก์กลับผ่านเข้ามาในกล่องหลัก หากบอกเพียงว่า “AI ทำพลาด” เราจะยังไม่รู้ว่าควรแก้ตรงไหน เพราะคำว่า AI ครอบคลุมตั้งแต่ข้อมูลที่เข้ามา วิธีแปลงข้อความ โมเดลที่ให้คะแนน เกณฑ์ตัดสิน ไปจนถึงหน้าจอที่ผู้ใช้เห็น
บทเรียนนี้จะใช้ระบบกรองสแปมเป็นเส้นเรื่องเดียวเพื่อแกะคำว่า โมเดล ออกจากระบบทั้งหมด เราจะตามอีเมลหนึ่งฉบับตั้งแต่กลายเป็นอินพุต ผ่านสิ่งที่โมเดลเรียนรู้ ออกมาเป็นคะแนน แล้วถูกเปลี่ยนเป็นการกระทำ เมื่อจบ คุณจะไม่เพียงจำคำจำกัดความ แต่จะวาดขอบเขตของโมเดล ตรวจจุดพลาด และถามคำถามที่ช่วยให้ใช้โมเดลอย่างรับผิดชอบได้
ความรู้ก่อนเรียน: หากทบทวนบทบาทของข้อมูลในระบบ AI จากหัวข้อ 15 มาก่อน จะช่วยให้เห็นว่าโมเดลรับอินพุต เรียนรู้รูปแบบ และเปลี่ยนผลลัพธ์เป็นการตัดสินใจอย่างไร
เมื่ออ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบายโมเดลด้วยภาพจำ Input → Function → Output โดยไม่สับสนกับระบบ AI ทั้งหมด
- แยกโครงสร้าง พารามิเตอร์ ไฮเปอร์พารามิเตอร์ วัตถุประสงค์ และเกณฑ์ตัดสินออกจากกันได้
- อธิบายความต่างระหว่าง Training, Validation, Test และ Inference พร้อมบอกสาเหตุที่ผลโลกจริงอาจต่างจากห้องทดลองได้
- อ่านคะแนนโมเดลอย่างระมัดระวัง เลือก Threshold ตามต้นทุนความผิดพลาด และตั้งคำถามเรื่อง Calibration ได้
- ไล่ตรวจความผิดพลาดตั้งแต่อินพุตถึงการกระทำ ระบุรุ่นโมเดล หลักฐาน และผู้รับผิดชอบได้
1. โมเดลคืออะไร: เริ่มจากภาพจำที่ถูกต้อง
ในความหมายกว้าง โมเดลคือกลไกเชิงคำนวณที่รับอินพุตแล้วให้เอาต์พุต หากเขียนแบบย่อ เราอาจใช้สัญลักษณ์ว่า y = f(x) โดย x คืออินพุต f คือโมเดล และ y คือผลลัพธ์ ประโยคนี้ดูเรียบง่าย แต่ช่วยวางเส้นแบ่งสำคัญมาก เพราะสิ่งที่เกิดก่อน x และสิ่งที่ระบบทำหลัง y ไม่จำเป็นต้องอยู่ในตัวโมเดล
สำหรับระบบกรองสแปม ผู้ใช้อาจเห็น “อีเมลหนึ่งฉบับ” เป็นอินพุต แต่โมเดลมักไม่ได้อ่านอีเมลดิบในรูปเดิมเสมอ ระบบอาจแปลงหัวเรื่อง ผู้ส่ง โดเมน ลิงก์ คำบางคำ รูปแบบตัวอักษร และประวัติการโต้ตอบให้เป็นตัวเลขหรือโทเคนก่อน สิ่งที่โมเดลรับจริงจึงเป็นตัวแทนของอีเมล ไม่ใช่ประสบการณ์ทั้งหมดที่มนุษย์เห็น
โมเดลกรองสแปมอาจให้เอาต์พุตเป็นคะแนน 0.87 ซึ่งหมายถึงหลักฐานภายในโมเดลเอนเอียงไปทางสแปมในระดับหนึ่ง คะแนนนี้ยังไม่ใช่คำสั่ง “ย้ายอีเมล” การกระทำเกิดขึ้นเมื่อระบบเปรียบเทียบคะแนนกับเกณฑ์ เช่น ถ้าคะแนนตั้งแต่ 0.80 ขึ้นไปให้ย้าย ถ้าอยู่ระหว่าง 0.60–0.79 ให้แสดงคำเตือน และถ้าต่ำกว่านั้นให้เข้ากล่องหลัก
ดังนั้นโมเดลไม่ใช่ฐานข้อมูล ไม่ใช่หน้าจอ ไม่ใช่กฎธุรกิจ และไม่ใช่มนุษย์ผู้รับผิดชอบ โมเดลเป็นส่วนที่เรียนหรือใช้ความสัมพันธ์ระหว่างอินพุตกับผลลัพธ์ แต่ความหมายของผลลัพธ์และผลกระทบต่อคนเกิดจากการออกแบบระบบรอบโมเดลด้วย หากเข้าใจเส้นแบ่งนี้ เราจะไม่รีบฝึกโมเดลใหม่ทุกครั้งที่ระบบมีปัญหา
ภาพจำสั้นที่สุด: โมเดลคือ “เครื่องแปลงตามรูปแบบที่เรียนมา” ส่วนระบบคือโรงงานทั้งสาย ตั้งแต่วัตถุดิบ กฎความปลอดภัย คนควบคุม ไปจนถึงการส่งสินค้า
อุปมาโรงงานมีขอบเขต โมเดลบางชนิดไม่ได้แปลงอินพุตแบบตายตัว เพราะมีการสุ่ม มีสถานะ หรือรับบริบทเพิ่มเติม โมเดลสร้างข้อความอาจให้คำตอบต่างกันเมื่อเปลี่ยนอุณหภูมิการสุ่มหรือคำสั่ง แม้ใช้อินพุตคล้ายเดิม อย่างไรก็ตาม แก่นยังเหมือนเดิม คือโมเดลสร้างผลจากอินพุต โครงสร้าง พารามิเตอร์ และการตั้งค่าที่ระบบส่งให้
คำว่า “โมเดลเรียนรู้” ไม่ได้ยืนยันว่าโมเดลเข้าใจ เจตนา หรือมีสามัญสำนึกเหมือนมนุษย์ ในแมชชีนเลิร์นนิง การเรียนรู้หมายถึงการปรับค่าภายในเพื่อให้ทำวัตถุประสงค์ที่กำหนดได้ดีขึ้นบนข้อมูลตัวอย่าง โมเดลจึงสะท้อนสิ่งที่ข้อมูลและวัตถุประสงค์ทำให้คุ้มค่า ไม่ได้สะท้อนความจริงทั้งหมดของโลกโดยอัตโนมัติ
2. ชิ้นส่วนสำคัญ: โครงสร้าง พารามิเตอร์ และสิ่งที่ไม่ได้เรียนเอง
เริ่มจาก โครงสร้างหรือสถาปัตยกรรม ซึ่งบอกว่าโมเดลคำนวณอย่างไร โมเดลเชิงเส้นรวมค่าน้ำหนักของคุณลักษณะ ต้นไม้ตัดสินใจถามเงื่อนไขเป็นกิ่ง ส่วนโครงข่ายประสาทส่งสัญญาณผ่านหลายชั้น สถาปัตยกรรมกำหนดรูปแบบความสัมพันธ์ที่โมเดลสามารถแทนได้ แต่สถาปัตยกรรมที่ซับซ้อนกว่าไม่ได้ชนะเสมอ หากข้อมูลน้อย เป้าหมายไม่ชัด หรือระบบต้องอธิบายได้ โมเดลง่ายอาจเหมาะกว่า
พารามิเตอร์ คือค่าที่กระบวนการฝึกปรับจากข้อมูล เช่น น้ำหนักที่ทำให้คำว่า “รับรางวัลทันที” เพิ่มคะแนนสแปม หรือค่าน้ำหนักที่ทำให้โดเมนผู้ส่งซึ่งเคยติดต่อกันลดคะแนน พารามิเตอร์จำนวนมากอาจทำงานร่วมกันจนไม่มีค่าใดค่าเดียวแปลเป็นกฎภาษามนุษย์ตรง ๆ ได้ จึงต้องใช้การประเมินและวิธีอธิบายที่เหมาะสมแทนการเดาจากน้ำหนักจุดเดียว
ไฮเปอร์พารามิเตอร์ คือค่าที่ทีมกำหนดเพื่อควบคุมการเรียนรู้หรือโครงสร้าง เช่น อัตราการเรียนรู้ จำนวนรอบ ความลึกของต้นไม้ ขนาดโมเดล หรือความแรงของการทำ Regularization ค่าเหล่านี้ไม่ได้เรียนด้วยวิธีเดียวกับพารามิเตอร์หลัก เรามักเลือกจากผลบนชุด Validation พร้อมคำนึงถึงเวลา หน่วยความจำ ความเสถียร และข้อจำกัดของการใช้งาน
ฟังก์ชันความสูญเสียหรือ Loss เปลี่ยนความคลาดเคลื่อนให้เป็นสัญญาณที่กระบวนการฝึกพยายามลด หากสแปมถูกทายเป็นอีเมลปกติ Loss จะบอกว่าโมเดลผิดมากน้อยเพียงใด แต่ Loss เป็นตัวแทนของเป้าหมาย ไม่ใช่เป้าหมายจริงทั้งหมดขององค์กร การลด Loss อาจไม่ลดความรำคาญของผู้ใช้ หรือไม่ปกป้องผู้ใช้กลุ่มที่มีรูปแบบภาษาแตกต่าง หากวัตถุประสงค์ไม่ได้สะท้อนสิ่งเหล่านั้น
Optimizer คือวิธีปรับพารามิเตอร์จากสัญญาณความผิดพลาด เปรียบได้กับวิธีเดินลงภูเขาเพื่อหาจุดต่ำ แต่ภูมิประเทศของโมเดลอาจซับซ้อน จุดเริ่มต้น ลำดับข้อมูล และการตั้งค่าจึงมีผลต่อจุดที่ไปถึง การฝึกซ้ำภายใต้เงื่อนไขต่างกันอาจได้พารามิเตอร์ไม่เหมือนกันแม้ใช้ข้อมูลชุดเดียวกัน
คุณลักษณะหรือ Representation คือรูปแบบที่ข้อมูลถูกนำเสนอให้โมเดล สำหรับสแปม โมเดลรุ่นหนึ่งอาจใช้จำนวนลิงก์ ความยาวหัวเรื่อง และชื่อโดเมน อีกโมเดลอาจใช้โทเคนจากข้อความทั้งฉบับ การเลือกตัวแทนข้อมูลกำหนดว่าโมเดลมองเห็นอะไรและมองไม่เห็น หากระบบตัดข้อมูลภาษาหนึ่งทิ้ง โมเดลก็ไม่มีทางเรียนสัญญาณในภาษานั้นได้
สิ่งที่โมเดลเรียน
พารามิเตอร์หรือความสัมพันธ์ที่ช่วยลดความผิดพลาดตามวัตถุประสงค์และข้อมูลฝึก
สิ่งที่ทีมเลือก
โจทย์ นิยามป้ายกำกับ สถาปัตยกรรม ไฮเปอร์พารามิเตอร์ ตัวชี้วัด เกณฑ์ และขั้นตอนใช้งาน
สิ่งที่โลกกำหนด
พฤติกรรมผู้ส่ง ภาษาใหม่ กลยุทธ์ผู้โจมตี ความคาดหวังผู้ใช้ และต้นทุนของความผิดพลาด
แนวคิดสำคัญคือโมเดลไม่เลือกเป้าหมายของตัวเอง ทีมเป็นผู้เลือกว่าจะเรียกอะไรว่า “สแปม” ใช้ข้อมูลช่วงใด ให้น้ำหนักความผิดพลาดแบบใด และตัดสินความสำเร็จจากตัวชี้วัดใด การบอกว่า “โมเดลเป็นกลางเพราะเรียนจากข้อมูล” จึงไม่ถูกต้อง เพราะทั้งข้อมูล ป้ายกำกับ วัตถุประสงค์ และเกณฑ์ล้วนเกิดจากการตัดสินใจ
3. วงจรการฝึก: จากตัวอย่างไปสู่พารามิเตอร์
การฝึกเริ่มก่อนที่อัลกอริทึมจะคำนวณ ทีมต้องนิยามงาน เช่น ทายว่าอีเมลเป็นสแปมหรือไม่ แล้วกำหนดหน่วยตัวอย่างและป้ายกำกับ หากผู้ใช้กด “ไม่ใช่สแปม” เราจะถือว่าเป็นคำตอบจริงทันทีหรือให้คนตรวจเพิ่ม หากผู้ใช้ไม่เคยเปิดอีเมล เราจะตีความอย่างไร คำตอบเหล่านี้กำหนดความหมายของข้อมูลฝึก
ขั้นต่อมาคือทำความสะอาดและแบ่งข้อมูล โดยทั่วไปใช้ชุด Training เพื่อปรับพารามิเตอร์ ชุด Validation เพื่อเลือกการตั้งค่าและตัดสินใจระหว่างโมเดล และชุด Test เพื่อประเมินครั้งสุดท้ายภายใต้เงื่อนไขที่ไม่ควรถูกใช้เลือกโมเดล หากเปิดดูผล Test ซ้ำแล้วปรับโมเดลตามผล Test ชุดนั้นจะค่อย ๆ กลายเป็น Validation และคะแนนอาจมองโลกในแง่ดีเกินจริง
การแบ่งแบบสุ่มไม่เหมาะกับทุกสถานการณ์ ระบบสแปมเผชิญกลยุทธ์ที่เปลี่ยนตามเวลา หากสุ่มอีเมลเก่ากับใหม่ปะปน ทีมอาจได้ตัวอย่างจากแคมเปญเดียวกันอยู่ทั้ง Training และ Test ทำให้ดูเหมือนโมเดลจำแนกอีเมลใหม่ได้ดี ทั้งที่จริงจำรูปแบบเดิม การแบ่งตามเวลา หรือแยกตามผู้ส่ง แคมเปญ และผู้ใช้ อาจสะท้อนโจทย์จริงกว่า
ระหว่างการฝึก โมเดลรับกลุ่มตัวอย่าง สร้างผลทำนาย เปรียบเทียบกับป้ายกำกับ คำนวณ Loss และปรับพารามิเตอร์ วงจรนี้เกิดซ้ำหลายรอบ หากโมเดลเรียนไม่พอ ทั้ง Training และ Validation อาจแย่ เรียกว่า Underfitting หากจำรายละเอียด Training มากเกินไป Training ดีมากแต่ Validation แย่ เรียกว่า Overfitting เป้าหมายไม่ใช่คะแนน Training สูงสุด แต่คือความสามารถกับตัวอย่างใหม่ที่เหมือนบริบทใช้งาน
Regularization, Early Stopping, การเพิ่มข้อมูล และการลดความซับซ้อนเป็นวิธีช่วยลด Overfitting แต่แต่ละวิธีมีต้นทุน การบังคับมากเกินไปอาจทำให้โมเดลพลาดสัญญาณที่มีประโยชน์ การเลือกจึงต้องดูเส้นโค้งการเรียนรู้ ผลกลุ่มย่อย และความเสถียรหลายรอบ ไม่ใช่ดูตัวเลขสุดท้ายเพียงค่าเดียว
สำหรับสแปม ข้อมูลยังมีความไม่สมดุล อีเมลปกติอาจมากกว่าสแปม หรือสแปมบางชนิดพบได้น้อย โมเดลที่ตอบ “ปกติ” เกือบทุกครั้งอาจมี Accuracy สูง แต่ปล่อยภัยคุกคามสำคัญหลุดรอด จึงต้องดู Precision, Recall, False Positive และ False Negative ตามต้นทุนจริง พร้อมมี Baseline เช่น กฎเดิมหรือการทายคลาสส่วนใหญ่เพื่อรู้ว่าโมเดลใหม่เพิ่มคุณค่าจริงหรือไม่
ข้อมูลรั่วหรือ Data Leakage เป็นจุดพลาดที่ทำให้คะแนนดีเกินจริง ตัวอย่างเช่น ฟิลด์ที่สร้างหลังจากทีมยืนยันว่าเป็นสแปมถูกนำเข้าเป็นคุณลักษณะ หรือข้อความตอบกลับจากผู้ใช้ที่เกิดหลังการตัดสินใจหลุดเข้า Training เมื่อใช้งานจริงข้อมูลเหล่านั้นยังไม่เกิด โมเดลจึงไม่มีสัญญาณวิเศษเหมือนตอนทดสอบ การตรวจลำดับเวลาและแหล่งกำเนิดคุณลักษณะจึงจำเป็น
อีกประเด็นคือคุณภาพป้ายกำกับ ผู้ใช้สองคนอาจมองอีเมลโฆษณาเดียวกันต่างกัน ผู้หนึ่งสมัครรับข่าวสาร ส่วนอีกคนไม่ต้องการ การรวมป้ายกำกับโดยไม่เก็บบริบทอาจสอนความขัดแย้งให้โมเดล ทีมควรระบุนิยาม จัดการกรณีก้ำกึ่ง และวัดความสอดคล้องของผู้ติดป้าย ไม่ใช่ถือว่าป้ายทุกป้ายเป็นข้อเท็จจริงสมบูรณ์
4. การประเมิน: คะแนนดีต้องตอบคำถามที่ถูก
ตัวชี้วัดไม่มีค่าโดยแยกจากคำถาม Accuracy ตอบว่าสัดส่วนคำตอบถูกทั้งหมดเท่าไร Precision ตอบว่าในสิ่งที่โมเดลระบุว่าเป็นสแปม มีสแปมจริงเท่าไร Recall ตอบว่าในสแปมจริงทั้งหมด โมเดลจับได้เท่าไร ไม่มีตัวชี้วัดใดดีที่สุดเสมอ เพราะการกันอีเมลสำคัญผิดกับการปล่อยอีเมลหลอกมีผลต่างกัน
สมมติว่ามีอีเมล 10,000 ฉบับ เป็นสแปม 200 ฉบับ โมเดลที่ตอบว่า “ไม่ใช่สแปม” ทุกฉบับมี Accuracy 98 เปอร์เซ็นต์ แต่ Recall ของสแปมเป็นศูนย์ ตัวเลข 98 จึงไม่ได้หมายความว่าระบบทำงานดี การรายงานควรมี Confusion Matrix ที่แยก True Positive, False Positive, True Negative และ False Negative เพื่อเห็นชนิดของความผิดพลาด
Precision กับ Recall มักแลกกันเมื่อเปลี่ยน Threshold หากลดเกณฑ์ โมเดลจับสแปมได้มากขึ้น แต่มีอีเมลปกติถูกกันมากขึ้น หากเพิ่มเกณฑ์ อีเมลปกติปลอดภัยขึ้น แต่สแปมอาจหลุดมากขึ้น การเลือกจุดทำงานควรใช้ต้นทุน ความสามารถในการตรวจซ้ำ และช่องทางกู้คืน เช่น มีโฟลเดอร์สแปมให้ผู้ใช้ดึงกลับหรือไม่
ผลรวมอาจซ่อนปัญหากลุ่มย่อย โมเดลอาจทำงานดีกับภาษาอังกฤษแต่แย่กับภาษาไทย หรือดีกับองค์กรใหญ่แต่แย่กับผู้ส่งรายย่อย ทีมควรแบ่งผลตามภาษา ประเภทผู้ส่ง อุปกรณ์ ช่วงเวลา และกลุ่มที่มีความหมาย โดยระวังว่ากลุ่มเล็กให้ค่าผันผวน ต้องรายงานจำนวนตัวอย่างและช่วงความไม่แน่นอนควบคู่
การประเมินแบบ Offline ใช้ข้อมูลย้อนหลังและควบคุมง่าย แต่ไม่เห็นพฤติกรรมมนุษย์ทั้งหมด การทดลอง Online อาจเห็นว่าผู้ใช้กู้คืนอีเมลมากขึ้นหรือรายงานสแปมน้อยลง แต่ต้องมีการป้องกันผลกระทบ การสุ่มอย่างเหมาะสม เกณฑ์หยุด และช่องทางอุทธรณ์ ไม่ควรปล่อยโมเดลใหม่ให้ผู้ใช้ทั้งหมดเพียงเพราะ Test ดีขึ้นเล็กน้อย
ก่อนเลือกโมเดล ควรเปรียบเทียบกับ Baseline ที่สมเหตุสมผล เช่น กฎเดิม โมเดลรุ่นก่อน หรือวิธีง่ายกว่า หากโมเดลซับซ้อนเพิ่ม Recall เพียงเล็กน้อยแต่ใช้ทรัพยากรมาก ตอบช้า และอธิบายยาก ทีมอาจเลือกโมเดลง่าย การประเมินที่ดีจึงรวมคุณภาพ ความเร็ว ต้นทุน ความเสถียร การดูแล และผลกระทบ ไม่ใช่คะแนนเดียว
| ตัวชี้วัด | คำถาม | สิ่งที่ต้องระวัง |
|---|---|---|
| Accuracy | ทายถูกทั้งหมดกี่ส่วน | หลอกตาได้เมื่อคลาสไม่สมดุล |
| Precision | สิ่งที่กันไว้เป็นสแปมจริงกี่ส่วน | สูงได้จากการกันเฉพาะกรณีง่ายจน Recall ต่ำ |
| Recall | สแปมจริงถูกจับได้กี่ส่วน | สูงได้ด้วยการกันกว้างจนรบกวนอีเมลปกติ |
| Calibration | คะแนนสอดคล้องกับอัตราเกิดจริงหรือไม่ | อาจเปลี่ยนเมื่อบริบทหรือข้อมูลเปลี่ยน |
| Latency | ผู้ใช้ต้องรอผลนานเท่าไร | ค่าเฉลี่ยอาจซ่อนกรณีช้ามาก |
5. Inference: โมเดลที่ฝึกแล้วทำงานกับอีเมลใหม่อย่างไร
เมื่อฝึกเสร็จ ทีมบันทึกโครงสร้างและพารามิเตอร์เป็น Artifact แล้วนำไปให้บริการ การเรียกโมเดลกับอินพุตใหม่เรียกว่า Inference ระบบอาจเรียกทันทีเมื่ออีเมลมาถึง หรือประมวลผลเป็นชุด การเลือกมีผลต่อความเร็ว ต้นทุน และการกู้คืน หากบริการล่ม ระบบจะพักอีเมล ใช้กฎสำรอง หรือปล่อยผ่านอย่างไรต้องกำหนดก่อนเกิดเหตุ
ขั้นเตรียมข้อมูลตอน Inference ต้องตรงกับตอน Training หากตอนฝึกแปลงตัวอักษรเป็นตัวพิมพ์เล็ก ตัด HTML และใช้พจนานุกรมรุ่นหนึ่ง แต่ระบบจริงใช้โค้ดคนละรุ่น ค่าที่เข้าโมเดลจะต่าง ปัญหานี้เรียก Training–Serving Skew และอาจทำให้คุณภาพตกแม้ไฟล์โมเดลไม่เปลี่ยน วิธีลดคือใช้โค้ดร่วมกัน บันทึกเวอร์ชัน และทดสอบตัวอย่างเดียวกันทั้งสองทาง
อินพุตต้องผ่านการตรวจรูปแบบและขอบเขต เช่น ความยาวอีเมล ภาษา ไฟล์แนบ และค่าที่หายไป โมเดลอาจคืนคะแนนได้แม้อินพุตผิดหน่วยหรืออยู่นอกช่วง แต่คะแนนนั้นไม่มีความหมาย ระบบจึงควรตรวจ Schema ระบุค่าเริ่มต้นอย่างระมัดระวัง และส่งกรณีผิดปกติไปเส้นทางสำรองแทนการบังคับให้โมเดลตอบ
สำหรับโมเดลสร้างเนื้อหา Inference ยังรวม Prompt, System Instruction, Context, เครื่องมือที่อนุญาต ค่าการสุ่ม และตัวกรอง ผลลัพธ์จึงไม่ได้มาจากน้ำหนักโมเดลเพียงอย่างเดียว หากคำตอบเปลี่ยน ต้องบันทึกส่วนประกอบเหล่านี้ด้วย การระบุเพียงชื่อโมเดลไม่พอสำหรับการทำซ้ำหรือสอบสวนเหตุการณ์
การให้บริการต้องคำนึงถึง Latency, Throughput และความพร้อมใช้งาน โมเดลใหญ่กว่าอาจแม่นขึ้นบนชุดทดสอบ แต่ตอบไม่ทันภาระงานจริง ระบบอาจลดขนาด ทำ Quantization ใช้ Cache หรือส่งเฉพาะกรณียากไปโมเดลใหญ่ ทุกวิธีเปลี่ยนพฤติกรรม จึงต้องประเมิน Artifact ที่ใช้งานจริง ไม่ใช่เฉพาะต้นฉบับในห้องทดลอง
สิ่งสำคัญคือ Logging ที่พอสำหรับตรวจสอบแต่ไม่ละเมิดความเป็นส่วนตัว ควรบันทึกเวลา รุ่นโมเดล รุ่นตัวแปลงอินพุต คะแนน เกณฑ์ เส้นทางตัดสิน และผลตอบกลับ โดยลดหรือปกปิดเนื้อหาอ่อนไหว กำหนดสิทธิ์เข้าถึงและระยะเก็บ หากไม่มีหลักฐาน เราจะแยกไม่ได้ว่าความผิดพลาดมาจากโมเดล กฎ หรือข้อมูล
6. ผลลัพธ์ของโมเดล: อย่ารีบแปลคะแนนเป็นความจริง
โมเดลจำแนกประเภทอาจคืน Logit, Score หรือ Probability ชื่อเรียกใน API ไม่รับประกันว่าค่าเป็นความน่าจะเป็นที่ปรับเทียบแล้ว คะแนน 0.9 อาจหมายถึงโมเดลชอบคลาสสแปมมากกว่าคลาสอื่น ไม่ได้หมายความว่าอีเมลฉบับนั้นมีโอกาสเป็นสแปม 90 เปอร์เซ็นต์เสมอ ต้องดูวิธีฝึก การแปลงคะแนน และผล Calibration บนข้อมูลใกล้เคียงการใช้งาน
โมเดลจัดอันดับคืนลำดับหรือคะแนนความเกี่ยวข้อง ระบบยังต้องเลือกจำนวนรายการ เพิ่มความหลากหลาย ตัดสิ่งต้องห้าม และคำนึงถึงความใหม่ โมเดลประมาณค่าคืนตัวเลขต่อเนื่อง เช่น ยอดขายหรือเวลา ควรแสดงช่วงความไม่แน่นอนและสมมติฐาน โมเดลสร้างข้อความคืนโทเคนต่อเนื่อง ซึ่งสามารถสร้างประโยคคล่องแต่ผิดข้อเท็จจริงได้
คำว่า “Confidence” บนหน้าจออาจทำให้คนเข้าใจเกินจริง หากไม่บอกว่าค่านี้วัดอะไรและผ่านการปรับเทียบหรือไม่ ผู้ใช้อาจถือว่าเป็นความมั่นใจแบบมนุษย์ การออกแบบที่รับผิดชอบควรใช้ภาษาตรง เช่น “คะแนนของโมเดล” แสดงข้อจำกัด และให้ข้อมูลที่ช่วยตรวจซ้ำ ไม่ใช้ตัวเลขทศนิยมหลายหลักเพื่อสร้างภาพความแม่นยำปลอม
ผลลัพธ์ยังขึ้นกับพื้นที่ของคลาส หากโมเดลรู้จักเพียง “สแปม” กับ “ปกติ” อีเมลฟิชชิงรูปแบบใหม่อาจถูกบังคับเข้าหนึ่งในสองกลุ่ม โมเดลไม่สามารถตั้งชื่อคลาสที่ไม่มีในงานได้เอง ระบบควรมีทางเลือก “ไม่แน่ใจ” หรือ Out-of-Distribution Detection เมื่อเหมาะสม และส่งกรณีเสี่ยงสูงให้มนุษย์ตรวจ
ในกรณีสแปม ลองแยกสามชั้นให้ชัด ชั้นแรกโมเดลให้คะแนน 0.74 ชั้นที่สองนโยบายกำหนดว่า 0.70–0.85 ให้ติดป้ายเตือน ชั้นที่สามอินเทอร์เฟซแสดงแถบสีเหลืองและให้ผู้ใช้กดรายงาน หากผู้ใช้คิดว่าแถบสีเหลืองหมายถึง “อันตรายแน่นอน” ปัญหาอยู่ที่การสื่อสาร ไม่ใช่จำเป็นต้องอยู่ที่โมเดล
7. โมเดลกับระบบ: ใครทำอะไรในสายงานจริง
ระบบเริ่มจากแหล่งข้อมูลและสิทธิ์เข้าถึง อีเมลอาจถูกสแกนส่วนหัว เนื้อหา และไฟล์แนบ การตัดสินใจว่าจะอ่านอะไรมีผลต่อความเป็นส่วนตัวและคุณภาพ หากตัดไฟล์แนบออก โมเดลอาจพลาดภัยในไฟล์ หากอ่านทุกอย่างโดยไม่มีการคุ้มครอง ระบบอาจเก็บข้อมูลส่วนบุคคลเกินจำเป็น การออกแบบจึงต้องสมดุลเป้าหมายกับสิทธิ์ของผู้ใช้
ขั้นเตรียมข้อมูลอาจตรวจไวรัส แยกภาษา ดึงโดเมน และสร้างคุณลักษณะ ข้อผิดพลาดในขั้นนี้เปลี่ยนอินพุตก่อนถึงโมเดล เช่น ตัวถอด HTML ลบข้อความสำคัญ หรือระบบอ่านภาษาไทยผิดเป็นอักขระเสีย โมเดลจะตอบตามข้อมูลที่ได้รับ แม้ตัวโมเดลทำงานตรงตามที่ออกแบบ
หลังโมเดลมี Post-processing เช่น รวมคะแนนจากหลายโมเดล บังคับกฎรายชื่อผู้ส่งที่เชื่อถือได้ หรือจำกัดการกระทำตามประเภทบัญชี กฎเหล่านี้อาจเพิ่มความปลอดภัย แต่ก็สร้างความขัดแย้ง หากกฎ Whitelist ถูกตั้งกว้าง ผู้โจมตีอาจอาศัยช่องนั้นผ่านโมเดล ทีมจึงต้องทดสอบทั้ง Pipeline ไม่ใช่ทดสอบโมเดลแยกส่วนเท่านั้น
มนุษย์อยู่หลายตำแหน่ง ผู้ติดป้ายข้อมูลกำหนดตัวอย่าง ทีมผลิตภัณฑ์กำหนดประสบการณ์ ผู้ดูแลความเสี่ยงกำหนดขอบเขต ผู้ปฏิบัติงานตรวจกรณีก้ำกึ่ง และผู้ใช้ให้ Feedback การเขียนว่า “AI ตัดสินใจ” อาจซ่อนความรับผิดชอบ ควรระบุว่าระบบใดสร้างคำแนะนำ ใครมีอำนาจอนุมัติ และใครแก้ไขผลได้
ระบบยังมีองค์ประกอบที่ไม่ใช่ AI เช่น ฐานข้อมูล Queue API การยืนยันตัวตน การสำรองข้อมูล และการแจ้งเตือน หาก API ส่งคะแนนของผู้ใช้ A ไปบัญชีผู้ใช้ B ต่อให้โมเดลแม่นก็เกิดความเสียหาย การประเมินระบบจึงรวม Security, Privacy, Reliability, Accessibility และการปฏิบัติงาน ไม่ใช่เฉพาะ Accuracy
NIST AI RMF เน้นการจัดการความเสี่ยงตามบริบท วงจรชีวิต และผู้มีส่วนได้ส่วนเสีย แนวคิดนี้ช่วยให้ถามได้ว่าใครได้รับประโยชน์ ใครรับผลเมื่อผิด มีช่องทางแก้หรืออุทธรณ์หรือไม่ และองค์กรติดตามความเสี่ยงหลังเปิดใช้จริงอย่างไร โมเดลเป็นหลักฐานหนึ่งชิ้นในคำตอบ ไม่ใช่คำตอบทั้งหมด
8. Threshold และ Calibration: สะพานจากคะแนนสู่ผลกระทบ
Threshold คือเกณฑ์ที่เปลี่ยนคะแนนต่อเนื่องเป็นเส้นทางตัดสิน ไม่มีเหตุผลสากลที่ต้องใช้ 0.5 เพราะค่าเหมาะสมขึ้นกับการกระจายคะแนน ต้นทุน และการปรับเทียบ ในระบบสแปม เราอาจมีสองเกณฑ์: สูงกว่า 0.90 ย้ายอัตโนมัติ ระหว่าง 0.65–0.90 เตือนแต่ยังแสดง และต่ำกว่า 0.65 ส่งเข้ากล่องหลัก การมีช่วงก้ำกึ่งช่วยหลีกเลี่ยงการตัดสินแบบแข็งเกินไป
ต้นทุน False Positive คืออีเมลปกติถูกกัน ผู้ใช้อาจพลาดงาน ใบเสร็จ หรือการแจ้งเตือนสำคัญ ต้นทุน False Negative คือสแปมหรือฟิชชิงผ่าน ผู้ใช้อาจเสียเงินหรือข้อมูล การให้น้ำหนักต้นทุนต้องอิงบริบท บัญชีองค์กรที่มีข้อมูลลับอาจใช้เกณฑ์ต่างจากบัญชีทั่วไป แต่ไม่ควรใช้ความกลัวแทนหลักฐาน
Calibration ตรวจว่าคะแนนสัมพันธ์กับอัตราเกิดจริงหรือไม่ หากอีเมลที่ได้คะแนนใกล้ 0.8 จำนวน 100 ฉบับ เป็นสแปมจริงประมาณ 80 ฉบับในบริบทเดียวกัน เราเรียกว่าปรับเทียบได้ใกล้เคียง โมเดลอาจจัดอันดับได้ดีแต่ Calibration แย่ หมายความว่าแยกกรณีเสี่ยงสูงต่ำได้ แต่ตัวเลขยังไม่เหมาะกับการสื่อเป็นความน่าจะเป็น
Calibration ไม่ถาวร เมื่อรูปแบบสแปม ภาษา หรือสัดส่วนผู้ใช้เปลี่ยน ความสัมพันธ์ระหว่างคะแนนกับเหตุการณ์จริงเปลี่ยนตาม จึงต้องติดตามเป็นช่วงเวลาและกลุ่มย่อย การนำโมเดลจากประเทศหนึ่งไปอีกประเทศหนึ่งโดยใช้เกณฑ์เดิม อาจทำให้ผลต่างมาก แม้โมเดลไฟล์เดิมไม่เปลี่ยน
การเลือกเกณฑ์ควรบันทึกเหตุผล วันที่ ข้อมูลที่ใช้ ผู้อนุมัติ และเงื่อนไขทบทวน หากเปลี่ยน Threshold ต้องถือว่าเป็นการเปลี่ยนพฤติกรรมระบบ แม้ไม่ฝึกโมเดลใหม่ ควรทดสอบ ย้อนกลับได้ และสื่อสารผลกระทบ การกล่าวว่า “ไม่ได้เปลี่ยนโมเดล” ไม่พอจะสรุปว่าระบบเหมือนเดิม
ในงานที่มีผลสูง ไม่ควรให้เกณฑ์หนึ่งสร้างคำตัดสินสุดท้ายโดยไม่มี Safeguard อาจใช้การตรวจสองชั้น หลักฐานประกอบ หรือการอนุมัติของมนุษย์ แต่ Human-in-the-loop ไม่ใช่ยาวิเศษ หากคนมีเวลาน้อย เห็นคะแนนแบบชี้นำ หรือไม่มีอำนาจแก้ การมีมนุษย์อยู่ในแผนภาพก็ไม่ได้ทำให้ระบบปลอดภัยขึ้นจริง
9. เมื่อโมเดลพลาด: ไล่ตรวจตั้งแต่ข้อมูลถึงโลกที่เปลี่ยน
กลับมาที่อีเมลพัสดุซึ่งถูกย้ายผิด ขั้นแรกอย่าเริ่มจากฝึกใหม่ ให้เก็บเหตุการณ์ที่ทำซ้ำได้: อีเมลเวลาใด บัญชีใด ตัวแปลงข้อมูลรุ่นไหน โมเดลรุ่นไหน คะแนนเท่าไร Threshold เท่าไร และกฎใดทำงาน หากไม่มีข้อมูลนี้ การแก้จะกลายเป็นการเดา และอาจสร้างผลเสียกับอีเมลประเภทอื่น
ตรวจอินพุตว่าครบและถูกหน่วยหรือไม่ โดเมนผู้ส่งถูกอ่านผิดหรือไม่ ตัวอักษรภาษาไทยถูกตัดหรือไม่ ลิงก์ถูกขยายก่อนตรวจหรือไม่ จากนั้นเปรียบเทียบคุณลักษณะกับ Training หาก Feature Distribution เปลี่ยน เช่น จำนวนอีเมลที่มี QR Code เพิ่มขึ้น โมเดลเก่าอาจไม่รู้สัญญาณใหม่
Data Drift หมายถึงการกระจายอินพุตเปลี่ยน เช่น ผู้ใช้เริ่มส่งรูปแทนข้อความ Concept Drift หมายถึงความสัมพันธ์ระหว่างอินพุตกับคำตอบเปลี่ยน เช่น คำที่เคยพบในสแปมกลายเป็นคำการตลาดทั่วไป ทั้งสองแบบทำให้คุณภาพลด แต่แนวแก้ต่างกัน การเห็น Drift ไม่ได้แปลว่าต้องฝึกใหม่ทันที ต้องตรวจผลต่อความผิดพลาดก่อน
ตรวจ Training–Serving Skew ว่าการแปลงข้อมูลเหมือนกันหรือไม่ ตรวจ Model Artifact และ Checksum ว่าโหลดรุ่นที่อนุมัติ ตรวจ Dependency และฮาร์ดแวร์หากผลคำนวณเปลี่ยน ตรวจ Post-processing ว่ามีการปรับคะแนนหรือกฎใหม่ และตรวจ Cache ว่าเก็บผลเก่าผิดบัญชีหรือไม่
บางปัญหาเป็น Adversarial Adaptation ผู้ส่งสแปมสังเกตระบบแล้วเปลี่ยนการสะกด ใส่ช่องว่าง ใช้รูปภาพ หรือยึดบัญชีผู้ส่งที่น่าเชื่อถือ การฝึกจากการโจมตีเมื่อวานอาจตามไม่ทัน การป้องกันจึงต้องมีหลายชั้น อัปเดตสัญญาณ เฝ้าระวัง และจำกัดผลกระทบเมื่อชั้นหนึ่งพลาด
Feedback Loop ก็สร้างปัญหาได้ หากระบบแสดงเฉพาะอีเมลที่คะแนนต่ำ ผู้ใช้จะรายงานผลกับกลุ่มนั้นมากกว่า ส่วนอีเมลที่ถูกกันไม่มีโอกาสถูกเห็น ข้อมูล Feedback จึงไม่ใช่ตัวอย่างสุ่มจากโลก การฝึกซ้ำจาก Feedback ดิบอาจตอกย้ำความผิดเดิม ต้องออกแบบ Sampling และการตรวจสอบให้เห็นกรณีที่ระบบซ่อนด้วย
เมื่อพบสาเหตุ ให้เลือกการแก้ที่ตรงชั้น: แก้ Parser หากอินพุตเสีย ปรับกฎหาก Threshold ไม่เหมาะ อัปเดต UI หากผู้ใช้เข้าใจผิด ฝึกใหม่หากความสัมพันธ์เปลี่ยน และเพิ่มช่องอุทธรณ์หากผู้ใช้แก้ผลไม่ได้ การฝึกโมเดลใหม่โดยไม่รู้สาเหตุอาจทำให้คะแนนรวมดีขึ้นแต่ปัญหาเดิมยังอยู่
Checklist สอบสวนเหตุการณ์
- เก็บตัวอย่างจริงและเวลาที่เกิดโดยปกป้องข้อมูลส่วนบุคคล
- ระบุรุ่นของข้อมูล ตัวแปลง โมเดล เกณฑ์ กฎ และหน้าจอ
- ทำซ้ำผลในสภาพแวดล้อมควบคุม
- เปรียบเทียบกับรุ่นก่อนและ Baseline ด้วยเงื่อนไขเดียวกัน
- ประเมินผลรวม กลุ่มย่อย และชนิดความผิดพลาด
- เลือกการแก้ที่ตรงสาเหตุ พร้อมแผน Rollback
- ติดตามหลังแก้เพื่อดูผลข้างเคียงและบันทึกบทเรียน
10. รุ่น ขอบเขต และการกำกับ: ทำให้ย้อนตอบได้ว่าเกิดอะไรขึ้น
ชื่อ “spam-model” ไม่พอสำหรับการตรวจสอบ ต้องมี Version ที่ชี้ไปยัง Artifact, โค้ด, การตั้งค่า, Dataset Snapshot และผลประเมิน ทีมควรรู้ว่าใครอนุมัติ เปิดใช้เมื่อไร ใช้กับผู้ใช้กลุ่มใด และถอยกลับอย่างไร หากเปลี่ยน Tokenizer หรือ Feature Pipeline พฤติกรรมอาจเปลี่ยนแม้พารามิเตอร์โมเดลเดิม
Model Card เป็นเอกสารสรุป Intended Use, Out-of-Scope Use, ตัวชี้วัด ชุดประเมิน ผลตามกลุ่ม ข้อจำกัด และข้อพิจารณาด้านจริยธรรม เอกสารนี้ไม่รับรองความปลอดภัยและไม่แทนการประเมินระบบ แต่ทำให้ข้อสมมติที่เคยอยู่ในหัวทีมมองเห็นและส่งต่อได้ ผู้ใช้ปลายทางควรได้รับส่วนที่จำเป็นต่อการตัดสินใจ ไม่ใช่เอกสารเทคนิคอย่างเดียว
ก่อนเปิดใช้ควรกำหนด Acceptance Criteria เช่น Recall ขั้นต่ำของฟิชชิง Precision ขั้นต่ำสำหรับการย้ายอัตโนมัติ Latency สูงสุด และเงื่อนไขกลุ่มย่อย กำหนด Red Line เช่น ห้ามย้ายอีเมลจากรายการสำคัญโดยไม่มีทางกู้คืน และกำหนดผู้มีอำนาจหยุดระบบเมื่อความเสี่ยงเกินขอบเขต
การเปิดใช้แบบ Canary หรือ Shadow ช่วยลดความเสี่ยง Shadow ให้โมเดลใหม่ทำนายโดยไม่กระทบผู้ใช้เพื่อเปรียบเทียบ Canary ให้ผู้ใช้ส่วนน้อยได้รับพฤติกรรมใหม่พร้อมติดตาม แต่ต้องเลือกกลุ่มอย่างเป็นธรรมและมีเกณฑ์หยุด วิธีเหล่านี้เป็นหลักฐานเสริม ไม่แทนการทดสอบก่อนเปิดใช้
Monitoring ต้องครอบคลุมคุณภาพเมื่อมีป้ายกำกับล่าช้า สัญญาณตัวแทน เช่น อัตรากู้คืนอีเมล การเปลี่ยนการกระจายอินพุต Latency Error Rate และผลกลุ่มย่อย Alert ต้องเชื่อมกับ Playbook ว่าใครตรวจ ทำอะไรภายในเวลาเท่าไร และเมื่อใดต้อง Rollback มิฉะนั้นกราฟจำนวนมากก็ไม่ช่วยลดความเสียหาย
การกำกับยังรวมการเก็บข้อมูลอย่างพอดี สิทธิ์เข้าถึง การลบตามกำหนด การจัดการเหตุการณ์ และช่องทางผู้ใช้ หากผู้ใช้กู้คืนอีเมลได้แต่ Feedback ไม่เคยถึงทีม โมเดลจะไม่ดีขึ้น หาก Feedback ถูกนำไปฝึกโดยไม่มีการตรวจ ผู้โจมตีอาจป้อนข้อมูลผิด การออกแบบวงจรเรียนรู้ต้องคำนึงถึงทั้งประโยชน์และการถูกโจมตี
คำถามสุดท้ายไม่ใช่เพียง “โมเดลแม่นไหม” แต่คือ “ระบบนี้เหมาะกับวัตถุประสงค์ ภายใต้บริบทและมาตรการที่มีหรือไม่” คำตอบควรมีระดับความเชื่อมั่นและความไม่แน่นอน เช่น ผลยังไม่ครอบคลุมภาษาหายาก หรือยังไม่มีป้ายกำกับโลกจริงเพียงพอ ความโปร่งใสเช่นนี้ช่วยให้ตัดสินใจดีกว่าความมั่นใจเกินหลักฐาน
11. ลงมือวิเคราะห์: วาดขอบเขตโมเดลและตรวจคำตอบ
โจทย์
ระบบกรองสแปมรับอีเมลใหม่ แปลงข้อความเป็นโทเคน ส่งเข้าโมเดลที่ให้คะแนน 0.78 จากนั้นกฎขององค์กรระบุว่าคะแนนตั้งแต่ 0.75 ให้ย้ายไปโฟลเดอร์สแปม ผู้ใช้กด “ไม่ใช่สแปม” และอีเมลถูกย้ายกลับ
- เขียนอินพุตที่ผู้ใช้เห็นและอินพุตที่โมเดลรับจริง
- ลากกรอบรอบส่วนที่เป็นโมเดล ระบุเอาต์พุตดิบ
- วงส่วนที่เปลี่ยนคะแนนเป็นการกระทำ
- ระบุหลักฐานอย่างน้อยห้ารายการที่ต้องเก็บเพื่อย้อนตรวจ
- เสนอการแก้สองแบบจากคนละชั้นของระบบ และบอกผลข้างเคียง
เปิดดูแนวคำตอบและเกณฑ์ตรวจตนเอง
อินพุตที่ผู้ใช้เห็นคืออีเมลทั้งฉบับ ส่วนอินพุตโมเดลคือโทเคนและคุณลักษณะที่ตัวแปลงสร้าง กรอบโมเดลเริ่มเมื่อรับตัวแทนเหล่านั้นและจบที่คะแนน 0.78 กฎ Threshold 0.75 อยู่หลังโมเดล และการย้ายโฟลเดอร์เป็นการกระทำของระบบ
หลักฐานควรมีอีเมลตัวอย่างที่ปกปิดข้อมูลอ่อนไหว เวลา รุ่น Parser/Tokenizer รุ่นโมเดล คะแนน เกณฑ์ กฎบัญชี เส้นทาง UI และ Feedback การแก้ชั้นโมเดลอาจเพิ่มตัวอย่างอีเมลพัสดุแล้วฝึกใหม่ แต่เสี่ยงลดการจับฟิชชิงที่เลียนแบบพัสดุ การแก้ชั้นนโยบายอาจเพิ่มช่วงเตือนก่อนย้าย แต่เพิ่มภาระผู้ใช้ คำตอบที่ดีต้องแยกชั้น บอกเหตุผล และยอมรับ Trade-off
ผ่านเมื่อ: คุณแยกโมเดลออกจาก Tokenizer และ Threshold ได้ ระบุเอาต์พุตดิบก่อนการกระทำได้ และไม่เสนอ “ฝึกใหม่” เป็นคำตอบเดียวโดยไม่มีหลักฐานสาเหตุ
นำไปใช้กับระบบอื่น
เลือกหนึ่งระบบ: แนะนำวิดีโอ อนุมัติเอกสาร ตรวจภาพ หรือผู้ช่วยตอบคำถาม เขียนแผนภาพห้าช่อง ข้อมูลเข้า → เตรียมข้อมูล → โมเดล → นโยบาย → ผลต่อผู้ใช้ แล้วตอบว่าโมเดลเรียนอะไร ทีมเลือกอะไร ใครตรวจกรณีก้ำกึ่ง และผู้ใช้แก้ผลได้อย่างไร หากตอบไม่ได้ แสดงว่ายังมีช่องว่างด้านเอกสารหรือความรับผิดชอบ
12. แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่ดีที่สุดให้ครบทุกข้อ แล้วกด “ตรวจคำตอบ” ระบบจะแสดง Feedback รายข้อ คะแนน และจำนวนข้อที่ยังไม่ตอบ
13. สรุปภาพใหญ่: โมเดลอยู่ตรงไหนและต้องตรวจอะไร
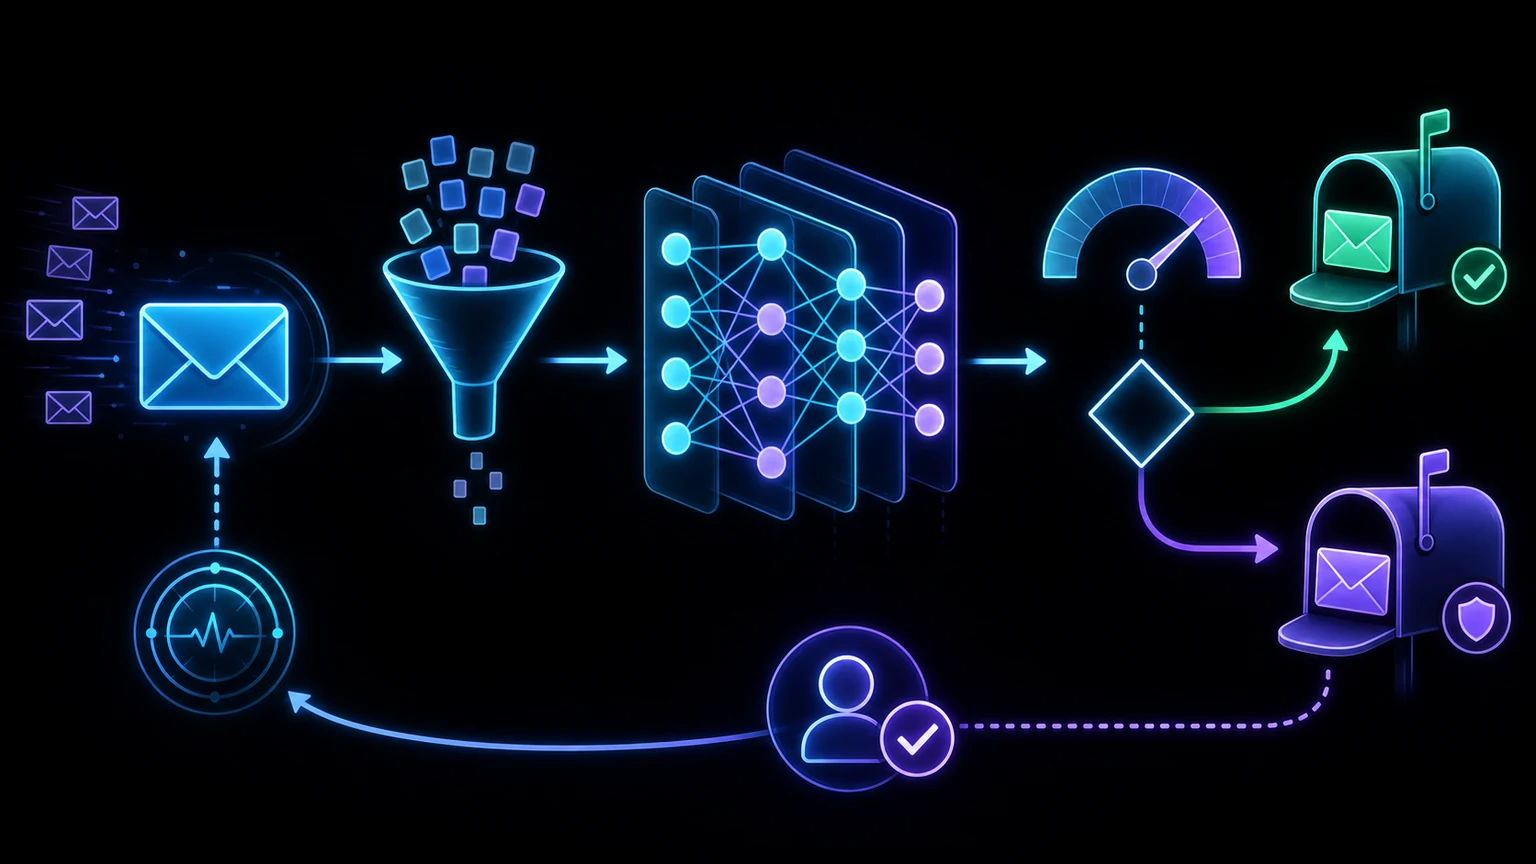
โมเดลคือกลไกที่แปลงอินพุตเป็นผลลัพธ์ด้วยโครงสร้างและพารามิเตอร์ที่ได้จากกระบวนการฝึก การฝึกพยายามลด Loss บนข้อมูลตัวอย่าง ขณะที่ Validation และ Test ช่วยประมาณความสามารถกับข้อมูลที่ไม่ได้ใช้ปรับพารามิเตอร์ แต่คะแนนห้องทดลองไม่รับประกันโลกจริง เพราะข้อมูล คน กฎ และสภาพแวดล้อมเปลี่ยนได้
ผลลัพธ์ของโมเดลยังไม่ใช่คำตัดสินสุดท้าย คะแนนต้องผ่านการแปลความหมาย Calibration Threshold และนโยบาย การตรวจระบบที่ดีจึงมองทั้ง Pipeline เก็บรุ่นและหลักฐาน มีช่องทางกู้คืน ติดตาม Drift และระบุผู้รับผิดชอบ เมื่อเราวาดเส้นแบ่งได้ เราจะเลือกวิธีแก้ได้ตรงชั้นและใช้โมเดลโดยไม่ฝากความรับผิดชอบไว้กับคำว่า AI
Insight Gate: หากคุณอธิบายระบบหนึ่งได้ว่าโมเดลรับอะไร คืนอะไร เรียนจากวัตถุประสงค์ใด คะแนนถูกเปลี่ยนเป็นการกระทำตรงไหน และเมื่อผิดต้องตรวจหลักฐานใด คุณผ่านแก่นของบทเรียนนี้แล้ว
เรียนต่ออย่างเป็นระบบ: ทบทวนบทก่อนหน้า และเก็บแบบฝึก Datasheet ไว้ทดลองกับข้อมูลจริงของคุณ
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงหลัก
- Google for Developers — Machine Learning Glossary
- Google Machine Learning Crash Course — Accuracy, Precision and Recall
- Google Machine Learning Crash Course — Overfitting
- NIST — Artificial Intelligence Risk Management Framework 1.0
- NIST AI RMF Playbook
- Mitchell et al. — Model Cards for Model Reporting
- Sculley et al. — Hidden Technical Debt in Machine Learning Systems
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 6 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 16 · PATH 01 · เนื้อหาเพื่อการศึกษา
