บทก่อนหน้าแสดงให้เห็นว่า AI เชื่อมกับกระบวนการอุตสาหกรรมอย่างไร บทนี้ย้ายมาสู่บริการสาธารณะ ซึ่งความผิดพลาดไม่ได้หมายถึงของเสียหรือเวลาหยุดเครื่องเท่านั้น แต่อาจหมายถึงคนคนหนึ่งพลาดสิทธิหรือไม่รู้ว่าจะขอทบทวนจากใคร
ลองนึกภาพว่าคุณยื่นคำร้องขอสวัสดิการผ่านระบบออนไลน์ เอกสารครบเกือบทั้งหมด แต่เลขรายได้ในฐานข้อมูลหนึ่งยังไม่อัปเดต ระบบ AI เห็นความไม่ตรงกันจึงให้คะแนนความเสี่ยงสูงและส่งคำร้องไปกอง “ตรวจเพิ่ม” จากเดิมที่ควรรอไม่กี่วัน กลายเป็นหลายสัปดาห์ คุณไม่รู้ว่า AI มีบทบาท ไม่รู้ว่าข้อมูลใดผิด และไม่รู้ว่าต้องคุยกับใคร
ปัญหาไม่ได้อยู่ที่ AI “ฉลาดไม่พอ” เพียงอย่างเดียว แต่อยู่ที่การออกแบบบริการทั้งระบบ ตั้งแต่ข้อมูลที่นำเข้า ความหมายของคะแนน วิธีที่เจ้าหน้าที่ใช้คำแนะนำ การแจ้งเหตุผล ไปจนถึงช่องทางให้ประชาชนแก้ข้อมูลและอุทธรณ์
บทเรียนนี้จะใช้กรณี “ระบบคัดกรองคำร้องขอสวัสดิการ” เป็นเส้นเรื่องหลัก กรณีดังกล่าวเป็นสถานการณ์สมมติเพื่อการอธิบาย ไม่ใช่ระบบของหน่วยงานใด เราจะตามคำร้องหนึ่งรายการตั้งแต่ยื่นเอกสาร ผ่าน AI และเจ้าหน้าที่ จนถึงการแจ้งผล อุทธรณ์ และนำข้อผิดพลาดกลับไปปรับบริการ
อ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบายวงจรของ AI ในบริการภาครัฐ ตั้งแต่ Input → Process → Output → Human Review → Feedback ได้
- แยกงานช่วยเจ้าหน้าที่ งานเสนอคำแนะนำ และงานตัดสินใจที่กระทบสิทธิ พร้อมเลือกหลักประกันให้เหมาะกับระดับผลกระทบได้
- ตรวจหาความเสี่ยงจากข้อมูลไม่ครอบคลุม ตัวชี้วัดผิดเป้า และ Automation Bias โดยใช้หลักฐานจากกระบวนการจริงได้
- ออกแบบคำแจ้ง เหตุผล ช่องทางแก้ข้อมูล และการอุทธรณ์ที่ประชาชนใช้งานได้จริง
- วาง Pilot ที่มี Baseline ตัวชี้วัดแยกกลุ่ม ผู้รับผิดชอบ จุดหยุด และแผนกู้คืนได้
AI ในภาครัฐคืออะไร และต่างจากระบบหลังบ้านทั่วไปตรงไหน
ถ้ามองแบบง่ายที่สุด AI ในภาครัฐคือระบบที่ช่วยหน่วยงานมองข้อมูลจำนวนมากแล้วทำงานบางอย่างได้เร็วขึ้น เช่น แยกประเภทเอกสาร อ่านข้อมูลจากแบบฟอร์ม คาดการณ์จำนวนผู้ใช้บริการ หาเหตุการณ์ผิดปกติ จัดลำดับงาน หรือเสนอคำตอบให้เจ้าหน้าที่ แต่คำว่า “ช่วย” ครอบคลุมงานหลายระดับ ตั้งแต่ช่วยสะกดชื่อถนนไปจนถึงเสนอว่าคำร้องใดควรถูกตรวจละเอียด ความแตกต่างของสองงานนี้ไม่ได้อยู่ที่ชื่อโมเดล แต่อยู่ที่ผลกระทบต่อประชาชน
ระบบหลังบ้านของร้านค้าอาจจัดสินค้าผิดหมวดแล้วทำให้ค้นหายาก ส่วนระบบของรัฐอาจจัดคำร้องของคนผิดกลุ่มจนเขาได้รับบริการช้าหรือพลาดกำหนดสำคัญ ภาครัฐยังใช้อำนาจตามกฎหมาย บริหารทรัพยากรสาธารณะ และให้บริการที่บางคนไม่มีทางเลือกอื่นทดแทน ความสะดวกจึงเป็นเพียงหนึ่งเป้าหมาย ต้องวางคู่กับความเสมอภาค ความถูกต้องตามอำนาจหน้าที่ ความเป็นส่วนตัว ความปลอดภัย และกระบวนการที่เป็นธรรม
ศัพท์ที่ควรรู้คือ Automated Decision System หรือระบบตัดสินใจอัตโนมัติ ซึ่งอาจหมายถึงเทคโนโลยีที่ช่วยหรือแทนการใช้ดุลยพินิจของมนุษย์ ไม่จำเป็นต้องเป็น Machine Learning เสมอไป กฎคอมพิวเตอร์ คะแนนความเสี่ยง หรือแบบจำลองสถิติก็อาจอยู่ในกระบวนการเดียวกันได้ ประเด็นสำคัญจึงไม่ใช่ถามว่า “นี่เป็น AI แท้ไหม” แต่ถามว่า “ระบบมีอิทธิพลต่อการตัดสินใจเพียงใด และใครได้รับผล”
ให้จำภาพสามชิ้นไว้ ชิ้นแรกคือ ข้อมูล ซึ่งเป็นสิ่งที่ระบบมองเห็น ชิ้นที่สองคือ แบบจำลองหรือกฎ ซึ่งเปลี่ยนข้อมูลให้เป็นการจัดหมวด คะแนน หรือคำแนะนำ ชิ้นที่สามคือ กระบวนการของคน ซึ่งตีความ ตรวจ ยืนยัน สื่อสาร และรับผิดชอบ หากมองเฉพาะโมเดล เราจะพลาดสาเหตุความผิดพลาดจำนวนมาก เช่น แบบฟอร์มออกแบบไม่ดี เจ้าหน้าที่ไม่มีเวลาตรวจ ระบบหน้าจอเน้นคะแนนจนกลบหลักฐาน หรือไม่มีช่องทางให้ประชาชนแก้ข้อมูล
โมเดลอาจผลิตคะแนน แต่บริการสาธารณะผลิตผลกระทบต่อชีวิตคน เราจึงต้องประเมินทั้งระบบ ไม่ใช่ประเมินความแม่นยำของโมเดลเพียงตัวเดียว
แนวคิดนี้สอดคล้องกับ NIST AI Risk Management Framework ซึ่งจัดการความเสี่ยงผ่านหน้าที่ Govern, Map, Measure และ Manage ตลอดวงจร ไม่ได้มองการทดสอบโมเดลเป็นกิจกรรมครั้งเดียวก่อนเปิดใช้[1] ส่วน UNESCO เน้นว่าความรับผิดชอบสุดท้ายไม่ควรถูกผลักให้ AI และควรมีกลไกกำกับ ประเมินผลกระทบ ตรวจสอบ และติดตามอย่างต่อเนื่อง[3]
สามระดับการใช้งาน: ช่วยงาน เสนอคำแนะนำ และมีอิทธิพลต่อสิทธิ
การพูดรวมว่า “หน่วยงานใช้ AI” ทำให้เราแยกความเสี่ยงไม่ออก ทางที่ดีกว่าคือดูว่า Output ของระบบเดินทางไปถึงประชาชนอย่างไร โดยแบ่งเป็นสามระดับเพื่อใช้คิด ไม่ใช่เพื่อแทนกฎหมายหรือการประเมินผลกระทบของแต่ละประเทศ
| ระดับ | ตัวอย่าง | ความเสี่ยงหลัก | หลักประกันที่ควรมี |
|---|---|---|---|
| ช่วยงานภายใน | ถอดข้อความ จัดหมวดเอกสาร ค้นระเบียบ ร่างคำตอบ | อ่านข้อมูลผิด อ้างเอกสารเก่า เปิดเผยข้อมูลเกินสิทธิ์ | ตรวจต้นฉบับ ระบุแหล่งและวันที่ จำกัดสิทธิ์เข้าถึง แก้ไขได้ก่อนส่ง |
| เสนอคำแนะนำ | จัดลำดับคำร้อง ชี้รายการที่ควรตรวจเพิ่ม พยากรณ์ความต้องการ | คะแนนกลายเป็นคำตัดสินโดยพฤตินัย กลุ่มข้อมูลน้อยถูกมองข้าม | แสดงหลักฐานและความไม่แน่นอน ทดสอบแยกกลุ่ม บันทึกการยอมรับหรือปฏิเสธคำแนะนำ |
| มีอิทธิพลต่อสิทธิ | ช่วยพิจารณาสวัสดิการ ใบอนุญาต การตรวจสอบ หรือมาตรการที่กระทบบุคคล | ปฏิเสธ ล่าช้า หรือตรวจเข้มโดยไม่เป็นธรรม และประชาชนไม่รู้เหตุผล | ประเมินผลกระทบก่อนใช้ มนุษย์ที่มีอำนาจจริง คำอธิบาย ช่องทางแก้ข้อมูล อุทธรณ์ และเยียวยา |
ระดับแรกไม่ได้ปลอดภัยอัตโนมัติ ตัวอย่างเช่นระบบสรุปเอกสารที่ดึงชื่อหรือจำนวนเงินผิดอาจทำให้เจ้าหน้าที่เข้าใจแฟ้มผิด แต่โดยทั่วไปความเสียหายย้อนกลับได้ง่ายกว่าหากผลยังไม่ออกไปถึงประชาชน ระดับที่สองมีความเสี่ยงซ่อนอยู่ เพราะหน้าจออาจเขียนว่า “คำแนะนำเท่านั้น” แต่เจ้าหน้าที่ต้องจัดการงานหลายร้อยรายการและแทบไม่มีเวลาคัดค้าน ระบบจึงกลายเป็นผู้ตัดสินโดยพฤตินัย
ระดับที่สามต้องระวังมากที่สุด เพราะผลอาจแตะสิทธิ ประโยชน์ โอกาส หรือข้อจำกัดที่สำคัญ หลัก “มีมนุษย์อยู่ในวงจร” จะมีความหมายก็ต่อเมื่อมนุษย์เห็นข้อมูลเพียงพอ มีเวลา มีความรู้ มีอำนาจเปลี่ยนผล และไม่ถูกลงโทษเมื่อคัดค้านโมเดล หากเจ้าหน้าที่ทำได้เพียงกดอนุมัติคำแนะนำเดิม การมีชื่อคนอยู่บนหน้าจอยังไม่ใช่การกำกับโดยมนุษย์
มาตรฐานและแนวทางของรัฐบาลแต่ละแห่งอาจกำหนดขอบเขตต่างกัน ตัวอย่างที่ใช้ศึกษาได้คือ Directive on Automated Decision-Making ของรัฐบาลแคนาดา ซึ่งผูกมาตรการกับระดับผลกระทบ และกำหนดเรื่องการประเมินผลกระทบ การมีส่วนร่วมของมนุษย์ คำอธิบาย และทางทบทวนสำหรับระบบที่อยู่ในขอบเขต[5] เราไม่ควรคัดลอกเกณฑ์ไปใช้โดยไม่ดูบริบทไทย แต่โครงคิด “ผลกระทบสูงขึ้น หลักประกันต้องเข้มขึ้น” ใช้เป็นคำถามเริ่มต้นได้ดี
กรณีศึกษาหลัก: คำร้องขอสวัสดิการหนึ่งรายการเดินทางผ่านระบบอย่างไร
ต่อไปนี้เป็น กรณีสมมติเพื่อการเรียนรู้ หน่วยงานหนึ่งต้องรับคำร้องขอสวัสดิการจำนวนมาก เจ้าหน้าที่ใช้เวลาส่วนหนึ่งตรวจว่าเอกสารครบหรือไม่ และต้องค้นข้อมูลจากหลายระบบ หน่วยงานจึงทดลอง AI เพื่อจัดหมวดเอกสาร ดึงข้อมูลสำคัญ และเสนอว่าคำร้องใด “พร้อมพิจารณา” “ต้องขอเอกสารเพิ่ม” หรือ “ควรให้เจ้าหน้าที่ตรวจละเอียด” เป้าหมายที่ประกาศคือช่วยลดเวลารอ โดยไม่ให้ AI อนุมัติหรือปฏิเสธสิทธิเอง
Context และผู้ได้รับผล
ผู้ใช้โดยตรงมีอย่างน้อยสามกลุ่ม กลุ่มแรกคือประชาชนผู้ยื่นคำร้อง ซึ่งต้องการผลที่ถูกต้องและทันเวลา กลุ่มที่สองคือเจ้าหน้าที่หน้าด่าน ซึ่งต้องเข้าใจว่า AI เห็นอะไรและมองข้ามอะไร กลุ่มที่สามคือผู้บริหารบริการ ซึ่งต้องรับผิดชอบทั้งประสิทธิภาพและความเป็นธรรม ยังมีกลุ่มที่ได้รับผลทางอ้อม เช่น ผู้ดูแลครอบครัว เจ้าหน้าที่รับเรื่องร้องเรียน ผู้ตรวจสอบ ผู้จัดหาระบบ และชุมชนที่เข้าถึงอินเทอร์เน็ตไม่เท่ากัน
Input ที่ระบบเห็น
ระบบอาจรับภาพเอกสาร ข้อความจากแบบฟอร์ม ประเภทคำร้อง วันที่ยื่น รายการเอกสารที่แนบ และข้อมูลอ้างอิงจากฐานที่หน่วยงานมีอำนาจใช้ สิ่งที่ระบบไม่เห็นอาจสำคัญพอ ๆ กัน เช่น เหตุที่เอกสารล่าช้า การสะกดชื่อหลายแบบ รายได้ที่เพิ่งเปลี่ยน เอกสารกระดาษที่สแกนไม่ชัด หรือเงื่อนไขชีวิตที่ไม่อยู่ในช่องมาตรฐาน หากข้อมูลบางอย่างไม่มี ไม่ควรตีความอัตโนมัติว่าเหตุการณ์นั้นไม่เกิดขึ้น
Process และ Output
ขั้นประมวลผลอาจประกอบด้วย Optical Character Recognition เพื่ออ่านข้อความ การตรวจความครบถ้วนตามกฎ และโมเดลจัดหมวดคำร้อง ผลที่ได้ไม่ใช่ “คนนี้สมควรได้รับสิทธิ” แต่เป็นข้อมูลช่วยงาน เช่น ช่องที่อ่านได้ รายการที่ไม่แน่ใจ เอกสารที่อาจขาด และคิวที่เสนอให้ตรวจต่อ หน้าจอควรแยกค่าที่อ่านจากต้นฉบับ ค่าที่คำนวณ และข้อสรุปของเจ้าหน้าที่ออกจากกัน เพื่อให้ย้อนกลับได้ว่าความผิดเกิดที่ชั้นใด
Baseline และ Metric
ก่อนทดลองต้องรู้วิธีเดิมทำงานอย่างไร เช่น เวลารอเฉลี่ยและค่ากลาง จำนวนคำร้องที่ถูกส่งกลับเพราะเอกสารไม่ครบ อัตราการแก้ผลหลังร้องเรียน และภาระงานต่อเจ้าหน้าที่ ถ้าวัดเฉพาะ “จำนวนแฟ้มที่ระบบจัดได้ต่อชั่วโมง” เราอาจได้ AI ที่เร็วแต่โยนภาระไปให้ประชาชน เป้าหมายจึงควรรวมเวลารอจนจบกระบวนการ ความถูกต้องของข้อมูล อัตราขอเอกสารซ้ำ ความแตกต่างระหว่างช่องทางออนไลน์กับออฟไลน์ และประสบการณ์ของผู้ใช้
Failure Mode ที่ซ่อนอยู่
ในกรณีของเรา ระบบอ้างข้อมูลรายได้จากฐานที่อัปเดตช้ากว่าเอกสารล่าสุด จึงให้สัญญาณความไม่ตรงกัน หากหน้าจอเน้นแถบสีแดงและซ่อนวันที่ของข้อมูล เจ้าหน้าที่อาจคิดว่าแฟ้มเสี่ยง ทั้งที่ปัญหาอยู่ที่ความสดใหม่ของฐานข้อมูล นี่คือความผิดพลาดของระบบโดยรวม ไม่ใช่เพียงโมเดล เพราะมีทั้งข้อมูลล่าช้า การออกแบบหน้าจอ และขั้นตอนตรวจที่ไม่บังคับให้เทียบวันที่
Human Role ที่มีความหมาย
เจ้าหน้าที่ต้องเปิดต้นฉบับ ดูแหล่งที่มาและวันที่ อ่านคำอธิบายของผู้ยื่น และเลือกได้ว่าจะรับ ปฏิเสธ หรือขอข้อมูลเพิ่มโดยบันทึกเหตุผล หากผลกระทบสูง ควรมีการทบทวนโดยบุคคลที่ไม่ได้เพียงทำซ้ำขั้นตอนเดิม ประชาชนต้องได้รับการแจ้งว่ามีระบบอัตโนมัติช่วยส่วนใด ข้อมูลหลักใดมีอิทธิพล และต้องส่งข้อมูลแก้ไขทางไหน
Monitoring และเงื่อนไขที่ทำให้ข้อสรุปเปลี่ยน
หน่วยงานต้องติดตามว่าเวลารอลดลงจริงหรือไม่ อัตราส่งกลับเพิ่มขึ้นหรือเปล่า กลุ่มใดได้รับผลต่างกัน และเจ้าหน้าที่ Override คำแนะนำบ่อยในกรณีไหน หากระบบเร็วขึ้นแต่คำร้องจากเอกสารกระดาษล่าช้ากว่าเดิม ข้อสรุป “โครงการสำเร็จ” ต้องเปลี่ยน หากพบว่าความผิดพลาดกระทบสิทธิอย่างเป็นระบบ ต้องหยุดส่วนที่เสี่ยง ย้อนกลับไปใช้กระบวนการเดิม และทบทวนผลย้อนหลัง ไม่ใช่รออัปเดตโมเดลรอบถัดไป
วงจรหกขั้นของบริการ AI ที่ตรวจสอบและกู้คืนได้
กรณีศึกษาจะชัดขึ้นเมื่อเราเดินตามวงจรทีละขั้น ทุกขั้นต้องตอบหกคำถาม: รับอะไรเข้า ทำอะไร ส่งอะไรออก ตรวจอย่างไร พลาดแบบใด และย้อนกลับไปแก้ตรงไหน
เริ่มจากภารกิจสาธารณะ ไม่ใช่เริ่มจากโมเดล
รับเข้า: ปัญหาเวลารอ ภาระงาน ข้อร้องเรียน และหน้าที่ตามกฎหมาย กระบวนการ: เขียนเป้าหมายที่วัดผลได้และเปรียบเทียบทางเลือกที่ไม่ใช้ AI ส่งออก: Problem Statement และ Baseline วิธีตรวจ: เป้าหมายสะท้อนผลต่อประชาชน ไม่ใช่เพียงต้นทุนภายใน จุดพลาด: นิยามความสำเร็จว่า “ประมวลผลเร็ว” อย่างเดียว ทางแก้: เพิ่ม Metric คุณภาพ ความเสมอภาค และภาระที่ย้ายไปยังผู้ใช้
กำหนดข้อมูลและสิทธิ์เข้าถึง
รับเข้า: แบบฟอร์ม เอกสาร ฐานข้อมูล และกฎการใช้ข้อมูล กระบวนการ: ระบุแหล่ง ผู้รับผิดชอบ ความสดใหม่ คุณภาพ และระยะเก็บ ส่งออก: Data Map ที่บอกว่าอะไรไหลไปไหน วิธีตรวจ: สุ่มเทียบกับต้นฉบับและทดสอบกลุ่มข้อมูลยาก จุดพลาด: ใช้สิ่งที่หาได้ง่ายแทนสิ่งที่จำเป็น ทางแก้: ลดข้อมูล แยกวัตถุประสงค์ และสร้างทางรับเอกสารนอกระบบดิจิทัล
สร้างคำแนะนำที่เห็นความไม่แน่นอน
รับเข้า: ข้อมูลที่ผ่านการตรวจคุณภาพ กระบวนการ: จัดหมวด ดึงข้อมูล หรือให้คะแนนตามขอบเขต ส่งออก: คำแนะนำพร้อมแหล่งและระดับความเชื่อมั่น วิธีตรวจ: เทียบกับชุดทดสอบและผู้เชี่ยวชาญโดเมน จุดพลาด: แปลงค่าความน่าจะเป็นเป็นคำว่า “ผ่าน/ไม่ผ่าน” แบบแข็ง ทางแก้: แสดงช่วงความไม่แน่นอนและส่งกรณีก้ำกึ่งให้คนตรวจ
ให้เจ้าหน้าที่ตรวจหลักฐานและรับผิดชอบ
รับเข้า: ต้นฉบับ คำแนะนำ และบริบท กระบวนการ: ตรวจความครบถ้วน เปรียบเทียบวันที่ ขอข้อมูลเพิ่ม หรือไม่รับคำแนะนำ ส่งออก: การตัดสินใจของผู้มีอำนาจพร้อมเหตุผล วิธีตรวจ: Audit Log และการสุ่มทบทวน จุดพลาด: เจ้าหน้าที่กดตามคะแนนเพราะหน้าจอหรือแรงกดดันด้านเวลา ทางแก้: ออกแบบหน้าจอให้หลักฐานมาก่อนคะแนน ฝึกอบรม และวัด Override อย่างมีความหมาย
แจ้งผลด้วยภาษาที่คนใช้สิทธิได้
รับเข้า: ผล เหตุผลหลัก ข้อมูลที่ใช้ และช่องทางติดต่อ กระบวนการ: สร้างคำแจ้งที่แยกบทบาท AI กับมนุษย์ ส่งออก: หนังสือหรือข้อความที่เข้าใจได้ วิธีตรวจ: ทดสอบกับผู้ใช้จริงและช่องทางช่วยเหลือ จุดพลาด: ส่งรหัสเหตุผลภายในหรือคำอธิบายกว้างจนโต้แย้งไม่ได้ ทางแก้: บอกข้อมูลและปัจจัยหลัก วิธีแก้ข้อมูล กำหนดเวลา และผู้รับเรื่อง
ติดตาม อุทธรณ์ เยียวยา และปรับระบบ
รับเข้า: ผลจริง คำร้องเรียน การ Override เหตุผิดพลาด และการอุทธรณ์ กระบวนการ: วิเคราะห์ทั้งภาพรวมและแยกกลุ่ม ส่งออก: การแก้รายบุคคล การปรับกระบวนการ หรือการหยุดระบบ วิธีตรวจ: รายงานประจำรอบและผู้ตรวจอิสระเมื่อเหมาะสม จุดพลาด: นับเฉพาะความแม่นยำของโมเดล ทางแก้: วัดเวลาถึงการเยียวยา ผลกระทบสะสม และกรณีที่ระบบไม่ควรทำงานต่อ
NIST ระบุว่าการวัดความเสี่ยงควรรวมทั้งวิธีเชิงปริมาณและเชิงคุณภาพ เปรียบเทียบกับ Baseline และติดตามระบบระหว่างใช้งาน ไม่ใช่เฉพาะก่อนเปิดตัว[2] จุดนี้สำคัญต่อภาครัฐ เพราะบริบทบริการ กฎ ระเบียบ ประชากร และพฤติกรรมเปลี่ยนได้ แม้โมเดลเดิมไม่ถูกแก้เลยก็ตาม
ความโปร่งใสที่ใช้ได้จริงไม่เท่ากับเปิด Source Code ทั้งหมด
เมื่อได้ยินคำว่า “โปร่งใส” หลายคนอาจนึกถึงการเปิดสูตรหรือ Source Code แต่ประชาชนส่วนใหญ่มักต้องการคำตอบที่ใกล้ตัวกว่านั้น: มี AI อยู่ตรงไหน ใช้ข้อมูลอะไร ทำไมผลของฉันจึงเป็นแบบนี้ ใครรับผิดชอบ และฉันทำอะไรต่อได้ การเปิดโค้ดอาจช่วยผู้ตรวจทางเทคนิค แต่ไม่แทนคำอธิบายรายกรณี
โปร่งใสต่อประชาชน
แจ้งว่า AI ทำหน้าที่ใด วัตถุประสงค์คืออะไร ข้อมูลหลักมาจากไหน ผลมีความหมายอย่างไร และช่องทางแก้ข้อมูลหรือร้องขอการทบทวนอยู่ที่ใด ภาษาต้องอ่านรู้เรื่องบนมือถือ เอกสารกระดาษ โทรศัพท์ และช่องทางช่วยเหลือ ไม่ผูกสิทธิไว้กับหน้าเว็บเพียงอย่างเดียว
โปร่งใสต่อเจ้าหน้าที่
หน้าจอต้องแสดงต้นฉบับ แหล่งข้อมูล วันที่ รุ่นระบบ ความไม่แน่นอน และเหตุที่ส่งต่อ พร้อมบอกขอบเขตที่โมเดลไม่เคยถูกทดสอบ เจ้าหน้าที่ต้องรู้ว่าเมื่อใดห้ามใช้ Output และบันทึกเหตุผลเมื่อยอมรับหรือคัดค้านคำแนะนำ
โปร่งใสต่อผู้ตรวจ
เก็บเอกสารวัตถุประสงค์ Data Map การประเมินผลกระทบ ชุดทดสอบ Metric แยกกลุ่ม ประวัติรุ่น Log การเปลี่ยนแปลง เงื่อนไขจัดซื้อ Incident และการแก้ไข เพื่อให้ตรวจย้อนกลับได้ว่าใครตัดสินใจอะไรจากหลักฐานชุดใด
OECD อธิบายความโปร่งใสและ Explainability ว่าควรช่วยให้คนรู้ว่ากำลังมีปฏิสัมพันธ์กับ AI เข้าใจความสามารถและข้อจำกัด รวมถึงได้รับข้อมูลที่เหมาะกับบริบทเกี่ยวกับข้อมูล ปัจจัย กระบวนการ หรือเหตุผล เพื่อเข้าใจและท้าทายผลลัพธ์ได้[4] คำว่า “เหมาะกับบริบท” สำคัญ เพราะคำอธิบายของระบบจัดคิวทั่วไปไม่จำเป็นต้องละเอียดเท่าระบบที่มีอิทธิพลต่อสวัสดิการ
ตัวอย่างเชิงปฏิบัติจากสหราชอาณาจักรคือ Algorithmic Transparency Recording Standard หรือ ATRS ซึ่งจัดรูปแบบให้หน่วยงานเผยแพร่ว่าใช้เครื่องมือเชิงอัลกอริทึมอย่างไรและเพราะเหตุใด[6] บันทึกระดับระบบเช่นนี้ช่วยให้สาธารณะและผู้ตรวจเห็นภาพรวม แต่ยังต้องมีคำอธิบายรายกรณีเมื่อผลกระทบถึงคนหนึ่งคน เพราะรู้ว่าหน่วยงานใช้ระบบอะไรไม่ได้ตอบว่าทำไมคำร้องของเราจึงถูกส่งไปตรวจเพิ่ม
คำอธิบายและสิทธิอุทธรณ์ต้องเปลี่ยนผลได้ ไม่ใช่เป็นเพียงแบบฟอร์ม
คำอธิบายที่มีประโยชน์ไม่จำเป็นต้องเปิดคณิตศาสตร์ทุกชั้น แต่ต้องตอบเหตุหลักของผลลัพธ์ ตัวอย่างเช่น “คำร้องถูกส่งไปตรวจเพิ่มเพราะข้อมูลรายได้จากฐาน A วันที่หนึ่งไม่ตรงกับเอกสาร B วันที่สอง” มีประโยชน์กว่าคำว่า “ระบบพบความเสี่ยงสูง” เพราะผู้ยื่นตรวจได้ว่าฐานใดเก่าและส่งหลักฐานอะไรเพิ่มได้
ควรแยกคำอธิบายสามระดับ ระดับแรกคือ คำอธิบายระบบ บอกวัตถุประสงค์และบทบาทโดยรวม ระดับที่สองคือ คำอธิบายผล บอกปัจจัยสำคัญในกรณีนั้น ระดับที่สามคือ บันทึกตรวจสอบ สำหรับเจ้าหน้าที่หรือผู้ตรวจที่ต้องย้อนดูข้อมูล รุ่น และการดำเนินการ การยัดรายละเอียดเทคนิคทั้งหมดให้ประชาชนไม่ใช่ความโปร่งใส หากทำให้หาเหตุผลสำคัญไม่เจอ
สิทธิอุทธรณ์ที่ใช้งานได้ต้องมีอย่างน้อยหกส่วน: จุดรับเรื่องที่หาเจอ วิธีส่งข้อมูลแก้ไข กำหนดเวลา ผู้ทบทวนที่มีอำนาจจริง การแจ้งสถานะ และการเยียวยาเมื่อพบข้อผิดพลาด การส่งข้อมูลกลับเข้าโมเดลเดิมแล้วคำนวณซ้ำไม่ใช่ Human Review เพราะสมมติฐานและข้อมูลผิดอาจยังอยู่ครบ
ผู้ทบทวนควรเห็นทั้งผลของ AI และหลักฐานต้นฉบับ แต่ไม่ควรถูกครอบด้วยคะแนนเดิมจนไม่กล้าคิดต่าง ในบางกรณีอาจซ่อนคำแนะนำชั่วคราวให้ผู้ทบทวนประเมินหลักฐานก่อน แล้วจึงเปรียบเทียบกับระบบ วิธีนี้ช่วยตรวจ Automation Bias ได้ดีขึ้น แต่ต้องออกแบบตามภาระงานและความเสี่ยงจริง
ช่องทางอุทธรณ์ต้องครอบคลุมคนที่ไม่มีสมาร์ตโฟน ใช้ภาษาอื่น มีความพิการ หรือไม่เข้าใจศัพท์ราชการ การเปิดแบบฟอร์มออนไลน์เพียงหน้าเดียวอาจดูเหมือนมีสิทธิ แต่ในทางปฏิบัติใช้ไม่ได้ นอกจากนี้ต้องไม่ลงโทษคนที่อุทธรณ์ เช่น ทำให้คิวเริ่มนับใหม่โดยไม่มีเหตุ หรือบังคับส่งข้อมูลชุดเดิมซ้ำทั้งที่หน่วยงานถือข้อมูลอยู่แล้ว
Directive ของแคนาดาระบุให้แจ้งทางทบทวนที่ทันเวลา มีประสิทธิผล และเข้าถึงง่ายสำหรับการตัดสินใจที่อยู่ในขอบเขต พร้อมข้อกำหนดเรื่องคำอธิบายและการมีส่วนร่วมของมนุษย์ตามระดับผลกระทบ[5] ส่วน Data and AI Ethics Framework ของสหราชอาณาจักรแนะนำให้สร้างกลไก Feedback ข้อร้องเรียน และ Appeal รวมทั้งติดตามการใช้งานอย่างต่อเนื่อง[7] บทเรียนที่ควรนำมาใช้คือ “อุทธรณ์” ต้องถูกออกแบบเป็นส่วนหนึ่งของระบบตั้งแต่ต้น ไม่ใช่เอกสารที่ค่อยเพิ่มหลังเกิดปัญหา
ข้อมูลที่ไม่ครอบคลุมทำให้บริการดูแม่น แต่ทิ้งบางคนไว้ข้างหลัง
ข้อมูลภาครัฐมักดูน่าเชื่อถือเพราะมาจากฐานทางการ แต่คำว่า “ทางการ” ไม่ได้แปลว่า “ครบ ถูก และเหมาะกับทุกวัตถุประสงค์” ฐานหนึ่งอาจถูกสร้างเพื่อเก็บภาษี อีกฐานเพื่อจ่ายสิทธิ นิยามครัวเรือน รายได้ หรือสถานะอาจต่างกัน การนำข้อมูลไปใช้กับงานใหม่จึงต้องตรวจความหมาย ไม่ใช่เพียงเชื่อมคอลัมน์ที่ชื่อคล้ายกัน
กลุ่มที่ข้อมูลไม่ครอบคลุมอาจไม่ใช่กลุ่มเล็กเสมอไป คนทำงานไม่เป็นทางการ คนย้ายที่อยู่ ผู้ใช้เอกสารกระดาษ ผู้สูงอายุ ชุมชนสัญญาณอ่อน หรือคนที่ชื่อถูกเขียนหลายรูปแบบ อาจปรากฏในข้อมูลน้อยหรือปรากฏแบบผิดรูป หากระบบเรียนจากประวัติที่คนกลุ่มนี้เคยได้รับบริการล่าช้า โมเดลอาจเรียนรู้ความล่าช้านั้นเป็น “รูปแบบปกติ” แล้วทำให้ปัญหาดำรงต่อ
Proxy และตัวชี้วัดที่พาไปผิดทิศ
บางครั้งเราไม่มีข้อมูลของสิ่งที่ต้องการวัด จึงใช้ตัวแทนหรือ Proxy เช่นใช้จำนวนการเข้าเว็บไซต์แทนความต้องการบริการ แต่คนที่ต้องการบริการมากอาจเข้าเว็บไซต์ไม่ได้ หากจัดทรัพยากรตามยอดคลิกเพียงอย่างเดียว พื้นที่ที่ขาดการเข้าถึงยิ่งได้รับทรัพยากรน้อยลง Proxy ไม่ผิดเสมอไป แต่ต้องอธิบายว่าสมมติฐานคืออะไรและตรวจด้วยข้อมูลภาคสนาม
ในกรณีคำร้องสวัสดิการ การใช้ “เอกสารครบในครั้งแรก” เป็นตัวชี้วัดคุณภาพผู้ยื่นอาจไม่เป็นธรรม เพราะความครบขึ้นกับความชัดเจนของแบบฟอร์ม การช่วยเหลือ และความสามารถเข้าถึงเอกสารด้วย หากระบบส่งคนที่เอกสารไม่ครบไปคิวช้า เราอาจวัดความสามารถในการผ่านระบบราชการ แทนที่จะวัดคุณสมบัติของสิทธิ
วัดแยกกลุ่มโดยไม่สร้างความเสี่ยงใหม่
การตรวจผลแยกกลุ่มช่วยมองเห็นความต่าง แต่ข้อมูลอัตลักษณ์มีความอ่อนไหว ต้องมีฐานการใช้ที่เหมาะสม จำกัดสิทธิ์ และหลีกเลี่ยงการสร้างฐานข้อมูลใหม่โดยไม่จำเป็น บางครั้งใช้การศึกษากลุ่มตัวอย่าง การทดสอบสถานการณ์ หรือข้อมูลรวมที่ลดการระบุตัวบุคคลได้ เป้าหมายคือเห็นผลกระทบ ไม่ใช่เก็บข้อมูลให้มากที่สุด
ควรดูทั้งอัตราความผิดพลาดและผลตามมาของความผิดพลาด กลุ่มสองกลุ่มอาจมี Error Rate ใกล้กัน แต่กลุ่มหนึ่งแก้ข้อมูลได้ง่าย ขณะที่อีกกลุ่มต้องเดินทางไกลหรือเสียรายได้เพื่อยื่นใหม่ ผลกระทบจึงไม่เท่ากัน การประเมินความเป็นธรรมต้องฟังผู้ใช้และเจ้าหน้าที่หน้าด่าน ไม่ใช่จบที่ตาราง Metric
Algorithmic Impact Assessment ของรัฐบาลแคนาดาเป็นตัวอย่างหนึ่งที่ถามถึงสิทธิ เสรีภาพ ความเสมอภาค ศักดิ์ศรี ความเป็นส่วนตัว สุขภาวะ ผลทางเศรษฐกิจ ความย้อนกลับได้ ระยะเวลาของผล และประสิทธิภาพต่อผู้ใช้ที่มีอัตลักษณ์หลากหลาย[8] เราไม่จำเป็นต้องใช้แบบประเมินเดียวกัน แต่ควรเห็นว่าความเสี่ยงของบริการสาธารณะกว้างกว่าความแม่นยำเชิงเทคนิค
Automation Bias: เมื่อคำแนะนำของเครื่องกลายเป็นคำตอบโดยไม่รู้ตัว
Automation Bias คือแนวโน้มที่คนให้น้ำหนักกับคำแนะนำของระบบอัตโนมัติมากเกินไป โดยเฉพาะเมื่อระบบดูเป็นทางการ แสดงคะแนนละเอียด หรือเคยถูกโฆษณาว่าแม่นยำ เจ้าหน้าที่อาจหยุดค้นหลักฐานอื่น ยอมรับคำแนะนำที่ผิด หรือมองไม่เห็นกรณีที่ระบบไม่เตือน ปัญหานี้ไม่ใช่การกล่าวโทษว่าเจ้าหน้าที่ขี้เกียจ แต่เกิดจากการผสมกันของเวลา งานค้าง การฝึกอบรม การออกแบบหน้าจอ วัฒนธรรมองค์กร และความรับผิดที่ไม่ชัด
ในกรณีศึกษา แถบสีแดง “เสี่ยงสูง” อาจทำให้เจ้าหน้าที่มองเอกสารด้วยความสงสัยตั้งแต่ต้น ถ้าคะแนนอยู่ด้านบน ตัวใหญ่ และต้นฉบับต้องกดหลายชั้น คะแนนจะชนะการออกแบบ แม้คู่มือเขียนว่าเป็นเพียงคำแนะนำ วิธีลดความเสี่ยงจึงต้องแก้ระบบงาน ไม่ใช่เพิ่มข้อความเตือนเล็ก ๆ
สัญญาณว่า Human-in-the-loop เป็นเพียงพิธีกรรม
- เจ้าหน้าที่เห็นคะแนน แต่ไม่เห็นแหล่งข้อมูล วันที่ หรือความไม่แน่นอน
- การไม่ทำตาม AI ต้องเขียนเหตุผลยาว แต่การทำตามกดครั้งเดียว
- ผู้บริหารวัดความเร็วและอัตราทำตามคำแนะนำ แต่ไม่วัดคุณภาพการทบทวน
- ไม่มีเวลาอ่านต้นฉบับ หรือจำนวนงานต่อคนสูงจนตรวจจริงไม่ได้
- เมื่อเกิดปัญหา ทุกฝ่ายบอกว่า “ระบบแนะนำ” แต่ไม่มีผู้มีอำนาจรับผิดชอบผล
ออกแบบให้มนุษย์คิดได้จริง
หน้าจอควรแสดงหลักฐานสำคัญก่อนสรุป แยกข้อเท็จจริงจากการอนุมาน ระบุข้อมูลที่หาย และให้เจ้าหน้าที่เปิดต้นฉบับได้ในคลิกที่สมเหตุสมผล ควรสุ่มกรณีคะแนนต่ำให้ตรวจเพื่อหา False Negative ไม่ใช่ตรวจแต่คะแนนสูง และสร้างพื้นที่ให้รายงานว่าโมเดลไม่เหมาะกับกรณีใดโดยไม่ถูกมองว่าเป็นความล้มเหลวส่วนบุคคล
การฝึกอบรมควรใช้ Failure Case จริงหรือสถานการณ์จำลอง ให้เจ้าหน้าที่ลองคัดค้านคำแนะนำและเห็นผลของข้อมูลผิด การบอกเพียง “AI อาจผิดได้” กว้างเกินไป คนต้องรู้ว่าผิดแบบใด สัญญาณเตือนคืออะไร และเมื่อใดต้องหยุดกระบวนการ นอกจากนี้ควรวิเคราะห์ Override ทั้งสองด้าน อัตราต่ำผิดปกติอาจแปลว่าเชื่อระบบมากเกินไป อัตราสูงอาจแปลว่าโมเดลไม่มีประโยชน์หรือหน้าจอแสดงไม่ดี
มนุษย์ก็มีอคติและทำผิดได้ เป้าหมายไม่ใช่ยกคนเหนือเครื่องโดยอัตโนมัติ แต่สร้างการตรวจไขว้ที่จุดแข็งของแต่ละฝ่ายช่วยกัน AI เก่งเรื่องค้นรูปแบบสม่ำเสมอจากข้อมูลจำนวนมาก คนเก่งเรื่องบริบท ข้อยกเว้น คุณค่า และความรับผิดชอบ ระบบที่ดีจึงต้องบันทึกทั้งคำแนะนำของ AI เหตุผลของคน และผลจริง เพื่อนำไปเรียนรู้โดยไม่ผลักความผิดให้ฝ่ายใดฝ่ายหนึ่ง
ติดตามผลจริง: ระบบเร็วขึ้น แต่บริการดีขึ้นหรือยัง
หลังเปิด Pilot ตัวเลขที่ดูดีมักมาเร็ว เช่นจำนวนแฟ้มต่อชั่วโมงหรือเวลาประมวลผลของโมเดล แต่ตัวเลขเหล่านี้เป็น System Metric ไม่ใช่ Outcome Metric เสมอไป บริการอาจประมวลผลเร็วขึ้นแต่ประชาชนต้องยื่นเอกสารซ้ำมากขึ้น หรือเจ้าหน้าที่แก้งานหลังบ้านเพิ่มจนเวลารวมไม่ลด
| สิ่งที่วัด | คำถาม | สัญญาณเตือน | การตอบสนอง |
|---|---|---|---|
| ประสิทธิภาพ | เวลาตั้งแต่ยื่นจนจบลดหรือไม่ | โมเดลเร็ว แต่คิวตรวจเพิ่มยาวขึ้น | วัด End-to-end และแยกเวลารอแต่ละขั้น |
| คุณภาพ | ข้อมูลที่ดึงและหมวดที่เสนอถูกเพียงใด | ข้อผิดพลาดซ้ำในเอกสารหรือภาษาบางแบบ | ปรับข้อมูล/ขั้นตอนและเพิ่มทางส่งต่อ |
| ความเป็นธรรม | เวลารอและ Error ต่างกันระหว่างกลุ่มหรือช่องทางหรือไม่ | ผู้ยื่นกระดาษหรือพื้นที่สัญญาณอ่อนช้ากว่าเดิม | เพิ่มบริการช่วยเหลือและแก้ Allocation |
| การใช้คำแนะนำ | เจ้าหน้าที่ Override เมื่อใดและเพราะอะไร | ทำตามเกือบ 100% โดยไม่มีเหตุผล หรือ Override สูงผิดปกติ | ทบทวน UI การฝึก และคุณภาพโมเดล |
| สิทธิและการเยียวยา | ประชาชนขอเหตุผล แก้ข้อมูล และอุทธรณ์ได้เร็วเพียงใด | เรื่องร้องเรียนเพิ่มแต่ไม่มีการเปลี่ยนผล | เสริมผู้ทบทวน แก้คำแจ้ง และตรวจผลย้อนหลัง |
| ความเสื่อม | ข้อมูล กฎ และประชากรเปลี่ยนจนผลลดลงหรือไม่ | Drift หลังนโยบายหรือแบบฟอร์มเปลี่ยน | หยุดส่วนที่เสี่ยง ประเมินใหม่ และออกเวอร์ชัน |
ต้องกำหนด Owner ของแต่ละ Metric คนดูแลโมเดลอาจวัดความแม่นยำ แต่เจ้าของบริการต้องดูเวลารอและผลกระทบ ผู้ดูแลข้อมูลต้องดูความสดใหม่ ทีมรับเรื่องต้องส่งสัญญาณจากข้อร้องเรียน และผู้บริหารต้องมีอำนาจหยุดระบบ การมี Dashboard โดยไม่มีเจ้าของการตอบสนองทำให้เรามองเห็นปัญหาแต่ไม่เปลี่ยนอะไร
Stop Rule ควรถูกกำหนดก่อน Pilot เช่นหากพบการปฏิเสธหรือความล่าช้าที่เกิดจากข้อมูลผิดในระดับที่กำหนด หากระบบส่งผลต่อกลุ่มหนึ่งต่างจาก Baseline อย่างมีนัยสำคัญเชิงบริการ หรือหากไม่สามารถอธิบายผลรายกรณีได้ ต้องหยุด Automation ที่เกี่ยวข้องและกลับสู่ขั้นตอนสำรอง จุดหยุดไม่ใช่สัญญาณว่าโครงการล้มเหลว แต่เป็นเบรกที่พิสูจน์ว่าหน่วยงานควบคุมระบบได้
แผนกู้คืนต้องตอบว่าคิวงานจะไปไหน ใครติดต่อผู้ได้รับผล ข้อมูลรุ่นใดถูกเก็บเพื่อวิเคราะห์ และจะทบทวนผลย้อนหลังได้ไกลแค่ไหน หากไม่มีแผนนี้ การปิดโมเดลอาจทำให้บริการหยุดชะงักจนทีมลังเลที่จะหยุด แม้เห็นความเสี่ยงแล้ว
ความรับผิดชอบของ OECD เน้น Traceability ของข้อมูล กระบวนการ และการตัดสินใจตลอดวงจร รวมถึงการจัดการความเสี่ยงอย่างต่อเนื่องตามบทบาทของผู้เกี่ยวข้อง[9] ในทางปฏิบัติ Traceability ไม่ใช่เก็บ Log ทุกอย่างตลอดไป แต่เก็บสิ่งที่จำเป็นเพื่ออธิบาย ตรวจ และแก้ผล โดยคำนึงถึงความเป็นส่วนตัวและระยะเก็บที่เหมาะสม
Checklist ก่อนทดลอง AI ในบริการภาครัฐ
Checklist นี้ไม่ใช่ตราประทับว่า “ปลอดภัยแล้ว” แต่เป็นคำถามหยุดคิดก่อนนำระบบไปแตะชีวิตคน แต่ละข้อควรมีเอกสารหรือหลักฐาน ไม่ใช่ตอบว่า “มี” จากความรู้สึก
- ภารกิจและฐานอำนาจ: ระบุปัญหาสาธารณะ อำนาจหน้าที่ วัตถุประสงค์ และเหตุผลว่าทำไม AI ดีกว่าการปรับกระบวนการแบบไม่ใช้ AI หากตอบไม่ได้ ให้หยุดที่การออกแบบบริการก่อน
- ขอบเขต Output: เขียนชัดว่า AI ทำอะไร ห้ามทำอะไร และผลใดต้องมีมนุษย์อนุมัติ หากคำว่า “ช่วยตัดสินใจ” กว้างเกินไป ให้แตกเป็นการจัดหมวด คะแนน คำแนะนำ และการตัดสินใจ
- Baseline: มีข้อมูลของวิธีเดิมทั้งเวลา คุณภาพ ความผิดพลาด ความแตกต่างระหว่างกลุ่ม และต้นทุนต่อประชาชน หากไม่มี Baseline จะพิสูจน์ไม่ได้ว่าระบบดีขึ้น
- Data Map: รู้แหล่ง เจ้าของ วันที่ ความสดใหม่ ความหมาย สิทธิ์เข้าถึง ระยะเก็บ และกลุ่มที่ข้อมูลไม่ครอบคลุม หากฐานสองแห่งใช้คำเดียวกันคนละความหมาย ต้องแก้ก่อนเชื่อม
- Impact Assessment: ประเมินผลต่อสิทธิ โอกาส ความเป็นส่วนตัว ความเสมอภาค ศักดิ์ศรี สุขภาวะ และความย้อนกลับได้ พร้อมรับฟังผู้ได้รับผล ไม่ใช่ประเมินโดยทีมเทคนิคฝ่ายเดียว
- Human Authority: ระบุชื่อบทบาทที่รับผิดชอบ เห็นหลักฐาน มีเวลา มีอำนาจ Override และรู้วิธีหยุด หากคนเพียงกดตามระบบ ข้อนี้ยังไม่ผ่าน
- Explanation and Notice: เตรียมคำแจ้งว่ามี AI ส่วนไหน ข้อมูลหรือปัจจัยหลักคืออะไร วิธีแก้ข้อมูล และขอทบทวนอย่างไร ทดสอบว่าคนทั่วไปอ่านแล้วทำขั้นต่อไปได้
- Appeal and Remedy: มีช่องทางออนไลน์และออฟไลน์ กำหนดเวลา ผู้ทบทวนอิสระจากการตัดสินเดิม และแผนเยียวยาผลย้อนหลัง หากอุทธรณ์แล้วกลับเข้าโมเดลเดิมอย่างเดียว ยังไม่ผ่าน
- Security and Privacy: จำกัดข้อมูลและสิทธิ์ ป้องกันการแก้ไขโดยมิชอบ บันทึกการเข้าถึง และมีแผน Incident โดยไม่ใช้การเก็บทุกอย่างเป็นคำตอบเริ่มต้น
- Testing: ทดสอบสภาพจริง เอกสารยาก ภาษาและช่องทางต่าง ๆ กรณีก้ำกึ่ง Failure Case และผลแยกกลุ่ม พร้อมระบุสิ่งที่ยังไม่ได้ทดสอบ
- Monitoring Owner: ทุก Metric มีคนดู ความถี่ เกณฑ์เตือน และการตอบสนอง ไม่สร้าง Dashboard ที่ไม่มีใครมีหน้าที่ลงมือ
- Stop and Recovery: มีกฎหยุด ขั้นตอนกลับไปใช้วิธีเดิม การแจ้งผู้ได้รับผล การเก็บหลักฐาน และผู้อนุมัติ Restart หากหยุดไม่ได้ ระบบยังไม่พร้อมเปิด
- Procurement: สัญญาต้องให้หน่วยงานตรวจข้อมูล รุ่น ประสิทธิภาพ Incident การเปลี่ยนแปลง และการเลิกใช้ได้ ไม่ปล่อยให้คำว่า “ความลับทางการค้า” ปิดกั้นความรับผิดชอบทั้งหมด
- Sunset Review: กำหนดวันทบทวนว่าระบบยังจำเป็นหรือไม่ ไม่ถือว่าซื้อแล้วต้องใช้ตลอดไป หากประโยชน์ไม่ชัดหรือความเสี่ยงสูงขึ้น ต้องลดขอบเขตหรือยุติ
Success Signal: หน่วยงานตอบทุกข้อด้วยเอกสาร ชื่อผู้รับผิดชอบ Metric และขั้นตอนกู้คืนที่ทดลองได้ Recovery Step: หากข้อใดตอบไม่ได้ ให้ลด Pilot เป็น Shadow Mode ซึ่งระบบคำนวณแต่ยังไม่ส่งผลต่อคิวหรือสิทธิ แล้วเก็บหลักฐานเพิ่มก่อนขยาย
ความเข้าใจผิดที่ทำให้ระบบดูพร้อมกว่าความจริง
“AI ไม่ตัดสิน คนเป็นคนกด จึงไม่มีความเสี่ยง”
กลไกที่ทำให้คิดเช่นนั้น: เราเห็นขั้นตอนสุดท้ายว่ามีชื่อเจ้าหน้าที่ จึงสรุปว่าคนควบคุมทุกอย่าง สิ่งที่ถูกต้อง: คำแนะนำ การจัดลำดับ หน้าจอ และแรงกดดันด้านเวลาสามารถกำหนดผลโดยพฤตินัย วิธีตรวจ: ดูอัตรา Override เวลาเฉลี่ยที่ใช้ต่อแฟ้ม และสัมภาษณ์ว่าเจ้าหน้าที่เข้าถึงหลักฐานใดก่อนตัดสิน
“ข้อมูลมาจากรัฐ จึงถูกและเป็นกลาง”
กลไกที่ทำให้คิดเช่นนั้น: ฐานทางการมีรูปแบบและเจ้าของชัด จึงดูน่าเชื่อถือ สิ่งที่ถูกต้อง: ข้อมูลอาจเก่า สร้างเพื่อวัตถุประสงค์อื่น หรือสะท้อนการเข้าถึงบริการที่ไม่เท่ากัน วิธีตรวจ: เทียบความหมาย วันที่ และอัตราผิดกับต้นฉบับ รวมทั้งสุ่มกรณีจากช่องทางและกลุ่มที่ต่างกัน
“ความแม่นยำ 95% แปลว่าพร้อมใช้”
กลไกที่ทำให้คิดเช่นนั้น: ตัวเลขเดียวเปรียบเทียบง่าย สิ่งที่ถูกต้อง: ต้องรู้ว่าทดสอบกับใคร ค่าผิด 5% กระทบอะไร กระจุกในกลุ่มใด และมีทางแก้หรือไม่ วิธีตรวจ: ดู Confusion Matrix แยกกลุ่ม Failure Case Baseline และผลทางบริการ ไม่ใช้ Accuracy เดี่ยว
“เปิด Source Code แล้วถือว่าโปร่งใส”
กลไกที่ทำให้คิดเช่นนั้น: โค้ดดูเหมือนเปิดทุกอย่าง สิ่งที่ถูกต้อง: ประชาชนยังต้องรู้บทบาท ข้อมูล ปัจจัย เหตุผล ผู้รับผิดชอบ และทางทักท้วง ส่วนผู้ตรวจต้องมีข้อมูลรุ่นและการใช้งานจริง วิธีตรวจ: ให้ผู้ใช้ลองอ่านคำแจ้งแล้วบอกขั้นตอนแก้ผล หากทำไม่ได้ ความโปร่งใสยังไม่ครบ
“Pilot เล็กจึงไม่ต้องมีทางอุทธรณ์”
กลไกที่ทำให้คิดเช่นนั้น: ทีมมอง Pilot เป็นการทดลองทางเทคนิค สิ่งที่ถูกต้อง: ถ้า Output เปลี่ยนคิว การตรวจ หรือบริการของคนจริง ผลกระทบก็จริง วิธีตรวจ: แยก Shadow Mode ที่ไม่เปลี่ยนผลออกจาก Pilot ที่แตะกระบวนการจริง แล้ววางสิทธิและการเยียวยาตามผลกระทบ
ลงมือทำ: ออกแบบบริการคัดกรองคำร้องให้ตรวจสอบได้
Worksheet 30–45 นาที
เลือกบริการสาธารณะหนึ่งรายการที่คุณรู้จัก อาจเป็นการยื่นคำร้อง ขอใบอนุญาต นัดหมาย แจ้งเหตุ หรือค้นข้อมูล ห้ามใช้ข้อมูลส่วนบุคคลจริงของผู้อื่น ให้เขียนบนกระดาษหรือเอกสารเปล่าตามหกช่องนี้
1. ภารกิจและ Baseline
ปัญหาที่คนเจอคืออะไร วิธีเดิมใช้เวลากี่ขั้น ใครได้รับผล และอะไรคือความสำเร็จที่มากกว่า “เร็วขึ้น” ระบุ Metric ของประชาชนอย่างน้อยสองตัว
2. Input และสิ่งที่หาย
รายการข้อมูลที่ระบบเห็น แหล่งและวันที่ จากนั้นเขียนข้อมูลสำคัญที่อาจไม่อยู่ในฐานอย่างน้อยสามข้อ พร้อมกลุ่มที่มีโอกาสถูกมองข้าม
3. AI ทำอะไรและห้ามทำอะไร
เขียน Output ให้เฉพาะเจาะจง เช่น “เสนอหมวดเอกสาร” ไม่ใช้คำกว้างว่า “ช่วยตัดสินใจ” แล้วขีดเส้นงานที่ต้องให้มนุษย์รับผิดชอบ
4. Human Review
ใครเห็นต้นฉบับ ใครมีอำนาจ Override ต้องใช้หลักฐานอะไร และจะป้องกัน Automation Bias จากหน้าจอ เวลา และแรงกดดันอย่างไร
5. Notice และ Appeal
เขียนคำแจ้งไม่เกินห้าบรรทัดที่บอกบทบาท AI ปัจจัยหลัก วิธีแก้ข้อมูล และช่องทางทบทวน จากนั้นเพิ่มทางเลือกออฟไลน์หนึ่งช่องทาง
6. Monitor และ Stop
เลือก Metric ประสิทธิภาพ คุณภาพ ความเป็นธรรม และสิทธิอย่างละหนึ่งตัว กำหนดเจ้าของ เกณฑ์เตือน Stop Rule และขั้นตอนกลับไปใช้วิธีเดิม
หลักฐานว่าทำสำเร็จ
ผู้อื่นอ่าน Worksheet แล้ววาดเส้นทาง Input → AI Output → Human Decision → Notice/Appeal → Monitoring ได้โดยไม่ต้องเดา และตอบได้ว่าเมื่อระบบผิด ใครหยุด ใครแก้ผลรายบุคคล และประชาชนติดต่อที่ใด
คำถามอธิบาย Why/How
- เหตุใด Output ที่เลือกจึงควรเป็นคำแนะนำ ไม่ใช่คำตัดสินอัตโนมัติ
- ข้อมูลที่หายจะทำให้เกิดผลผิดแบบใด และใครรับต้นทุนมากที่สุด
- Human Review ของคุณมีอำนาจและเวลาเพียงพอจริงหรือไม่
- คำอธิบายช่วยให้ประชาชนเปลี่ยนสถานการณ์ได้อย่างไร
- Metric ใดอาจดูดีแต่ซ่อนผลเสีย และคุณจะจับมันอย่างไร
Recovery Step
ถ้าออกแบบไม่ได้เพราะยังไม่รู้ข้อมูลหรือกฎ ให้ลดขอบเขตเหลือ Observation Task: เดินตามกระบวนการเดิมหนึ่งรอบ จดจุดส่งต่อ จุดรอ ข้อมูลที่กรอกซ้ำ และเหตุที่เจ้าหน้าที่ต้องใช้ดุลยพินิจ จากนั้นกลับมาเติมเฉพาะช่อง 1–3 ก่อน อย่าเลือกโมเดลจนกว่าจะเห็นปัญหาและ Baseline ชัด
แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่ดีที่สุดให้ครบ แล้วกด “ตรวจคำตอบ” ระบบจะแสดงคะแนนรวม เฉลย เหตุผลรายข้อ และจำนวนข้อที่ยังไม่ได้ตอบ แบบทดสอบนี้วัดการใช้เหตุผลจากกลไก ไม่ใช่การจำคำศัพท์
สรุป: บริการที่รับผิดชอบไม่ได้ถามเพียงว่า AI แม่นไหม
กลับไปที่คำร้องสวัสดิการในตอนต้น ความล่าช้าไม่ได้เกิดจากโมเดลตัวเดียว ข้อมูลรายได้เก่า หน้าจอที่เน้นคะแนน ขั้นตอนที่ไม่บังคับตรวจวันที่ และช่องทางอุทธรณ์ที่ไม่ชัดร่วมกันสร้างผลกระทบ การแก้จึงต้องตามวงจรทั้งเส้น ไม่ใช่เพียงฝึกโมเดลใหม่แล้วหวังว่าทุกอย่างจะดีขึ้น
AI ในภาครัฐสร้างคุณค่าได้เมื่อช่วยลดงานซ้ำ ค้นข้อมูล จัดลำดับ และเสนอทางเลือก แต่ Output ต้องอยู่ในขอบเขตที่สัมพันธ์กับผลกระทบ ยิ่งแตะสิทธิ โอกาส หรือบริการจำเป็น ยิ่งต้องเห็นหลักฐาน ความไม่แน่นอน ความแตกต่างระหว่างกลุ่ม และผู้รับผิดชอบที่มีอำนาจจริง
Mental Model ที่ควรจำมีห้าจุด: ประชาชนยื่นข้อมูล → AI ช่วยแนะนำ → คนตรวจและตัดสิน → แจ้งเหตุผลพร้อมอุทธรณ์ → ติดตามผลและปรับระบบ หากวงจรขาดจุดใดจุดหนึ่ง โดยเฉพาะคนรับผิดชอบหรือทางทักท้วง ระบบอาจเร็วขึ้นแต่บริการยังไม่ชอบธรรม
ก่อนเรียกระบบว่า “สำเร็จ” ให้ถามสามคำถามสุดท้าย: คนที่ได้รับผลรู้หรือไม่ว่าเกิดอะไรขึ้น เขาเปลี่ยนผลที่ผิดได้หรือไม่ และหน่วยงานหยุดหรือย้อนกลับระบบได้หรือไม่ ถ้าคำตอบยังไม่ชัด งานยังไม่จบ
ภาพสรุป: วงจร AI ภาครัฐที่ประชาชนทักท้วงได้
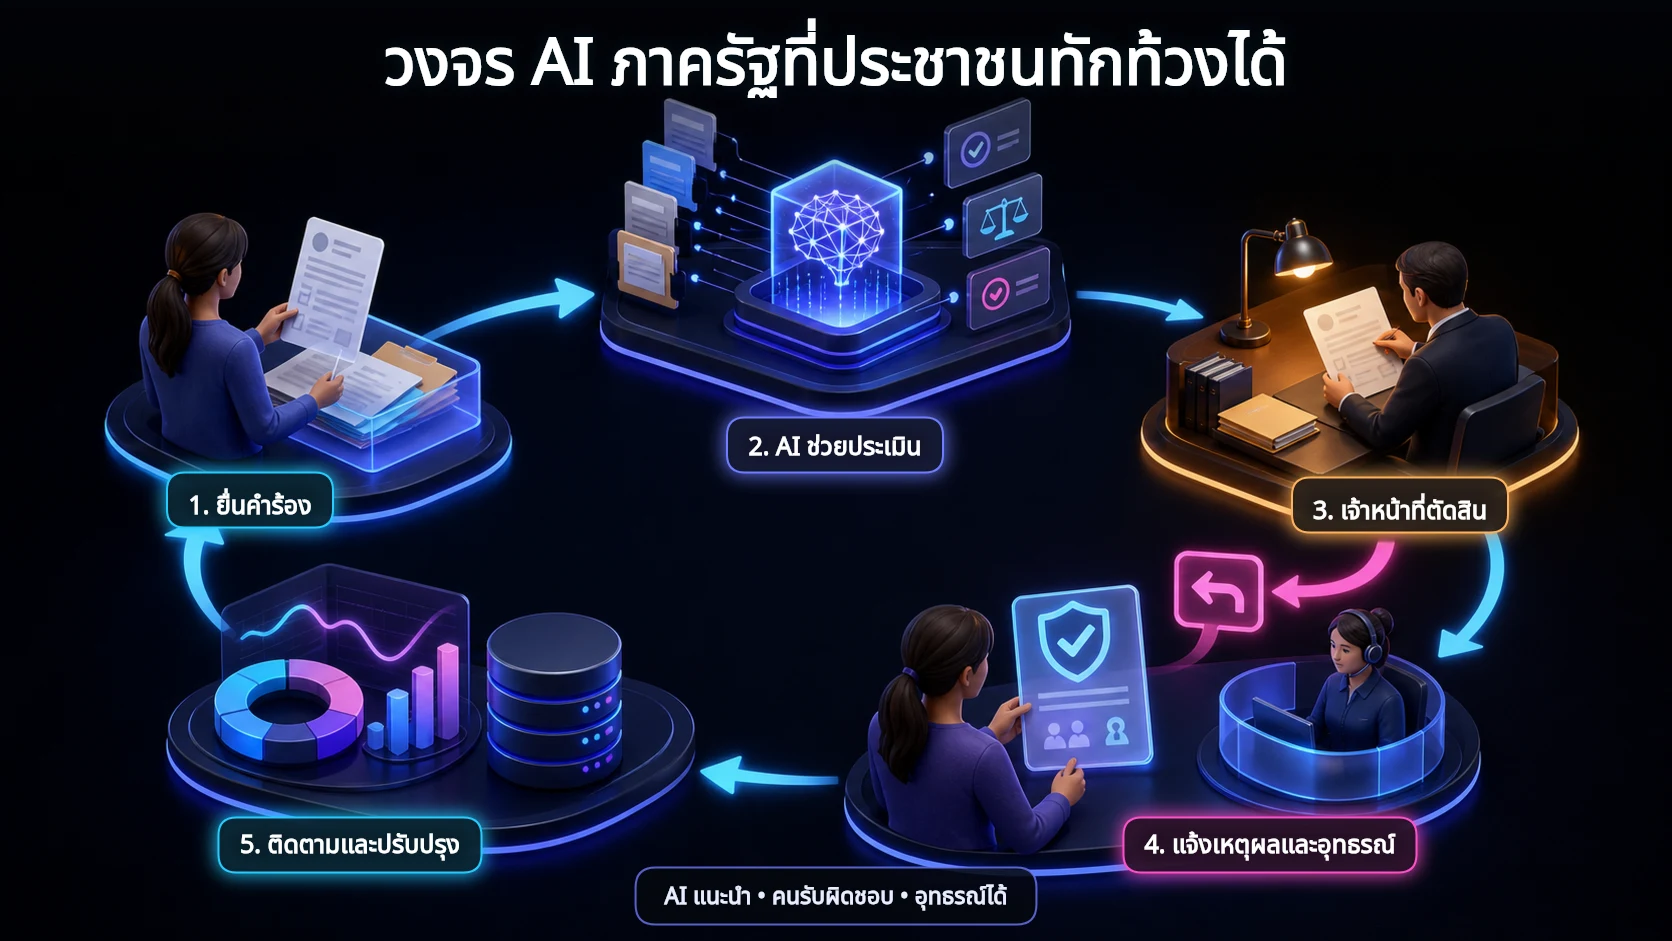
ภาพประกอบต้นฉบับสำหรับบทเรียนหัวข้อ 22 · เวอร์ชัน 2 · ปรับองค์ประกอบและคำกำกับเพื่อการศึกษา
เรียนต่ออย่างมีทิศทาง
บทถัดไปจะย้ายจากบริการสาธารณะไปสู่ AI ในงานความมั่นคง ซึ่งต้องแยก “สัญญาณเตือน” ออกจาก “หลักฐาน” และชั่งน้ำหนักความปลอดภัยกับสิทธิให้รอบคอบกว่าเดิม หากต้องการเห็นภาพรวมและลำดับหัวข้อทั้งหมด ให้กลับไปยัง Learning Pack PATH 01
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงและหมายเหตุบรรณาธิการ
- NIST — Artificial Intelligence Risk Management Framework (AI RMF 1.0) ใช้รองรับกรอบจัดการความเสี่ยงตลอดวงจร
- NIST AI Resource Center — AI RMF Core ใช้รองรับ Govern, Map, Measure และ Manage รวมถึงการทดสอบและติดตามระหว่างใช้งาน
- UNESCO — Recommendation on the Ethics of Artificial Intelligence ใช้รองรับ Human Oversight, Accountability, Fairness และ Impact Assessment
- OECD AI Principle — Transparency and Explainability ใช้รองรับการแจ้งบทบาท AI คำอธิบาย และความสามารถในการท้าทายผลลัพธ์
- Government of Canada — Directive on Automated Decision-Making ใช้เป็นตัวอย่างกรอบภาครัฐเรื่องระดับผลกระทบ Human Involvement คำอธิบาย และ Recourse
- UK Government — Algorithmic Transparency Recording Standard Hub ใช้เป็นตัวอย่างการเปิดเผยว่าเครื่องมือเชิงอัลกอริทึมถูกใช้ในภาครัฐอย่างไรและเพราะเหตุใด
- UK Government — Data and AI Ethics Framework ใช้รองรับ Feedback, Complaints, Appeals และ Monitoring
- Government of Canada — Algorithmic Impact Assessment Tool ใช้เป็นตัวอย่างมิติผลกระทบและมาตรการตามความเสี่ยง
- OECD AI Principle — Accountability ใช้รองรับ Traceability และการจัดการความเสี่ยงตลอดวงจร
ตรวจข้อเท็จจริงและทบทวนภาษาไทยล่าสุด: 8 สิงหาคม 2026 · ตัวอย่างระบบคัดกรองคำร้องในบทเรียนเป็นสถานการณ์สมมติเพื่อการอธิบาย · เนื้อหานี้ไม่ใช่คำแนะนำทางกฎหมายหรือนโยบายเฉพาะหน่วยงาน
