ลองนึกภาพพฤติกรรมค้นหาข้อมูลเมื่อไม่กี่ปีก่อน หากเราอยากรู้ว่า “Local LLM ต่างจาก Cloud AI อย่างไร” สิ่งที่ทำแทบอัตโนมัติคือเปิด Google พิมพ์คำค้นสั้น ๆ แล้วไล่เปิดลิงก์ทีละหน้า เราต้องเป็นคนเปรียบเทียบว่าใครอธิบายตรงคำถามที่สุด ใครมีข้อมูลล่าสุด และใครน่าเชื่อถือพอที่จะนำไปใช้ต่อ กระบวนการทั้งหมดนี้มีเว็บเพจเป็นปลายทางหลัก และการชนะในสนาม Search จึงผูกกับคำถามคลาสสิกว่าเว็บไซต์ของเราอยู่ “อันดับที่เท่าไร” บนหน้าผลการค้นหา
แต่ในปี 2026 ภาพนั้นกำลังเปลี่ยนอย่างเห็นได้ชัด ผู้ใช้จำนวนมากไม่ได้เริ่มต้นด้วยคำค้นสั้น ๆ อีกต่อไป พวกเขาถามเป็นประโยคยาว ใส่เงื่อนไขหลายข้อ ขอให้เปรียบเทียบ ขอเหตุผล ขอขั้นตอน และถามต่อเนื่องเหมือนกำลังสนทนากับผู้ช่วยส่วนตัว Google มี AI Overviews และ AI Mode, Microsoft มี Copilot Search, OpenAI มี ChatGPT Search และ Perplexity สร้างประสบการณ์ค้นหาแบบตอบเป็นคำตอบพร้อมแหล่งอ้างอิงมาตั้งแต่ต้น สิ่งที่ผู้ใช้เห็นจึงไม่ใช่เพียงรายการลิงก์ แต่เป็น “คำตอบที่สังเคราะห์มาแล้ว” พร้อมลิงก์บางส่วนที่ระบบเห็นว่ามีประโยชน์ต่อการตรวจสอบหรืออ่านต่อ [1][5][8][11]
การเปลี่ยนผ่านนี้ทำให้คำถามของเจ้าของเว็บไซต์เปลี่ยนไปด้วย จากเดิมที่ถามว่า “ทำอย่างไรให้ติดหน้าแรก” เราเริ่มถามว่า “ทำอย่างไรให้ AI มองเห็นเนื้อหาของเรา เลือกเราเป็นแหล่งข้อมูล และอ้างอิงเราในคำตอบ” คำว่า Generative Engine Optimization หรือ GEO จึงได้รับความสนใจอย่างรวดเร็ว บางบทความถึงขั้นประกาศว่า GEO คือผู้มาแทน SEO แต่หากดูจากหลักฐานจริง ภาพไม่ได้ตรงไปตรงมาขนาดนั้น งานวิจัยยุคแรกแสดงให้เห็นว่าการปรับรูปแบบข้อความบางชนิดสามารถเพิ่ม visibility ภายในสภาพแวดล้อมทดลองได้ แต่บทสำรวจงานวิจัยในปี 2026 เตือนว่าผลเหล่านี้ไม่ได้เท่ากับการพิสูจน์ว่าเว็บเพจจะถูกค้นพบแบบ organic มากขึ้น หรือจะได้ traffic เพิ่มขึ้นอย่างยั่งยืนในทุกแพลตฟอร์ม [13][14]
บทความนี้จึงตั้งใจตอบคำถามให้ลึกกว่าคำว่า “GEO คืออะไร” เราจะเริ่มตั้งแต่ AI Search ทำงานต่างจาก Search แบบเดิมอย่างไร ไปจนถึง Retrieval-Augmented Generation (RAG), query fan-out, การเลือกแหล่งอ้างอิง, zero-click behavior, ความสัมพันธ์ระหว่าง SEO, AEO และ GEO รวมถึงสิ่งที่เจ้าของเว็บไซต์ควรลงมือทำจริงในปี 2026 และสิ่งใดที่ยังควรถือเป็นเพียงสมมติฐาน ไม่ใช่กฎของอัลกอริทึม เป้าหมายไม่ใช่การหาสูตรลับสำหรับหลอก AI แต่คือการสร้างเนื้อหาที่ทั้งมนุษย์อ่านแล้วได้ประโยชน์ และระบบค้นคืนข้อมูลสามารถเข้าใจ ตรวจสอบ และนำไปใช้ได้ง่ายขึ้น
- อธิบายความต่างระหว่าง Search แบบจัดอันดับลิงก์กับ AI Search แบบสังเคราะห์คำตอบ
- วินิจฉัยได้ว่าหน้าเว็บติดอยู่ที่ Access, Indexing, Retrieval, Reranking, Context หรือ Citation
- วาง SEO, AEO และ GEO เป็นระบบเดียวกันโดยไม่หลงคำโฆษณาเรื่องสูตรลับ
- ออกแบบการทดลองและ KPI ที่วัดซ้ำได้ก่อนลงทุนกับเครื่องมือ GEO
AI Search คืออะไร และทำไมจึงไม่ใช่แค่ “Google ที่มี Chatbot แปะอยู่ด้านบน”
AI Search คือประสบการณ์ค้นหาที่ใช้โมเดลภาษาหรือโมเดลหลายรูปแบบเข้ามาช่วยตีความคำถาม วางแผนการค้นคืนข้อมูล รวบรวมหลักฐานจากหลายแหล่ง แล้วสังเคราะห์ออกมาเป็นคำตอบที่อ่านต่อเนื่องได้ แทนที่จะบังคับให้ผู้ใช้เปิดสิบลิงก์แล้วประกอบคำตอบเอง จุดเปลี่ยนสำคัญจึงอยู่ที่บทบาทของระบบ จากเดิม Search Engine ทำหน้าที่ “จัดอันดับเอกสาร” เป็นหลัก ไปสู่ระบบที่ทำหน้าที่ทั้งค้นคืน ประเมิน และเรียบเรียงข้อมูลให้ผู้ใช้ในชั้นเดียวกัน
Google อธิบายว่า AI Mode สามารถใช้เทคนิค query fan-out โดยแตกคำถามหนึ่งข้อออกเป็นคำถามย่อยหลายหัวข้อ แล้วค้นหลายแหล่งพร้อมกัน ก่อนนำข้อมูลกลับมาประกอบเป็นคำตอบ [1][5] นี่ต่างจากภาพจำของ SEO แบบเดิมที่เรามักคิดเป็น keyword เดียวต่อ SERP เดียว เพราะ query หนึ่งครั้งใน AI Mode อาจทำให้เกิด retrieval หลายรอบในเบื้องหลัง และแต่ละรอบอาจเจอเว็บไซต์คนละชุดกัน
ChatGPT Search มีตรรกะคล้ายกันในภาพรวม แต่รายละเอียดเป็นของ OpenAI เอง เอกสารช่วยเหลือของ OpenAI ระบุว่าเมื่อใช้ผู้ให้บริการค้นหาภายนอก ระบบอาจเขียนคำถามของผู้ใช้ใหม่เป็นคำค้นเจาะจงหนึ่งหรือหลายรายการ แล้วส่งคำค้นเหล่านั้นไปยัง search providers เพื่อช่วยหาแหล่งข้อมูลที่เกี่ยวข้อง [8] ผู้ใช้จึงสามารถถามด้วยภาษาธรรมชาติยาว ๆ ขณะที่ระบบภายในอาจแปลงคำถามนั้นเป็นชุด search queries ที่มีรูปแบบต่างจากข้อความต้นฉบับอย่างมาก
Microsoft อธิบาย Copilot Search ใน Bing ว่าเป็นการผสม traditional search กับ generative search โดยระบบอ่าน รวบรวม และให้เหตุผลจากข้อมูลบนเว็บ พร้อมแสดงแหล่งที่มาที่ใช้สร้างคำตอบ [11] ส่วน Perplexity วาง citations เป็นส่วนกลางของประสบการณ์ตั้งแต่เริ่มต้น และถึงขั้นสร้าง Publishers Program เพื่อเชื่อมความสัมพันธ์กับผู้ผลิตเนื้อหา [12] แม้แต่ละระบบมี UX และวิธีเลือกแหล่งข้อมูลต่างกัน แต่ทิศทางร่วมคือผู้ใช้คาดหวัง “คำตอบ” ก่อน “รายการลิงก์” มากขึ้น
จุดนี้สำคัญมากต่อเจ้าของเว็บไซต์ เพราะหน้าที่ของเว็บไม่ใช่เพียงเป็นปลายทางที่ผู้ใช้คลิกเข้าไปอ่าน แต่ยังอาจกลายเป็นหน่วยความรู้ที่ระบบนำไปอ้างอิงหรือใช้ประกอบคำตอบ โดยที่ผู้ใช้บางส่วนอาจไม่คลิกเข้ามาเลย ดังนั้น visibility ในยุค AI Search จึงกว้างกว่า traffic และ traffic เองก็ต้องถูกตีความใหม่
จากคำค้นสั้น ๆ สู่บทสนทนา: พฤติกรรมผู้ค้นหากำลังเปลี่ยนอย่างไร
Search แบบเดิมสอนให้ผู้ใช้คิดเป็น keyword เพราะเรารู้ว่าการพิมพ์ประโยคยาวเกินไปอาจทำให้ผลลัพธ์กระจัดกระจาย ผู้ใช้จึงย่อความต้องการให้เหลือคำอย่าง “local llm thai”, “best pdf ai” หรือ “seo 2026” แล้วค่อยปรับ query ทีละรอบ แต่ generative search สนับสนุนพฤติกรรมตรงกันข้าม ผู้ใช้สามารถระบุเงื่อนไขเต็มรูป เช่น “ช่วยเปรียบเทียบ Local LLM 3 ตัวที่เหมาะกับภาษาไทย ใช้ RTX 16GB ได้ และขอข้อดีข้อเสียสำหรับงานองค์กรที่ต้องรักษาความลับ” จากนั้นถามต่อว่า “ถ้าเน้น RAG ล่ะ” โดยไม่ต้องเริ่มใหม่
Google รายงานในเดือนพฤษภาคม 2026 ว่า AI Mode มีผู้ใช้งานรายเดือนทั่วโลกมากกว่าหนึ่งพันล้านราย และปริมาณ query เพิ่มขึ้นมากกว่าสองเท่าในแต่ละไตรมาสนับจากเปิดตัว ขณะที่ AI Overviews มีขนาดการใช้งานใหญ่กว่านั้น [4][5] ตัวเลขจากบริษัทผู้ให้บริการควรอ่านในฐานะข้อมูลจากเจ้าของแพลตฟอร์ม ไม่ใช่งานสำรวจอิสระ แต่ก็สะท้อนชัดว่าประสบการณ์ค้นหาแบบ AI ไม่ใช่ฟีเจอร์ทดลองขนาดเล็กอีกต่อไป
ผลกระทบที่สำคัญที่สุดคือ search intent มีความละเอียดขึ้น เราไม่ควรคิดเพียง informational, navigational, transactional แบบกว้าง ๆ แต่ต้องมอง “ภารกิจ” ของผู้ใช้ เช่น ต้องการเข้าใจแนวคิด ต้องการเปรียบเทียบ ต้องการตัดสินใจ ต้องการแก้ปัญหาเฉพาะหน้า ต้องการแผนปฏิบัติ หรือกำลังตรวจสอบข้อเท็จจริง AI Search เหมาะกับการรวมหลาย intent ในบทสนทนาเดียว เพราะระบบสามารถรักษาบริบทและถามต่อได้
สำหรับคนทำคอนเทนต์ นี่ทำให้ long-tail ไม่ได้หมายถึงคำค้นยาวเพียงอย่างเดียวอีกต่อไป แต่หมายถึงชุดสถานการณ์และข้อจำกัดที่ผู้ใช้ใส่เข้ามา หากเว็บมีคำตอบที่อธิบาย “เงื่อนไข” ได้ดี เช่น เมื่อไรควรใช้ A แทน B มีข้อยกเว้นอะไร ต้องระวังอะไร และข้อมูลอ้างอิงอยู่ที่ไหน เนื้อหานั้นมีโอกาสเป็นประโยชน์ต่อระบบสังเคราะห์คำตอบมากกว่าเนื้อหาที่พูดกว้าง ๆ แต่ไม่มีรายละเอียดให้หยิบไปใช้งาน
นี่ไม่แปลว่าทุกบทความต้องเขียนยาว เพียงแต่ต้องตอบครบตามงานที่ผู้ใช้พยายามทำ บาง query ต้องการคำตอบสั้นและแม่น บาง query ต้องการตารางเปรียบเทียบ บาง query ต้องการขั้นตอน บาง query ต้องการหลักฐานหลายแหล่ง หลักคิดที่สำคัญกว่าจำนวนคำคือ information gain: เมื่อเทียบกับหน้าที่มีอยู่แล้ว เนื้อหาของเรามีข้อมูลหรือมุมที่ช่วยให้ผู้ใช้ตัดสินใจดีขึ้นจริงหรือไม่
Zero-click Search: AI ช่วยผู้ใช้มากขึ้น แต่เว็บไซต์อาจได้คลิกน้อยลงจริงหรือ
เมื่อคำตอบถูกแสดงบนหน้าค้นหาโดยตรง คำถามที่หลีกเลี่ยงไม่ได้คือผู้ใช้ยังต้องคลิกเข้าเว็บไซต์หรือไม่ งานสำรวจพฤติกรรมโดย Pew Research Center จาก browsing data ของผู้ใหญ่สหรัฐ 900 คนในเดือนมีนาคม 2025 พบว่า เมื่อหน้าผลการค้นหามี AI summary ผู้ใช้คลิกลิงก์ในแหล่งอ้างอิงของ summary เพียงประมาณ 1% ของการเข้าชมหน้าประเภทนั้น และมีสัดส่วนการจบ browsing session หลังเห็น AI summary สูงกว่าหน้าค้นหาที่ไม่มี summary [18] ข้อมูลนี้สนับสนุนความกังวลเรื่อง zero-click แต่ก็ต้องระวังไม่ขยายผลเกินกลุ่มตัวอย่าง ช่วงเวลา และประเทศที่ศึกษา
ด้านข้อมูลอุตสาหกรรม Ahrefs วิเคราะห์ keyword ขนาดใหญ่และรายงานในเดือนกุมภาพันธ์ 2026 ว่า keyword ที่มี AI Overview สัมพันธ์กับ CTR ของอันดับหนึ่งที่ต่ำลงอย่างมาก โดยประมาณการผลกระทบเฉลี่ยราว 58% ในชุดข้อมูลของตน [19] จุดสำคัญคือคำว่า “สัมพันธ์” เพราะการศึกษาประเภท observational ไม่สามารถยืนยันได้ว่า AI Overview เป็นสาเหตุเดียวของการลดลง SERP มีฟีเจอร์อื่นเพิ่มขึ้น พฤติกรรมผู้ใช้เปลี่ยน และกลุ่ม keyword ที่ trigger AI Overview ก็อาจมีธรรมชาติแตกต่างจากกลุ่มควบคุม
ฝั่ง Google เสนอภาพที่ต่างออกไป บริษัทระบุว่า total organic click volume จาก Google Search ไปยังเว็บไซต์โดยรวมค่อนข้างเสถียรในบางช่วงที่วัด และกล่าวว่าคลิกจากประสบการณ์ที่มี AI อาจมีคุณภาพสูงขึ้นในความหมายว่าผู้ใช้กลับออกจากเว็บไซต์ช้าลง [7] ข้อความนี้ไม่ได้หักล้างงานของ Pew หรือ Ahrefs โดยตรง เพราะแต่ละแหล่งวัดคนละหน่วย คนละช่วงเวลา และคนละตัวชี้วัด จึงควรอ่านร่วมกันมากกว่าหาคำตอบว่าใคร “ถูกทั้งหมด”
สิ่งที่เจ้าของเว็บควรสรุปเชิงกลยุทธ์คือ traffic จาก informational query บางประเภทมีแนวโน้มถูกกดดันมากขึ้น โดยเฉพาะคำถามที่ AI สามารถตอบจบได้ในสองสามย่อหน้า เช่น คำจำกัดความ คำตอบตัวเลขง่าย ๆ หรือสรุปขั้นพื้นฐาน แต่ query ที่ต้องการประสบการณ์ตรง เครื่องมือ interactive, community, original dataset, downloadable resource, การตัดสินใจที่มีความเสี่ยง หรือรายละเอียดเชิงลึกยังมีเหตุผลให้ผู้ใช้คลิกต่อ
ดังนั้นการวางกลยุทธ์เนื้อหาในยุค AI Search ไม่ควรตั้งเป้าหมาย traffic สูงสุดจากทุก query เหมือนเดิม แต่ควรพิจารณาว่า query ใดเหมาะกับการสร้าง awareness ผ่านการถูกอ้างอิง และ query ใดควรถูกออกแบบให้ผู้ใช้ต้องการเข้ามาต่อบนเว็บไซต์ เช่น มี benchmark ของตัวเอง ตารางที่อัปเดตต่อเนื่อง เครื่องคิดเลข เครื่องมือดาวน์โหลด วิดีโอสาธิต หรือขั้นตอนที่ละเอียดเกินกว่าจะสรุปใน AI answer ได้ทั้งหมด
GEO คืออะไร: จุดกำเนิด แนวคิด และเหตุใดคำนี้จึงถูกพูดถึงมากในปี 2026
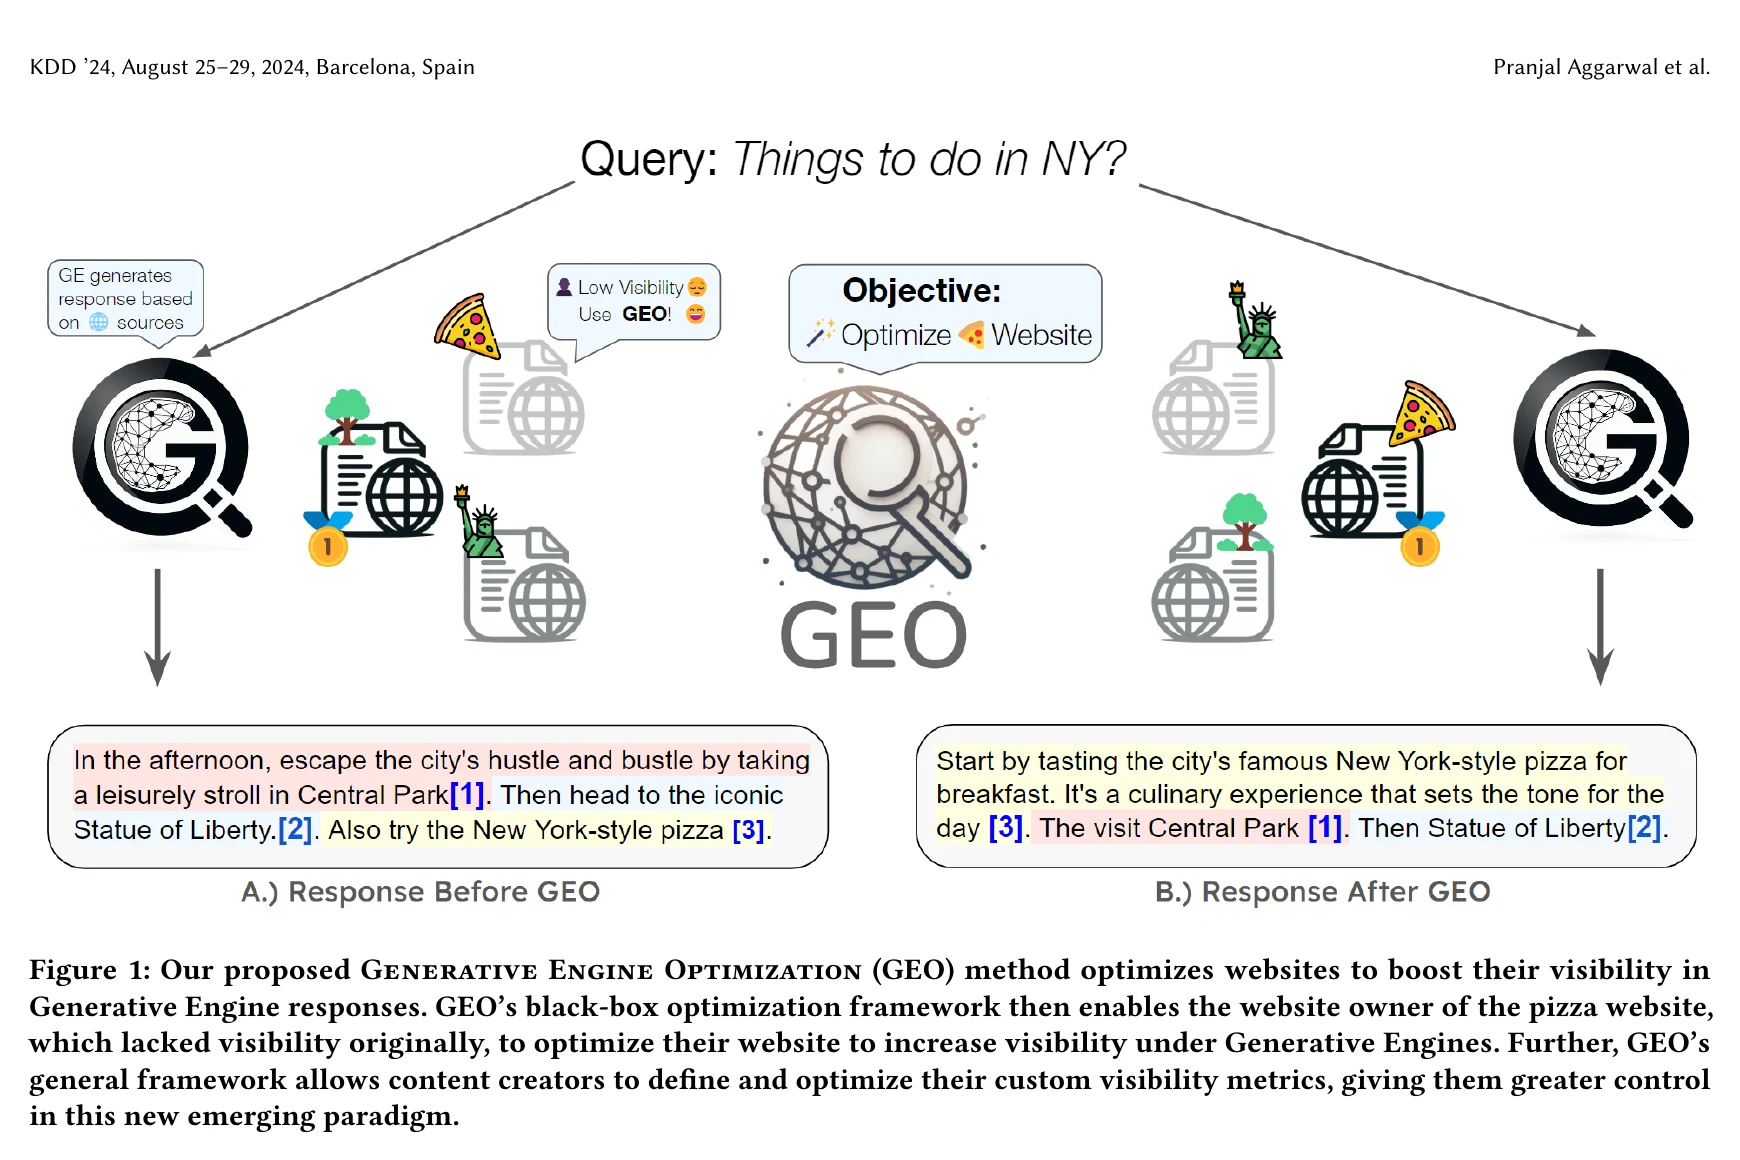
คำว่า Generative Engine Optimization หรือ GEO ได้รับการนิยามอย่างเป็นระบบในงานของ Aggarwal และคณะ ซึ่งเผยแพร่เป็น preprint ในปี 2023 และตีพิมพ์ใน KDD 2024 งานดังกล่าวมอง generative engines เป็นระบบที่สังเคราะห์คำตอบจากหลายแหล่ง และเสนอกรอบการปรับเนื้อหาเพื่อเพิ่ม “visibility” ของแหล่งข้อมูลในคำตอบของระบบ [13] ผลทดลองที่ถูกอ้างถึงบ่อยคือบางวิธีสามารถเพิ่ม visibility ได้สูงสุดประมาณ 40% ใน benchmark ของงานวิจัย
ตัวเลข 40% นี้ต้องตีความให้ถูกบริบท การทดลองยุคแรกจำนวนมากทำงานบนชุด candidate sources ที่กำหนดไว้แล้ว กล่าวอีกแบบคือเอกสารมีโอกาสอยู่ในบริบทให้โมเดลเห็นก่อน จากนั้นจึงทดสอบว่าการเขียนหรือจัดรูปแบบแบบใดทำให้ข้อความนั้นถูกใช้หรือได้รับ prominence มากขึ้น นี่แตกต่างจากโลกจริงที่เว็บเพจก่อนหนึ่งหน้าจะถูก AI อ้างอิงต้องผ่านหลายด่าน ตั้งแต่ crawler เข้าถึงได้หรือไม่ ถูก index หรือไม่ ถูก retrieval เลือกมาหรือไม่ ถูก rerank ขึ้นมาหรือไม่ และสุดท้ายโมเดลใช้เนื้อหานั้นในคำตอบหรือไม่
บทสำรวจเชิงวิพากษ์ปี 2026 ที่ทบทวนงาน GEO หลายสิบชิ้นเสนอว่าควรมอง GEO เป็น pipeline ที่ stochastic และ partially observable มากกว่าจะเป็น ranking task เดียว งานสำรวจชี้ว่าหลักฐานที่แข็งแรงที่สุดในปัจจุบันสนับสนุนเพียงว่า เมื่อเอกสารถูกนำเข้าบริบทแล้ว การปรับบางอย่างสามารถเปลี่ยนโอกาสที่ข้อความจะถูกใช้หรืออ้างอิงได้ แต่ยังไม่มีเทคนิคใดที่พิสูจน์ผลเชิงเหตุและผลระยะยาว ข้ามแพลตฟอร์ม ต่อ organic discoverability และผลลัพธ์ทางธุรกิจอย่างมั่นคง [14]
นี่เป็นเหตุผลว่าทำไมเราควรใช้ GEO เป็น “เลนส์ในการคิด” ไม่ใช่ “คู่มือแฮ็กระบบ” GEO ช่วยเตือนให้เราคิดถึง visibility ที่เกิดหลังจากการค้นคืนข้อมูล และช่วยสร้าง KPI ใหม่ เช่น citation rate หรือ share of cited answers แต่ไม่ได้ทำให้พื้นฐาน SEO หายไป ในหลายกรณี ถ้าเว็บ crawl ไม่ได้ index ไม่ดี authority อ่อน หรือเนื้อหาไม่ตรง intent เราจะยังไม่ถึงขั้นที่ GEO-style content optimization มีความหมายด้วยซ้ำ
อีกประเด็นคือคำศัพท์ในตลาดยังไม่นิ่ง บางองค์กรใช้ AEO หรือ Answer Engine Optimization เพื่อหมายถึงการปรับเนื้อหาให้ตอบคำถามตรงและปรากฏใน answer engines บางแห่งใช้ GEO เน้น generative AI โดยเฉพาะ บางคนใช้ LLMO หรือ AI Search Optimization หากมองในทางปฏิบัติ ชื่อเรียกสำคัญน้อยกว่าการรู้ว่าเรากำลัง optimize ด่านใด: การถูกค้นพบ การถูกเลือกเป็นหลักฐาน การถูกอ้างอิง หรือการสร้างผลลัพธ์ทางธุรกิจหลังจากผู้ใช้เห็นแบรนด์ของเรา
SEO, AEO และ GEO ต่างกันอย่างไร และควรวางให้อยู่ในภาพเดียวกันแบบไหน
SEO หรือ Search Engine Optimization มีเป้าหมายกว้างคือทำให้เนื้อหาเข้าถึงได้ เข้าใจได้ และแข่งขันในระบบค้นหาแบบดั้งเดิม ตั้งแต่ technical SEO, crawling, indexing, architecture, internal links, content quality ไปจนถึง reputation และ links จากภายนอก AEO มักถูกใช้เพื่อเน้นรูปแบบที่ตอบคำถามชัดเจน เช่น featured snippets, voice answers หรือ answer boxes ส่วน GEO มุ่งมอง visibility ภายในคำตอบที่สร้างด้วย generative models
ปัญหาเกิดขึ้นเมื่อเรานำสามคำนี้ไปวางเป็นยุคที่แทนกัน เช่น SEO → AEO → GEO เพราะในทางเทคนิคระบบใหม่ยังพึ่งของเก่าอยู่ Google ระบุอย่างชัดเจนว่า AI features บน Search ยังใช้ core Search ranking and quality systems และการจะเป็น supporting link ใน AI Overviews หรือ AI Mode หน้าเว็บต้อง index ได้และมีสิทธิ์แสดงใน Google Search ตามข้อกำหนดปกติ [1][2] ดังนั้น SEO ไม่ได้กลายเป็นของเก่าที่เลิกใช้ แต่กลายเป็นฐาน infrastructure ของ visibility รูปแบบใหม่
วิธีมองที่ใช้งานได้กว่าคือใช้โมเดลสามชั้น ชั้นแรกคือ Discoverability: เว็บต้อง crawl/index ได้และระบบเข้าใจ topical relevance ชั้นที่สองคือ Answerability: เนื้อหาต้องมีส่วนที่ตอบคำถามชัด มีโครงสร้างและหลักฐานเพียงพอให้ระบบหยิบใช้ ชั้นที่สามคือ Generative Visibility: เมื่อถูกดึงเข้าบริบทแล้ว แหล่งของเราถูกอ้างอิง มี prominence และช่วยประกอบ final answer มากน้อยเพียงใด SEO ดูแลชั้นแรกและส่วนใหญ่ของชั้นสอง AEO เน้นชั้นสอง ส่วน GEO เน้นชั้นสองต่อชั้นสาม แต่ทั้งหมดทับซ้อนกัน
สำหรับทีมเล็ก การสร้างหน่วยงาน “GEO แยกจาก SEO” เร็วเกินไปอาจเพิ่มงานซ้ำซ้อน สิ่งที่คุ้มกว่าคือเพิ่มคำถาม GEO เข้าไปใน editorial checklist เดิม เช่น บทความมี claim ที่ตรวจสอบได้ไหม มี primary source ไหม มีคำตอบแบบสั้นสำหรับคำถามหลักไหม ตารางเปรียบเทียบอ่านง่ายไหม entity ต่าง ๆ ถูกระบุชัดหรือไม่ และเราวัด citation visibility นอกเหนือจาก keyword ranking หรือยัง
สิ่งที่ไม่ควรทำคือเปลี่ยนภาษาเขียนให้แข็งหรือเป็น template จนผู้อ่านเสียประสบการณ์ เพียงเพราะหวังว่า AI จะอ่านข้อความง่ายขึ้น หากการ optimize ทำให้บทความน่าอ่านน้อยลง ความน่าเชื่อถือลดลง หรือข้อมูลถูกย่อจนเสียบริบท เราอาจได้ประโยชน์ในด่านหนึ่งแต่เสียในด่านอื่น งาน SAGEO Arena ปี 2026 พบด้วยว่ากลยุทธ์ที่ดูเหมือนช่วยด้าน generation บางแบบอาจทำให้ retrieval และ reranking แย่ลงเมื่อทดสอบใน pipeline ที่สมจริงขึ้น [17]
| เลนส์ | คำถามหลัก | งานที่ต้องทำ | สิ่งที่ควรวัด |
|---|---|---|---|
| SEO | ระบบค้นหาเข้าถึง เข้าใจ และจัดอันดับหน้าได้หรือไม่ | Crawl, Index, Architecture, Relevance, Quality และ Reputation | Impression, Position, CTR, Organic Conversion |
| AEO | ส่วนใดของหน้าตอบคำถามได้ตรงและครบ | Answer-first, Heading, Definition, Steps, Table และ FAQ ที่มีประโยชน์จริง | Answer Surface, Engagement และ Task Completion |
| GEO | เมื่อเข้าสู่ Generative Pipeline แล้ว หน้าได้รับเลือก ใช้ และอ้างอิงหรือไม่ | Evidence, Extractability, Entity Clarity, Original Information และการวัดซ้ำ | Mention Rate, Citation Rate, AI Referral และ Conversion |
เบื้องหลัง AI Search: จาก Crawl ไปจนถึง Citation ไม่ได้มี “อันดับเดียว” ให้เรา optimize
เพื่อเข้าใจ GEO อย่างไม่หลงทาง เราควรแยก pipeline เป็นอย่างน้อยหกขั้น ขั้นที่หนึ่งคือ Access ระบบหรือ search partner ต้องเข้าถึงหน้าได้ ขั้นที่สองคือ Indexing หรือการมี representation ของเอกสารในดัชนี ขั้นที่สามคือ Retrieval เมื่อคำถามเข้ามา ระบบต้องค้นพบว่าเอกสารของเราเกี่ยวข้อง ขั้นที่สี่คือ Reranking/Selection ระบบเลือกบางแหล่งจาก candidate จำนวนมาก ขั้นที่ห้าคือ Context Allocation เนื้อหาบางส่วนถูกส่งเข้า context ให้โมเดล และขั้นสุดท้ายคือ Generation/Citation โมเดลสร้างคำตอบพร้อม attribution หรือลิงก์ตามกลไกของแพลตฟอร์ม
Google เปิดเผยบางส่วนของกลไกว่า AI Overviews และ AI Mode สามารถใช้ query fan-out และ RAG โดยดึงข้อมูลจาก Search index ผ่าน core ranking systems เพื่อช่วยให้คำตอบสดและ grounded ขึ้น [1][2] คำว่า RAG ในที่นี้ไม่ควรถูกตีความว่าทุกแพลตฟอร์มใช้ implementation เดียวกัน RAG เป็นตระกูลแนวคิดกว้าง ๆ ที่ผสาน retrieval กับ generation ส่วนรายละเอียด candidate generation, ranking, passage selection และ citation attribution เป็นระบบเฉพาะของแต่ละบริษัท
เมื่อมองแบบ pipeline เราจะเห็นว่าคำถาม “ทำอย่างไรให้ ChatGPT อ้างอิงเว็บเรา” ไม่มีคำตอบเดียว หาก OAI-SearchBot ถูกบล็อก ปัญหาอยู่ที่ access; หาก crawl ได้แต่ไม่มี topical relevance ปัญหาอาจอยู่ที่ retrieval; หากถูก retrieve แต่ไม่ cite ปัญหาอาจอยู่ที่ source selection หรือ content extractability; หาก cite แล้วแต่ไม่มี referral ปัญหาอาจอยู่ที่ user intent หรือความน่าสนใจของ landing page ดังนั้นการแก้ต้องวินิจฉัยตามด่าน ไม่ใช่เปลี่ยนคำในบทความแบบสุ่ม
งานวิจัยปี 2026 เสนอแยก citation selection ออกจาก citation absorption กล่าวคือหน้าเว็บอาจถูกอ้างอิง แต่ไม่ได้หมายความว่าข้อมูลจากหน้านั้นมีอิทธิพลมากต่อคำตอบ หรือในทางกลับกัน ระบบอาจใช้สาระจากหน้าแต่ citation ไปชี้อีกแหล่งหนึ่ง กรอบแบบนี้ช่วยให้เห็นว่าการนับจำนวน citations อย่างเดียวอาจไม่สะท้อน contribution จริง [16] อย่างไรก็ดี สำหรับเจ้าของเว็บทั่วไป absorption วัดยากกว่าการมองเห็น citation และ referral จึงควรใช้เป็นแนวคิดวิเคราะห์มากกว่าตัวเลข KPI รายวัน
อีกลักษณะหนึ่งของ generative systems คือความแปรผัน การถามคำถามเดิมสองครั้งอาจได้ชุดแหล่งอ้างอิงต่างกัน การเปลี่ยนคำเพียงเล็กน้อยอาจทำให้ระบบแตก query fan-out คนละเส้นทาง งาน “Don’t Measure Once” จึงเสนอให้วัด GEO แบบ distribution ด้วยการรันซ้ำและใช้ prompt variants แทนการเก็บ screenshot เพียงครั้งเดียว [15] นี่เป็นจุดแตกต่างสำคัญจาก rank tracking แบบเดิมที่แม้จะผันผวน แต่ยังมีแนวคิด position ที่ค่อนข้างชัดกว่า
สิ่งที่ Google บอกอย่างเป็นทางการ: ไม่ต้องมี “GEO Schema” และ SEO Fundamentals ยังสำคัญ
ท่ามกลางคำแนะนำ GEO จำนวนมาก สิ่งที่มีน้ำหนักสูงสุดสำหรับ Google Search คือเอกสารจาก Google Search Central เอง เอกสาร AI features and your website ระบุว่าไม่มีข้อกำหนดทางเทคนิคเพิ่มเติมเพื่อให้ปรากฏใน AI Overviews หรือ AI Mode นอกเหนือจากการมีสิทธิ์ปรากฏใน Search ปกติ และยังย้ำว่า SEO best practices เดิมใช้ได้ต่อ [1] นี่เป็นข้อความสำคัญเพราะตัดความเชื่อที่ว่าเว็บไซต์ต้องติดตั้ง markup ลับชนิดใหม่เพื่อเข้า AI Search
Google ระบุด้วยว่าไม่จำเป็นต้องสร้างไฟล์ machine-readable ใหม่ ไฟล์ AI text พิเศษ หรือ schema.org แบบพิเศษเพื่อให้ถูกแสดงใน AI features [1] ดังนั้นการโฆษณาว่า llms.txt หรือ schema บางชนิด “จำเป็น” ต่อ Google AI Overviews จึงเกินหลักฐานในปัจจุบัน ไฟล์หรือมาตรฐานทดลองอาจมี use case อื่น แต่ต้องแยกออกจากคำกล่าวว่า Google ต้องใช้สิ่งนั้นเพื่ออ้างอิงเว็บไซต์
สิ่งที่ Google แนะนำกลับเป็นเรื่องคุ้นเคย: อนุญาตให้ crawl, ทำ internal links ให้ผู้ใช้และ crawler หาเนื้อหาได้, ทำ page experience ให้ดี, ทำให้สาระสำคัญอยู่ใน text ที่เข้าถึงได้, ใช้ภาพและวิดีโอคุณภาพดีเมื่อเหมาะสม และทำ structured data ให้ตรงกับเนื้อหาที่มองเห็นจริง [1] Structured data ยังมีคุณค่าในการช่วยอธิบายชนิดและความหมายของข้อมูล รวมถึงเปิดโอกาสต่อ rich results แต่ Google ไม่รับประกันว่าการมี markup จะทำให้เกิด rich result และไม่ได้บอกว่า schema เป็น shortcut สำหรับ AI citation [20]
Google ยังเตือนเรื่อง generative AI content ว่าเครื่องมือ AI ใช้ช่วย research หรือจัดโครงสร้างได้ แต่การสร้างหน้าเป็นจำนวนมากโดยไม่เพิ่มคุณค่าอาจเข้าข่าย scaled content abuse ตาม spam policies [21] นี่เชื่อมกับ GEO โดยตรง เพราะช่วงที่ตลาดตื่นกับ AI Search มีแรงจูงใจให้ผลิตบทความจำนวนมากเพื่อครอบคลุมทุก prompt แต่หากเนื้อหาเหล่านั้นเป็น commodity content ที่สรุปของคนอื่นซ้ำ ๆ ก็อาจมีคุณค่าน้อยทั้งต่อผู้ใช้และระบบค้นหา
ข้อสรุปเชิงปฏิบัติคือ สำหรับ Google ให้เริ่มจาก Search Essentials และ people-first content ก่อน แล้วค่อยเพิ่มมุม GEO เช่น extractable answers และ evidence blocks การกลับลำดับโดยทำ “AI-friendly wording” ก่อนแก้ indexability, site architecture หรือ content quality เป็นการ optimize ปลายท่อขณะที่ต้นท่อยังมีปัญหา
แล้ว ChatGPT Search ล่ะ: สิ่งที่เจ้าของเว็บควรทำตามข้อมูลจาก OpenAI
OpenAI ให้คำแนะนำสำหรับ publishers ค่อนข้างตรงไปตรงมา หากต้องการให้เนื้อหาถูกค้นพบและนำไปแสดงใน summary/snippet ของ ChatGPT Search ควรตรวจว่าไม่ได้บล็อก OAI-SearchBot ใน robots.txt และ infrastructure เช่น CDN หรือระบบป้องกัน bot ต้องอนุญาต traffic จาก crawler ที่ประกาศไว้ [8][9] การอนุญาต crawler ไม่ได้รับประกันว่าจะถูกจัดอันดับหรืออ้างอิง แต่เป็นเงื่อนไขพื้นฐานด้าน access
จุดที่ควรแยกให้ชัดคือ OAI-SearchBot กับ GPTBot มีวัตถุประสงค์ต่างกัน เอกสาร publisher FAQ ของ OpenAI แยก control สำหรับ search visibility ออกจาก control ที่เกี่ยวกับ potential training ทำให้เจ้าของเว็บสามารถตัดสินใจด้าน discoverability และด้าน training policy แยกกันได้ [9] สำหรับองค์กรที่มีข้อกำหนดด้านข้อมูลหรือ licensing การแยก crawler policy เป็นราย user-agent จึงสำคัญกว่าการ block ทุกอย่างแบบเหมารวม
OpenAI ยังระบุว่า referral จาก ChatGPT สามารถติดตามใน analytics ได้ และลิงก์ referral มีพารามิเตอร์ utm_source=chatgpt.com เพื่อช่วยแยก traffic [9] นี่ทำให้ KPI ด้าน ChatGPT มีความเป็นรูปธรรมกว่าการพยายามเดาว่า citation ใดสร้าง session หากเว็บใช้ GA4 หรือระบบ analytics อื่น ควรสร้าง channel/group หรือ report แยกสำหรับ AI referrals และบันทึก landing pages ที่ได้รับ traffic จาก chatgpt.com
ในทางเนื้อหา OpenAI ไม่ได้ประกาศ checklist GEO แบบที่รับประกันอันดับ เอกสาร Search ระบุเพียงว่าระบบใช้ปัจจัยหลายอย่างเพื่อช่วยให้ผู้ใช้พบข้อมูลที่ reliable และ relevant และไม่มีวิธีรับประกัน top placement [8] ดังนั้นคำแนะนำบนอินเทอร์เน็ตที่บอกว่า “ChatGPT ชอบย่อหน้า 40 คำ” หรือ “ต้องเขียนคำตอบขึ้นต้นด้วยประโยคแบบนี้” ควรถือเป็น hypothesis จนกว่าจะมีการทดลองที่ออกแบบดีหรือคำยืนยันจากผู้ให้บริการ
Content สำหรับ AI Search ควรหน้าตาอย่างไร: หลักการที่มีเหตุผลและไม่ขัดกับคนอ่าน
คำแนะนำที่ปลอดภัยที่สุดไม่ใช่การเขียนเพื่อ bot แต่คือการทำให้ข้อมูลมีโครงสร้างทางความคิดชัด หากหัวข้อหนึ่งตอบคำถามหลายข้อ ให้ใช้ heading ที่สื่อความหมายตรง เช่น “RAG ต่างจาก Fine-tuning อย่างไร” แทน heading กว้างอย่าง “สิ่งที่ควรรู้” จากนั้นเริ่มย่อหน้าด้วยคำตอบสั้นที่ยืนได้ด้วยตัวเอง แล้วค่อยขยายเหตุผล ตัวอย่าง และข้อยกเว้น โครงสร้างแบบนี้ช่วยทั้งคนที่สแกนบทความและระบบที่ต้องเลือก passage ที่เกี่ยวข้อง
หลักการที่สองคือ evidence density เมื่อมี claim ที่ตรวจสอบได้ ควรใส่แหล่งอ้างอิงที่มีคุณภาพใกล้กับ claim นั้น ไม่ใช่กองลิงก์ทั้งหมดไว้ท้ายบทความแบบไม่รู้ว่าอันไหนสนับสนุนประโยคใด โดยเฉพาะเรื่องที่เปลี่ยนเร็ว เช่น จำนวนผู้ใช้ ชื่อโมเดล ราคา กฎหมาย หรือผล benchmark Primary source ควรมาก่อนบทสรุปจากบุคคลที่สามเมื่อเป็นไปได้
หลักการที่สามคือ original information เว็บไซต์ที่เพียงเรียบเรียงข้อมูลจากเว็บอื่นอยู่ในตำแหน่งที่ถูกแทนที่ได้ง่าย เพราะ AI สามารถสรุปแหล่งเดียวกันได้เช่นกัน สิ่งที่สร้างความแตกต่างคือข้อมูลต้นฉบับ เช่น ผลทดสอบภาษาไทย ตาราง benchmark ที่ทีมทำเอง screenshot workflow จริง ข้อผิดพลาดที่พบจากการทดลอง dataset ที่ดาวน์โหลดได้ แบบสอบถาม หรือกรณีศึกษาในบริบทประเทศไทย เมื่อข้อมูลนั้นเป็นของเราเอง เว็บของเราจะกลายเป็น primary source ที่ระบบอื่นมีเหตุผลต้องอ้าง
หลักการที่สี่คือ entity clarity ระบุชื่อบุคคล องค์กร ผลิตภัณฑ์ เวอร์ชัน วันที่ และความสัมพันธ์ให้ชัด หลีกเลี่ยงสรรพนามคลุมเครือในย่อหน้าที่มีหลาย entity เช่น “บริษัทนี้” หรือ “โมเดลนี้” โดยไม่บอกว่าอ้างถึงอะไร การเขียนชัดไม่ได้หมายถึงเขียนเหมือนฐานข้อมูล แต่หมายถึงลด ambiguity ให้ทั้งผู้อ่านและระบบ
หลักการที่ห้าคือ content freshness ที่มีความหมาย การเปลี่ยนวันที่ updated โดยไม่แก้สาระไม่ช่วยให้บทความน่าเชื่อถือ ควรบอกว่าปรับอะไร เช่น “อัปเดต 9 ส.ค. 2026: เพิ่ม Search Console Generative AI report และข้อมูล AI Mode ล่าสุด” การทำ changelog เล็ก ๆ สำหรับบทความ evergreen ที่เปลี่ยนเร็วช่วยผู้อ่านประเมิน freshness ได้ดีกว่า badge วันที่เพียงอย่างเดียว
หลักการที่หกคือ layered depth บทความดีควรมีคำตอบเร็วสำหรับผู้เริ่มต้น และมีรายละเอียดลึกสำหรับคนที่ต้องตัดสินใจจริง ตัวอย่างเช่นส่วนต้นอธิบาย GEO ในสามประโยค ต่อด้วยตาราง SEO vs GEO แล้วค่อยลง pipeline, measurement และ limitations วิธีนี้ทำให้หน้าเดียวตอบหลายระดับ intent โดยไม่บังคับทุกคนอ่านตั้งแต่ต้นจนจบ
สุดท้ายคืออย่าตัดบริบทเพื่อให้ passage สั้นเกินไป หากคำตอบมีเงื่อนไข ให้ใส่เงื่อนไขใน passage เดียวกัน เช่น “Structured data ช่วย Google เข้าใจประเภทข้อมูลและอาจเปิดสิทธิ์ rich results แต่ไม่ใช่ข้อกำหนดพิเศษสำหรับ AI Overviews” ดีกว่าแยกประโยค “Structured data ช่วย AI Search” ไว้โดด ๆ ซึ่งเสี่ยงถูกนำไปสรุปผิดความหมาย
Structured Data, E-E-A-T, Entity และ Brand Signals: อะไรคือหลักฐาน อะไรคือการอนุมาน
Structured data เป็นหัวข้อที่ถูกพูดถึงมากใน GEO เพราะดูเหมือนเป็นภาษา machine-readable ที่น่าจะช่วย AI เข้าใจเว็บ แต่สำหรับ Google ต้องแยกสองประเด็น Google ยืนยันว่า structured data ช่วยให้ Search เข้าใจข้อมูลและใช้กับ rich result บางประเภทได้ [20] แต่ในเอกสาร AI features Google ระบุว่าไม่มี schema พิเศษที่ต้องเพิ่มเพื่อปรากฏใน AI Overviews หรือ AI Mode [1] ดังนั้นแนวทางที่สมเหตุผลคือทำ schema ที่ Google รองรับและตรงกับ visible content เพื่อประโยชน์ Search โดยรวม ไม่ใช่สร้าง markup เกินจริงเพื่อหวัง citation
คำว่า E-E-A-T ได้แก่ Experience, Expertise, Authoritativeness และ Trust ถูกใช้ใน ecosystem ของ Google เพื่ออธิบายแนวทางประเมินคุณภาพ แต่ไม่ควรนำไปพูดเหมือนมี E-E-A-T score ที่เจ้าของเว็บดูได้โดยตรง ในมุม AI Search สิ่งที่จับต้องได้กว่าคือการแสดงหลักฐานของประสบการณ์และความน่าเชื่อถือ เช่น ผู้เขียนเป็นใคร ใช้เกณฑ์อะไรในการทดสอบ มี methodology หรือไม่ แหล่งข้อมูลต้นฉบับอยู่ที่ไหน และข้อจำกัดของผลสรุปคืออะไร
ส่วน brand/entity signals เป็นพื้นที่ที่งานวิจัยและข้อมูลอุตสาหกรรมกำลังสำรวจ งาน comparative study บางชิ้นพบว่า AI Search อาจให้น้ำหนักแหล่ง third-party หรือ earned media สูงในบาง vertical และ platform [14] แต่เราไม่ควรสรุปเป็นกฎว่า “ต้องมี PR จึงจะติด AI” เพราะระบบแตกต่างกันและ evidence ยังไม่พอสำหรับ universal rule สิ่งที่เชื่อถือได้คือการมีข้อมูลสอดคล้องกันข้ามเว็บไซต์ทางการ โปรไฟล์ผู้เขียน แหล่งข่าว และฐานข้อมูลที่น่าเชื่อถือช่วยลดความกำกวมของ entity ในโลกเว็บโดยรวม
สำหรับแบรนด์ขนาดเล็ก การไล่สร้าง mention ปริมาณมากบนเว็บคุณภาพต่ำมีความเสี่ยงกลายเป็น spam มากกว่าช่วย สิ่งที่ดีกว่าคือ earned references ที่มีเหตุผล เช่น ออกรายงานต้นฉบับที่สำนักข่าวหรือผู้เชี่ยวชาญนำไปอ้าง ร่วมงานกับมหาวิทยาลัย เผยแพร่ dataset เปิด หรือทำคู่มือที่กลายเป็น reference ในชุมชน การสร้าง authority แบบนี้ช้ากว่าเทคนิค copywriting แต่มีคุณค่าต่อทั้ง Search, AI systems และผู้ใช้จริง
หากต้องเลือกเพียงหนึ่งประโยคให้จำเกี่ยวกับ brand signals คือ “สร้างเหตุผลที่เว็บอื่นควรอ้างถึงคุณ” มากกว่า “สร้างจำนวนครั้งที่ชื่อคุณปรากฏ” ความแตกต่างนี้สอดคล้องกับหลัก people-first content และลดความเสี่ยงจากการไล่ตาม metric ที่ผู้ให้บริการไม่เคยรับรอง
งานวิจัย GEO บอกอะไรจริง ๆ: จากผล +40% สู่ข้อเตือนในปี 2026
งาน GEO รุ่นแรกมีคุณูปการสำคัญเพราะทำให้โจทย์ visibility ของผู้ผลิตเนื้อหาใน generative engines ถูกศึกษาอย่างเป็นระบบ และเสนอ metric ที่พยายามวัดว่าข้อมูลจาก source ใดปรากฏในคำตอบมากน้อยเพียงใด [13] กลยุทธ์อย่างการเพิ่ม citations, statistics หรือการปรับความลื่นไหลบางแบบแสดงผลดีในบาง domain แต่ efficacy แตกต่างกันตามหัวข้อ ทำให้แม้แต่งานต้นฉบับเองก็ไม่สนับสนุนแนวคิด one-size-fits-all
เมื่อระบบจริงพัฒนาขึ้น งานปี 2026 เริ่มตั้งคำถามต่อ external validity ของผลทดลองเก่า SAGEO Arena ชี้ว่าการ optimize เฉพาะ generation หลังจากกำหนด candidate documents ไว้แล้วอาจมองข้าม retrieval/reranking และใน pipeline ที่สมจริง กลยุทธ์บางอย่างอาจลด performance ในด่านก่อนหน้า [17] นี่เป็นบทเรียนสำคัญมาก: ข้อความที่โมเดล “ชอบใช้” ไม่จำเป็นต้องเป็นข้อความที่ search system “ชอบ retrieve”
Critical Survey 2026 เสนอ evidence hierarchy และสรุปอย่างระมัดระวังว่า หลักฐานที่น่าเชื่อถือที่สุดยังจำกัดอยู่ที่ผลต่อ citation/use เมื่อ content ถูก retrieve แล้ว ขณะที่ผลต่อ organic discoverability และ downstream behavior เช่น clicks หรือ conversions ยังไม่ได้รับการพิสูจน์แบบ longitudinal cross-platform [14] ดังนั้นคำกล่าวเช่น “เพิ่มสถิติแล้ว traffic จาก AI จะเพิ่ม 40%” เป็นการเอาผลจาก metric หนึ่งไปขยายเป็นอีก metric โดยไม่มีหลักฐานรองรับ
งานด้าน measurement ยังพบอีกว่าความแปรผันของคำตอบสูง การวัดครั้งเดียวจึงเสี่ยงมาก [15] หากเราถาม ChatGPT ว่า “เครื่องมือ Local LLM ที่ดีที่สุดคืออะไร” แล้วเว็บเราไม่ถูกอ้างหนึ่งครั้ง ไม่ได้หมายความว่า visibility เป็นศูนย์ เช่นเดียวกัน การถูก cite หนึ่งครั้งไม่ได้หมายความว่าเราครองคำถามนั้น การประเมินควรใช้ repeated runs, paraphrased prompts, ช่วงเวลาต่างกัน และ comparison set กับคู่แข่ง
มุมที่น่าสนใจอีกอย่างคือ citation absorption [16] หากระบบ cite เว็บเราแต่ final answer ใช้ข้อเท็จจริงหลักจากเว็บอื่น แบรนด์อาจมี visibility แต่ไม่ได้เป็นแหล่งสาระสำคัญ ในทางกลับกัน ถ้าข้อมูลต้นฉบับของเราถูกสังเคราะห์ แต่ citation attribution ไม่สมบูรณ์ ก็เกิดปัญหาความเป็นธรรมต่อผู้ผลิตเนื้อหา นี่ทำให้ GEO ไม่ใช่เพียงศาสตร์การตลาด แต่เชื่อมกับ design ของ information ecosystem และ incentive ของผู้สร้างความรู้
คำว่า “เพิ่ม visibility ได้สูงสุด 40%” หมายถึงผลภายใต้ Benchmark และเงื่อนไขของงาน GEO ยุคแรก ไม่ใช่คำมั่นว่าเว็บไซต์จริงจะได้ citation หรือ traffic เพิ่ม 40% ข้ามทุกแพลตฟอร์ม
KPI ใหม่ในยุค AI Search: อย่าวัด GEO ด้วย “อันดับ” เพียงตัวเดียว
ระบบ generative ไม่มี rank position ที่เสถียรเท่า SERP ปกติ การวัดผลจึงควรใช้ KPI หลายชั้น เริ่มจาก Technical Availability: crawler ที่ต้องการเข้าถึงเว็บได้หรือไม่ robots.txt/CDN block หรือไม่ จากนั้น Search Discoverability: หน้า index และมี organic impressions หรือไม่ ต่อด้วย AI Visibility: แบรนด์หรือ URL ถูก mention/cite ในชุด prompt ที่กำหนดกี่เปอร์เซ็นต์ และสุดท้าย Business Outcome: referral sessions, engaged sessions, leads, subscriptions หรือ conversions ที่มาจาก AI surfaces
สำหรับ Google Search ในปี 2026 Google เริ่มเปิด Generative AI performance reports ใน Search Console แบบ rollout ให้บางเว็บไซต์ โดยมีมุมมอง dedicated สำหรับ visibility ใน AI features ขณะที่ AI Mode data ถูกนับรวมใน Performance report โดยรวม [3] การมี report เฉพาะช่วยให้เจ้าของเว็บเริ่มวัด impressions จาก generative features ได้ตรงขึ้น แต่ availability อาจยังไม่เท่ากันทุกบัญชี จึงต้องตรวจใน Search Console ของตนเอง
สำหรับ ChatGPT OpenAI ระบุว่า referral URL มี utm_source=chatgpt.com [9] ทีม analytics จึงสามารถสร้าง segment เช่น source/medium ที่มี chatgpt.com และติดตาม landing page, engagement, conversion rate และ assisted conversions ได้ ส่วน Perplexity, Copilot หรือ Gemini ควรดู referrer domains และ campaign parameters ที่ปรากฏจริงใน log/analytics เนื่องจากรูปแบบอาจเปลี่ยนได้ ไม่ควร hard-code สมมติฐานจากบทความเก่า
สำหรับ visibility ที่ไม่มี click วิธีง่ายที่สุดคือสร้าง prompt set 30-100 ข้อที่สะท้อน user journeys จริง แบ่งเป็น discovery, comparison, troubleshooting, purchase/selection, และ deep research จากนั้นรันแต่ละ prompt หลายครั้งและเก็บ 1) mention rate 2) citation rate 3) citation position/prominence 4) competitor share 5) source domains ที่ปรากฏบ่อย วิธีนี้ใช้แรงแต่ให้ข้อมูลเชิงกลยุทธ์มากกว่าการเช็คคำถามหนึ่งข้อ
ควรกำหนด baseline ก่อนแก้เนื้อหา และทำ A/B แบบเวลาเมื่อทำได้ เช่น วัด 4 สัปดาห์ก่อนปรับและ 4 สัปดาห์หลังปรับ โดยควบคุมปัจจัยใหญ่ ๆ เช่น seasonality หรือ major product launch แม้จะไม่ใช่ randomized experiment แต่ดีกว่าการแก้บทความแล้วเห็น citation หนึ่งครั้งก่อนสรุปว่าเทคนิคได้ผล
KPI ที่ควรหลีกเลี่ยงการตีความเกินจริงคือ citation count ดิบ หาก prompt set เปลี่ยนทุกเดือน ตัวเลขเปรียบเทียบไม่ได้ หากระบบหนึ่ง cite แหล่งมากกว่าระบบอื่นโดยธรรมชาติ count ก็ไม่เท่ากัน และหากแบรนด์ถูก cite ในคำถามที่ไม่มีความหมายทางธุรกิจ การเพิ่มขึ้นก็อาจไม่สำคัญ จึงควรผูก GEO metrics กับ topic priority และ conversion value เสมอ
| ชั้นการวัด | ตัวชี้วัดตัวอย่าง | คำถามที่ตอบ |
|---|---|---|
| Discoverability | Index coverage, Search impressions, Crawl errors | ระบบมีโอกาสพบหน้าเราหรือยัง |
| Generative visibility | Mention rate, Citation rate, Share of cited answers | เราโผล่ในคำตอบบ่อยและสม่ำเสมอเพียงใด |
| Traffic | Organic sessions, AI referrals, Landing-page mix | Visibility เปลี่ยนเป็นการเข้าชมแบบใด |
| Quality | Engagement, Assisted conversion, Qualified lead | ผู้เข้าชมทำสิ่งที่มีคุณค่าหรือไม่ |
| Stability | ค่าเฉลี่ย ช่วงกระจาย และผลจาก Prompt variants | ผลเกิดซ้ำได้หรือเป็นเพียง Screenshot ครั้งเดียว |
Playbook สำหรับเว็บไซต์ไทย: 12 ขั้นตอนที่ลงมือทำได้โดยไม่ต้องรอ “มาตรฐาน GEO”
ขั้นที่ 1: ตรวจ crawler access ก่อน เริ่มจาก Googlebot และ crawler ของแพลตฟอร์มที่ต้องการ เช่น OAI-SearchBot ตรวจ robots.txt, firewall, CDN และ WAF ว่าไม่ได้ block โดยไม่ตั้งใจ เพราะ content strategy ไม่มีประโยชน์หากระบบเข้าถึงหน้าไม่ได้ [1][9]
ขั้นที่ 2: ตรวจ indexability และ canonical ให้สะอาด โดยเฉพาะ WordPress ที่อาจเกิด archive, tag, parameter หรือ duplicate URLs จำนวนมาก หน้า pillar และบทความหลักต้องมี canonical ที่ถูกต้อง sitemap อัปเดต และ internal links จาก hub ที่เกี่ยวข้อง
ขั้นที่ 3: สร้าง topic architecture แทนการไล่ keyword เดี่ยว เช่นหัวข้อ AI Search อาจมี pillar “AI Search คืออะไร” และ cluster “GEO”, “AI Overviews”, “ChatGPT Search”, “RAG”, “Search Console AI report”, “วิธีวัด AI citations” โครงสร้างนี้ทำให้ทั้งคนและ crawler เห็นความสัมพันธ์ของเนื้อหา
ขั้นที่ 4: ทำ source map ก่อนเขียน แยก primary sources, academic research, official docs, local sources และ industry studies สำหรับแต่ละ claim การทำ source map ลด hallucination และช่วยให้บทความอัปเดตง่ายเมื่อข้อมูลเปลี่ยน
ขั้นที่ 5: เขียน answer-first section แต่ไม่ทำให้ตื้น ทุก H2 สำคัญควรมีคำตอบสั้น 2-4 ประโยคที่ยืนได้เอง จากนั้นตามด้วยบริบท หลักฐาน และข้อยกเว้น วิธีนี้เหมาะกับทั้ง featured extraction และผู้อ่านที่ต้องการสแกน
ขั้นที่ 6: เพิ่ม original Thai context หากบทความภาษาไทยเพียงแปล documentation อังกฤษ โอกาสสร้างความแตกต่างต่ำ ให้เพิ่มตัวอย่างเครื่องมือที่คนไทยใช้ ปัญหาภาษาไทย กฎหมาย/นโยบายไทย ราคาในบริบทไทย ผลทดสอบภาษาไทย หรือ workflow สำหรับองค์กรไทย
ขั้นที่ 7: ทำ author/source transparency ใส่ผู้เขียน ความเชี่ยวชาญ วิธีทดสอบ วันที่ตรวจข้อมูล และ disclosure หากใช้ AI ช่วย สิ่งเหล่านี้ไม่ใช่ trick เพื่อ ranking แต่ช่วยให้ผู้อ่านตัดสินความน่าเชื่อถือ
ขั้นที่ 8: ใช้ structured data ที่เหมาะและตรง visible content เช่น Article, Breadcrumb, Organization หรือ ProfilePage ตามเอกสาร Google อย่าสร้าง FAQ schema เพียงเพราะอยากได้ AI citation โดยไม่ดูว่า Google รองรับ use case นั้นอย่างไรในปัจจุบัน [20]
ขั้นที่ 9: เพิ่ม internal links ที่มี anchor สื่อความหมาย เช่น “RAG คืออะไร” ดีกว่า “อ่านต่อที่นี่” การเชื่อม pillar-cluster ช่วย discovery และให้ผู้อ่านไปต่อจากคำตอบสั้นสู่ความรู้ลึก
ขั้นที่ 10: สร้าง asset ที่สรุปแทนได้ยาก เช่น ตาราง benchmark ที่อัปเดตทุกเดือน เครื่องมือคำนวณ dataset template checklist downloadable หรือวิดีโอสาธิต สิ่งเหล่านี้เพิ่มเหตุผลให้เกิด click แม้ AI จะสรุปเนื้อหาเบื้องต้นได้
ขั้นที่ 11: สร้าง GEO measurement set จาก prompt จริงของผู้ใช้และวัดซ้ำ เก็บทั้ง citation และ referral อย่าใช้ screenshot ที่เลือกเฉพาะตัวอย่างที่เว็บเราติด เพราะจะทำให้ทีมเข้าใจ performance สูงเกินจริง [15]
ขั้นที่ 12: ทบทวนทุก 60-90 วันว่า content ที่อัปเดตสร้าง value ใหม่หรือเพียงเปลี่ยนคำ หากไม่มีข้อมูลใหม่ ให้ลงทุนกับการปรับ accuracy, UX และ assets มากกว่าการเติมย่อหน้าเพื่อทำให้บทความยาวขึ้น
ตัวอย่างการออกแบบบทความหนึ่งหน้าให้พร้อมทั้ง SEO และ AI Search
สมมติเราจะเขียนเรื่อง “Local LLM คืออะไร” วิธีเดิมอาจเริ่มด้วยประวัติ LLM ยาวหลายย่อหน้า แล้วค่อยตอบคำถามหลักช่วงกลางบทความ วิธีที่เหมาะกับ search intent ปัจจุบันคือเปิดด้วยคำจำกัดความสั้นและความแตกต่างจาก Cloud LLM จากนั้นมีตาราง “Local vs Cloud” พร้อมหัวข้อ Privacy, Cost, Latency, Maintenance, GPU Requirement แล้วค่อยลงรายละเอียดแต่ละประเด็น
ภายในส่วน “ข้อดีของ Local LLM” ไม่ควรเขียนเพียง bullet ทั่วไปว่าเร็ว ปลอดภัย และประหยัด เพราะคำเหล่านี้เป็น claim ที่ขึ้นกับบริบท ควรอธิบายว่า privacy ดีขึ้นในกรณีใด ข้อมูลออกจาก network หรือไม่ ค่าใช้จ่ายคุ้มเมื่อ workload แบบไหน latency ขึ้นกับ hardware และ stack อย่างไร วิธีนี้ทำให้แต่ละ passage มีข้อมูลที่ถูกนำไปตอบคำถามย่อยได้โดยไม่บิดความหมาย
จากนั้นเพิ่ม original benchmark เช่นทดลองโมเดล 3 ตัวบน GPU รุ่นเดียวกัน ใช้ prompt ภาษาไทยชุดเดียว วัด tokens/sec, VRAM และคุณภาพคำตอบ พร้อม methodology และวันที่ทดสอบ นี่คือ information asset ที่ทั้งคนและ AI search systems มีเหตุผลต้องอ้างมากกว่าบทความที่คัด specifications จากหน้า model card
ท้ายบทความใส่ FAQ ที่ตอบคำถามจริง เช่น “Local LLM ต้องต่ออินเทอร์เน็ตไหม”, “RTX 16GB รันโมเดลขนาดไหนได้”, “Ollama กับ vLLM ต่างกันอย่างไร” FAQ ควรมีไว้เพราะช่วยผู้อ่าน ไม่ใช่เพราะหวัง rich result หากคำตอบอยู่แล้วในเนื้อหาให้ลิงก์ไป section หลักแทนการเขียนซ้ำหลายรอบ
ผลลัพธ์คือหน้าเดียวมีคุณสมบัติครบสามมิติ: SEO ทำให้ค้นพบได้, AEO ทำให้ตอบคำถามย่อยได้ชัด และ GEO ทำให้มี evidence/structure ที่เหมาะกับการนำไปสังเคราะห์โดย generative systems โดยไม่มีจุดไหนต้องเสีย readability ของมนุษย์
สิ่งที่ไม่ควรทำ: 8 ความเชื่อเกี่ยวกับ GEO ที่เสี่ยงทำให้เสียเวลา
ความเชื่อที่ 1 “SEO ตายแล้ว” — ขัดกับโครงสร้างจริงของ Google AI Search ที่ยังใช้ Search index และ ranking systems เป็นฐาน [1][2] SEO อาจเปลี่ยน KPI และ distribution ของ clicks แต่ยังเป็น infrastructure สำคัญ
ความเชื่อที่ 2 “ต้องมี llms.txt ไม่เช่นนั้น Google AI ไม่อ่านเว็บ” — Google ระบุว่าไม่ต้องมี AI text file พิเศษสำหรับ AI Overviews/AI Mode [1] โปรเจกต์ llms.txt อาจมีประโยชน์ใน ecosystem บางส่วน แต่ไม่ควรโฆษณาเป็นข้อบังคับของ Google
ความเชื่อที่ 3 “เพิ่ม schema แล้ว AI จะ cite” — structured data ช่วย Search เข้าใจข้อมูลและ eligibility ของ rich results แต่ไม่มี schema พิเศษที่รับประกัน AI citation [1][20]
ความเชื่อที่ 4 “เขียนย่อหน้าสั้นเสมอแล้วติด AI” — passage clarity มีเหตุผล แต่ไม่มีความยาวสากลที่ผู้ให้บริการรับรอง บางเรื่องต้องการบริบทและข้อยกเว้น ถ้าตัดจน claim ผิด ความน่าเชื่อถือจะเสีย
ความเชื่อที่ 5 “อ้างแหล่งเยอะที่สุดจะได้ +40%” — ตัวเลข visibility improvement จากงาน GEO ยุคแรกเป็นผลใน benchmark เฉพาะ และไม่ได้แปลเป็น traffic uplift แบบเดียวกันทุกแพลตฟอร์ม [13][14]
ความเชื่อที่ 6 “ตรวจ ChatGPT ครั้งเดียวก็รู้ GEO ranking” — generative answers มีความแปรผัน ต้องรันซ้ำและใช้ prompt variants [15]
ความเชื่อที่ 7 “ถ้า AI สรุปคำตอบได้ ก็ไม่ต้องสน traffic” — สำหรับธุรกิจ referral ยังมีคุณค่า โดยเฉพาะ conversion, subscription และ first-party audience กลยุทธ์ต้องออกแบบทั้ง visibility และ click incentive
ความเชื่อที่ 8 “ผลิตคอนเทนต์ AI จำนวนมากเพื่อครอบทุก prompt” — Google เตือนชัดว่าการสร้างเนื้อหาปริมาณมากโดยไม่เพิ่มคุณค่าอาจเข้าข่าย scaled content abuse [21] วิธีที่ยั่งยืนกว่าคือสร้าง topical depth และ original information
แผน 90 วันสำหรับองค์กรหรือเว็บไซต์ที่ต้องการเริ่ม GEO อย่างจริงจัง
ช่วงวัน 1-30 ให้ทำ Baseline และ Technical Hygiene ตรวจ robots, indexation, Search Console, analytics, referrer ของ AI tools และสร้าง prompt set ที่สอดคล้องกับ 20-30 หัวข้อธุรกิจหลัก บันทึกว่าแบรนด์ถูก mention/cite ที่ไหน คู่แข่งใดถูกเลือก และ source domains ใดปรากฏซ้ำ อย่าแก้ทุกอย่างพร้อมกัน เพราะจะไม่รู้ว่าอะไรสัมพันธ์กับผล
ช่วงวัน 31-60 เลือก 5-10 หน้าที่มี business value สูงและปรับ content quality ก่อน เพิ่มคำตอบตรง intent, citation to primary sources, author/methodology, original examples, comparison table และ internal links หากมี data ที่ทีมสร้างเองให้ยกขึ้นมาเป็นจุดเด่น อย่าเปลี่ยน title/URL/architecture โดยไม่จำเป็นพร้อมกันทั้งหมด
ช่วงวัน 61-90 วัดซ้ำ prompt set ด้วยวิธีเดิมและเทียบ baseline ดูทั้ง traditional organic metrics, generative impressions ถ้ามี Search Console report, AI referrals และ conversion quality หาก citation เพิ่มแต่ traffic ไม่เพิ่ม ให้ถามว่าคำถามนั้นเป็น zero-click by nature หรือ landing page ไม่มีเหตุผลให้คลิก หาก traffic เพิ่มแต่ conversion ต่ำ ให้แก้ user journey หลัง click แทนที่จะหมกมุ่นกับ citation
หลัง 90 วันจึงค่อยตัดสินใจว่าจะขยาย GEO program อย่างไร หัวข้อที่มี visibility gap ใหญ่แต่มี commercial/educational value สูงควรลงทุนเพิ่ม หัวข้อที่ AI ตอบจบง่ายและไม่มี conversion value อาจไม่ควรไล่ citation ส่วน topic ที่เว็บไซต์มี original authority ควรสร้าง cluster และ update cadence ระยะยาว
การวาง governance ก็สำคัญ ทีมควรกำหนดว่า claim ประเภทใดต้อง primary source, ใครรับผิดชอบ update, จะเก็บ evidence ของ benchmark อย่างไร และ AI-generated drafts ต้องผ่าน human review ขั้นไหน เมื่อ AI Search ให้รางวัลกับข้อมูลที่ตรวจสอบง่าย ความมีวินัยด้าน editorial process เองก็กลายเป็น competitive advantage
โอกาสเฉพาะของเว็บไซต์ภาษาไทยในยุค AI Search
เว็บไซต์ภาษาไทยมีทั้งความเสี่ยงและโอกาส ความเสี่ยงคือโมเดลสามารถสรุปแหล่งภาษาอังกฤษจำนวนมากมาเป็นภาษาไทยได้ ทำให้บทความแปลข่าวหรือเรียบเรียงเอกสารต่างประเทศแบบผิวเผินถูกแทนที่ง่ายขึ้น แต่โอกาสคือข้อมูลจำนวนมากในบริบทไทยยังไม่มี primary source ที่อธิบายดี อ่านง่าย และมีโครงสร้างสำหรับคนทั่วไป
หัวข้อเช่น AI ในโรงเรียนไทย, กฎหมายและแนวทางกำกับ AI, การใช้ Local LLM กับภาษาไทย, benchmark TTS/STT ภาษาไทย, AI สำหรับเอกสารราชการ, privacy ในองค์กรไทย หรือการเปรียบเทียบ workflow ที่ใช้บริการในประเทศไทย มี information gap ที่สรุปจากต่างประเทศอย่างเดียวไม่ได้ หากเว็บไซต์สร้างข้อมูลเหล่านี้เอง ก็มีโอกาสเป็น source of record ของภาษาไทย
อีกโอกาสคือ bilingual authority บทความหลักอาจเป็นภาษาไทย แต่ชื่อผลิตภัณฑ์ คำศัพท์มาตรฐาน paper title และ technical term ควรเก็บรูปอังกฤษที่ถูกต้องไว้ด้วย เพื่อช่วยการเชื่อม entity และทำให้ผู้อ่านค้นต่อได้ง่าย การแปลคำทุกคำจนไม่เหลือชื่อมาตรฐานอาจทำให้เกิด ambiguity โดยไม่จำเป็น
เว็บไซต์ไทยควรลงทุนใน quality translation ของหลักฐาน ไม่ใช่แปลเฉพาะเนื้อหา เช่น เมื่อ cite Google Search Central ให้สรุปสาระไทยอย่างแม่น แล้วลิงก์ไป official source อังกฤษ เมื่อ cite งานวิจัยให้บอกข้อจำกัดของ methodology ด้วย วิธีนี้ทำให้บทความเป็น bridge ระหว่างองค์ความรู้สากลกับผู้อ่านไทย ซึ่งเป็น value ที่ AI summary ทั่วไปอาจทำได้ไม่ละเอียดเท่า
สุดท้าย การสร้าง community และ feedback loop เป็น asset สำคัญ ความคิดเห็น คำถามจริงจากผู้อ่าน แบบสำรวจ หรือข้อมูล usage ที่ได้รับความยินยอมสามารถช่วยบอกว่า user intent ภาษาไทยจริง ๆ คืออะไร แล้วนำกลับไปสร้าง FAQ, benchmark และบทความใหม่ นี่เป็นข้อมูล first-party ที่คู่แข่งคัดลอกยาก
อนาคตของ Search: จาก Information Retrieval ไปสู่ Delegation
AI Search ในปัจจุบันยังเน้นการค้นและสังเคราะห์ข้อมูล แต่ทิศทางผลิตภัณฑ์กำลังขยับไปสู่ agentic search ที่ไม่เพียงบอกคำตอบ แต่ช่วยลงมือทำ เช่น เปรียบเทียบสินค้า วางแผนการเดินทาง กรอกข้อมูล หรือเชื่อมต่อบริการภายนอก เมื่อ Search เปลี่ยนจาก “ช่วยฉันรู้” เป็น “ช่วยฉันทำ” เว็บไซต์ต้องคิดต่อว่าข้อมูลและบริการของตนสามารถถูก machine action ใช้งานได้อย่างปลอดภัยอย่างไร
ในโลกนั้น content visibility อาจไม่พอ API, product feeds, merchant data, structured business information, availability และ transactional integration จะมีบทบาทมากขึ้น สำหรับเว็บสื่อหรือเว็บความรู้ สิ่งที่สร้างคุณค่าจะเป็น provenance, expertise, original reporting และ trust ส่วนเว็บบริการอาจต้องทำให้ agent เข้าใจ action schema และขั้นตอนธุรกรรมอย่างถูกต้อง
อย่างไรก็ตาม การคาดการณ์เหล่านี้ควรแยกจากสิ่งที่ผู้ให้บริการรับรองในปัจจุบัน เราไม่ควรรีบสร้าง architecture ตามสมมติฐานว่าทุก search จะกลายเป็น agent ภายในหนึ่งปี สิ่งที่ควรทำตอนนี้คือทำฐานข้อมูลและ content infrastructure ให้สะอาด มี semantics ที่ดี มี API/feeds เมื่อมีเหตุผลทางธุรกิจ และรักษาสิทธิ์ควบคุม crawler/data usage ให้ชัด
ประวัติของ SEO สอนเราว่าคนที่ชนะระยะยาวไม่ใช่คนที่ไล่ช่องโหว่อัลกอริทึมทุกครั้ง แต่คือคนที่สร้างระบบเผยแพร่ข้อมูลที่มีคุณภาพ สม่ำเสมอ และปรับตัวทันช่องทางใหม่ GEO น่าจะเดินเส้นทางเดียวกัน จากช่วงแรกที่เต็มไปด้วยสูตรและคำศัพท์การตลาด ไปสู่ discipline ที่รวม content strategy, information retrieval, analytics และ brand authority เข้าด้วยกัน
กรณีศึกษาเชิงแนวคิด: ถ้าเว็บมีบทความดีอยู่แล้ว แต่ AI ไม่อ้างอิง ควรวิเคราะห์อย่างไร
สมมติเว็บไซต์หนึ่งมีบทความคุณภาพสูงเรื่อง “AI อ่าน PDF ภาษาไทยได้ดีที่สุดตัวไหน” และติดอันดับ Search ได้ดี แต่เมื่อลองถาม ChatGPT Search หรือ AI Mode กลับไม่ค่อยถูกอ้างอิง การตอบสนองที่ผิดคือรีบแก้ข้อความทั้งบทให้เป็นภาษาที่คิดว่า AI ชอบ เพราะเราไม่รู้ด้วยซ้ำว่าปัญหาอยู่ตรง generation หรือเกิดก่อนหน้านั้น วิธีที่ถูกต้องคือไล่ pipeline ทีละชั้น
ชั้นแรกตรวจ access และ indexability ถ้า Googlebot หรือ OAI-SearchBot เข้าไม่ได้ ต่อให้เนื้อหาดีเพียงใดก็ไม่มีโอกาสในหลาย retrieval path ตรวจ robots.txt, response code, canonical, noindex, CDN และ WAF จากนั้นตรวจว่า URL มี organic impressions และถูกค้นพบจาก keyword ที่เกี่ยวข้องหรือไม่ หากไม่มี ปัญหาหลักยังเป็น SEO/discoverability ไม่ใช่ GEO
ชั้นถัดมาตรวจ relevance และ passage structure บทความอาจติดอันดับด้วย authority ของโดเมน แต่คำตอบเฉพาะที่ AI ต้องการกระจายอยู่หลายย่อหน้า เช่นเกณฑ์ทดสอบอยู่ตอนต้น ผลทดสอบอยู่ในภาพ และข้อจำกัดอยู่ท้ายบท หาก information unit สำคัญไม่อยู่ใน text หรือไม่มี heading ชัด ระบบ retrieval อาจหา passage ที่ตอบ query ได้ไม่ดี การแก้จึงควรย้ายข้อมูลสำคัญมาอยู่ใน text ที่อ่านได้ เพิ่มตาราง methodology/result และทำ heading ให้ตรงกับคำถามจริง
จากนั้นตรวจ source uniqueness หากบทความเพียงรวบรวม specification จากเว็บไซต์ผู้ผลิต AI อาจเลือก cite primary source แทนเราอย่างสมเหตุผล วิธีสร้างเหตุผลให้ถูก cite คือเพิ่มสิ่งที่ primary source ไม่มี เช่น benchmark ภาษาไทยชุดเดียวกัน คะแนน OCR สำหรับเอกสารสแกน ตาราง error cases และวิธีทดสอบที่ทำซ้ำได้ เมื่อเราเป็นผู้สร้าง evidence เอง บทบาทของเว็บเปลี่ยนจาก secondary summary เป็น source
สุดท้ายจึงวัด citation behavior ด้วย prompt panel หลายรูปแบบ เช่น “AI ตัวไหนอ่าน PDF ไทยดีที่สุด”, “เปรียบเทียบ ChatGPT Gemini Claude กับ PDF สแกนภาษาไทย”, “เครื่องมือไหนดึงตารางไทยจาก PDF ได้ดี” รันซ้ำหลายครั้ง แล้วดูว่าเว็บปรากฏใน subset ไหน หากปรากฏเฉพาะ prompt ที่พูดถึงภาษาไทยแต่ไม่ปรากฏ prompt ทั่วไป นั่นอาจไม่ใช่ปัญหา แต่สะท้อน niche authority ที่ชัดเจนและมีคุณค่า
วิธีสร้าง GEO Experiment ที่ไม่หลอกตัวเอง
ทีมคอนเทนต์มักตกหลุม confirmation bias ได้ง่ายมาก เพราะ AI answer เปลี่ยนได้ตลอด หากเราแก้บทความแล้วถามใหม่จนกว่าจะเห็นเว็บตัวเองถูก cite เราสามารถ “พิสูจน์” เทคนิคแทบทุกอย่างได้ วิธีทดลองที่ดีกว่าคือกำหนด protocol ก่อนแก้ เช่นมี prompt 40 ข้อ แต่ละข้อมี paraphrase 3 แบบ รัน 3 ครั้งต่อแบบ และบันทึกผลก่อน-หลังด้วยช่วงเวลาที่ใกล้เคียงกัน
ควรแบ่ง prompt เป็นกลุ่มตาม intent เพราะผลของการแก้บางอย่างอาจช่วยเฉพาะ comparison queries แต่ไม่ช่วย definition queries ตัวอย่างเช่นการเพิ่มตาราง benchmark น่าจะมีประโยชน์ต่อคำถาม “A กับ B ต่างกันอย่างไร” มากกว่าคำถาม “A คืออะไร” การรวมทุก prompt เป็นคะแนนเดียวอาจซ่อนผลที่มีความหมาย
ตัวแปรที่เก็บควรมีอย่างน้อย source URL, domain, citation present/absent, mention present/absent, order/prominence โดยประมาณ, factual role ของ citation และ final answer theme หากระบบ cite เว็บเราเพราะบทความมีคำจำกัดความ แต่ไม่ใช้ benchmark ที่เพิ่งเพิ่ม การบอกว่า benchmark ทำให้ GEO ดีขึ้นก็ยังเร็วเกินไป
หากมีทรัพยากร ควรสร้าง control pages หรืออย่างน้อย comparison group ของหน้าที่ไม่ได้แก้ เพื่อช่วยแยกการเปลี่ยนแปลงจาก platform update ออกจากผลของ content edit เช่นถ้า citation ของทั้งเว็บเพิ่มพร้อมกันหลัง engine update การเพิ่มขึ้นของหน้า test อาจไม่ได้เกิดจากการแก้บทความ
การทดลองควรบันทึกวันที่ รุ่นหรือชื่อประสบการณ์ของแพลตฟอร์มเท่าที่มองเห็นได้ ประเทศ/ภาษา และสถานะ login หากเกี่ยวข้อง เพราะ personalization และ localization สามารถเปลี่ยนผลได้ การเก็บรายละเอียดนี้ทำให้ข้อมูลมีค่าต่อการตัดสินใจในอนาคต ไม่ใช่เพียง screenshot เพื่อโชว์ว่าติด AI ครั้งหนึ่ง
เป้าหมายของ GEO experiment ไม่ใช่พิสูจน์ว่าเทคนิคของเราถูก แต่คือหักล้างสมมติฐานให้ได้เร็วที่สุด หากการเพิ่ม FAQ ไม่เปลี่ยน citation แต่ original data ทำให้ citation เพิ่มใน comparison prompts อย่างสม่ำเสมอ เราเรียนรู้ว่าควรลงทุนกับข้อมูลต้นฉบับมากกว่าการเพิ่มข้อความซ้ำ นั่นคือ value ของ experimentation จริง ๆ
Technical Checklist สำหรับ WordPress และเว็บไซต์คอนเทนต์
สำหรับ WordPress ปัญหาทางเทคนิคที่พบบ่อยไม่ได้เกิดจาก AI โดยตรง แต่ส่งผลต่อ AI Search ผ่าน Search infrastructure เริ่มจาก XML sitemap ต้องมีเฉพาะ URL canonical ที่ต้องการ index, category/tag archives ที่ไม่มีคุณค่าไม่ควรสร้างพื้นที่ crawl จำนวนมาก, pagination และ parameter URLs ต้องจัดการอย่างมีเหตุผล และหน้า content หลักไม่ควรถูกซ่อนหลัง JavaScript ที่ crawler render ยากโดยไม่จำเป็น
ตรวจ robots.txt ว่าไม่ได้ใช้ rule กว้างจน block bot ที่ต้องการ ตัวอย่างที่ต้องคิดแยกคือ Googlebot สำหรับ Google Search, OAI-SearchBot สำหรับ ChatGPT Search และ GPTBot สำหรับนโยบาย potential training ของ OpenAI [9] การตัดสินใจควรอิงนโยบายข้อมูลของเว็บไซต์ ไม่ใช่คัด robots template จากเว็บอื่นโดยไม่เข้าใจผล
ตรวจ HTTP status และ performance ให้หน้า article ตอบ 200 เสถียร ไม่เกิด redirect chain หลายชั้น และ CDN ไม่ challenge bot ด้วย CAPTCHA หากมี firewall logs ให้ sampling request จาก crawler ที่ประกาศไว้และดู 403/429 rates โดยเฉพาะหลังเปลี่ยน security plugin
ให้ข้อมูลสำคัญอยู่ใน HTML text ที่ผู้ใช้เห็นจริง ตารางเปรียบเทียบที่ render เป็นภาพอย่างเดียวอาจสวย แต่ทำให้ข้อมูลเข้าถึงยากขึ้นทั้งด้าน accessibility และ retrieval ควรมี HTML table หรือ text alternative ที่มีข้อมูลเท่ากัน ภาพใช้เสริม visualization ไม่ใช่เป็นที่อยู่เดียวของข้อเท็จจริงหลัก
ทำ structured data เท่าที่ตรงชนิดเนื้อหาและ validate ด้วยเครื่องมือของ Google [20] Article/Breadcrumb/Organization/ProfilePage อาจเหมาะตามบริบท แต่ markup ต้องตรงกับ visible content เสมอ อย่าใส่ rating, author credentials หรือ FAQ ที่หน้าไม่มีจริง เพราะสร้างความเสี่ยงด้าน policy โดยไม่ใช่ทางลัดไป AI citation
สำหรับ internal linking ให้สร้าง hub ที่เป็นเส้นทางการเรียนรู้มากกว่าลิงก์อัตโนมัติจำนวนมาก Anchor text ควรบอกปลายทาง เช่น “เข้าใจ RAG และ grounding” หรือ “วิธีวัด citation จาก ChatGPT” และหน้า orphan ที่ไม่มีลิงก์จากเนื้อหาหลักควรถูกนำเข้ามาใน architecture หากยังมีคุณค่า
สุดท้าย ตั้งระบบ monitoring หลัง deploy เช่น Search Console coverage/performance, uptime, analytics และ server logs หากมี ทีมจะสามารถแยกได้เร็วว่าการลด visibility มาจาก technical incident, search demand, platform change หรือ content issue แทนการโยนทุกอย่างให้คำว่า algorithm update
Editorial Checklist ก่อนกด Publish ในยุค AI Search
ก่อนเผยแพร่ ให้ถามข้อแรกว่า “บทความนี้มีคำตอบหรือข้อมูลใหม่อะไรที่หน้าอื่นไม่มี” หากตอบไม่ได้ ควรเพิ่ม original example, test, framework หรือการสังเคราะห์ที่มีเหตุผล การเขียนใหม่ด้วยถ้อยคำต่างจากคู่แข่งไม่เท่ากับ information gain
ถามข้อสองว่า “ทุก claim ที่เปลี่ยนได้มี source หรือไม่” รายละเอียดอย่างจำนวนผู้ใช้ วันที่เปิดตัว availability ราคา รุ่นโมเดล หรือนโยบาย crawler ควรย้อนกลับไปแหล่งทางการหรือ research ที่ตรวจสอบได้ และใส่วันที่ของข้อมูลเมื่อมีโอกาสเปลี่ยนสูง
ถามข้อสามว่า “ผู้อ่านเห็นความแตกต่างระหว่าง fact, inference และ recommendation หรือไม่” ตัวอย่างเช่น Fact: Google บอกว่าไม่ต้องมี special schema สำหรับ AI Overviews; Inference: โครงสร้าง heading ที่ดีน่าจะช่วย passage retrieval; Recommendation: เว็บไซต์ควรใช้ heading ตรงคำถามหลัก การแยกสามระดับนี้ทำให้บทความน่าเชื่อถือกว่าการพูดทุกอย่างด้วยน้ำเสียงมั่นใจเท่ากัน
ถามข้อสี่ว่า “หัวข้อและย่อหน้าสามารถเข้าใจโดยไม่ต้องอ่านบริบทสิบย่อหน้าก่อนหรือไม่” ไม่ได้หมายถึงทุกย่อหน้าต้อง standalone 100% แต่ส่วนที่มี definition, comparison, steps หรือข้อควรระวังควรมี subject ชัด ไม่ใช้คำว่า “มัน” หรือ “สิ่งนี้” จนไม่รู้ว่าอ้างถึง entity ใด
ถามข้อห้าว่า “มีส่วนที่ AI สรุปผิดได้ง่ายหรือไม่” หากมีตัวเลขที่มี denominator เฉพาะ งาน observational หรือ benchmark ที่ใช้ dataset จำกัด ให้ใส่ข้อจำกัดในย่อหน้าเดียวกับผล ไม่ควรวาง disclaimer ห่างไปหลายหน้าจน passage extraction ตัดเงื่อนไขออก
ถามข้อหกว่า “บทความมีเหตุผลให้คลิกเข้ามาหลังเห็น AI summary หรือไม่” เช่น downloadable checklist, benchmark table, interactive tool, images จากการทดลอง, dataset, code, template หรือรายละเอียดเชิงลึก ถ้าไม่มีเลย บทความ informational พื้นฐานอาจสร้าง visibility แต่สร้าง traffic ต่ำ ซึ่งต้องสอดคล้องกับเป้าหมายของเว็บไซต์
ถามข้อเจ็ดว่า “อัปเดตครั้งต่อไปจะรู้ได้อย่างไรว่าต้องแก้อะไร” ใส่ source list, research notes หรือ changelog ภายในระบบ editorial เพื่อให้ทีมรู้ว่า claim ไหนขึ้นกับเอกสารใด เมื่อ Google หรือ OpenAI เปลี่ยน policy จะได้แก้เฉพาะส่วนที่ได้รับผลกระทบแทนการเขียนใหม่ทั้งบท
และถามข้อสุดท้ายว่า “ถ้าตัดคำว่า GEO ออกจากบทความนี้ เนื้อหายังมีประโยชน์ต่อมนุษย์หรือไม่” ถ้าคำตอบคือไม่ แปลว่าเราอาจกำลัง optimize เพื่อแนวคิดทางการตลาดมากกว่าผู้อ่าน เป้าหมายที่ยั่งยืนที่สุดยังคงเป็นการสร้างแหล่งข้อมูลที่คนอยากเชื่อและระบบมีเหตุผลจะอ้าง
GEO Readiness Checklist: แบบประเมิน 30 ข้อก่อนลงทุนกับ AI Search
ด้านการเข้าถึง: 1) หน้าเป้าหมายตอบ HTTP 200 และไม่มี redirect chain ที่ไม่จำเป็น 2) Googlebot เข้าถึงได้ 3) OAI-SearchBot เข้าถึงได้หากต้องการ visibility ใน ChatGPT Search 4) CDN/WAF ไม่ block crawler โดยไม่ตั้งใจ 5) robots.txt สะท้อนนโยบายจริงขององค์กร ไม่ใช่ template ที่คัดลอกมา 6) หน้าไม่มี noindex หรือ canonical ผิด 7) XML sitemap มี URL canonical ที่ต้องการ index และอัปเดตสม่ำเสมอ
ด้านโครงสร้างเว็บไซต์: 8) บทความสำคัญไม่เป็น orphan page 9) มี hub หรือ pillar เชื่อม cluster ที่เกี่ยวข้อง 10) anchor text ของ internal link บอกหัวข้อปลายทาง 11) breadcrumb และ navigation ช่วยให้เข้าใจ hierarchy 12) หน้า duplicate, tag และ archive ที่ไม่มีคุณค่าถูกควบคุม 13) important content อยู่ใน text ที่เข้าถึงได้ ไม่ซ่อนอยู่ในภาพหรือ widget เพียงอย่างเดียว
ด้านคุณภาพเนื้อหา: 14) คำถามหลักได้รับคำตอบชัดในช่วงต้น 15) แต่ละ H2 มีประเด็นเฉพาะและไม่ใช้ heading กว้างเกินไป 16) claim สำคัญมี evidence ที่ตรวจสอบได้ 17) แหล่งปฐมภูมิถูกเลือกก่อนบทสรุปจากบุคคลที่สามเมื่อเหมาะสม 18) มีข้อจำกัดหรือ caveat ใกล้กับตัวเลข/ผลวิจัยที่อาจถูกตีความเกินจริง 19) มี original information หรือ local context ที่คู่แข่งไม่มี 20) ผู้เขียน วิธีทดสอบ และวันที่อัปเดตชัดเจน
ด้าน machine readability โดยไม่เสียคนอ่าน: 21) entity เช่นชื่อบริษัท โมเดล เวอร์ชัน และวันที่ระบุชัด 22) ตารางใช้ HTML/text ที่อ่านได้ 23) structured data ตรงกับ visible content และใช้ชนิดที่มีเหตุผล 24) ไม่มีการยัด keyword หรือสร้าง FAQ ซ้ำเพียงเพื่อหวัง AI citation 25) ไม่มีข้ออ้างว่า schema, llms.txt หรือเทคนิคใดรับประกัน AI ranking หากไม่มีหลักฐานทางการ
ด้านการวัดผล: 26) มี baseline organic metrics ก่อนปรับ 27) มี prompt set ที่สะท้อนคำถามจริงของผู้ใช้ 28) มี repeated runs และ prompt paraphrases เพื่อลดความผิดพลาดจากความแปรผัน 29) analytics แยก AI referrals เช่น chatgpt.com ได้ 30) ทีมเชื่อม visibility metrics กับ engagement/conversion แทนการไล่ citation count ดิบ
หากเว็บไซต์ผ่านไม่ถึงครึ่งของ checklist นี้ ไม่ควรรีบซื้อเครื่องมือ GEO ราคาแพง เพราะปัญหาหลักอาจยังอยู่ที่ technical SEO, editorial quality หรือ analytics แต่หากพื้นฐานครบแล้ว เครื่องมือ monitoring และการทดลอง citation สามารถช่วยหาช่องว่างที่ละเอียดขึ้นได้อย่างมีเหตุผล
การใช้ checklist ควรทำเป็นรอบ ไม่ใช่ครั้งเดียว เทคโนโลยี search เปลี่ยนเร็ว นโยบาย crawler และ reporting เปลี่ยนได้ และบทความ evergreen เองก็สะสม technical debt ได้ ควรกำหนด review cadence เช่นรายไตรมาสสำหรับ pillar content และตรวจทันทีเมื่อมี major platform update ที่เกี่ยวกับ search visibility
ที่สำคัญ อย่าใช้คะแนน readiness เป็นเป้าหมายปลายทาง เว็บไซต์ที่ผ่าน 30/30 แต่ไม่มีข้อมูลที่คนต้องการก็ไม่ชนะ ส่วนเว็บไซต์ที่มีงานวิจัยต้นฉบับทรงคุณค่าแม้ UX ยังไม่สมบูรณ์อาจได้รับการอ้างอิงสูงมาก Checklist มีไว้ลดความผิดพลาดพื้นฐาน ไม่ได้แทนคุณภาพและความสำคัญของความรู้ที่เผยแพร่
คำถามที่พบบ่อย (FAQ)
GEO จะมาแทน SEO หรือไม่?
ไม่น่าจะเป็นการแทนที่แบบหนึ่งต่อหนึ่ง โดยเฉพาะ Google ที่ระบุว่า AI features ยังพึ่ง Search index และ ranking systems เดิม SEO จึงยังเป็นฐานด้าน crawl, index, relevance และ quality ส่วน GEO เพิ่มโจทย์การถูกเลือก อ้างอิง และนำไปใช้ในคำตอบ generative [1][2]
GEO กับ AEO ต่างกันอย่างไร?
คำศัพท์ยังไม่มีมาตรฐานกลาง AEO มักเน้นการทำเนื้อหาให้ตอบคำถามตรงและเหมาะกับ answer surfaces ขณะที่ GEO มักเน้น visibility ใน generative engines ที่สังเคราะห์จากหลายแหล่ง ทั้งสองส่วนทับซ้อนกันมาก
ต้องติดตั้ง llms.txt หรือไม่?
สำหรับ Google AI Overviews/AI Mode ไม่ใช่ข้อกำหนด Google ระบุว่าไม่จำเป็นต้องมี AI text files หรือ special markup เพื่อให้ปรากฏใน AI features [1] หากใช้ llms.txt ควรมองเป็นมาตรฐานทดลอง/เครื่องมือเสริมใน ecosystem บางส่วน ไม่ใช่ ranking requirement ที่ได้รับการยืนยัน
Structured data ช่วย GEO ไหม?
ช่วย Search เข้าใจความหมายและชนิดข้อมูล รวมถึง eligibility ของ rich results แต่ไม่มีหลักฐานทางการว่าการเพิ่ม schema จะรับประกัน AI citation Google ระบุว่าไม่มี special schema ที่จำเป็นสำหรับ AI features [1][20]
ควรเขียนบทความให้สั้นเพื่อให้ AI อ่านง่ายหรือไม่?
ไม่ควรใช้ความสั้นเป็นเป้าหมายหลัก ควรใช้ความชัดเจนและโครงสร้างเป็นเป้าหมาย ตอบตรงก่อนแล้วขยายรายละเอียดตามความจำเป็น หัวข้อซับซ้อนต้องมีบริบทและข้อจำกัดเพื่อป้องกันการสรุปผิด
จะรู้ได้อย่างไรว่า ChatGPT ส่ง traffic มาให้เว็บไซต์?
OpenAI ระบุว่า referral links สามารถมี utm_source=chatgpt.com จึงตรวจใน GA4 หรือ analytics อื่นได้ [9] ควรติดตามทั้ง session, engagement และ conversion ไม่ใช่ traffic อย่างเดียว
จะวัดว่าเว็บถูก AI cite มากขึ้นได้อย่างไร?
สร้างชุด prompt ที่คงที่ แบ่งตาม intent แล้วรันซ้ำหลายครั้งต่อแพลตฟอร์ม เก็บ mention rate, citation rate และ competitor share การวัดครั้งเดียวไม่น่าเชื่อถือเพราะคำตอบมีความแปรผัน [15]
การเพิ่มสถิติและ citation ในบทความช่วยให้ถูก cite มากขึ้นจริงไหม?
งาน GEO ยุคแรกพบผลเชิง visibility ในบาง domain และ environment แต่ผลไม่ได้แปลเป็น organic discoverability หรือ traffic uplift โดยอัตโนมัติ งานทบทวนปี 2026 แนะนำให้ระวังการขยายผลเกินหลักฐาน [13][14]
เว็บไซต์เล็กมีโอกาสชนะ AI Search หรือไม่?
มี โดยเฉพาะ niche ที่มีข้อมูลต้นฉบับและความเชี่ยวชาญเฉพาะ แต่ไม่มีสูตรรับประกัน การสร้าง primary data, practical experience และ earned references เป็นแนวทางที่มีเหตุผลมากกว่าการพยายามเลียนแบบเว็บใหญ่
ควรเริ่มจาก GEO tool หรือปรับเว็บก่อน?
เริ่มจาก technical access, indexability, content quality และ analytics ก่อน จากนั้นค่อยใช้เครื่องมือช่วย monitor citations หากพื้นฐานยังมีปัญหา GEO dashboard ที่สวยก็ไม่แก้ discoverability
บทสรุป
AI Search ไม่ได้ทำให้เว็บหายไป แต่เปลี่ยนบทบาทของเว็บจาก “หน้าปลายทางทุกครั้ง” เป็น “โครงสร้างความรู้ที่อาจถูกนำไปสังเคราะห์ก่อนผู้ใช้ตัดสินใจคลิก” นี่เป็นการเปลี่ยน distribution model ที่สำคัญมาก เพราะเว็บไซต์สามารถมีอิทธิพลต่อคำตอบแม้ traffic ไม่ได้เพิ่มในสัดส่วนเดิม และในอีกด้านหนึ่งก็ทำให้เจ้าของเว็บต้องสร้างเหตุผลใหม่ว่าทำไมผู้ใช้ควรออกจาก AI answer แล้วเข้ามาหาเรา
GEO มีประโยชน์ในฐานะภาษาสำหรับคุยเรื่อง visibility ในโลก generative แต่การมองมันเป็น SEO เวอร์ชันใหม่ที่มีสูตรเฉพาะคือการสรุปเร็วเกินไป หลักฐานปัจจุบันบอกให้เรากลับไปสนใจพื้นฐานมากกว่าหาทางลัด: crawl ได้, index ได้, ตรง intent, มีข้อมูลต้นฉบับ, อ้างหลักฐาน, ระบุ entity ชัด, อัปเดตอย่างมีเหตุผล และวัดผลแบบซ้ำได้
สำหรับเจ้าของเว็บไซต์ไทย นี่อาจเป็นช่วงเวลาที่ดีมาก หากเราหยุดแข่งขันด้วยการผลิตบทความที่เหมือนกัน แล้วหันมาสร้างแหล่งข้อมูลภาษาไทยที่มี methodology และประสบการณ์จริง เมื่อ AI ต้องเลือก source เพื่ออธิบายหัวข้อให้ผู้ใช้ มันย่อมต้องพึ่งข้อมูลที่มีอยู่บนเว็บ ถ้าเรากลายเป็นผู้สร้างข้อมูลต้นฉบับที่ดีที่สุดใน niche ของเรา เราไม่ได้ optimize เฉพาะเพื่อ AI Search แต่กำลังสร้าง authority ที่มีคุณค่าต่อทุกช่องทาง
คำถามที่เหมาะกับปี 2026 จึงไม่ใช่ “SEO หรือ GEO อะไรจะชนะ” แต่คือ “เราจะทำให้ความรู้ของเราถูกค้นพบ เข้าใจ อ้างอิง และสร้างคุณค่าต่อผู้ใช้ได้อย่างไร ไม่ว่าประตูทางเข้าจะเป็น Google, ChatGPT, Gemini, Copilot, Perplexity หรือระบบใหม่ที่ยังไม่เกิดขึ้น” หากตอบคำถามนี้ได้ดี เราจะไม่ต้องวิ่งตามชื่อเรียกใหม่ทุกปี
ภาพสรุป: จากหน้าเว็บสู่คำตอบที่มีแหล่งอ้างอิง
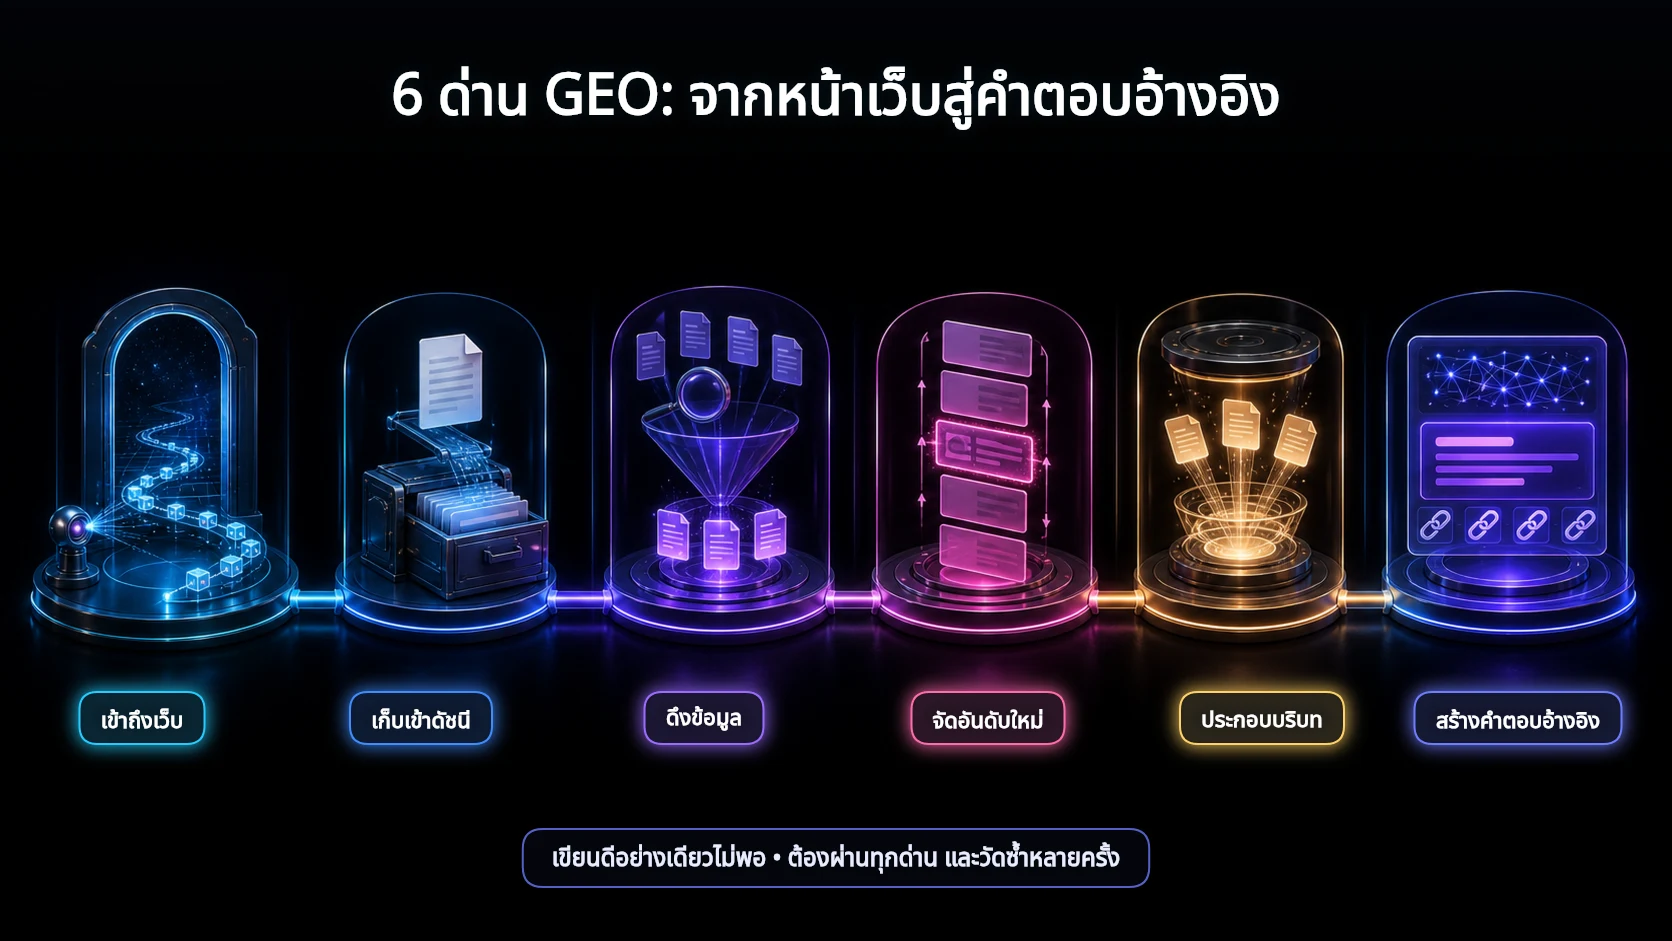
ภาพนี้ไม่ใช่ผังภายในของแพลตฟอร์มใดแพลตฟอร์มหนึ่ง แต่เป็น Mental Model สำหรับวินิจฉัยงาน หากผลไม่ดี ให้ระบุด่านที่ล้ม หลักฐานที่รองรับ และ Metric ที่จะใช้ยืนยันก่อนเปลี่ยนเนื้อหา
ปูพื้นกลไก AI ก่อนวางกลยุทธ์ Search
ถ้าต้องการเข้าใจว่าข้อมูล โมเดล การอนุมาน และการตรวจสอบเชื่อมกันอย่างไร เริ่มจากบทเรียนพื้นฐานของ Insightful AI World
อ่าน “AI คืออะไร” →แหล่งอ้างอิง
ตรวจสอบล่าสุด 9 สิงหาคม 2026 เอกสารผู้ให้บริการใช้สำหรับข้อกำหนดและคุณสมบัติของแพลตฟอร์ม งานวิจัยและข้อมูลอุตสาหกรรมใช้พร้อมขอบเขต ไม่ถือว่าผลหนึ่งใช้แทนทุกประเทศ เว็บไซต์ หรือระบบได้
- Google Search Central — AI features and your website
- Google Search Central — Optimizing your website for generative AI features on Google Search
- Google Search Central Blog — Introducing Search Generative AI performance reports in Search Console (3 Jun 2026)
- Google — New opportunities, control and insights for website owners (3 Jun 2026)
- Google — How AI Mode is changing and expanding the way people search in the U.S. (19 May 2026)
- Google — New ways to find your favorite sources and original content in AI Search (27 May 2026)
- Google — AI in Search is driving more queries and higher quality clicks (6 Aug 2025)
- OpenAI Help Center — ChatGPT Search
- OpenAI Help Center — Publishers and Developers FAQ
- OpenAI — Introducing ChatGPT search
- Microsoft Bing Blog — Introducing Copilot Search in Bing (4 Apr 2025)
- Perplexity — Introducing the Perplexity Publishers Program (30 Jul 2024)
- Aggarwal et al. — GEO: Generative Engine Optimization, KDD 2024 / arXiv:2311.09735
- Martinez — Optimizing Visibility in Generative Engines: A Critical Survey of GEO (2023–2026)
- Schulte, Bleeker & Kaufmann — Don’t Measure Once: Measuring Visibility in AI Search (GEO)
- Zhang, He & Yao — From Citation Selection to Citation Absorption
- Kim et al. — SAGEO Arena: A Realistic Environment for Evaluating Search-Augmented GEO
- Pew Research Center — Google users are less likely to click on links when an AI summary appears (22 Jul 2025)
- Ahrefs — Update: AI Overviews Reduce Clicks by 58% (4 Feb 2026)
- Google Search Central — Introduction to structured data markup in Google Search
- Google Search Central — Guidance on using generative AI content on your website
Editorial Note
บทความนี้แยกข้อความทางการ ผลงานวิจัย การอนุมาน และคำแนะนำเชิงปฏิบัติออกจากกัน ตัวเลข Zero-click, CTR และ GEO visibility มาจากหน่วยวัด ชุดข้อมูล และช่วงเวลาต่างกัน จึงไม่ควรนำมาเทียบตรงหรือใช้เป็นคำรับรองผลลัพธ์ทางธุรกิจ เทคโนโลยี AI Search เปลี่ยนเร็ว ควรตรวจเอกสารทางการอีกครั้งก่อนใช้คำแนะนำด้าน crawler, reporting หรือ platform policy ในอนาคต
