Demo ที่ทำงานในหนึ่งสัปดาห์อาจดูราคาถูก แต่ระบบจริงต้องเชื่อมข้อมูล ตรวจสิทธิ์ สร้างหน้าจอ ฝึกคน ติดตามคุณภาพ รับมือเหตุผิดปกติ และทบทวนรุ่นตลอดอายุ REN จึงไม่เริ่มด้วยคำถามว่า “โมเดลราคาเท่าไร” แต่เริ่มด้วยคำถามที่ใหญ่กว่า: เรากำลังใช้ทรัพยากรอะไรเพื่อเปลี่ยนการตัดสินใจใด ผลลัพธ์ที่ต้องการคืออะไร และใครรับต้นทุนเมื่อระบบผิด
คำตอบหลักของบทนี้คือ ความคุ้มค่าไม่ได้อยู่ในราคา API หรือค่าเครื่องเพียงบรรทัดเดียว แต่อยู่ในหลักฐานว่ากระบวนการดีขึ้นจริงเมื่อเทียบกับ Baseline และทางเลือกอื่น หลังหักต้นทุนข้อมูล ระบบ คน การปฏิบัติการ ความเสี่ยง และการเลิกใช้แล้ว หากยังเชื่อมจากความสามารถของ AI ไปถึงผลลัพธ์ไม่ได้ ตัวเลข ROI ที่ดูสวยก็เป็นเพียงสมมติฐาน
ตลอดบทเราจะใช้สมมติฐาน Pilot เดิมเป็นเส้นเรื่อง: “AI ลดเวลาตรวจ 30% โดย Recall กรณีสำคัญไม่ต่ำกว่า 95%” ตัวเลขนี้เป็น เกณฑ์ที่ต้องทดสอบ ไม่ใช่ผลจริง เราจะย้อนดูว่าต้องเก็บ Baseline อะไร นับต้นทุนชั้นใด เทียบกับทางเลือกใด และต้องหยุดเมื่อหลักฐานแบบไหนไม่ผ่าน
ความรู้ก่อนเรียน: หากทบทวนการกำหนดปัญหาที่เหมาะกับ AI และการแยก AI ออกจากระบบอัตโนมัติทั่วไปในหัวข้อ 27–28 มาก่อน จะช่วยให้เทียบทางเลือกและต้นทุนส่วนเพิ่มได้ชัดขึ้น
เมื่ออ่านจบบทนี้ คุณจะทำอะไรได้
- กำหนด Baseline, Outcome และหลักฐานที่ใช้เปรียบเทียบก่อนเริ่มโครงการได้
- เชื่อม Capability → Workflow Change → Operational Metric → Outcome → Evidence ได้โดยไม่ข้ามเหตุผลสำคัญ
- จัดทำ TCO ที่รวมข้อมูล การพัฒนา โครงสร้างพื้นฐาน คน การปฏิบัติการ ความเสี่ยง และการออกจากระบบได้
- เปรียบเทียบ AI กับกฎ ซอฟต์แวร์ทั่วไป การปรับกระบวนการ และกรณีไม่ทำอะไรด้วย Incremental Value ได้
- ออกแบบ Pilot, Sensitivity, Go/No-Go, Stop Rule และ Rollback เพื่อใช้หลักฐานตัดสินใจได้
1. Mental Model: ความคุ้มค่าคือสายโซ่หลักฐาน ไม่ใช่เลขก้อนเดียว
หลายทีมเริ่มประเมินโครงการด้วยการใส่ค่าพัฒนาไว้ฝั่งต้นทุน แล้วใส่เวลาที่คาดว่าจะประหยัดได้ไว้ฝั่งประโยชน์ จากนั้นคำนวณผลต่าง วิธีนี้ดูเป็นระเบียบแต่ซ่อนคำถามสำคัญไว้มาก เช่น เวลาที่ลดลงถูกนำไปใช้ทำอะไรต่อ ปริมาณงานที่คาดจะเข้าระบบเกิดจริงหรือไม่ ผู้ตรวจต้องใช้เวลาตรวจซ้ำเท่าไร และความผิดพลาดหนึ่งครั้งสร้างงานแก้ไขหรือผลกระทบต่อใคร
Mental Model ที่ใช้ในบทนี้มีห้าชั้นต่อกัน หากชั้นหนึ่งขาด การอ้างคุณค่าหลังจากนั้นจะอ่อนลง ชั้นแรกคือ Capability หรือสิ่งที่ระบบทำได้ ชั้นที่สองคือ Workflow Change หรือขั้นตอนและบทบาทที่เปลี่ยน ชั้นที่สามคือ Operational Metric เช่น เวลา คิว อัตราตรวจซ้ำ หรือการส่งต่อ ชั้นที่สี่คือ Outcome ที่องค์กรและผู้ได้รับผลกระทบเห็นจริง และชั้นสุดท้ายคือ Evidence ที่แยกความคาดหวังออกจากผลพิสูจน์แล้ว
นำสายโซ่นี้ไปวางบนสมมติฐาน Pilot เดิม ความสามารถของ AI คือช่วยประเมินกรณีเพื่อให้เจ้าหน้าที่ตรวจได้เร็วขึ้น แต่ความเร็วของโมเดลยังไม่ใช่คุณค่า หากผลมาถึงหน้าจอที่ใช้ยาก เจ้าหน้าที่ต้องค้นหลักฐานเพิ่ม หรือทุกกรณียังต้องรอการอนุมัติแบบเดิม Workflow ก็อาจไม่เปลี่ยน ดังนั้น “AI ทำงานได้” กับ “โครงการคุ้มค่า” เป็นคนละข้อสรุป
Feedback และมนุษย์อยู่ในสายโซ่ตั้งแต่ต้น เจ้าของงานกำหนดว่า Outcome ใดสำคัญ ผู้ตรวจบอกว่าหลักฐานใดพอใช้ ทีมข้อมูลดูว่าผลจริงย้อนกลับมาเป็นข้อมูลที่เชื่อถือได้หรือไม่ ผู้กำกับความเสี่ยงกำหนดสิ่งที่ยอมรับไม่ได้ และผู้มีอำนาจตัดสินใจเลือกว่าจะขยาย จำกัด ปรับ หรือหยุด ความคุ้มค่าจึงไม่ใช่หน้าที่ของฝ่ายการเงินเพียงทีมเดียว
หลักจำง่าย: อย่าใส่ “ประหยัดเวลา” เป็นคุณค่า จนกว่าจะอธิบายได้ว่าเวลาเดิมวัดอย่างไร เวลาใหม่ลดตรงไหน งานที่หายไปหรือเพิ่มขึ้นอยู่กับใคร และผลลัพธ์ปลายทางเปลี่ยนจริงหรือไม่
2. Baseline: หากไม่รู้ค่าเดิม จะพิสูจน์การเปลี่ยนแปลงไม่ได้
Baseline คือภาพของกระบวนการก่อนการเปลี่ยนแปลง ไม่ใช่เลขหนึ่งตัวที่หยิบจากรายงานเก่า ทีมต้องระบุหน่วยงาน ประเภทงาน ช่วงเวลา วิธีนับ และเงื่อนไขที่ทำให้ข้อมูลเปรียบเทียบกันได้ หากเวลาต่อกรณีในช่วงปกติถูกนำไปเทียบกับ Pilot ในช่วงงานเบา ผลที่ดูดีอาจมาจากปริมาณและความยากที่ต่างกัน ไม่ใช่ระบบใหม่
สำหรับสมมติฐาน “ลดเวลาตรวจ 30%” ต้องแยกเวลารอออกจากเวลาทำงานจริง แยกกรณีทั่วไปออกจากกรณีสำคัญ และบันทึกงานที่เกิดหลังการตรวจ เช่น การขอข้อมูลเพิ่ม การแก้ผลผิด การส่งต่อ และการอุทธรณ์ มิฉะนั้นระบบอาจลดเวลาบนหน้าจอแรกแต่ย้ายงานไปท้ายกระบวนการ ทำให้เวลารวมไม่ได้ลดอย่างที่คิด
Baseline ที่ดีควรรวมคุณภาพและภาระคน ไม่ใช่ดูความเร็วอย่างเดียว ในโจทย์เดิม Recall ของกรณีสำคัญถูกตั้งเป็น Guardrail จึงต้องรู้ก่อนว่ากระบวนการเดิมพบกรณีสำคัญได้อย่างไร ข้อมูลเฉลยมาจากไหน ใครยืนยัน และใช้เวลานานเท่าไร หากนิยาม “กรณีสำคัญ” เปลี่ยนระหว่างทดลอง ตัวเลขก่อนและหลังจะเทียบกันไม่ได้
| มิติ | สิ่งที่ต้องบันทึก | คำถามตรวจคุณภาพ |
|---|---|---|
| ปริมาณและส่วนผสมงาน | จำนวนกรณี ประเภท ความยาก ช่วงพีก | ก่อนและหลังเป็นงานกลุ่มเดียวกันหรือไม่ |
| เวลา | เวลาทำงาน เวลารอ เวลาส่งต่อ เวลาแก้ | จับเวลาในจุดเดียวกันและนิยามเหมือนกันหรือไม่ |
| คุณภาพ | ผลถูก ผลผิด กรณีสำคัญที่พลาด และการตรวจซ้ำ | ใครยืนยันผลจริงและมีความล่าช้าเท่าไร |
| ต้นทุน | แรงงาน ระบบเดิม การแก้ไข และการสนับสนุน | รวมงานหลังบ้านที่มองไม่เห็นหรือยัง |
| ผลต่อคน | ภาระงาน ความเข้าใจ การส่งต่อ และผลแยกกลุ่ม | ค่าเฉลี่ยซ่อนกลุ่มที่ได้รับผลเสียหรือไม่ |
Baseline อาจเป็นกระบวนการคน กฎเดิม ซอฟต์แวร์ทั่วไป หรือการไม่ดำเนินการใดเพิ่มเติม สิ่งสำคัญคือเลือกตัวเปรียบเทียบที่มีอยู่จริง ไม่ใช่เทียบ AI กับโลกสมมติที่ไม่มีต้นทุนและไม่มีวิธีแก้ การทำเช่นนั้นทำให้ประโยชน์ส่วนเพิ่มของ AI ถูกขยายเกินจริง
ก่อนอนุมัติ Pilot ให้มีเจ้าของ Baseline และแบบบันทึกที่ทุกฝ่ายเห็นตรงกัน หากข้อมูลเดิมขาด ให้ระบุช่องว่างและความไม่แน่นอนไว้ ไม่ควรเติมตัวเลขเพื่อให้ตารางครบ ช่องว่างนั้นคือสิ่งที่ Pilot ต้องช่วยเรียนรู้ และอาจเป็นเหตุผลให้ยังประเมินความคุ้มค่าไม่ได้
3. แผนที่คุณค่า: จาก Output ไปถึง Outcome โดยไม่ข้าม Workflow
Output ของโมเดลอาจเป็นคะแนน หมวด คำพยากรณ์ หรือร่างข้อความ แต่ Outcome คือสิ่งที่เกิดหลังจากคนและระบบนำ Output ไปใช้ ความแตกต่างนี้สำคัญเพราะทีมมักนำตัวชี้วัดโมเดลไปแทนผลลัพธ์ธุรกิจ เช่น มองว่า Recall สูงขึ้นเท่ากับบริการดีขึ้น ทั้งที่เจ้าหน้าที่อาจได้รับคำเตือนมากจนตอบสนองไม่ทัน
เริ่มแผนที่คุณค่าด้วยการเขียนผู้ใช้ผลและการกระทำถัดไป ในสมมติฐานของบทนี้ AI ไม่ได้ “ลดเวลา” ด้วยตัวเอง มันส่งผลให้เจ้าหน้าที่จัดลำดับหรือมองหลักฐานได้เร็วขึ้น จากนั้นเจ้าหน้าที่ตรวจ ยืนยัน ส่งต่อ หรือปฏิเสธ หากขั้นตอนหนึ่งยังเป็นคอขวด คุณค่าที่คาดไว้จะไม่ไหลไปถึง Outcome
แยกคุณค่าเป็นสามสถานะเพื่อไม่ให้การคาดการณ์กลายเป็นข้อเท็จจริง สถานะแรกคือ คุณค่าที่ตั้งสมมติฐาน ซึ่งยังอยู่ใน Business Case สถานะที่สองคือ คุณค่าที่สังเกตใน Pilot ซึ่งใช้ได้เฉพาะขอบเขตทดลอง และสถานะที่สามคือ คุณค่าที่ติดตามหลังใช้งาน ซึ่งต้องรวม Drift การเปลี่ยน Workflow ภาระ Support และผลต่อกลุ่มต่าง ๆ
ผู้ได้รับคุณค่า
ระบุว่าใครได้เวลา คุณภาพ ความปลอดภัย หรือการเข้าถึงที่ดีขึ้น และอย่านับคุณค่าซ้ำเมื่อส่งผ่านหลายทีม
ผู้รับต้นทุน
ระบุว่าใครต้องตรวจซ้ำ ฝึกใหม่ รับคำร้อง แก้ Incident หรือรับผลเมื่อระบบผิด เพราะต้นทุนอาจไม่ได้อยู่ทีมเจ้าของงบ
ช่วงเวลาของคุณค่า
แยกประโยชน์ช่วงทดลอง ช่วงขยาย และช่วงปฏิบัติการปกติ เนื่องจากปริมาณ งานยาก และการสนับสนุนอาจเปลี่ยนไป
คุณค่าที่ไม่ใช่ตัวเงินยังต้องวัดอย่างมีวินัย เวลาบริการ คุณภาพ ความปลอดภัย ความเสมอภาค และความสามารถใหม่อาจสำคัญกว่ารายได้ แต่ต้องกำหนดตัวชี้วัด วิธีเก็บหลักฐาน และผู้ตัดสินว่าดีขึ้นเพียงพอหรือไม่ การบอกว่า “ประสบการณ์ดีขึ้น” โดยไม่มีสัญญาณตรวจสอบทำให้ Go/No-Go พึ่งความรู้สึก
สุดท้ายตรวจเหตุและผลอย่างระมัดระวัง หาก Pilot ทำพร้อมกับการปรับแบบฟอร์ม ฝึกเจ้าหน้าที่ และลดปริมาณงาน ผลดีที่พบอาจไม่ได้มาจาก AI เพียงอย่างเดียว Business Case ที่ซื่อสัตย์ควรระบุองค์ประกอบร่วมและหลีกเลี่ยงการให้เครดิตทั้งหมดแก่โมเดล
4. TCO: นับต้นทุนตลอดวงจร ไม่ใช่แค่ API หรือ GPU
Total Cost of Ownership หรือ TCO คือทรัพยากรทั้งหมดที่ต้องใช้เพื่อให้ระบบสร้างและรักษาผลลัพธ์ตลอดอายุ ค่าโมเดลเป็นเพียงส่วนหนึ่ง ระบบใช้งานจริงยังมีข้อมูล การเชื่อมต่อ การทดสอบ หน้าจอ สิทธิ์ การตรวจของคน การติดตามคุณภาพ การรับมือ Incident และการย้ายหรือเลิกใช้
ต้นทุนช่วงต้นมักมองเห็นง่าย เช่น การทดลองและการพัฒนา แต่ต้นทุนต่อเนื่องอาจใหญ่ขึ้นเมื่อปริมาณงานเพิ่ม ข้อมูลเปลี่ยน ผู้ให้บริการเปลี่ยนเงื่อนไข หรือทีมต้องรองรับกรณียกเว้นมากกว่าที่คาด การประเมินจึงต้องแยกต้นทุนคงที่ ต้นทุนตามปริมาณ ต้นทุนตามความซับซ้อน และต้นทุนที่เกิดเมื่อผิดพลาด
| หมวดต้นทุน | รายการที่ต้องนับ | จุดตรวจ |
|---|---|---|
| ข้อมูล | เก็บ ทำความสะอาด ป้ายกำกับ สิทธิ์ คุณภาพ และการเติมข้อมูล | ต้องตรวจซ้ำบ่อยเพียงใด และใครรับผิดชอบเมื่อข้อมูลเปลี่ยน |
| พัฒนาและประเมิน | ทดลอง Prompt/Model Integration ชุดทดสอบ และการทบทวน | รวมงานก่อนและหลังโมเดล ตลอดจนกรณียกเว้นหรือยัง |
| โครงสร้างพื้นฐาน | Compute, Storage, Network, Logging, Security และ Vendor | ต้นทุนเปลี่ยนตามปริมาณ ช่วงพีก ความยาวข้อมูล หรือระดับบริการอย่างไร |
| คนและการเปลี่ยนแปลง | Human Review, Training, Support, Process และการสื่อสาร | งานใครลด งานใครเพิ่ม และภาระใหม่ถูกนับที่ทีมใด |
| ปฏิบัติการ | Monitor, Audit, Incident, Evaluation, Update และการทดสอบซ้ำ | ใครเป็นเจ้าของตลอดอายุ และมีเวลา/เครื่องมือเพียงพอหรือไม่ |
| ออกจากระบบ | Export, Migration, Archive, Shutdown และการคืน Workflow เดิม | ย้ายข้อมูลและหลักฐานได้หรือไม่ ต้องเก็บอะไร และใช้เวลาฟื้นกลับเท่าไร |
Human Review ต้องนับตามงานจริง ไม่ใช่สมมติว่าคนตรวจเพียงไม่กี่วินาที หากผู้ตรวจต้องเปิดเอกสารหลายหน้า ขอข้อมูลเพิ่ม หรือรับผิดชอบผลที่ระบบเสนอ เวลานี้เป็นส่วนของต้นทุนต่อกรณี และอาจเพิ่มเมื่อระบบไม่มั่นใจหรือเมื่อทีมตั้ง Guardrail ที่เข้มขึ้น
ต้นทุนการประเมินไม่ควรถูกตัดออกหลังเปิดใช้ เพราะคุณภาพบนข้อมูลใหม่อาจต่างจากชุดทดสอบ ทีมต้องมีตัวอย่างที่ตรวจได้ เกณฑ์เตือน ผู้ทบทวน และรอบตัดสินใจว่าจะปรับรุ่น เปลี่ยนกฎ หรือหยุดใช้ การไม่มีงบสำหรับ Monitor ไม่ได้ทำให้ต้นทุนหาย แต่ทำให้ความเสี่ยงถูกซ่อนไว้
ต้นทุนออกจากระบบมีผลต่อการต่อรองและความยืดหยุ่น หากข้อมูลส่งออกไม่ได้ หลักฐานผูกกับผู้ให้บริการ หรือ Workflow ไม่มีทางสำรอง องค์กรอาจติดอยู่กับระบบแม้คุณค่าไม่ผ่านเกณฑ์ การรวม Exit Cost ตั้งแต่ต้นช่วยให้ Rollback เป็นสิ่งที่ทดสอบได้ ไม่ใช่คำสัญญาในเอกสาร
5. ต้นทุนความเสี่ยง: นับทั้งการควบคุม เหตุผิด และผลต่อผู้ได้รับผลกระทบ
ความเสี่ยงไม่ควรถูกวางไว้ท้าย Business Case เป็นข้อความว่า “จะบริหารภายหลัง” เพราะการควบคุมมีต้นทุนและเปลี่ยนเศรษฐศาสตร์ของระบบ หากโจทย์ต้องมีการตรวจทุกกรณี ต้องเก็บหลักฐานยาวขึ้น หรือต้องตอบ Incident ภายในกรอบเวลาที่กำหนด ต้นทุนเหล่านี้เป็นส่วนหนึ่งของทางเลือกตั้งแต่วันแรก
แนวคิด Expected Loss ช่วยมองโอกาสและผลกระทบร่วมกัน แต่ค่าเฉลี่ยไม่ควรกลบเหตุการณ์รุนแรงที่ยอมรับไม่ได้ ทีมต้องแยกเหตุทั่วไปที่แก้คืนได้ออกจากเหตุที่กระทบความปลอดภัย สิทธิ หรือความไว้วางใจอย่างมาก แม้เกิดไม่บ่อย เหตุหลังอาจต้องมี Guardrail ที่ทำให้ระบบช้าหรือแพงขึ้น ซึ่งเป็นต้นทุนที่ต้องยอมรับหากยังเลือกใช้ AI
ในสมมติฐาน Pilot การพลาดกรณีสำคัญเป็นความเสี่ยงหลัก จึงมี Recall เป็น Guardrail แต่ Recall เพียงตัวเดียวไม่บอกภาระคำเตือนเกิน หากระบบส่งกรณีจำนวนมากให้คนตรวจ ผลสำคัญอาจถูกพบมากขึ้นพร้อมกับคิวที่ยาวและความล้าของผู้ตรวจ ดังนั้นต้องมองต้นทุนของทั้ง False Negative และ False Positive พร้อมผลต่อ Workflow
ก่อนเหตุ
ออกแบบสิทธิ์ ชุดทดสอบ Guardrail การอบรม ทางส่งต่อ และการสำรองกระบวนการ
ระหว่างเหตุ
ตรวจพบ จำกัดขอบเขต หยุดกฎ แจ้งเจ้าของ เก็บหลักฐาน และรักษาบริการที่จำเป็น
หลังเหตุ
ค้นหาผลกระทบย้อนหลัง แก้ผล เยียวยา วิเคราะห์สาเหตุ ทดสอบซ้ำ และติดตามว่าไม่เกิดซ้ำ
ต้นทุนความเสี่ยงต้องรวมคนที่อยู่นอกทีมโครงการ ผู้ใช้ปลายทาง ผู้ได้รับผลกระทบ ทีมบริการ ทีมกฎหมาย หรือผู้ตรวจสอบอาจรับภาระเมื่อระบบผิด หาก Business Case แสดงประโยชน์อยู่ทีมหนึ่งแต่ซ่อนต้นทุนไว้กับอีกทีม การตัดสินใจจะดูคุ้มจากมุมงบประมาณแต่ไม่คุ้มต่อระบบโดยรวม
กรอบ NIST AI RMF ช่วยให้ทีมไม่แยกคุณค่ากับความเสี่ยงออกจากกัน การกำกับ การทำความเข้าใจบริบท การวัด และการจัดการต้องวนต่อเนื่อง ส่วนหลัก OECD เน้นความโปร่งใส ความแข็งแรง และความรับผิดชอบ ซึ่งหมายความว่าต้นทุนในการอธิบาย ตรวจสอบ และรับผิดชอบไม่ใช่งานเสริม แต่เป็นเงื่อนไขของระบบที่ไว้ใจได้
6. เทียบทางเลือก: AI ต้องชนะด้วยคุณค่าส่วนเพิ่ม ไม่ใช่เพราะตัวเปรียบเทียบถูกทำให้อ่อน
คำถามที่ถูกไม่ใช่ “AI ดีกว่าไม่ทำอะไรหรือไม่” แต่คือ “ทางเลือกใดสร้าง Outcome ที่ต้องการด้วยต้นทุนและความเสี่ยงที่ยอมรับได้ที่สุด” ทางเลือกอาจเป็นการปรับแบบฟอร์ม ทำฐานความรู้ ใช้กฎ ซื้อซอฟต์แวร์ทั่วไป เพิ่มการอบรม หรือแก้คอขวดของ Workflow โดยไม่ใช้โมเดล
บทเดิมเสนอว่าทางเลือกง่ายกว่าอาจให้คุณค่าส่วนใหญ่ด้วยต้นทุนและความเสี่ยงต่ำกว่า ตัวเลข 70% ที่ปรากฏเดิมควรอ่านเป็นตัวอย่างแนวคิด ไม่ใช่ค่าที่พิสูจน์แล้วสำหรับโครงการนี้ สิ่งที่ต้องทำจริงคือวัดคุณค่าของแต่ละทางเลือกในบริบทเดียวกัน แล้วคำนวณ Incremental Value หรือคุณค่าที่ AI เพิ่มเหนือทางเลือกที่ดีที่สุด
| ทางเลือก | จุดแข็งที่ต้องตรวจ | ข้อจำกัดและต้นทุนที่ต้องนับ |
|---|---|---|
| ปรับกระบวนการ | แก้คอขวดตรงจุด ใช้ความรู้เดิม ตรวจสอบง่าย | อาจไม่รองรับปริมาณหรือความแปรผันบางแบบ |
| กฎหรือระบบอัตโนมัติ | ผลคาดการณ์ได้ เหมาะกับเงื่อนไขชัด | ต้องดูแลกฎ กรณียกเว้น และการเปลี่ยนข้อกำหนด |
| ซอฟต์แวร์ทั่วไป | อาจพร้อมใช้ มีการสนับสนุน และต้นทุนชัดกว่า | ความยืดหยุ่น การเชื่อมต่อ และข้อจำกัด Vendor |
| AI ช่วยคน | รับมือข้อมูลซับซ้อนหรือความไม่แน่นอนและช่วยจัดลำดับ | ต้องประเมิน Human Review, Drift, Incident และ Guardrail |
| ไม่ทำเพิ่ม | ไม่มีต้นทุนเปลี่ยนระบบทันที | ต้องนับต้นทุนปัญหาเดิม โอกาสที่เสียไป และความเสี่ยงคงค้าง |
การเทียบต้องใช้ Baseline และ Outcome ชุดเดียวกัน หากทางเลือกกฎถูกวัดด้วยเวลารวม แต่ AI ถูกวัดเฉพาะเวลาประมวลผล การเปรียบเทียบจะลำเอียง เช่นเดียวกัน หากนับค่าแรงตรวจในทางเลือกเดิมแต่ไม่นับ Human Review ใน AI ตัวเลขต้นทุนจะผิดตั้งแต่โครงสร้าง
ทางเลือกไม่จำเป็นต้องเป็นผู้ชนะเพียงหนึ่งเดียว ระบบที่คุ้มอาจใช้กฎกับกรณีแน่นอน ใช้ AI กับกรณีซับซ้อน และส่งต่อคนเมื่อความเสี่ยงสูง การออกแบบขอบเขตเช่นนี้ช่วยลดต้นทุนโมเดลและภาระตรวจ พร้อมทำให้ Stop Rule ใช้ได้เฉพาะส่วนที่มีปัญหาแทนการหยุดทั้งระบบ
7. Pilot: ซื้อความรู้เกี่ยวกับสมมติฐาน ไม่ใช่ซื้อคำยืนยันไอเดีย
Pilot ที่ดีเริ่มจากรายการสิ่งที่ทีมยังไม่รู้ เช่น ข้อมูลจริงพอหรือไม่ ผู้ตรวจใช้ผลอย่างไร ภาระ Review เท่าไร กรณียากกระจุกอยู่ที่ไหน และระบบเชื่อม Workflow ได้หรือไม่ เป้าหมายคือทำให้ความไม่แน่นอนลดลงพอสำหรับการตัดสินใจ ไม่ใช่สร้าง Demo ที่ดูดีที่สุด
สมมติฐานเดิม “ลดเวลาตรวจ 30% โดย Recall กรณีสำคัญไม่ต่ำกว่า 95%” มีสองแกนที่ดึงกัน ความเร็วอาจดีขึ้นด้วยการลดการตรวจ แต่ Guardrail คุณภาพอาจต้องเพิ่มการตรวจของคน Pilot จึงต้องวัดทั้งเวลาแบบ end-to-end, Recall ตามนิยามที่ล็อกไว้, จำนวนกรณีส่งต่อ, อัตราตรวจซ้ำ และเหตุผิดที่ต้องแก้
ตัวเลข 30% และ 95% เป็นเกณฑ์ทดลองที่มีอยู่ในบทเดิม ไม่ใช่ข้อมูลอุตสาหกรรมหรือผลทดสอบจริง ทีมต้องยืนยันว่าเกณฑ์เหล่านี้มาจากความต้องการใด หากตั้งสูงหรือต่ำเกินไปโดยไม่มีเหตุผล Pilot อาจผ่านหรือไม่ผ่านโดยไม่ช่วยตัดสินว่าระบบเหมาะกับงาน
องค์ประกอบ Pilot ที่ตรวจสอบได้
- สมมติฐาน: ระบุสิ่งที่คาดว่าจะเปลี่ยน พร้อมเหตุผลที่เชื่อม Capability ถึง Outcome
- ขอบเขต: ระบุผู้ใช้ ประเภทงาน ช่วงเวลา ระบบที่เชื่อม และสิ่งที่ยังไม่รวม
- Baseline: ใช้นิยาม วิธีวัด และส่วนผสมงานที่เทียบกันได้
- Guardrail: ระบุความผิดพลาดหรือผลกระทบที่ยอมรับไม่ได้
- Evidence: เก็บทั้งผลดิบ การตัดสินใจของคน ผลปลายทาง และภาระงาน
- Budget/Time Box: กำหนดเพดานทรัพยากรและเวลาที่อนุญาตให้เรียนรู้
- Stop Rule: ตกลงล่วงหน้าว่าเมื่อใดต้องหยุด จำกัด หรือกลับกระบวนการเดิม
ข้อมูล Pilot ต้องมีงานที่เป็นตัวแทนและกรณียาก ไม่ควรคัดเฉพาะตัวอย่างที่ระบบเคยเห็นหรือกรณีที่ทีมรู้ว่าโมเดลทำได้ดี หากมีข้อมูลเฉลยล่าช้า ให้กำหนดว่าจะติดตามผลนานเพียงใดและใครยืนยัน การประกาศผลก่อน Feedback ครบทำให้คุณค่าที่เห็นเป็นเพียงผลระยะต้น
Human Review เป็นทั้ง Control และตัวแปรทางเศรษฐศาสตร์ ผู้ตรวจต้องเห็นข้อมูลที่ใช้ตัดสิน มีเวลาเพียงพอ และมีอำนาจปฏิเสธหรือส่งต่อ หากคนเพียงกดรับผลเพราะคิวมาก Pilot อาจดูเร็วแต่ไม่ได้พิสูจน์ว่าการกำกับมีความหมาย ต้องเก็บเหตุผล Override และปัญหาเครื่องมือเพื่อรู้ว่า Workflow พร้อมจริงหรือไม่
หลัง Pilot ให้แยกข้อสรุปเป็น “ผ่านในขอบเขตทดลอง”, “ยังไม่รู้”, และ “ไม่ผ่าน” การพบว่าสมมติฐานไม่ผ่านไม่ใช่ความล้มเหลวของ Pilot หากช่วยหยุดการลงทุนที่ไม่คุ้ม Pilot ล้มเหลวเมื่อออกแบบให้ไม่สามารถตอบคำถามตัดสินใจหรือเมื่อเปลี่ยนเกณฑ์หลังเห็นผล
8. Unit Economics และ Sensitivity: ดูต้นทุนต่อผลสำเร็จ ไม่ใช่ต่อคำขอ
ค่าใช้จ่ายต่อคำขออาจทำให้ระบบดูถูก แต่คำขอจำนวนหนึ่งอาจล้มเหลว ต้องส่งต่อ หรือสร้างงานแก้ ตัวหารที่มีความหมายกว่าคือกรณีที่จบกระบวนการตามเกณฑ์คุณภาพ ดังนั้น Cost per Case ควรรวม Compute, Review, Support และส่วนแบ่งต้นทุนพัฒนาต่อกรณีที่สำเร็จ ไม่ใช่ต่อทุกคำขอที่ส่งเข้าโมเดล
Value per Case ต้องเชื่อมกับ Outcome และหลีกเลี่ยงการนับซ้ำ หากเวลาที่ลดลงทำให้ทีมรองรับงานเพิ่ม คุณค่าอาจอยู่ที่ความสามารถในการให้บริการ ไม่ควรนับทั้งมูลค่าเวลาเต็มจำนวนและรายได้จากงานเพิ่มโดยไม่ตรวจว่ามาจากทรัพยากรเดียวกัน ขณะเดียวกันต้องหักต้นทุนความผิดพลาด การแก้ไข และผลที่ระบบสร้างต่อผู้ได้รับผลกระทบ
Cost per Successful Case
ต้นทุนระบบและคนทั้งหมด หารด้วยกรณีที่จบตามเกณฑ์คุณภาพและไม่ต้องแก้ซ้ำเกินขอบเขต
Value per Case
คุณค่าปลายทางที่พิสูจน์ได้ หักต้นทุนความผิดพลาด ภาระส่งต่อ และผลกระทบที่ต้องชดเชย
Break-even
ปริมาณหรือเวลาที่คุณค่าสะสมครอบต้นทุนคงที่ ต้นทุนต่อเนื่อง และ Control ที่จำเป็น
Sensitivity Analysis ทดสอบว่า Business Case ยังอยู่ได้หรือไม่เมื่อสมมติฐานแย่ลง เช่น ปริมาณต่ำกว่าคาด ค่าใช้จ่ายสูงขึ้น คุณภาพลดลง Human Review มากขึ้น หรือการเชื่อมระบบใช้เวลานานขึ้น ไม่ต้องสร้างความแม่นยำปลอมให้ตัวเลข แต่ควรแสดงช่วงและตัวแปรที่ทำให้ข้อสรุปเปลี่ยน
แยกตัวแปรที่ทีมควบคุมได้ออกจากตัวแปรภายนอก ทีมอาจปรับขอบเขต ลดปริมาณที่ส่งเข้า AI หรือเปลี่ยน Workflow ได้ แต่ราคา Vendor ข้อกำหนด หรือส่วนผสมงานอาจเปลี่ยนโดยไม่อยู่ในการควบคุม การรู้จุดเปราะบางช่วยกำหนดสัญญา Monitor และแผนทางเลือกได้เหมาะสม
อย่าใช้ค่าเฉลี่ยเพียงค่าเดียว หากกรณีบางกลุ่มใช้เวลาตรวจมากหรือมีต้นทุนผิดพลาดสูง Unit Economics ควรแยกกลุ่มสำคัญ ระบบอาจคุ้มสำหรับงานทั่วไปแต่ไม่คุ้มสำหรับกรณีเสี่ยงสูง การจำกัดขอบเขตจึงอาจเป็นคำตอบที่ดีกว่าการประกาศผ่านหรือไม่ผ่านทั้งโครงการ
9. Go/No-Go: ตัดสินจากคุณค่า ความเป็นไปได้ ความเสี่ยง และการย้อนกลับพร้อมกัน
Go/No-Go ไม่ควรเป็นการประชุมครั้งเดียวที่เลือก “เดินหน้า” หรือ “ยกเลิก” โดยไม่มีระดับกลาง หลักฐานอาจรองรับการขยายเฉพาะขอบเขต รองรับการทดลองต่อเพื่อปิดช่องว่าง หรือบอกให้กลับไปใช้ทางเลือกที่ง่ายกว่า การตัดสินใจที่ดีระบุขอบเขต เงื่อนไข เจ้าของ และวันทบทวนถัดไป
แกนคุณค่าถามว่า Outcome ดีขึ้นจาก Baseline หรือไม่และใครได้รับคุณค่า แกนความเป็นไปได้ถามว่าข้อมูล ระบบ และ Workflow ทำงานได้ต่อเนื่องหรือไม่ แกนความเสี่ยงถามว่า Guardrail ผ่านหรือไม่และเมื่อผิดเกิดผลกับใคร แกนการย้อนกลับถามว่าทีมหยุด จำกัด คืนค่า และรักษาบริการได้จริงหรือไม่
Checklist ก่อนอนุมัติขยาย
- Outcome ดีขึ้นจาก Baseline ตามวิธีวัดที่ตกลงไว้หรือไม่
- คุณภาพและ Guardrail ผ่านในทุกกลุ่มสำคัญหรือไม่
- TCO และ Unit Economics ยังรับได้ในสถานการณ์ฐานและสถานการณ์แย่หรือไม่
- ทางเลือกที่ไม่ใช้ AI ถูกเทียบด้วยเกณฑ์เดียวกันหรือไม่
- ทีมมีเจ้าของ Monitor, Incident, Evaluation และ Change หรือไม่
- ผู้ใช้เข้าใจผล มีเวลาและอำนาจตรวจ และยอมรับภาระ Workflow จริงหรือไม่
- Rollback และ Exit ถูกทดสอบ พร้อมข้อมูลและหลักฐานที่ต้องรักษาหรือไม่
- สิ่งที่ยังไม่รู้มีผลต่อการตัดสินใจมากพอให้ต้อง Pilot ต่อหรือไม่
ผู้ตัดสินใจควรเห็นทั้งหลักฐานสนับสนุนและหลักฐานคัดค้าน หากรายงานแสดงเฉพาะค่าเฉลี่ยที่ดีและซ่อนกรณีพลาด การอนุมัติจะไม่สะท้อนความเสี่ยงจริง เช่นเดียวกัน หากไม่แสดงต้นทุนคนเพราะอยู่คนละงบ TCO จะต่ำกว่าความเป็นจริง การทบทวนข้ามทีมช่วยป้องกันการโยกต้นทุนออกจากตาราง
คำตัดสินควรเขียนให้ตรวจย้อนหลังได้ ระบุข้อมูลที่ใช้ สมมติฐานที่ยังอยู่ ขอบเขตที่อนุมัติ เกณฑ์ติดตาม และผู้มีอำนาจหยุด หากผลหลังใช้งานเปลี่ยน ทีมจะรู้ว่าข้อสรุปเดิมไม่ใช้แล้วเมื่อใด แทนที่จะเดินหน้าต่อเพราะเคยอนุมัติไปแล้ว
10. Failure Case: โครงการดูคุ้มบนสไลด์ แต่ไม่คุ้มเมื่อเจอระบบจริง
Failure Case แรกคือ นับเฉพาะโมเดล ทีมใส่ค่า API หรือ Compute แต่ไม่ใส่ข้อมูล Integration, Human Review, Monitor และ Incident เมื่อเปิดใช้ ต้นทุนที่ไม่อยู่ใน Business Case กลายเป็นงานเร่งของหลายทีม และระบบดูแพงกว่าที่อนุมัติไว้ สาเหตุไม่ใช่ต้นทุนเพิ่มอย่างเดียว แต่เป็นขอบเขต TCO ที่ผิดตั้งแต่ต้น
Failure Case ที่สองคือ คุณค่าหยุดที่ Output โมเดลตอบเร็วหรือแม่นขึ้น แต่หน้าจอ ขั้นตอนอนุมัติ และคิวส่งต่อเหมือนเดิม Operational Metric จึงไม่เปลี่ยน หรือดีเพียงจุดหนึ่งแล้วแย่ที่จุดถัดไป วิธีป้องกันคือทำ Value Map และวัดเวลา end-to-end รวมการแก้และการรอ
Failure Case ที่สามคือ Pilot ไม่เป็นตัวแทน ทีมเลือกงานง่าย ผู้ใช้ที่พร้อม และข้อมูลที่สะอาด เมื่อขยายไปงานจริง คุณภาพลด Human Review เพิ่ม และกรณียกเว้นมากขึ้น หลักฐานจาก Pilot จึงไม่รองรับขอบเขตใหม่ ต้องระบุความแตกต่างและทดลองเพิ่ม ไม่ควรนำผลเดิมไปคูณตามปริมาณโดยตรง
Failure Case ที่สี่คือ ลด Control เพื่อให้ ROI ผ่าน การตัด Human Review, Audit หรือ Logging ออกทำให้ตารางต้นทุนดีขึ้น แต่ความเสี่ยงไม่ได้หาย เพียงถูกส่งไปให้ผู้ใช้ ทีม Incident หรือผู้ได้รับผลกระทบในอนาคต หาก Control เป็นเงื่อนไขให้ระบบปลอดภัย ต้นทุนของมันต้องอยู่ใน Business Case
Failure Case ที่ห้าคือ Sunk Cost ทำให้หยุดไม่ได้ เมื่อใช้เวลาและงบไปแล้ว ทีมอาจลดเกณฑ์หรือเปลี่ยน Outcome เพื่อให้โครงการผ่าน Stop Rule ที่กำหนดล่วงหน้าและผู้ตัดสินใจที่ไม่ผูกกับการส่งมอบช่วยให้หลักฐานยังมีอำนาจเหนือความรู้สึกเสียดาย
สัญญาณที่ต้องหยุด จำกัด หรือย้อนกลับ
- Baseline เปรียบเทียบไม่ได้ หรือข้อมูลผลจริงไม่พอสำหรับสรุป
- Guardrail ของกรณีสำคัญไม่ผ่าน แม้ตัวชี้วัดเฉลี่ยดูดี
- ภาระ Human Review, Support หรือ Incident สูงกว่าสมมติฐานจนข้อสรุปเปลี่ยน
- ทางเลือกที่ง่ายกว่าสร้าง Outcome ใกล้เคียงด้วยความเสี่ยงต่ำกว่า
- ทีมไม่มีเจ้าของ Monitor และไม่มีทางคืน Workflow ที่ปลอดภัย
- ผลดีเกิดเฉพาะขอบเขตทดลองและไม่มีหลักฐานรองรับการขยาย
เมื่อสัญญาณเกิดขึ้น การหยุดไม่จำเป็นต้องหมายถึงทิ้งทุกอย่าง ทีมอาจลดขอบเขต กลับไปใช้กฎในกรณีแน่นอน ใช้ AI เป็นเครื่องมือช่วยร่างโดยไม่ตัดสิน หรือกลับไปเก็บข้อมูลก่อน การออกแบบทางเลือกไว้ล่วงหน้าทำให้ Stop Rule เป็นการจัดการความเสี่ยง ไม่ใช่การยอมแพ้
11. ลงมือทำ: Business Case หนึ่งหน้าที่แยกข้อเท็จจริงออกจากสมมติฐาน
เลือกโครงการหนึ่งโครงการแล้วเขียนให้ครบในหน้าเดียว เป้าหมายไม่ใช่ย่อทุกอย่างจนเหลือคำกว้าง แต่ทำให้ผู้ตัดสินใจเห็นสายโซ่หลักฐาน จุดที่ยังไม่รู้ และเงื่อนไขที่ทำให้คำตอบเปลี่ยน หากช่องใดไม่มีข้อมูล ให้เขียนว่า “ยังไม่ทราบ” พร้อมวิธีหาคำตอบ แทนการเติมตัวเลข
Worksheet: Business Case หนึ่งหน้า
- การตัดสินใจ: ใครกำลังตัดสินใจเรื่องอะไร และปัญหาเดิมเกิดตรงไหน
- Baseline: ปริมาณ เวลา คุณภาพ ต้นทุน ภาระคน และผลต่อกลุ่มสำคัญเป็นอย่างไร
- Outcome: ผลปลายทางใดต้องดีขึ้น ใครได้รับคุณค่า และหลักฐานใดถือว่าเพียงพอ
- Value Map: Capability เปลี่ยน Workflow และ Operational Metric อย่างไรจึงถึง Outcome
- Alternatives: กฎ ซอฟต์แวร์ การปรับกระบวนการ หรือไม่ทำเพิ่มให้ผลอย่างไร
- TCO: ข้อมูล พัฒนา โครงสร้างพื้นฐาน คน ปฏิบัติการ ความเสี่ยง และ Exit มีรายการใดบ้าง
- Risk: ความผิดพลาดสำคัญ ผู้ได้รับผลกระทบ Control, Incident และเจ้าของความเสี่ยงคือใคร
- Pilot: สมมติฐาน ขอบเขต Baseline Evidence, Budget/Time Box และ Guardrail คืออะไร
- Economics: Cost/Value per Successful Case, Break-even และตัวแปร Sensitivity คืออะไร
- Decision Rule: Go, จำกัดขอบเขต, Pilot ต่อ, No-Go หรือ Rollback เมื่อหลักฐานแบบใด
วิธีตรวจคำตอบของตัวเอง
อ่าน Business Case แล้วปิดชื่อเทคโนโลยี หากยังเข้าใจว่าปัญหาคืออะไร ใครใช้ผล วิธีวัดเปรียบเทียบอย่างไร และเมื่อใดต้องหยุด แสดงว่าโครงเหตุผลเริ่มชัด หากทุกอย่างขึ้นกับคำว่า “AI ช่วยเพิ่มประสิทธิภาพ” แสดงว่ายังขาด Workflow, Metric หรือ Evidence
จากนั้นลองสลับ AI ออกเป็นทางเลือกกฎหรือการปรับกระบวนการ หาก Outcome ยังเกิดได้เกือบเหมือนเดิม ให้ถามว่า Incremental Value ของ AI อยู่ตรงไหน ถ้าตอบไม่ได้ ยังไม่ควรอนุมัติต้นทุนและความเสี่ยงส่วนเพิ่ม
สุดท้ายให้คนจากทีมปฏิบัติการ ความเสี่ยง และผู้ใช้ตรวจรายการต้นทุน คนแต่ละกลุ่มมักเห็นงานที่ทีมโครงการมองไม่เห็น เช่น การขอสิทธิ์ การตอบคำถาม การแก้ผลผิด การเก็บหลักฐาน และการย้อนกลับ รายการที่เพิ่มจากการตรวจข้ามทีมไม่ใช่การทำให้โครงการดูแพง แต่ทำให้คำตัดสินใกล้ความจริงขึ้น
12. แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่ดีที่สุดให้ครบทุกข้อ แล้วกด “ตรวจคำตอบ” ระบบจะแสดง Feedback รายข้อ คะแนนรวม และจำนวนข้อที่ยังไม่ตอบ
0/5 คะแนน · ยังไม่ได้ตอบ 5 ข้อ
13. สรุปและภาพจำ: คุณค่าที่พิสูจน์ได้ต้องมากกว่าต้นทุนและความเสี่ยงทั้งวงจร
โครงการ AI ไม่คุ้มเพียงเพราะโมเดลทำงานได้หรือ Demo ดูรวดเร็ว มันคุ้มเมื่อ Capability เปลี่ยน Workflow, Operational Metric และ Outcome อย่างมีหลักฐาน เมื่อเทียบกับ Baseline และทางเลือกที่ดีที่สุดแล้ว คุณค่าส่วนเพิ่มยังมากกว่าต้นทุนข้อมูล ระบบ คน การปฏิบัติการ ความเสี่ยง และ Exit
สมมติฐาน “ลดเวลาตรวจ 30% โดย Recall กรณีสำคัญไม่ต่ำกว่า 95%” ช่วยให้เห็นว่าเกณฑ์ความเร็วและคุณภาพต้องถูกทดสอบพร้อมกัน ไม่ใช่ผลจริงที่ควรนำไปคำนวณล่วงหน้า Pilot ต้องเก็บเวลา end-to-end ภาระ Human Review, Feedback, Incident และผลต่อกลุ่มสำคัญ พร้อม Stop Rule ก่อนเริ่ม
เมื่อหลักฐานไม่ผ่าน คำตอบอาจเป็นการจำกัดขอบเขต ใช้กฎหรือซอฟต์แวร์ทั่วไป เก็บข้อมูลเพิ่ม หรือหยุดโครงการ การตัดสินใจเช่นนี้ไม่ใช่การต่อต้าน AI แต่เป็นการใช้ทรัพยากรอย่างรับผิดชอบและรักษาทางเลือกในการย้อนกลับ
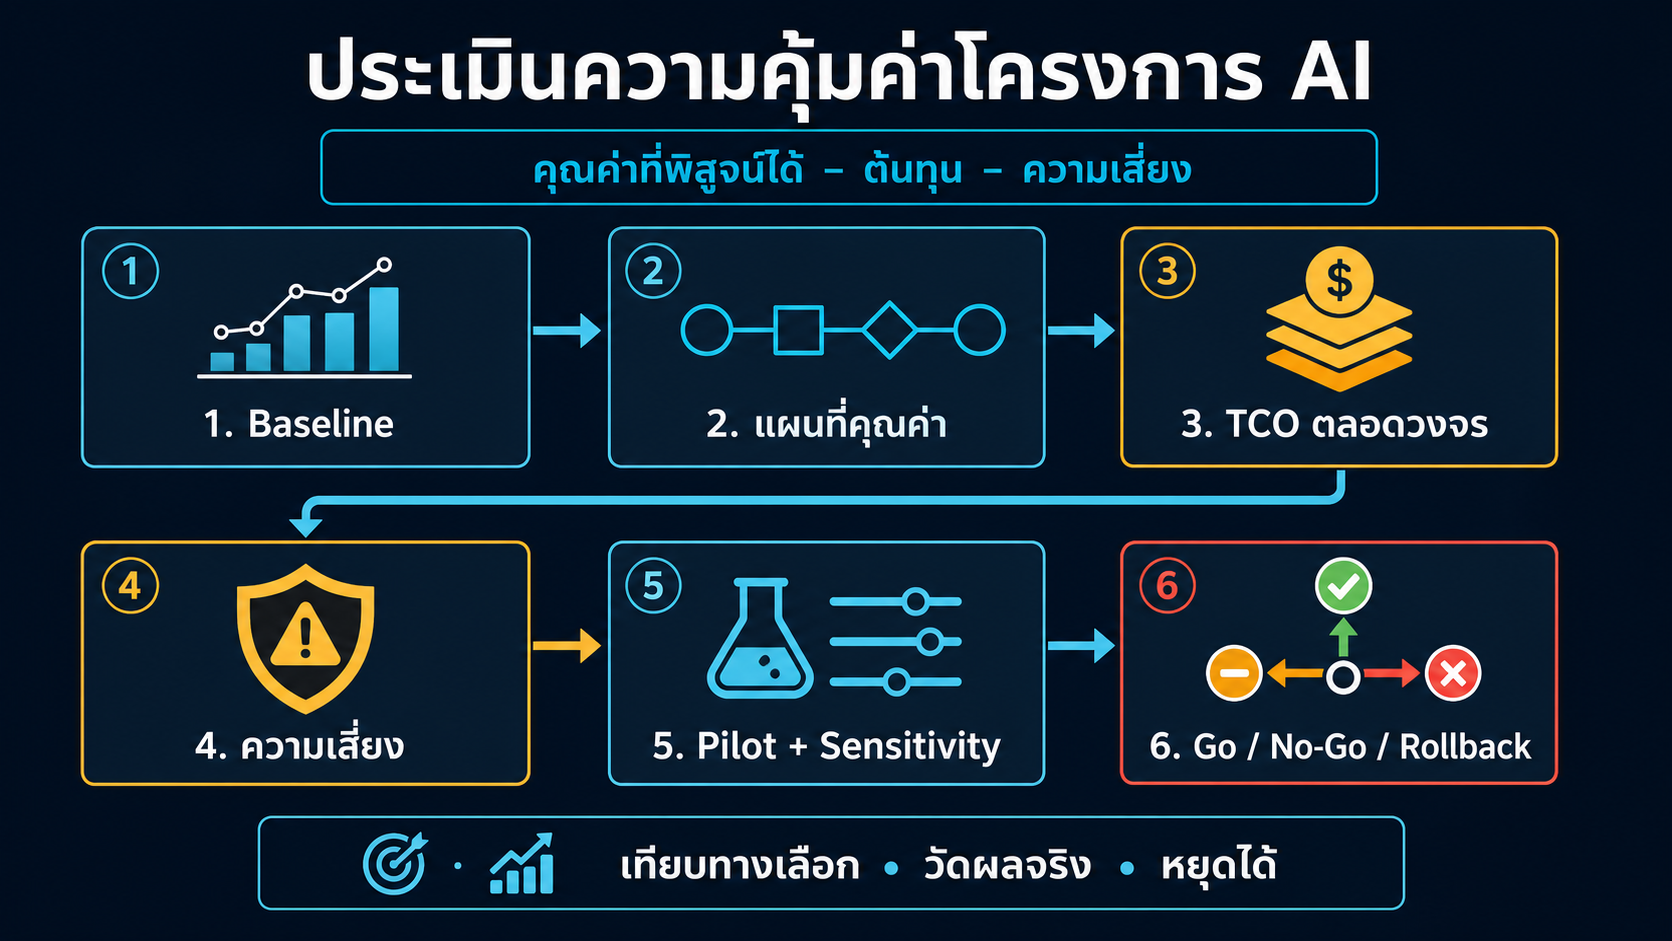
วิธีอ่านภาพ: อย่าเริ่มที่ราคาโมเดล ให้ไล่จากปัญหาเดิมและ Baseline ผ่านการเปลี่ยน Workflow ไปถึง Outcome ที่พิสูจน์ได้ จากนั้นหักต้นทุนและความเสี่ยงตลอดวงจร ก่อนเทียบกับทางเลือกอื่นและตัดสินจากหลักฐาน
- ก่อนลงทุน: ล็อก Baseline, Outcome, ทางเลือก, TCO และสิ่งที่ยอมรับไม่ได้
- ระหว่าง Pilot: เก็บผลจริง ภาระคน ความผิดพลาด และข้อมูลที่ใช้ยืนยันสมมติฐาน
- ก่อนขยาย: ทดสอบ Sensitivity, เจ้าของปฏิบัติการ, Stop Rule, Rollback และ Exit
เรียนต่ออย่างเป็นระบบ
เชื่อมการเลือกโจทย์ ทางเลือกเทคโนโลยี และความคุ้มค่าเข้ากับบทเรียนอื่นใน PATH 01
แหล่งอ้างอิงหลักและขอบเขต
- Google for Developers — Managing ML Projects — การเริ่มจากเป้าหมายโครงการ ความเป็นไปได้ และการประเมิน
- Google Machine Learning Crash Course — Production ML Systems — ระบบใช้งานจริงประกอบด้วยข้อมูล การทดสอบ การติดตาม และส่วนอื่นมากกว่าโมเดล
- NIST — Artificial Intelligence Risk Management Framework 1.0 — การกำกับ ทำความเข้าใจบริบท วัด และจัดการความเสี่ยง
- OECD AI Principles — ความโปร่งใส ความแข็งแรง และความรับผิดชอบ
ขอบเขต: สมมติฐาน “ลดเวลาตรวจ 30% โดย Recall กรณีสำคัญไม่ต่ำกว่า 95%” มาจากบทเดิมและใช้เพื่ออธิบายวิธีออกแบบ Pilot เท่านั้น ไม่ใช่ผลทดสอบ ตัวเลขมาตรฐาน หรือคำรับรองความคุ้มค่าของระบบจริง การประเมินต้องใช้ข้อมูลขององค์กร บริบทความเสี่ยง และข้อกำหนดที่เกี่ยวข้อง
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 10 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 29 · PATH 01 · เนื้อหาเพื่อการศึกษา
