คุณอยู่ตรงไหนในเส้นทางนี้
PATH 01 · พื้นฐานดิจิทัลและภาพรวม AI · หัวข้อ 8 จาก 50 หัวข้อ
เจ้าของร้านกาแฟเล็ก ๆ คนหนึ่งพิมพ์ประโยคเดียวลงในหน้าจอว่า “ช่วยคิดแคมเปญเปิดตัวเมนูฤดูฝน” ไม่กี่วินาทีต่อมา เธอได้ชื่อเมนู คำโฆษณา ภาพโปสเตอร์ และเสียงประกอบหลายแบบ ทั้งที่ก่อนหน้านี้งานแต่ละชิ้นต้องใช้คนละเครื่องมือและใช้เวลาหลายวัน
ภาพนี้ทำให้ Generative AI ดูเหมือนเครื่องจักรที่เข้าใจทุกอย่างและสร้างได้ตามใจ แต่สิ่งที่เกิดขึ้นจริงละเอียดกว่านั้นมาก โมเดลไม่ได้เปิดลิ้นชักหยิบคำตอบสำเร็จรูปออกมา และไม่ได้มีประสบการณ์แบบมนุษย์ มันเรียนความสัมพันธ์ของข้อมูลจำนวนมาก แล้วคำนวณตัวอย่างใหม่ที่เข้ากับคำสั่งและรูปแบบที่เคยพบ
คำตอบสั้นที่สุดคือ Generative AI เป็นระบบที่เรียนรูปแบบของข้อมูล แล้วสร้างข้อมูลตัวอย่างใหม่ เช่น ข้อความ ภาพ เสียง วิดีโอ โค้ด หรือข้อมูลสังเคราะห์ ความสามารถในการสร้างไม่ได้รับประกันว่าผลลัพธ์จริง ถูกกฎหมาย เป็นธรรม หรือเหมาะกับงาน ผู้ใช้จึงต้องเรียนสองทักษะพร้อมกัน: สั่งให้ระบบสร้าง และตรวจว่าสิ่งที่สร้างสมควรถูกนำไปใช้หรือไม่
บทเรียนนี้จะใช้ร้านกาแฟเป็นเส้นเรื่องเดียว ตั้งแต่การให้ Prompt การที่โมเดลสร้างร่าง การพบคำกล่าวที่ไม่มีหลักฐาน ไปจนถึงการตัดสินใจของมนุษย์ เพื่อให้คุณเห็นทั้งกลไก ประโยชน์ Failure Case และทางกลับเมื่อผลลัพธ์ผิด
อ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบายความต่างระหว่าง Predictive AI กับ Generative AI ด้วยตัวอย่าง Input → Process → Output ได้
- เปรียบเทียบแนวคิดหลักของ VAE, GAN, Autoregressive Model และ Diffusion Model ได้โดยไม่สับสนกลไก
- อธิบายว่า Transformer ช่วยการสร้างภาษาอย่างไร และเหตุใดความลื่นไหลจึงไม่เท่ากับความจริงได้
- ระบุ Failure Case ด้านข้อเท็จจริง ความเป็นส่วนตัว อคติ สิทธิ์ และการพึ่งพาระบบมากเกินไปได้
- ใช้ด่านตรวจแบบทำซ้ำได้เพื่อตัดสินใจว่าจะอนุมัติ แก้ไข หรือปฏิเสธผลลัพธ์ก่อนใช้งานจริงได้
Generative AI คืออะไร เมื่อคำว่า “สร้าง” ไม่ได้แปลว่า “คิดเหมือนมนุษย์”
คำว่า Generative หมายถึงการก่อให้เกิดตัวอย่างใหม่จากแบบจำลองที่เรียนรู้มา ผลลัพธ์อาจเป็นประโยคหนึ่งประโยค ภาพหนึ่งภาพ คลิปเสียง ชุดโค้ด โครงสร้างโมเลกุล หรือข้อมูลจำลองสำหรับการทดลอง สิ่งที่เรียกว่า “ใหม่” คือระบบไม่ได้เก็บผลลัพธ์ทุกชิ้นไว้ล่วงหน้าแล้วเลือกออกมาแบบเมนูตายตัว แต่คำนวณองค์ประกอบของผลลัพธ์ตามบริบท ความน่าจะเป็น และเงื่อนไขที่ได้รับ
อย่างไรก็ตาม “ใหม่” ไม่ได้แปลว่าไม่เคยคล้ายสิ่งใดมาก่อน โมเดลเรียนจากข้อมูลฝึก หากข้อมูลมีรูปแบบซ้ำ มีอคติ หรือมีตัวอย่างบางชิ้นเด่นมาก ผลลัพธ์ก็อาจสะท้อนสิ่งเหล่านั้น บางระบบอาจสร้างข้อความที่ใกล้กับข้อมูลฝึกมากกว่าที่ผู้ใช้คาด งานของ Carlini และคณะเคยแสดงการดึงตัวอย่างข้อความจาก GPT-2 ได้ในเงื่อนไขการโจมตีที่ศึกษา จึงไม่ควรสรุปว่า “โมเดลไม่ได้เป็นฐานข้อมูล” แล้วข้อมูลส่วนตัวจะปลอดภัยโดยอัตโนมัติ [8]
Generative AI จึงควรถูกมองเป็น เครื่องสร้างตัวเลือก มากกว่าเครื่องประกาศความจริง ร้านกาแฟอาจใช้มันร่างชื่อเมนูสิบแบบเพื่อเปิดพื้นที่ความคิด แต่การบอกว่าเมล็ดกาแฟมีสรรพคุณทางสุขภาพอย่างใดอย่างหนึ่งเป็น Claim ที่ต้องมีหลักฐาน คนที่รับผิดชอบงานต้องรู้ว่าช่วงไหนระบบกำลังเสนอความเป็นไปได้ และช่วงไหนกำลังกล่าวถึงข้อเท็จจริงที่ตรวจสอบได้
Generative AI คล้ายผู้ฝึกงานที่ดูตัวอย่างจำนวนมากและร่างงานได้เร็ว ผู้ฝึกงานอาจเสนอไอเดียที่สดใหม่ แต่ยังต้องได้รับโจทย์ที่ชัด ตรวจข้อมูล และมีคนตัดสินใจ อุปมานี้หยุดตรงที่โมเดลไม่มีประสบการณ์ เจตนา หรือความรับผิดชอบแบบมนุษย์
Predictive AI กับ Generative AI ต่างกันที่คำถามและรูปแบบผลลัพธ์
ก่อนยุคที่ผู้ใช้ทั่วไปคุยกับโมเดล เราคุ้นกับ AI ที่ตอบคำถามแบบเลือกหรือประมาณค่า เช่น อีเมลนี้เป็นสแปมหรือไม่ ลูกค้ารายนี้มีโอกาสยกเลิกบริการเท่าไร หรือภาพนี้เป็นแมวหรือสุนัข ระบบเหล่านี้มักถูกเรียกรวมว่า Predictive AI เพราะเป้าหมายหลักคือทำนายป้ายกำกับ คะแนน หมวดหมู่ หรือค่าตัวเลขจากข้อมูลที่ป้อนเข้า
Generative AI เปลี่ยนชนิดของผลลัพธ์ จากคำตอบในชุดที่กำหนดไว้ไปเป็นลำดับหรือโครงสร้างที่ยาวและหลากหลายกว่า ตัวอย่างเช่น Predictive AI รับข้อมูลยอดขายแล้วคาดการณ์ยอดสัปดาห์หน้า ส่วน Generative AI รับคำอธิบายเมนูแล้วร่างโพสต์ประชาสัมพันธ์หนึ่งย่อหน้า ความต่างนี้ไม่ได้ทำให้แบบหนึ่งฉลาดกว่าอีกแบบเสมอไป ทั้งสองถูกออกแบบให้ตอบโจทย์คนละชนิด และบางระบบรวมทั้งการทำนายกับการสร้างไว้ด้วยกัน
| มิติ | Predictive AI | Generative AI |
|---|---|---|
| คำถามหลัก | สิ่งนี้น่าจะเป็นอะไร หรือค่าเท่าไร | ตัวอย่างใหม่ที่สอดคล้องกับเงื่อนไขควรมีหน้าตาอย่างไร |
| Input | ข้อมูลคุณลักษณะ ภาพ ข้อความ หรือประวัติ | Prompt บริบท ตัวอย่าง เอกสาร หรือสัญญาณตั้งต้น |
| Process | ประมาณป้ายกำกับ คะแนน หรือความน่าจะเป็น | สุ่มหรือคำนวณองค์ประกอบของผลลัพธ์ต่อเนื่อง |
| Output | หมวดหมู่ คะแนน ค่าตัวเลข | ข้อความ ภาพ เสียง วิดีโอ โค้ด หรือข้อมูลใหม่ |
| Failure ที่พบบ่อย | จำแนกผิด คะแนนคลาดเคลื่อน | สร้างเนื้อหาที่ดูน่าเชื่อแต่ผิด ไม่เหมาะ หรือคล้ายข้อมูลฝึก |
| ด่านตรวจ | Metric, Test set, Threshold และผลกระทบ | หลักฐาน ความสอดคล้อง สิทธิ์ ความปลอดภัย และมนุษย์อนุมัติ |
ในกรณีร้านกาแฟ ระบบ Predictive อาจคาดการณ์จำนวนแก้วที่ขายได้จากอากาศและยอดเดิม ส่วนระบบ Generative ช่วยร่างชื่อเมนูและภาพโปสเตอร์ หากเลือกชนิดระบบผิด เราอาจใช้ข้อความสวย ๆ แทนการคาดการณ์ที่ต้องวัด หรือใช้คะแนนทำนายแทนงานสร้างสรรค์ที่ต้องการทางเลือกหลายแบบ จุดเริ่มจึงไม่ใช่ “อยากใช้ AI แบบใหม่ที่สุด” แต่คือ “เราต้องการตัดสินใจหรือสร้างอะไร”
เรียนรูปแบบเพื่อสร้างใหม่หมายความว่าอย่างไร
ลองจินตนาการว่ามีภาพแก้วกาแฟจำนวนมาก แต่ละภาพต่างกันทั้งมุมกล้อง สี ฉากหลัง แสง และรูปทรง โมเดลไม่ได้รับกฎว่าแก้วต้องมีเส้นกี่เส้น มันปรับพารามิเตอร์จากตัวอย่างเพื่อแทนความสัมพันธ์ที่เกิดซ้ำ เช่น ขอบโค้งมักเชื่อมกับปากแก้ว เงาสัมพันธ์กับทิศทางแสง และหูจับมักอยู่ติดกับตัวแก้ว ความสัมพันธ์เหล่านี้รวมกันเป็นแบบจำลองเชิงสถิติของข้อมูล
คำว่า การกระจายของข้อมูล หรือ Data Distribution เป็นภาษาทางสถิติที่ช่วยอธิบายว่า ตัวอย่างแบบใดเกิดขึ้นได้บ่อย แบบใดพบได้น้อย และส่วนประกอบต่าง ๆ สัมพันธ์กันอย่างไร Generative Model พยายามเรียนการกระจายนี้ หรืออย่างน้อยเรียนวิธีสร้างตัวอย่างที่ใกล้เคียงกับมัน จากนั้นจึงสุ่มหรือคำนวณตัวอย่างตามเงื่อนไข เช่น “แก้วกาแฟสีเขียวบนโต๊ะไม้ในบรรยากาศฝนตก”
ความสามารถนี้มีขอบเขต ถ้าข้อมูลฝึกขาดบริบทไทย โมเดลอาจสร้างป้ายร้าน ภาษา หรือรายละเอียดวัฒนธรรมที่ผิด ถ้าข้อมูลมีภาพสไตล์หนึ่งมาก โมเดลอาจโน้มเอียงไปทางสไตล์นั้น หาก Prompt คลุมเครือ พื้นที่ความเป็นไปได้จะกว้างและผลลัพธ์แกว่งมากขึ้น ผู้ใช้จึงควรมอง Prompt เป็นการกำหนดเงื่อนไข ไม่ใช่คำสั่งที่รับประกันผลลัพธ์เดียว
ระบบรับ Prompt เอกสาร ภาพ เสียง หรือข้อมูลประกอบ และแปลงสิ่งเหล่านั้นเป็นตัวแทนเชิงตัวเลข
โมเดลใช้พารามิเตอร์ที่เรียนรู้เพื่อประเมินองค์ประกอบถัดไปหรือเส้นทางการสร้างที่สอดคล้องกับบริบท
ระบบเลือกหรือสุ่มองค์ประกอบต่อเนื่องจนได้ข้อความ ภาพ เสียง หรือโครงสร้างครบชิ้น
มนุษย์หรือระบบประเมินตรวจความจริง คุณภาพ ความปลอดภัย และส่งคำแนะนำกลับเพื่อสร้างใหม่หรือหยุดใช้
ความลื่นไหลบอกว่าองค์ประกอบเข้ากับรูปแบบได้ดี แต่ไม่ได้บอกว่าข้อความมีหลักฐาน ภาพเป็นเหตุการณ์จริง หรือคำแนะนำเหมาะกับสถานการณ์ของคุณ
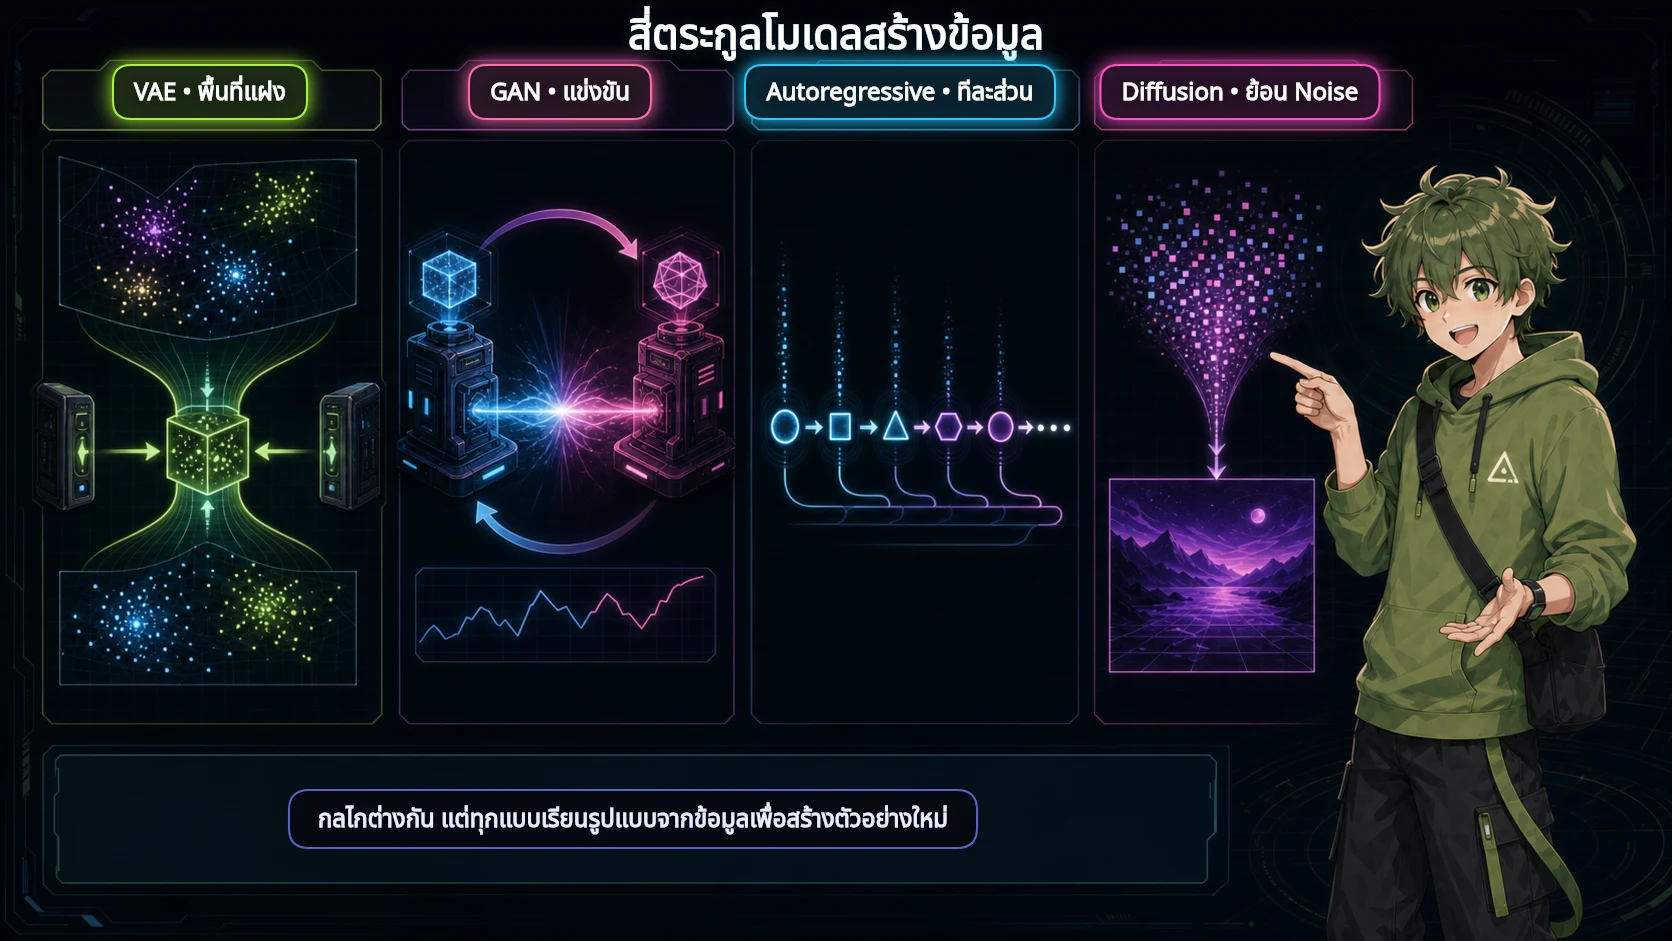
สี่ตระกูลโมเดลสร้างข้อมูลใช้กลไกต่างกัน
Generative AI ไม่ได้หมายถึงสถาปัตยกรรมเพียงแบบเดียว งานวิจัยหลายสายพยายามตอบคำถามเดียวกันว่า “เราจะเรียนโครงสร้างของข้อมูลแล้วสร้างตัวอย่างใหม่ได้อย่างไร” แต่เลือกเครื่องมือทางคณิตศาสตร์และวิธีฝึกต่างกัน การเห็นความต่างช่วยให้เราไม่เรียกทุกระบบว่า Chatbot และไม่คาดหวัง Failure แบบเดียวจากโมเดลทุกชนิด
VAE: บีบข้อมูลลงพื้นที่แฝงแล้วถอดกลับ
Variational Autoencoder มีส่วน Encoder ที่แปลงข้อมูลให้เป็นตัวแทนใน Latent Space หรือพื้นที่แฝง และ Decoder ที่ถอดตัวแทนนั้นกลับเป็นข้อมูล งานของ Kingma และ Welling เสนอวิธีฝึกแบบ Variational ที่คำนวณ Gradient ได้อย่างมีประสิทธิภาพ [1] เมื่อพื้นที่แฝงมีโครงสร้าง เราสามารถสุ่มจุดและถอดกลับเป็นตัวอย่างใหม่ได้ จุดแข็งคือการแทนข้อมูลอย่างต่อเนื่องและสำรวจการเปลี่ยนแปลงระหว่างตัวอย่าง แต่ผลลัพธ์บางงานอาจดูนุ่มหรือขาดรายละเอียดเมื่อเทียบกับวิธีอื่น
GAN: ผู้สร้างกับผู้ตรวจเรียนรู้จากการแข่งขัน
Generative Adversarial Network มี Generator สร้างตัวอย่างและ Discriminator แยกว่าตัวอย่างมาจากข้อมูลจริงหรือผู้สร้าง ทั้งสองพัฒนาไปพร้อมกันผ่านเกมการแข่งขัน [2] ภาพที่สร้างอาจคมและสมจริง แต่การฝึกอาจไม่เสถียร หาก Generator พบวิธีหลอกผู้ตรวจด้วยตัวอย่างเพียงไม่กี่รูปแบบ อาจเกิด Mode Collapse คือสร้างของคล้ายกันซ้ำและครอบคลุมความหลากหลายไม่พอ งาน Unrolled GAN ศึกษาวิธีลดปัญหานี้โดยคำนึงถึงการตอบสนองของ Discriminator ล่วงหน้า [3]
Autoregressive: สร้างทีละส่วนจากบริบทก่อนหน้า
โมเดล Autoregressive แยกความน่าจะเป็นของข้อมูลลำดับออกเป็นการทำนายส่วนถัดไปทีละขั้น สำหรับภาษา ส่วนหนึ่งอาจเป็น Token ซึ่งไม่จำเป็นต้องตรงกับคำเต็ม โมเดลดูบริบทก่อนหน้าแล้วคำนวณ Token ถัดไป ทำซ้ำจนจบคำตอบ ข้อดีคือสร้างลำดับซับซ้อนได้และกำหนดบริบทได้ยืดหยุ่น ข้อจำกัดคือความผิดช่วงต้นอาจพาเส้นเรื่องถัดไปเบี่ยง และการสร้างยาวต้องทำต่อเนื่องหลายขั้น
Diffusion: เรียนการย้อนจาก Noise ไปสู่ข้อมูล
Diffusion Model ฝึกโดยค่อย ๆ เติม Noise ลงในข้อมูล แล้วเรียนกระบวนการย้อนกลับเพื่อประมาณและลด Noise ระหว่างสร้าง ระบบเริ่มจากสัญญาณที่ดูสุ่มและปรับทีละขั้นจนเกิดโครงสร้างที่สอดคล้องกับเงื่อนไข งาน DDPM แสดงผลการสังเคราะห์ภาพคุณภาพสูงและเชื่อมแนวคิดกับ Denoising Score Matching [6] ภาพจำว่า “ปอก Noise ออก” ช่วยเริ่มต้น แต่สิ่งที่เกิดจริงคือการสุ่มตัวอย่างจากแบบจำลอง ไม่ใช่มีภาพสำเร็จรูปซ่อนอยู่ในก้อน Noise
ตระกูลเหล่านี้ไม่ได้แยกขาดเสมอ ระบบสมัยใหม่อาจผสมองค์ประกอบหลายแบบ เช่น ใช้ Transformer จัดการลำดับและใช้ Diffusion สร้างภาพ หรือใช้ตัวแทนใน Latent Space เพื่อลดขนาดการคำนวณ การจำชื่อจึงไม่สำคัญเท่าการถามว่าโมเดลรับอะไรเข้า สร้างอย่างไร ตรวจอะไรได้ และพลาดแบบใด
Transformer และ Diffusion เปลี่ยนทั้งภาษาและภาพอย่างไร
Transformer ทำให้บริบทจำนวนมากถูกประมวลผลได้มีประสิทธิภาพขึ้น
งาน Attention Is All You Need ปี 2017 เสนอ Transformer ที่ใช้กลไก Attention เป็นแกนและลดการพึ่งการประมวลผลแบบ Recurrent ตามลำดับ [4] Attention ช่วยให้ตัวแทนของ Token หนึ่งตำแหน่งชั่งน้ำหนักว่าบริบทส่วนใดเกี่ยวข้อง ตัวอย่างเช่น คำว่า “มัน” ในประโยคอาจต้องเชื่อมกับคำนามที่อยู่ก่อนหน้า แม้อยู่ห่างหลายคำ
การคำนวณที่ขนานได้ดีขึ้นช่วยให้ฝึกโมเดลกับข้อมูลและพารามิเตอร์ขนาดใหญ่ เมื่อโมเดล Autoregressive แบบ Transformer ได้รับ Prompt มันจึงสร้าง Token ต่อเนื่องโดยใช้บริบทที่เรียนรู้ งาน GPT-3 แสดงว่าการขยายขนาดโมเดลช่วยเพิ่มความสามารถแบบ Few-shot ในหลายงาน โดยให้คำสั่งและตัวอย่างผ่านข้อความโดยไม่ปรับพารามิเตอร์สำหรับแต่ละงาน [5] นี่เป็นหนึ่งในจุดที่หน้าจอสนทนาเริ่มทำให้คนทั่วไปใช้โมเดลภาษาได้โดยไม่ต้องฝึกโมเดลเอง
แต่ Attention ไม่ใช่กลไกค้นความจริงโดยกำเนิด โมเดลอาจเชื่อมคำได้ลื่น สร้างเหตุผลที่ฟังดี และยังตอบผิด เพราะเป้าหมายพื้นฐานของการสร้างคือความสอดคล้องของลำดับ ไม่ใช่การรับประกันว่าทุก Claim ผ่านการตรวจสอบ NIST เรียกผลลัพธ์ผิดที่ถูกนำเสนออย่างมั่นใจว่า Confabulation และชี้ว่าเป็นความเสี่ยงสำคัญของ Generative AI [7]
Diffusion ทำให้การสร้างภาพมีเส้นทางจากความสุ่มสู่โครงสร้าง
เมื่อผู้ใช้พิมพ์ว่า “โปสเตอร์เมนูเครื่องดื่มฤดูฝน โทนเขียวเข้ม” ข้อความจะถูกแปลงเป็นเงื่อนไขเชิงตัวเลข จากนั้นกระบวนการสร้างภาพค่อย ๆ ปรับสัญญาณตั้งต้นให้ไปในทิศทางที่สัมพันธ์กับเงื่อนไข รูปทรงใหญ่เกิดก่อนรายละเอียดเล็กในหลายกรณี แต่แต่ละระบบมี Sampler, จำนวนขั้น และวิธี Conditioning ต่างกัน
การสร้างซ้ำด้วย Prompt เดิมอาจได้ภาพไม่เหมือนเดิมเพราะมีการสุ่ม Seed และการตั้งค่าอื่นเข้ามาเกี่ยวข้อง ความแปรผันเป็นคุณสมบัติที่ช่วยสำรวจทางเลือก แต่เป็นข้อจำกัดเมื่อเราต้องทำซ้ำผลลัพธ์เดิม จึงควรบันทึก Prompt, รุ่นโมเดล, Seed และการแก้ไข เมื่อความสามารถในการทำซ้ำมีความสำคัญ
กรณีศึกษา: จาก Prompt ร้านกาแฟสู่แคมเปญที่ต้องตรวจทุกชั้น
บริบทและโจทย์
ร้านกาแฟริมคลองกำลังเปิดตัวเมนู “ฝนแรก” ทีมมีเวลาไม่มาก จึงใช้ Generative AI ช่วยคิดชื่อรอง ร่างคำบรรยาย สร้างภาพโปสเตอร์ และเสนอแผนโพสต์หนึ่งสัปดาห์ กรณีนี้เป็นสถานการณ์สมมติเพื่ออธิบายกลไก ไม่มีผลทดสอบเชิงธุรกิจจริงและไม่ควรถูกนำไปอ้างว่า AI เพิ่มยอดขายเป็นจำนวนใด
Input: โจทย์ที่ดีต้องบอกเป้าหมาย ข้อเท็จจริง และข้อห้าม
ทีมเริ่มจาก Prompt สั้นว่า “เขียนโพสต์เปิดตัวเมนูกาแฟฤดูฝน” ผลลัพธ์ฟังดูดีแต่กว้างมาก บางร่างบอกว่าเมล็ดกาแฟมาจากจังหวัดที่ร้านไม่ได้ใช้ บางร่างกล่าวถึงส่วนลดที่ไม่มีอยู่ และภาพหนึ่งมีข้อความไทยเพี้ยน นี่ไม่ใช่เรื่องแปลก เพราะ Prompt ไม่ได้ให้ข้อเท็จจริงที่ยืนยันแล้วหรือขอบเขตที่ระบบต้องเคารพ
ทีมจึงสร้าง Brief ใหม่ ระบุชื่อเมนู ส่วนผสมที่ยืนยันได้ กลุ่มลูกค้า น้ำเสียง ช่องทาง จำนวนตัวอักษร คำที่ห้ามใช้ และข้อกำหนดว่า “หากข้อมูลใดไม่มีใน Brief ให้ทำเครื่องหมายว่าต้องถาม ห้ามเดา” การเพิ่มบริบทไม่ได้ทำให้ระบบไม่ผิด แต่ลดพื้นที่ให้ระบบเติมรายละเอียดเองและทำให้คนตรวจเห็นจุดเสี่ยงง่ายขึ้น
Process: สร้างหลายร่างเพื่อเปรียบเทียบ ไม่ยึดร่างแรก
ทีมขอคำบรรยายสามแนว: อบอุ่น เรียบง่าย และสนุก จากนั้นเปรียบเทียบประโยคที่เหมือนกันและต่างกัน การสร้างหลายร่างช่วยแยกส่วนที่มาจาก Brief ออกจากส่วนที่โมเดลเติมเอง ถ้าทุกร่างยืนยันข้อเท็จจริงเดียวกันก็ยังไม่ถือว่าเป็นหลักฐาน เพราะโมเดลอาจทำซ้ำรูปแบบผิดเดิม ความสม่ำเสมอเป็นสัญญาณให้ตรวจ ไม่ใช่ใบรับรองความจริง
สำหรับภาพ ทีมสร้างร่างแบบไม่มีข้อความไทยก่อน แล้ววางตัวอักษรด้วยเครื่องมือที่รองรับการจัดรูปสระและวรรณยุกต์ ตรวจสิทธิ์ของโลโก้ เครื่องหมายการค้า ภาพบุคคล และองค์ประกอบที่อาจคล้ายผลงานอื่น การสั่ง “สไตล์เหมือนศิลปินคนหนึ่ง” ถูกตัดออกจาก Brief เพราะทีมไม่ต้องการเลียนแบบลักษณะเฉพาะของผู้สร้างรายอื่น
Output: แยกสิ่งที่เป็นร่างออกจากสิ่งที่พร้อมใช้งาน
ผลลัพธ์ถูกติดป้ายสามสถานะ ร่างสีเขียวคือส่วนที่ตรง Brief และตรวจแล้ว ร่างสีเหลืองต้องแก้ถ้อยคำหรือภาพ และร่างสีแดงมี Claim ไม่มีหลักฐาน ข้อมูลส่วนตัว หรือองค์ประกอบที่ไม่ควรใช้ การติดป้ายบังคับให้ทีมตอบว่าใครตรวจอะไร แทนการใช้ความรู้สึกว่า “ดูดีแล้ว” เป็นเกณฑ์เดียว
ทีมยังตรวจว่าคำโฆษณาสื่อความหมายเกินจริงหรือไม่ เช่น “ช่วยให้สมองตื่นเต็มประสิทธิภาพ” เป็นข้อความสุขภาพที่ต้องมีหลักฐานและอาจอยู่ภายใต้ข้อกำกับ ส่วน “กลิ่นโกโก้และคาราเมลตามบันทึกการชิมของร้าน” เป็นคำบรรยายที่มีที่มาในบริบทของร้าน การแยกประเภท Claim ช่วยกำหนดระดับการตรวจที่เหมาะสม
Failure: ภาพสวยและภาษามั่นใจอาจซ่อนความผิด
ในรอบหนึ่ง โมเดลเสนอชื่อรางวัลสมมติให้เมล็ดกาแฟ คำกล่าวนี้ดูน่าเชื่อเพราะมีชื่อเวทีและปีครบ แต่เมื่อเปิดแหล่งต้นทางกลับไม่พบ การเขียนชื่อเฉพาะครบไม่ได้เพิ่มความจริง ระบบเพียงสร้างลำดับที่เข้ากับรูปแบบของข้อความประชาสัมพันธ์ หากทีมคัดลอกทันที ร้านจะเผยแพร่ข้อมูลเท็จและต้องรับผิดชอบเอง
อีก Failure เกิดเมื่อทีมเผลอวางรายชื่อลูกค้าประจำพร้อมข้อมูลการสั่งซื้อเข้า Prompt เพื่อขอทำข้อความเฉพาะบุคคล ข้อมูลนี้ไม่จำเป็นต่อการสร้างตัวอย่างและเพิ่มความเสี่ยงด้านความเป็นส่วนตัว ทีมจึงหยุดงาน ลบข้อมูลส่วนบุคคลจาก Input ใช้ตัวอย่างสมมติ และกำหนดนโยบายว่าข้อมูลใดห้ามส่งออกจากระบบร้าน
Human Role และ Monitoring: คนต้องเป็นเจ้าของเกณฑ์และทางกลับ
ผู้จัดการร้านเป็นผู้อนุมัติข้อเท็จจริงและข้อเสนอทางการตลาด นักออกแบบตรวจองค์ประกอบภาพ และผู้ดูแลข้อมูลตรวจว่ามีข้อมูลส่วนตัวหรือสิทธิ์ที่เกี่ยวข้องหรือไม่ หลังปล่อยแคมเปญ ทีมเก็บข้อร้องเรียน ข้อผิดพลาด และร่างที่ถูกปฏิเสธไว้เป็นบทเรียน หากระบบหรือรุ่นโมเดลเปลี่ยน ต้องทดสอบตัวอย่างเดิมใหม่ เพราะพฤติกรรมอาจเปลี่ยนโดยที่ Prompt เหมือนเดิม
กรณีนี้แสดง Input → Process → Output → Failure → Human → Feedback ครบวงจร Generative AI ช่วยลดเวลาสร้างร่างและเพิ่มทางเลือก แต่คุณค่าจริงเกิดเมื่อกระบวนการตรวจทำให้ร่างที่เร็วกลายเป็นงานที่มีเจ้าของ มีหลักฐาน และย้อนกลับได้
เหตุใด Generative AI จึงมาถึงผู้ใช้ทั่วไปในช่วงนี้
แนวคิด Generative Model มีมานานก่อนหน้าจอสนทนา VAE และ GAN ในช่วงปี 2013–2014 ทำให้การเรียนรู้พื้นที่แฝงและการสร้างด้วยการแข่งขันก้าวหน้า Transformer ในปี 2017 เปลี่ยนวิธีประมวลผลลำดับ และ DDPM ในปี 2020 แสดงศักยภาพของ Diffusion ในการสร้างภาพ จุดเปลี่ยนไม่ได้มาจากงานใดงานหนึ่งเพียงลำพัง แต่จากหลายชั้นที่สุกงอมพร้อมกัน
ชั้นแรกคือสถาปัตยกรรมที่ขยายได้ดีขึ้น ชั้นที่สองคือข้อมูลดิจิทัลและกำลังประมวลผล ชั้นที่สามคือวิธีฝึกและปรับโมเดลให้ทำตามคำสั่ง ชั้นที่สี่คือส่วนติดต่อที่ใช้ภาษาธรรมดา เมื่อผู้ใช้ไม่ต้องเขียนโค้ดหรือเตรียมชุดข้อมูลเอง คนจำนวนมากจึงทดลองสร้างข้อความและภาพได้ทันที
ความง่ายของหน้าจอซ่อนระบบขนาดใหญ่ไว้ข้างหลัง ตั้งแต่การรวบรวมและคัดข้อมูล โครงสร้างพื้นฐานการคำนวณ การประเมินความปลอดภัย การให้ Feedback ของมนุษย์ ไปจนถึงการให้บริการและเฝ้าระวัง การพิมพ์ Prompt หนึ่งบรรทัดจึงไม่ใช่หลักฐานว่าเทคโนโลยีทำงานอย่างง่าย หรือไม่มีต้นทุนและผู้ได้รับผลกระทบ
อีกปัจจัยคือโมเดลเดียวสามารถทำงานหลายชนิดจากคำสั่งได้โดยไม่ต้องสร้างหน้าจอเฉพาะทุกงาน ความยืดหยุ่นนี้ทำให้ Generative AI กลายเป็นชั้นกลางของผลิตภัณฑ์จำนวนมาก แต่ก็ทำให้การประเมินยากขึ้น เพราะระบบอาจถูกนำไปใช้ในบริบทที่ผู้พัฒนาไม่ได้ทดสอบ ผู้ใช้จึงต้องตรวจตามงานจริง ไม่อาศัยชื่อรุ่นหรือการสาธิตเพียงอย่างเดียว
ความคล่องไม่เท่ากับความจริง: ข้อจำกัดที่ต้องมองเห็น
Confabulation: เมื่อระบบสร้างสิ่งที่ฟังเหมือนจริงแต่ผิด
NIST อธิบาย Confabulation ว่าเป็นกรณีที่ Generative AI สร้างเนื้อหาผิดหรือเท็จและนำเสนออย่างมั่นใจ ปรากฏการณ์นี้สอดคล้องกับธรรมชาติของระบบที่สร้างผลลัพธ์ให้ใกล้การกระจายของข้อมูล ไม่ได้เปิดฐานข้อเท็จจริงที่รับรองแล้วทุกครั้ง [7] ความเสี่ยงสูงขึ้นเมื่อคำถามปลายเปิด ต้องการความรู้เฉพาะ หรือมีผลต่อการตัดสินใจสำคัญ
วิธีรับมือไม่ใช่เพียงสั่งว่า “ห้ามหลอน” แต่ต้องออกแบบระบบให้มีแหล่งอ้างอิง ตรวจได้ จำกัดขอบเขต และให้คนที่มีความรู้ตรวจ Claim สำคัญ Retrieval หรือการแนบเอกสารอาจช่วยให้คำตอบยึดกับข้อมูลมากขึ้น แต่ยังต้องตรวจว่าโมเดลอ่านแหล่งถูก อ้างตรง และไม่เติมข้อสรุปเกินหลักฐาน
ข้อมูลส่วนตัวและการจดจำ
Prompt อาจถูกส่งไปยังบริการภายนอก เก็บใน Log หรือใช้ตามนโยบายของผู้ให้บริการ ผู้ใช้ต้องทราบว่าข้อมูลไหลไปไหน ใครเข้าถึงได้ เก็บนานเท่าไร และมีทางลบหรือไม่ งานวิจัยการดึงข้อมูลฝึกแสดงว่าการจดจำและการเปิดเผยตัวอย่างเป็นความเสี่ยงที่ต้องประเมิน ไม่ควรใส่รหัสผ่าน เลขบัตร ข้อมูลสุขภาพ ความลับทางธุรกิจ หรือข้อมูลลูกค้าเพียงเพราะหน้าจอดูเหมือนบทสนทนาส่วนตัว [8]
อคติและความครอบคลุม
ถ้าข้อมูลฝึกแทนบางกลุ่มมากกว่ากลุ่มอื่น ผลลัพธ์อาจทำให้ภาพ ภาษา หรือบทบาทบางแบบดูเป็นค่าเริ่มต้น โมเดลอาจสร้างภาพอาชีพที่ผูกกับเพศหรือเชื้อชาติ หรือทำงานกับภาษาที่มีข้อมูลน้อยได้แย่กว่า การตรวจต้องดูหลายกลุ่ม หลายบริบท และคนที่ได้รับผลกระทบ ไม่ใช่ดูตัวอย่างที่สวยที่สุดเพียงชิ้นเดียว
สิทธิ์ ความเป็นต้นฉบับ และการระบุที่มา
ผลลัพธ์สร้างใหม่ไม่ได้หมายความว่าปลอดลิขสิทธิ์ เครื่องหมายการค้า สิทธิ์ในภาพบุคคล หรือเงื่อนไขของข้อมูลต้นทางโดยอัตโนมัติ กฎหมายและเงื่อนไขบริการแตกต่างตามพื้นที่และผลิตภัณฑ์ งานเชิงพาณิชย์จึงต้องตรวจสิทธิ์ของ Input, Reference และ Output แยกกัน หากไม่แน่ใจควรขอคำแนะนำจากผู้เชี่ยวชาญ ไม่ใช้คำตอบของโมเดลเป็นคำวินิจฉัยทางกฎหมาย
ความปลอดภัยและการพึ่งพามากเกินไป
Generative AI อาจช่วยร่างโค้ดหรือคำแนะนำได้ แต่โค้ดอาจมีช่องโหว่ คำแนะนำอาจขาดเงื่อนไข และผู้ใช้อาจเชื่อเพราะคำตอบเรียบร้อย การจัดวางระบบควรกำหนดสิทธิ์ขั้นต่ำ ทดสอบก่อนเชื่อมกับข้อมูลจริง ปิดการทำงานอัตโนมัติในขั้นเสี่ยง และมีทางหยุดหรือย้อนกลับ ความรับผิดชอบไม่ควรถูกโยนให้ “AI ตัดสินใจเอง” เพราะระบบไม่รับผลกระทบแทนผู้ใช้
| สัญญาณเตือน | เหตุใดจึงเสี่ยง | การตอบสนอง |
|---|---|---|
| มีชื่อ ปี ตัวเลข หรือคำพูดที่ไม่มี Source | รายละเอียดเฉพาะทำให้ข้อความดูจริงแม้แต่งขึ้น | เปิดแหล่งปฐมภูมิและตรวจทีละ Claim |
| Input มีข้อมูลส่วนตัวหรือความลับ | ข้อมูลอาจถูกเก็บ ส่งต่อ หรือรั่ว | หยุด ลบหรือทำข้อมูลให้ไม่ระบุตัวตน และตรวจนโยบาย |
| ภาพคล้ายแบรนด์ บุคคล หรือผลงานเฉพาะ | อาจกระทบสิทธิ์และความไว้วางใจ | เปลี่ยน Brief ตรวจที่มา และขออนุญาตเมื่อจำเป็น |
| ผลลัพธ์ดีเฉพาะตัวอย่างง่าย | อาจไม่ครอบคลุมกรณีขอบหรือกลุ่มย่อย | สร้าง Test set ที่แทนบริบทจริงและ Failure Case |
| ไม่มีคนรับผิดชอบก่อนเผยแพร่ | ความผิดถูกส่งต่อโดยไม่มีทางแก้ | กำหนดผู้อนุมัติ Log และ Recovery Plan |
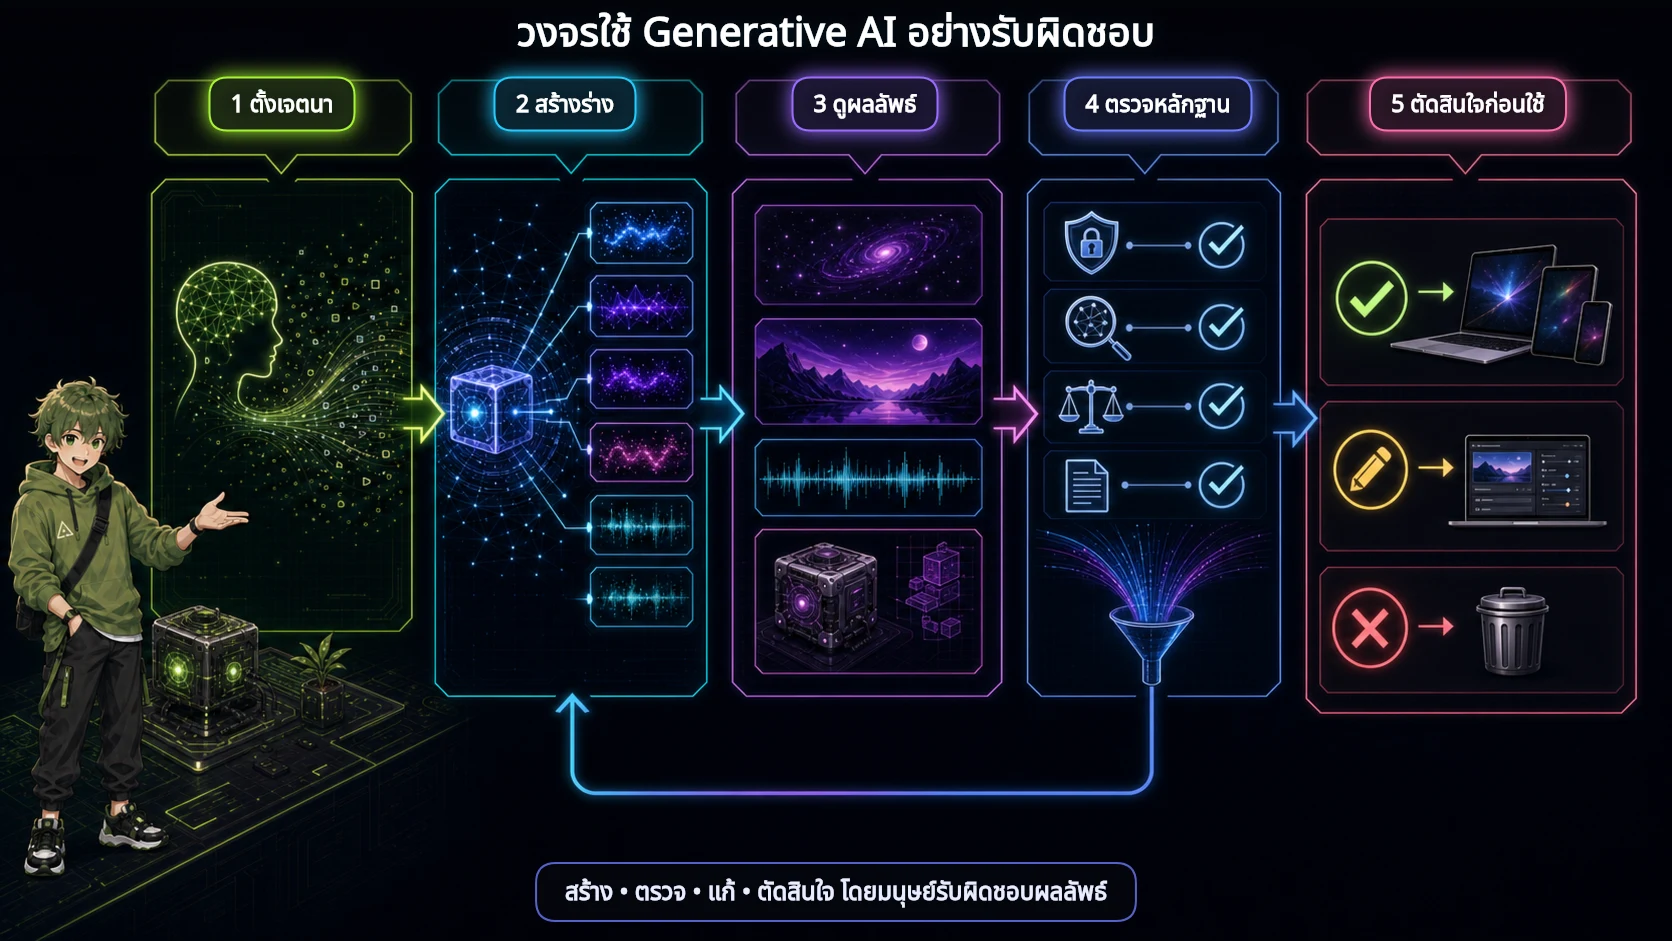
หกด่านตรวจก่อนเปลี่ยน “สร้างได้” ให้เป็น “ใช้ได้”
- ด่าน 1 — จุดประสงค์: งานนี้ต้องการร่างทางเลือก สรุปข้อมูล หรือประกาศข้อเท็จจริง? ถ้าโจทย์ไม่ชัด อย่าเริ่มจาก Prompt ที่กว้างเกินไป
- ด่าน 2 — Input: ข้อมูลที่ส่งเข้าได้รับอนุญาตหรือไม่ มีข้อมูลส่วนตัว ความลับ หรือเนื้อหาที่ไม่ควรถูกส่งออกจากระบบหรือไม่
- ด่าน 3 — หลักฐาน: Claim สำคัญเปิดแหล่งปฐมภูมิได้หรือไม่ ลิงก์มีอยู่จริงและสนับสนุนข้อความตรงหรือไม่
- ด่าน 4 — ผลกระทบ: ใครได้ประโยชน์ ใครรับความเสี่ยง ผลลัพธ์ทำงานแย่กับกลุ่มหรือภาษาบางแบบหรือไม่
- ด่าน 5 — สิทธิ์และความปลอดภัย: ตรวจ License, เครื่องหมาย, ภาพบุคคล, โค้ด และการเชื่อมต่อระบบภายนอกแล้วหรือยัง
- ด่าน 6 — มนุษย์และทางกลับ: ใครอนุมัติ ใครหยุดได้ เก็บ Log อะไร และเมื่อผิดจะถอน แก้ หรือแจ้งผู้ได้รับผลกระทบอย่างไร
ด่านเหล่านี้ไม่จำเป็นต้องใช้ความเข้มเท่ากันทุกงาน การขอไอเดียตั้งชื่อโฟลเดอร์มีผลกระทบน้อยกว่าการร่างคำแนะนำสุขภาพ แต่หลักคิดเหมือนกันคือระดับการตรวจต้องสัมพันธ์กับความเสียหายที่เป็นไปได้ งานความเสี่ยงสูงควรมีผู้เชี่ยวชาญและกระบวนการรับรองเฉพาะด้าน
ความเข้าใจผิดที่ทำให้เราใช้ Generative AI เกินขอบเขต
“ตอบเป็นธรรมชาติ แปลว่าเข้าใจเหมือนคน”
กลไกที่ทำให้คิดเช่นนั้น: ภาษาเป็นสัญญาณที่มนุษย์ใช้ประเมินความคิด เมื่อระบบตอบต่อเนื่อง เราจึงเผลอเติมเจตนาและความเข้าใจให้มัน สิ่งที่ถูกต้อง: ความสามารถทางภาษาอาจสูงมาก แต่ไม่ใช่หลักฐานของประสบการณ์หรือความรับผิดชอบแบบมนุษย์ วิธีตรวจ: ถามคำถามเดียวกันในบริบทเปลี่ยน ตรวจแหล่ง และดูว่าระบบรักษาข้อเท็จจริงได้หรือไม่
“ตอบเหมือนกันสามครั้ง แปลว่าถูก”
กลไกที่ทำให้คิดเช่นนั้น: ความสม่ำเสมอดูเหมือนความมั่นใจ สิ่งที่ถูกต้อง: โมเดลอาจทำซ้ำรูปแบบผิดเดิมเพราะข้อมูลและบริบทเหมือนกัน วิธีตรวจ: เปรียบเทียบกับแหล่งอิสระที่เชื่อถือได้ ไม่ใช้คำตอบหลายรอบของโมเดลเดียวเป็นหลักฐานหลายชิ้น
“ผลลัพธ์ใหม่ย่อมไม่มีปัญหาสิทธิ์”
กลไกที่ทำให้คิดเช่นนั้น: ผู้ใช้ไม่เห็นไฟล์ต้นทางถูกคัดลอกตรง ๆ สิ่งที่ถูกต้อง: สิทธิ์ขึ้นกับ Input, Output, ความคล้าย การใช้งาน และกฎหมายที่เกี่ยวข้อง วิธีตรวจ: บันทึกที่มาและเงื่อนไข ตรวจองค์ประกอบเฉพาะ และหลีกเลี่ยงการเลียนแบบผู้สร้างรายใดอย่างเจาะจง
“Prompt ที่ดีแก้ความเสี่ยงได้ทั้งหมด”
กลไกที่ทำให้คิดเช่นนั้น: Prompt ที่ละเอียดมักทำให้ผลลัพธ์ดีขึ้น สิ่งที่ถูกต้อง: Prompt ช่วยกำหนดเงื่อนไข แต่ไม่เปลี่ยนข้อมูลฝึก ไม่รับประกันความจริง และไม่แทนระบบสิทธิ์หรือการตรวจ วิธีตรวจ: แยก Prompt Quality ออกจาก Evidence, Safety และ Human Approval
แบบฝึก: สร้างและตรวจร่างโดยไม่หลงความลื่นไหล
สิ่งที่ต้องสร้าง: ร่างคำอธิบาย 120–180 คำสำหรับเรื่องที่คุณมีแหล่งทางการหนึ่งแหล่ง เช่น คำอธิบายบริการของหน่วยงานหรือคุณสมบัติผลิตภัณฑ์จากคู่มือ
- คัดข้อเท็จจริงที่ยืนยันแล้ว 5 ข้อจากแหล่งต้นทาง โดยไม่ใส่ข้อมูลส่วนตัวหรือความลับ
- เขียน Prompt ระบุผู้อ่าน น้ำเสียง ความยาว ข้อเท็จจริงห้าข้อ และคำสั่งว่าอย่าเติมข้อมูลนอกแหล่ง
- สร้างสามร่างโดยเปลี่ยนเพียงน้ำเสียง แล้วทำเครื่องหมาย Claim ชื่อเฉพาะ ตัวเลข และประโยคที่เพิ่มจากแหล่ง
- เปิดแหล่งต้นทางตรวจทีละ Claim แยกเป็น ผ่าน ต้องแก้ และปฏิเสธ
- เขียนเหตุผลหนึ่งประโยคต่อการตัดสินใจ และระบุผู้ที่จะรับผิดชอบหากร่างถูกเผยแพร่
สัญญาณว่าสำเร็จ: คุณอธิบายได้ว่าร่างใดถูกเลือกเพราะอะไร ระบุ Claim ที่โมเดลเติมเองได้ และมีหลักฐานเปิดตรวจซ้ำได้
Recovery Step: หากไม่มีแหล่งทางการ ให้เปลี่ยนโจทย์เป็นงานสร้างสรรค์ที่ไม่อ้างข้อเท็จจริง หรือหยุดกิจกรรมไว้ก่อน อย่าใช้ลิงก์ที่โมเดลสร้างขึ้นมาเป็นแหล่งแทนโดยไม่เปิดตรวจ
คำถามสะท้อน: ส่วนใดของงานที่ AI ช่วยลดเวลาได้จริง และส่วนใดที่ยังต้องใช้วิจารณญาณ ความรู้เฉพาะ หรืออำนาจตัดสินใจของมนุษย์?
คำถามที่พบบ่อย
Generative AI กับ LLM เหมือนกันหรือไม่
ไม่เหมือนกันทั้งหมด Large Language Model หรือ LLM เป็น Generative AI กลุ่มหนึ่งที่เน้นภาษา Generative AI ยังรวมระบบสร้างภาพ เสียง วิดีโอ โค้ด ข้อมูลสังเคราะห์ และโครงสร้างชนิดอื่น โมเดลหลายสื่ออาจรับและสร้างข้อมูลมากกว่าหนึ่งชนิดในระบบเดียว
Generative AI ค้นข้อมูลจากอินเทอร์เน็ตทุกครั้งหรือไม่
ไม่จำเป็น โมเดลพื้นฐานอาจสร้างจากพารามิเตอร์และบริบทที่ได้รับโดยไม่มีการค้นเว็บ ระบบบางตัวเชื่อม Search, Retrieval หรือเครื่องมือภายนอก จึงต้องตรวจหน้าที่ของผลิตภัณฑ์และแหล่งที่คำตอบอ้าง การมีลิงก์ไม่ได้แปลว่าเนื้อหาถูกอ่านหรืออ้างตรงเสมอไป
ทำไมตั้ง Temperature ต่ำแล้วยังตอบผิดได้
การลดความสุ่มช่วยให้ผลลัพธ์สม่ำเสมอขึ้น แต่ไม่ได้เพิ่มข้อเท็จจริงใหม่ หากแบบจำลองหรือบริบทนำไปสู่รูปแบบผิด ระบบอาจตอบผิดแบบเดิมอย่างสม่ำเสมอ Temperature จึงเป็นตัวควบคุมการสุ่ม ไม่ใช่ปุ่มเปิดความจริง
ใช้ Generative AI กับงานสุขภาพ กฎหมาย หรือการเงินได้หรือไม่
ใช้ช่วยจัดโครงคำถามหรือร่างเอกสารภายใต้กระบวนการที่เหมาะสมได้ แต่ไม่ควรใช้แทนผู้เชี่ยวชาญหรือการตรวจเฉพาะด้าน งานเหล่านี้มีผลกระทบสูง ข้อมูลอาจอ่อนไหว และกฎเปลี่ยนตามพื้นที่และเวลา ต้องกำหนดขอบเขต แหล่งอ้างอิง วันที่ตรวจ และผู้รับผิดชอบชัดเจน
ถ้าภาพดูสมจริง เราควรระบุว่าเป็นภาพสร้างหรือไม่
ควรเปิดเผยเมื่อบริบททำให้ผู้ชมอาจเข้าใจว่าเป็นเหตุการณ์ บุคคล หรือหลักฐานจริง โดยเฉพาะข่าว การศึกษา โฆษณา และเรื่องที่มีผลต่อความไว้วางใจ นอกจากการระบุแล้วควรตรวจสิทธิ์ ความคล้าย เครื่องหมาย และผลกระทบต่อผู้ที่ถูกนำเสนอด้วย
แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่อธิบายแนวคิดหรือการตัดสินใจได้ดีที่สุด แล้วกด “ตรวจคำตอบ” ระบบจะแสดงคะแนนรวม เฉลย และเหตุผลรายข้อ
สรุป: ยุคที่ทุกคนสร้างได้ ต้องเป็นยุคที่ทุกคนตรวจเป็น
กลับมาที่ร้านกาแฟ คำสั่งหนึ่งบรรทัดช่วยให้ทีมเห็นชื่อ ภาพ และแนวทางที่อาจไม่เกิดขึ้นหากเริ่มจากกระดาษเปล่า นี่คือคุณค่าที่ชัดของ Generative AI: มันลดต้นทุนของการสร้างร่างและทำให้เราสำรวจความเป็นไปได้หลายทางได้เร็วขึ้น
แต่กลไกที่ทำให้มันสร้างได้ก็คือเหตุผลที่เราต้องตรวจ โมเดลเรียนรูปแบบและคำนวณตัวอย่างที่เข้ากับบริบท VAE ใช้พื้นที่แฝง GAN ใช้การแข่งขัน Autoregressive Model สร้างทีละส่วน Transformer ช่วยเชื่อมบริบท และ Diffusion เรียนเส้นทางย้อนจาก Noise ไม่มีแนวทางใดเปลี่ยนความน่าเป็นไปได้ให้เป็นความจริงโดยอัตโนมัติ
Mental Model ที่ควรจำจึงมีสี่คำ: สร้าง → ตรวจ → แก้ → ตัดสินใจ ใช้ AI เพื่อขยายทางเลือก ใช้หลักฐานเพื่อจำกัดความผิด ใช้ผู้เชี่ยวชาญเมื่อผลกระทบสูง และให้มนุษย์หรือองค์กรที่มีอำนาจเป็นเจ้าของการตัดสินใจเสมอ
บทถัดไปจะย้อนมาจัดแผนที่คำศัพท์ว่า AI, Machine Learning และ Deep Learning ต่างกันอย่างไร เพื่อให้คุณเห็นว่า Generative AI อยู่ตรงไหนในภาพใหญ่ และไม่ใช้ชื่อของเทคโนโลยีหลายชั้นแทนกันจนตัดสินใจผิด
ภาพสรุปบทเรียน
เรียนต่อใน PATH 01
เปิด Learning Pack เพื่อดูตำแหน่งของหัวข้อ 8 และเรียนต่อหัวข้อ 9 ซึ่งจะแยกความสัมพันธ์ระหว่าง AI, Machine Learning และ Deep Learning ให้ชัดเจน
ดู Learning Pack ทั้งชุด →แหล่งข้อมูลอ้างอิงและหมายเหตุบรรณาธิการ
- Kingma & Welling — Auto-Encoding Variational Bayes งานต้นฉบับเรื่อง VAE และ Stochastic Variational Inference
- Goodfellow et al. — Generative Adversarial Networks งานต้นฉบับของกรอบ GAN
- Metz et al. — Unrolled Generative Adversarial Networks งานศึกษาความไม่เสถียรและ Mode Collapse
- Vaswani et al. — Attention Is All You Need งานต้นฉบับของ Transformer
- Brown et al. — Language Models are Few-Shot Learners ผลการทดลอง GPT-3 แบบ Few-shot และข้อจำกัด
- Ho, Jain & Abbeel — Denoising Diffusion Probabilistic Models กลไกและผลการทดลอง DDPM
- NIST AI 600-1 — Generative AI Profile กรอบความเสี่ยงเรื่อง Confabulation, Privacy, Bias, Information Integrity, IP และ Human-AI Configuration
- Carlini et al. — Extracting Training Data from Large Language Models งานทดลองการดึงตัวอย่างข้อมูลฝึกจาก GPT-2
ขอบเขตหลักฐาน: กรณีร้านกาแฟและแบบฝึกเป็นสถานการณ์สมมติเพื่อการเรียนรู้ ไม่มีการอ้างผลยอดขายหรือประสิทธิภาพจากการทดลองจริง คำแนะนำด้านสิทธิ์ ความเป็นส่วนตัว และงานเสี่ยงสูงเป็นหลักคิดทั่วไป ไม่ใช่คำแนะนำทางกฎหมาย การแพทย์ หรือการเงินเฉพาะกรณี
หมายเหตุภาพประกอบ: Featured Image และภาพ Inline สร้างด้วย OpenAI ImageGen โดยใช้ Character Sheet ของ RYU และ Style Reference ของ AI Academy ข้อความไทยวางด้วย Noto Sans Thai ผ่าน Skia/OpenType shaping ภาพ Inline เป็น Visual Set เฉพาะบทเรียนหัวข้อ 8 และผ่านการตรวจ Full, 1024×576 และ 300×169
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 3 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 8 · PATH 01 · สถานะ Draft
