ความรู้ก่อนเรียน: ควรรู้ว่า RAM เป็นพื้นที่ทำงานชั่วคราว และ CPU ต้องรอข้อมูลจาก Storage หากยังไม่คุ้น ให้ทบทวนหัวข้อ 32 ก่อน
BEGIN WITH THE WORKFLOW
เมษากำลังทำระบบ AI ช่วยจัดหมวดภาพเอกสารเก่า ทีมมีภาพสแกนหนึ่งแสนสองหมื่นไฟล์ ไฟล์ Metadata, Model Weight, Log และ Checkpoint อีกหลายชุด ตอนทดลองกับข้อมูลหนึ่งพันไฟล์ ทุกอย่างดูเร็ว แต่เมื่อเพิ่มข้อมูลจริง GPU กลับว่างเป็นช่วง ๆ โปรแกรมเปิดช้า และการสำรองข้อมูลกินเวลาจนทีมไม่กล้าทดสอบการกู้คืน
คำถามแรกของทีมคือ “ควรเปลี่ยน HDD เป็น SSD หรือซื้อ NVMe ที่เร็วที่สุดเลยไหม” คำถามนี้ฟังดูสมเหตุผล แต่ยังขาดครึ่งสำคัญ เพราะ Storage ไม่ได้ทำงานโดดเดี่ยว ความเร็วที่ผู้ใช้เห็นขึ้นกับชนิดคำขอ ขนาดไฟล์ สัดส่วนอ่านกับเขียน Queue, Cache, Interface, File System, พื้นที่ว่าง อุณหภูมิ และเส้นทางกู้คืนด้วย
คำตอบสั้น: HDD เหมาะกับงานที่ต้องการความจุมากและยอมรอการเคลื่อนหัวอ่านได้ ส่วน SSD ลดเวลารอของงานสุ่มและตอบสนองเร็วกว่า แต่คำว่า SSD, SATA หรือ NVMe ยังไม่ใช่คำตอบสุดท้าย เราต้องเริ่มจากรูปแบบ I/O ของงาน วัดคอขวด แล้วออกแบบ Backup ที่กู้คืนได้จริง
บทเรียนนี้จะใช้กรณีของเมษาเป็นเส้นเรื่อง ตั้งแต่ข้อมูลออกจากจานหรือ NAND ผ่าน Controller และ Interface เข้าสู่ RAM ไปจนถึงจุดที่ระบบเขียนผลกลับ รวมทั้งดูว่าความเร็วสูงสุดบนกล่องต่างจากประสบการณ์จริงอย่างไร และเหตุใด Storage ที่เร็วมากก็ยังสูญเสียข้อมูลได้
อ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบายเส้นทางข้อมูลจาก HDD หรือ SSD ผ่าน Controller, Interface, File System และ RAM ได้
- แยก Sequential, Random, Read, Write, Block Size, IOPS, Throughput, Latency และ Queue Depth ได้
- อธิบาย Failure Case ของ HDD และ SSD รวมถึงผลของ Cache, พื้นที่ว่าง ความร้อน และ Garbage Collection ได้
- ออกแบบการวัด Storage ให้ใกล้กับ Workflow จริง โดยไม่ใช้คะแนน Benchmark ตัวเดียวตัดสิน
- เลือก Storage, Archive และ Backup จากความต้องการใช้งาน พร้อมกำหนดวิธีทดสอบ Restore ได้
MENTAL MODEL
Storage คือคลังที่ต้องส่งของ ไม่ใช่เพียงพื้นที่ว่าง
ลองนึกถึงห้องเก็บของที่มีของครบ แต่ประตูแคบ พนักงานค้นช้า และมีรถเข็นคันเดียว ความจุของห้องอาจมาก แต่คนใช้งานยังรอ Storage ก็คล้ายกัน Capacity บอกว่าเก็บได้เท่าไร ส่วน Latency บอกว่าเริ่มตอบหนึ่งคำขอช้าเพียงใด Throughput บอกว่าขนข้อมูลต่อเวลาได้มากแค่ไหน และ IOPS บอกว่าจัดการคำขอแยกชิ้นต่อวินาทีได้กี่ครั้ง
อุปมานี้ช่วยเปิดภาพ แต่ของจริงซับซ้อนกว่า เพราะระบบปฏิบัติการอาจ Cache ข้อมูลไว้ใน RAM, Controller อาจรวมคำขอหรือเก็บข้อมูลชั่วคราว และ Application อาจอ่านไฟล์หลายชุดพร้อมกัน เมื่อเราเห็นโปรแกรมเปิดเร็ว ไม่ได้แปลว่า Storage อ่านเร็วเสมอไป อาจเป็นเพราะข้อมูลยังอยู่ใน Cache ในทางกลับกัน เมื่อเห็น Storage ทำงานเต็มร้อยเปอร์เซ็นต์ ก็ไม่ได้บอกเองว่าคอขวดอยู่ที่ตัวไดรฟ์ อาจอยู่ที่ Queue, File System, Network หรือการออกแบบไฟล์
Storage แบบ Non-volatile เก็บข้อมูลได้เมื่อปิดไฟ ต่างจาก RAM ที่ใช้เป็น Working Memory เมื่อโปรแกรมเริ่ม ระบบอ่านโค้ดและข้อมูลจาก Storage เข้า RAM จากนั้น CPU หรือ GPU จึงทำงานกับข้อมูลที่อยู่ใกล้กว่า เมื่อโปรแกรมบันทึกผล ข้อมูลจะเดินย้อนกลับผ่าน Buffer, File System และ Controller ลงสื่อ การอ่านกับการเขียนจึงมีเส้นทางและความเสี่ยงคนละแบบ
กฎจำง่าย: อย่าถามเพียงว่าไดรฟ์เร็วเท่าไร ให้ถามว่า “งานส่งคำขอแบบใด ข้อมูลเดินผ่านอะไร และเราวัดเวลาที่ผู้ใช้รอจากจุดไหนถึงจุดไหน”
DATA PATH
คำขอหนึ่งครั้งต้องผ่านหลายชั้นก่อนถึงสื่อ
โปรแกรมขอเปิด อ่าน เขียน หรือ Flush ข้อมูล
แปลงชื่อไฟล์และตำแหน่งเชิงตรรกะ
ตรวจ Page Cache รวมคำขอ และจัด Queue
ส่งคำสั่งผ่าน SATA, SAS, NVMe, USB หรือ Network
จัดตาราง Cache แก้ข้อผิดพลาด และคุยกับสื่อ
หัวอ่านเข้าถึงจาน หรือ NAND อ่านเขียน Page
ถ้าโปรแกรมเปิดไฟล์ที่เพิ่งอ่านไป ระบบอาจตอบจาก RAM โดยไม่แตะไดรฟ์ นี่คือเหตุผลที่ Benchmark ต้องแยก Cold Cache กับ Warm Cache การทดสอบรอบแรกอาจวัด Storage จริงมากกว่า ส่วนรอบถัดไปอาจวัดหน่วยความจำและ File Cache หากไม่รู้ว่า Cache เปิดอยู่ เราอาจสรุปว่าไดรฟ์เร็วขึ้นหลายเท่า ทั้งที่เพียงอ่านข้อมูลเดิมจาก RAM
เมื่อเขียนข้อมูล โปรแกรมอาจได้รับสัญญาณว่า “เขียนเสร็จ” หลังข้อมูลเข้าถึง Buffer หรือ Cache แต่ก่อนข้อมูลอยู่บนสื่ออย่างปลอดภัย ความหมายของ Flush, Fsync, Write-through และ Power-loss Protection จึงสำคัญกับฐานข้อมูลหรือ Transaction งานทั่วไปอาจยอมแลกความคงทนชั่วขณะกับความเร็ว แต่ระบบที่ห้ามสูญเสียธุรกรรมต้องกำหนดจุด Commit ชัดเจน
ทางเดินนี้ยังมีเพดานหลายจุด ไดรฟ์ NVMe อาจเร็ว แต่ต่อผ่าน Enclosure หรือ Port ที่ช้ากว่า ไฟล์อยู่บน NAS อาจติด Network หรือ Server ฝั่งปลายทาง RAID อาจเพิ่มความขนานแต่สร้างภาระ Parity และการ Rebuild การอ่านตัวเลขจากไดรฟ์เดี่ยวจึงไม่อธิบายระบบปลายทางทั้งหมด
INSIDE HDD
HDD ต้องเคลื่อนหัวอ่านและรอจานหมุน
Hard Disk Drive เก็บข้อมูลด้วยสภาวะแม่เหล็กบน Platter หรือจานที่หมุนด้วย Spindle Motor หัวอ่านเขียนอยู่ปลาย Actuator Arm และเคลื่อนไปยัง Track ที่ต้องการ Firmware กับ Servo ช่วยควบคุมตำแหน่งอย่างละเอียด เมื่อคำขอมาถึง ไดรฟ์ต้อง Seek หรือขยับหัวไปยังแนวข้อมูล จากนั้นรอให้ Sector ที่ต้องการหมุนมาถึงใต้หัว จึงอ่านหรือเขียนได้
เวลารอเชิงกลสองส่วนนี้ทำให้งานสุ่มไฟล์เล็กเสียเปรียบ สมมติว่าคำขอถัดไปอยู่คนละตำแหน่ง หัวอ่านต้องเคลื่อนใหม่และรอรอบหมุนซ้ำ ต่อให้ไฟล์รวมมีขนาดไม่มาก คำขอจำนวนมากก็ทำให้เวลารวมสูง ตรงกันข้าม หากข้อมูลวางต่อเนื่องกัน หัวอ่านเคลื่อนน้อยและอ่านเป็นสายยาวได้ จึงทำ Throughput ของไฟล์ใหญ่ได้สมเหตุผลเมื่อเทียบกับต้นทุนต่อ TB
คำว่า RPM บอกความเร็วรอบ แต่ไม่ใช่คะแนนรวม ความหนาแน่นข้อมูล จำนวน Platter, Firmware, Cache, Interface และรูปแบบการจัดวางไฟล์มีผลด้วย HDD บางรุ่นใช้เทคนิคบันทึกต่างกัน เช่น Conventional Magnetic Recording หรือ Shingled Magnetic Recording ซึ่งอาจมีพฤติกรรมเขียนซ้ำไม่เหมือนกัน ผู้ซื้อจึงต้องอ่านคู่มือรุ่นจริง โดยเฉพาะเมื่อใช้กับ RAID, NAS หรืองานเขียนหนัก
Failure Case ของ HDD เชื่อมกับชิ้นส่วนกลไกและพื้นผิวบันทึก เช่น Motor, Actuator, Head, Vibration, Shock และ Bad Sector แต่คำว่า “มีชิ้นส่วนหมุนจึงเสียแน่” ก็ง่ายเกินไป อายุการใช้งานขึ้นกับรุ่น สภาพแวดล้อม ภาระงาน อุณหภูมิ การผลิต และวิธีติดตั้ง SMART อาจรายงานสัญญาณบางชนิด แต่ไม่รับประกันว่าจะเตือนก่อนทุกเหตุการณ์
ในกรณีของเมษา HDD ยังมีคุณค่า เพราะภาพต้นฉบับจำนวนมากถูกอ่านเป็นชุดใหญ่ไม่บ่อย ทีมยอมรอการคัดลอกเพื่อแลกความจุในงบจำกัดได้ แต่หากใช้ไดรฟ์ลูกเดียวเป็นทั้งพื้นที่ Training, Log, Checkpoint และ Backup หัวอ่านจะสลับตำแหน่งตลอด งานจึงแย่งกันและการเสียหนึ่งครั้งกระทบทุกหน้าที่
INSIDE SSD
SSD ตัดเวลารอเชิงกล แต่ต้องบริหารข้อจำกัดของ NAND
Solid State Drive ไม่มีหัวอ่านเคลื่อนที่ ข้อมูลอยู่ในเซลล์ของ NAND Flash และ Controller รับคำสั่งจาก Host แล้วแปลง Logical Block Address ไปยังตำแหน่งจริง กระบวนการแปลงนี้เรียกว่า Flash Translation Layer หรือ FTL ผู้ใช้มองเห็นพื้นที่ต่อเนื่อง แต่ Controller อาจย้ายข้อมูลจริงไปคนละ Page เพื่อกระจายการสึกและเตรียม Block ว่าง
NAND อ่านและ Program เป็นหน่วย Page แต่ลบเป็นหน่วย Block ที่ใหญ่กว่า และไม่สามารถเขียนทับ Page ที่ใช้แล้วตรง ๆ แบบง่าย เมื่อมีการแก้ข้อมูล Controller มักเขียนเวอร์ชันใหม่ไปยัง Page ว่าง ทำเครื่องหมายของเก่าว่าใช้ไม่ได้ แล้วค่อยทำ Garbage Collection โดยย้าย Page ที่ยังใช้ได้ออกจาก Block ก่อนลบ Block ทั้งก้อน กระบวนการภายในนี้สร้างงานเพิ่มที่ผู้ใช้ไม่เห็น
Write Amplification คือสัดส่วนการเขียนจริงภายใน NAND ต่อข้อมูลที่ Host สั่งเขียน หาก Host เขียนหนึ่งหน่วยแต่ Controller ต้องย้ายข้อมูลเพิ่มหลายหน่วย ค่า Amplification สูงขึ้น การเขียนสุ่ม การเขียนทับบ่อย พื้นที่ว่างน้อย และข้อมูลหลายอายุปะปนกันอาจเพิ่มภาระ Garbage Collection ผลคือ Latency แกว่ง Throughput ต่อเนื่องลด และรอบ Program/Erase ถูกใช้มากขึ้น
Wear Leveling กระจายการเขียนเพื่อลดการสึกเฉพาะจุด Error Correcting Code ช่วยตรวจและแก้ข้อผิดพลาดบางชนิด Bad Block Management แยกพื้นที่ที่ใช้ไม่ได้ และ Over-provisioning กันพื้นที่ให้ Controller หมุนเวียนข้อมูล งานเหล่านี้ทำให้ SSD ใช้ง่าย แต่ไม่ได้ลบข้อจำกัดทางกายภาพ เมื่อไดรฟ์ใกล้เต็มหรือมีงานเขียนยาวต่อเนื่อง พื้นที่ทำงานภายในลดลงและประสิทธิภาพอาจไม่เหมือนช่วงไดรฟ์ใหม่
SSD หลายรุ่นใช้ Cache ที่เขียนได้เร็ว เช่น SLC Cache แม้ NAND หลักจะเป็นชนิดที่เก็บหลายบิตต่อเซลล์ ขนาด Cache อาจคงที่หรือปรับตามพื้นที่ว่าง เมื่องานเขียนเกิน Cache ความเร็วอาจตกสู่ Sustained Write ของ NAND จริง ดังนั้นตัวเลข Burst จากการคัดลอกไฟล์สั้น ๆ ไม่ตอบงาน Checkpoint ขนาดใหญ่ที่เขียนนานหลายนาที
ความร้อนเป็นอีกเงื่อนไข Controller หรือ NAND อาจลดความเร็วเพื่อรักษาอุณหภูมิ เรียกว่า Thermal Throttling ไดรฟ์ M.2 ที่อยู่ใต้ GPU หรือไม่มีทางระบายอากาศอาจทำคะแนนช่วงสั้นดีแต่ตกเมื่อโหลดต่อเนื่อง Endurance จึงต้องอ่านร่วมกับอุณหภูมิ Firmware, TBW หรือ DWPD, ระยะประกัน และภาระงานจริง ไม่ใช่ดูชนิด NAND เพียงคำเดียว
สำหรับเมษา SSD เหมาะกับ Working Dataset และ Index เพราะการเปิดไฟล์เล็กจำนวนมากต้องการ Latency ต่ำ แต่ทีมยังต้องเผื่อพื้นที่ว่าง วัดหลัง Cache หมด และเก็บต้นฉบับอีกชุดแยกจากไดรฟ์ทำงาน การมี SSD เร็วหนึ่งลูกช่วย Training ได้ แต่ไม่ทำให้ข้อมูลปลอดภัยขึ้นเอง
WORKLOAD SHAPE
Sequential, Random, Read, Write และ Block Size เปลี่ยนคำตอบ
Sequential I/O คือการอ่านหรือเขียนตำแหน่งต่อเนื่อง เช่น คัดลอกวิดีโอขนาดใหญ่ อ่าน Archive ที่เรียงข้อมูล หรือเขียน Checkpoint ก้อนใหญ่ ระบบขนข้อมูลเป็นสายยาวและลดค่าใช้จ่ายต่อคำขอได้ งานนี้มักดู Throughput เป็นหลัก แต่ยังต้องดูว่าความเร็วคงอยู่หลัง Cache หมดหรือไม่
Random I/O คือคำขอกระจายหลายตำแหน่ง เช่น เปิดไฟล์ Thumbnail จำนวนมาก อ่าน Record จาก Database หรือสุ่มตัวอย่างภาพระหว่าง Training HDD เสียเวลาขยับหัว ส่วน SSD ไม่มี Seek เชิงกลจึงได้เปรียบชัด แต่ Controller, Queue และ Firmware ยังมีผล Random Read กับ Random Write ก็ไม่เหมือนกัน เพราะการเขียน SSD อาจกระตุ้น Garbage Collection
Block Size คือขนาดข้อมูลต่อคำขอ หากคำขอ 4 KB จำนวนมาก ตัวเลข IOPS สำคัญเพราะมีคำขอมาก หากคำขอ 1 MB ต่อเนื่อง Throughput สำคัญกว่า การพูดว่าไดรฟ์ทำได้หนึ่งแสน IOPS โดยไม่บอก Block Size, Read/Write Mix และ Queue Depth จึงตีความไม่ได้ เช่นเดียวกับ MB/s ที่ไม่บอกว่าเป็น Burst หรือ Sustained
Read/Write Mix สะท้อนว่างานอ่านมากหรือเขียนมาก ระบบค้นหาอาจอ่านหนัก ระบบ Log อาจเขียนต่อเนื่อง Database มีทั้งอ่าน เขียน Flush และ Sync งาน AI Training อ่าน Dataset ซ้ำและเขียน Checkpoint เป็นช่วง ๆ การวัดเฉพาะ Read ทำให้มองไม่เห็นอาการสะดุดตอน Checkpoint ส่วนการวัดเฉพาะ Write ไม่บอกเวลาสุ่มตัวอย่าง
Concurrency และ Queue Depth บอกจำนวนคำขอที่รอพร้อมกัน Queue ลึกช่วยให้ Controller จัดตารางและใช้ความขนานภายในได้มากขึ้น แต่ผู้ใช้ที่เปิดไฟล์หนึ่งไฟล์อาจมี Queue ตื้น คะแนนที่ได้จากหลาย Thread และ Queue สูงจึงไม่เท่ากับ Latency ของการคลิกเปิดโปรแกรม หากเพิ่ม Queue จน Throughput สูงแต่เวลารอต่อคำขอแย่ งาน Interactive อาจรู้สึกช้าลง
| รูปแบบงาน | สิ่งที่ควรวัด | จุดที่มักเข้าใจผิด |
|---|---|---|
| ไฟล์ใหญ่ต่อเนื่อง | Sustained Throughput, อุณหภูมิ, เวลารวม | ใช้ Burst ช่วง Cache เป็นคำตอบ |
| ไฟล์เล็กจำนวนมาก | Random IOPS, Latency, Queue | ดู MB/s สูงสุดเพียงตัวเดียว |
| งาน Interactive | P50/P95 Latency และ Cold Start | ใช้ Queue ลึกที่ไม่ตรงผู้ใช้จริง |
| Log/Checkpoint | Sustained Write, Flush, Endurance | ไม่ทดสอบเมื่อไดรฟ์ใกล้เต็ม |
| Archive/Backup | Capacity, Restore Time, Integrity | คิดว่ามีสำเนาเท่ากับกู้คืนได้ |
MEASURE THE RIGHT THING
IOPS, Throughput และ Latency เป็นคนละคำตอบ
IOPS คือจำนวนการทำงาน Input/Output ต่อวินาที แต่หนึ่ง Operation อาจมีขนาดต่างกัน หนึ่งหมื่น IOPS ที่ 4 KB ขนข้อมูลไม่เท่าหนึ่งหมื่น IOPS ที่ 64 KB เราจึงต้องบอกขนาดคำขอ รูปแบบสุ่มหรือต่อเนื่อง สัดส่วนอ่านเขียน และ Queue Depth ทุกครั้งที่เปรียบเทียบ
Throughput คือปริมาณข้อมูลต่อเวลา มักแสดงเป็น MB/s หรือ GB/s เหมาะกับไฟล์ใหญ่ การ Stream และการคัดลอกจำนวนมาก แต่ Throughput สูงไม่ได้แปลว่าคลิกเปิดไฟล์เล็กแล้วตอบทันที รถบรรทุกขนของได้มากต่อเที่ยว แต่อาจใช้เวลาเริ่มออกตัวนานกว่ามอเตอร์ไซค์ที่ส่งซองหนึ่งชิ้น
Latency คือเวลาตั้งแต่ส่งคำขอจนได้รับผลตอบ เป็นสิ่งที่งาน Interactive และคำขอพึ่งพากันไวต่อมาก ค่าเฉลี่ยอาจซ่อนช่วงแย่ จึงควรดู Percentile เช่น P50, P95 หรือ P99 หากคำขอหนึ่งต้องรอคำขอก่อนหน้า Tail Latency ที่พุ่งเป็นช่วง ๆ อาจทำให้ Pipeline สะดุดแม้ค่าเฉลี่ยดูดี
สามค่านี้สัมพันธ์กันแต่แทนกันไม่ได้ เมื่อเพิ่ม Queue เราอาจเพิ่ม Throughput และ IOPS เพราะมีงานค้างให้ Controller เลือกมากขึ้น ขณะเดียวกัน Latency ต่อคำขออาจสูงขึ้น หากระบบให้บริการผู้ใช้จริง เราต้องกำหนด Service Metric เช่น “เปิดชุดภาพแรกภายในสองวินาที” หรือ “เขียน Checkpoint โดยไม่หยุด Training เกินสิบวินาที” ก่อน แล้วจึงเลือก Metric อุปกรณ์ที่เชื่อมกับเป้าหมายนั้น
Capacity ก็ต้องแยกพื้นที่โฆษณา พื้นที่ที่ระบบมองเห็น พื้นที่หลัง Format, Snapshot, Reserved Space และ Headroom สำหรับการทำงานของ SSD หากทีมใช้พื้นที่จนเหลือน้อย Benchmark วันแรกอาจไม่สะท้อนเดือนที่หก การวางแผนจึงใช้ Peak Data, อัตราเติบโต ระยะเก็บ และพื้นที่ชั่วคราว ไม่ใช่ขนาด Dataset วันนี้เพียงค่าเดียว
INTERFACE, PROTOCOL, CACHE
SATA กับ NVMe เป็นทางสื่อสาร ไม่ใช่ชื่อชนิด NAND
SATA เป็น Interface ที่ใช้กับ HDD และ SSD ได้ ส่วน NVMe เป็นชุด Protocol สำหรับสื่อ Non-volatile และใช้กับ Transport หลายแบบ โดย NVMe SSD สำหรับผู้ใช้ทั่วไปมักเชื่อมผ่าน PCI Express คำว่า M.2 บอก Form Factor และ Connector บางส่วน ไม่รับประกันว่าอุปกรณ์ทุกชิ้นเป็น NVMe เพราะ M.2 บางรุ่นใช้ SATA
ทางเดินมีเพดานของตนเอง SSD SATA อาจติดข้อจำกัด Interface ก่อน NAND ขณะที่ NVMe เปิดทางให้ Queue และความขนานมากขึ้น แต่ผลจริงขึ้นกับ Lane, Generation, Controller, Driver, Cooling และ Workload การใส่ไดรฟ์ลง Slot ที่แบ่ง Lane กับอุปกรณ์อื่นหรือใช้ Adapter ช้าอาจลดประสิทธิภาพ การซื้อจากชื่อ NVMe อย่างเดียวจึงยังไม่พอ
External Storage เพิ่ม USB, Thunderbolt, Cable, Bridge Chip และ Power เข้ามา Enclosure บางตัวร้อนหรือใช้ Protocol แปลงที่เพิ่ม Latency Network Storage เพิ่ม NIC, Switch, Network Stack, Server, RAID และผู้ใช้ร่วม การวัด Local Disk แล้วคาดว่า NAS จะเท่ากันผิดกลไก เพราะตำแหน่งคอขวดเปลี่ยนไป
Cache มีหลายชั้น: Application Cache, OS Page Cache, Controller Cache และ Cache ใน SSD แต่ละชั้นช่วยลดเวลาบางกรณีและอาจซ่อนสื่อจริง การทดสอบต้องระบุว่าต้องการวัดประสบการณ์แบบ Warm ซึ่งผู้ใช้ซ้ำงานเดิม หรือ Cold ซึ่งข้อมูลยังไม่อยู่ใน Cache งานจริงอาจต้องดูทั้งสองแบบ
Queue ไม่ใช่สิ่งไม่ดีเสมอไป มันช่วยดูดซับงานพร้อมกัน แต่ Queue ที่ยาวต่อเนื่องเป็นสัญญาณว่าระบบรับคำขอเร็วกว่าประมวลผลได้ หาก Latency สูงพร้อม Queue สูง เราต้องหาว่าใครสร้างคำขอและสื่ออิ่มหรือไม่ การเพิ่มไดรฟ์เร็วขึ้นอาจช่วย แต่การ Batch, จัด Shard, ลดไฟล์เล็ก หรือกระจายเวลางานก็อาจแก้ตรงกว่าการเปลี่ยนอุปกรณ์
MAIN CASE STUDY
กรณีศึกษา: ระบบจัดหมวดภาพเอกสารของเมษา
บริบท: ทีมมีภาพสแกน 120,000 ไฟล์ เฉลี่ยไฟล์ละไม่กี่ MB เก็บบน HDD ลูกเดียว โปรแกรมสุ่มอ่านภาพ สร้าง Thumbnail และบันทึกผลลง SQLite ระหว่าง Training มี Checkpoint ขนาดหลาย GB ทุกสามสิบนาที ทีมดูเพียงว่า GPU Utilization แกว่งและสรุปว่าไดรฟ์ช้า แต่ยังไม่แยกเวลา Decode, Database และ Cache
Input: ภาพเล็กจำนวนมาก Metadata, Model Weight, Log และ Checkpoint รูปแบบนี้มีทั้ง Random Read, Small Write, Sequential Write และการอ่านซ้ำ หากทุกอย่างอยู่บนไดรฟ์เดียว HDD ต้องสลับหัวระหว่างภาพ Database และ Checkpoint Queue จึงยาวในช่วงเขียน แม้ค่า Throughput เฉลี่ยทั้งชั่วโมงดูไม่สูง
Process: ทีมวาด Data Path ตั้งแต่ Data Loader ขอไฟล์ File System ตรวจ Cache, HDD อ่าน Sector, CPU Decode ภาพ, RAM เก็บ Batch แล้วจึงส่ง Tensor ไป GPU จากนั้นแยก Metric ของแต่ละช่วง พวกเขาวัดเวลารอข้อมูล อัตราการ Decode, Disk Latency, Queue และเวลาหยุดระหว่าง Checkpoint แทนการดู GPU เพียงหน้าเดียว
Baseline: การทดลองใช้ชุดข้อมูลเดียวกันสองรอบ รอบแรก Cold Cache และรอบสอง Warm Cache พร้อมบันทึก Block Size, Read/Write Mix และจำนวน Worker ผลตัวอย่างในบทนี้เป็นสถานการณ์สมมติเพื่อสอนวิธีคิด ไม่ใช่ผล Benchmark ของรุ่นใด ทีมจึงไม่ใช้ตัวเลขสมมติเป็นคำแนะนำซื้อของ
การเปลี่ยนแปลง: ทีมย้าย Working Dataset และ Database ไป SSD เว้นพื้นที่ Headroom จัดภาพเป็น Shard ขนาดพอเหมาะ ลดการเปิดไฟล์กระจัดกระจาย กำหนดเวลาหรือปลายทาง Checkpoint ไม่ให้แย่งงานอ่าน และเก็บต้นฉบับกับ Versioned Backup แยกอีกระบบ HDD เดิมทำหน้าที่ Archive ไม่ใช่รับทุกงานพร้อมกัน
Output และ Success Signal: งานผ่านเมื่อเวลารอ Data Loader ลดลง GPU ว่างเพราะข้อมูลน้อยลง P95 Latency ของการอ่านคงที่ขึ้น และ Checkpoint ไม่ทำให้ Pipeline หยุดเกินเกณฑ์ที่ทีมกำหนด หากย้ายไป SSD แล้ว Decode ยังเป็นคอขวด ทีมจะไม่ซื้อไดรฟ์เพิ่ม แต่ปรับ Image Format, Worker หรือ Preprocessing แทน
Human Role: เมษาต้องกำหนดว่าไฟล์ใดเป็น Source of Truth ใครลบได้ Retention นานเท่าไร และทดสอบ Restore อย่างไร Hardware ไม่ตัดสินความสำคัญของข้อมูลให้เอง และ SMART ไม่ยืนยันว่า Backup ใช้งานได้ ความรับผิดชอบจึงอยู่ที่การออกแบบสิทธิ์ การสำรอง การตรวจผล และแผนตอบเหตุ
FAILURE CASES
อาการช้าไม่ได้มาจากเหตุเดียว และอุปกรณ์ทุกชนิดเสียได้
HDD Seek Thrash
หลายงานสุ่มตำแหน่งพร้อมกันทำให้หัวอ่านเคลื่อนไปมา Queue ยาวและ Latency สูง แม้ปริมาณ MB/s ไม่มาก
SSD Cache Exhaustion
งานเขียนสั้นเร็ว แต่เมื่อ Cache เต็ม ความเร็วตกสู่ระดับ NAND จริงและอาจแกว่งตาม Garbage Collection
Thermal Throttling
Controller ลดความเร็วเมื่อร้อน คะแนนช่วงต้นดี แต่โหลดต่อเนื่องช้าลง จึงต้องวัดอุณหภูมิและระยะเวลาทดสอบ
Drive Nearly Full
พื้นที่ว่างน้อยลด Headroom สำหรับการย้ายข้อมูลภายใน SSD และทำให้ File System จัดพื้นที่ได้ยากขึ้น
Queue Contention
Backup, Antivirus, Indexing, Log และงานหลักแย่งไดรฟ์เดียวกัน อาการเกิดเป็นช่วงและหายเมื่อทดสอบแยกงาน
False Safety
Health แสดงปกติ แต่ Controller, Firmware, Power หรือความผิดพลาดของคนยังทำให้ข้อมูลใช้ไม่ได้
HDD อาจมี Reallocated Sector, Pending Sector, เสียงหรือแรงสั่นผิดปกติ แต่ไม่ควรรอให้มีสัญญาณครบก่อนสำรอง SSD อาจรายงาน Percentage Used, Media Error หรือข้อมูล Endurance ตาม Vendor ทว่าชื่อ Attribute และความหมายไม่เหมือนกันทุกยี่ห้อ การอ่าน SMART จึงต้องเทียบคู่มือรุ่นจริงและดูแนวโน้ม ไม่ใช้ค่าเดียวสร้างคำรับประกัน
Power Failure อาจกระทบข้อมูลที่ยังอยู่ใน Cache หรือโครงสร้าง Metadata แม้ตัวสื่อไม่พัง ระบบระดับองค์กรอาจมี Power-loss Protection แต่ต้องตรวจคุณสมบัติรุ่นจริง UPS ลดความเสี่ยงไฟดับบางส่วน แต่ไม่แทนการออกแบบ Transaction, File System, Backup และการทดสอบหลังเหตุการณ์
Firmware Bug หรือ Controller Failure อาจทำให้ข้อมูลจำนวนมากเข้าถึงไม่ได้พร้อมกัน RAID ช่วย Availability เมื่อไดรฟ์บางลูกเสียตามรูปแบบที่ออกแบบ แต่การ Rebuild สร้างภาระสูง และ RAID ไม่ป้องกันการลบผิด Malware, Corruption หรือไฟไหม้ การมีหลายไดรฟ์ในชุดเดียวจึงไม่เท่ากับมี Backup แยกความเสี่ยง
Failure Case ที่คนมองข้ามคือ Benchmark สวยแต่ระบบจริงช้า เพราะทดสอบไฟล์เดียวต่อเนื่อง ขณะที่งานจริงเปิดไฟล์เล็กและ Decode ด้วย CPU หรือทดสอบบนไดรฟ์ว่างและเย็น แต่ใช้งานจริงใกล้เต็มและร้อน วิธีแก้คือเปลี่ยนเงื่อนไขทดสอบให้ใกล้ Production ไม่ใช่เลือกกราฟที่ตัวเลขสูงที่สุด
DECISION RULE
เลือก Storage จากหน้าที่ ไม่ใช่จากป้ายว่าเร็วที่สุด
| หน้าที่ | ตัวเลือกเริ่มต้น | เหตุผล | สิ่งที่ต้องตรวจเพิ่ม |
|---|---|---|---|
| ระบบปฏิบัติการและโปรแกรม | SSD | ต้องการ Latency ต่ำและ Random Read | Interface, Cooling, Capacity, Reliability |
| Working Dataset ไฟล์เล็ก | SSD/NVMe | ลด Seek และรองรับคำขอขนาน | Queue จริง, Decode, Sharding, Headroom |
| วิดีโอหรือไฟล์ใหญ่ต่อเนื่อง | SSD หรือ HDD ตาม SLA | Throughput และต้นทุนต่อ TB เป็นหลัก | Sustained Rate, Stream พร้อมกัน, Network |
| Archive ที่อ่านไม่บ่อย | HDD/Object/Tape ตามบริบท | เน้น Capacity และต้นทุนระยะยาว | Retention, Integrity, เวลาเรียกคืน, Migration |
| Log และ Checkpoint เขียนหนัก | SSD ที่มี Endurance เหมาะ | ต้องรับ Sustained Write และ Flush | TBW/DWPD, PLP, Thermal, Write Amplification |
| Backup | หลายสำเนาและแยกระบบ | เป้าหมายคือ Recovery ไม่ใช่ความเร็วอย่างเดียว | Offline/Immutable, RPO/RTO, Restore Test |
คำว่า “ตัวเลือกเริ่มต้น” ไม่ใช่คำสั่งซื้อ หากงานต้องเงียบ ประหยัดไฟ หรือพกพา SSD อาจได้เปรียบ หากต้องเก็บข้อมูลจำนวนมากในงบคงที่ HDD อาจเหมาะกว่า หากองค์กรมี NAS, Cloud หรือ Object Storage คำตอบต้องรวม Network, Egress, Availability และผู้ดูแลด้วย
ต้นทุนตลอดวงจรหรือ Total Cost of Ownership รวมราคาซื้อ พื้นที่สำรอง พลังงาน Cooling, Enclosure, Port, Cable, Downtime, เวลาย้ายข้อมูล อะไหล่ การตรวจสุขภาพ การทำ Backup และเวลาคนในการกู้คืน ไดรฟ์ราคาถูกต่อ TB อาจแพงหากทำให้งานหยุดบ่อย ส่วนไดรฟ์เร็วมากอาจไม่คุ้มถ้าคอขวดอยู่ที่ CPU Decode หรือ Network
Readiness Checklist ก่อนเลือก
- ระบุ Dataset ปัจจุบัน อัตราเติบโต พื้นที่ชั่วคราว Snapshot และ Headroom
- แยก Random/Sequential, Read/Write, Block Size และจำนวนงานพร้อมกัน
- กำหนด Success Metric ของผู้ใช้ เช่น Cold Start, P95 Latency หรือเวลาคัดลอก
- วาดเส้นทาง Interface, Lane, Enclosure, Network และ Cache ทุกชั้น
- ตรวจ Sustained Performance เมื่อไดรฟ์ร้อนและพื้นที่ใช้งานใกล้สภาพจริง
- อ่าน Endurance, Warranty, Firmware, Compatibility และคู่มือ Vendor ของรุ่นจริง
- แยก Working Storage, Archive และ Backup พร้อมเจ้าของแต่ละหน้าที่
- กำหนด RPO, RTO, Retention และหลักฐานว่า Restore ผ่าน
AI WORKLOAD
GPU เร็วเพียงใดก็ต้องรอเมื่อข้อมูลมาไม่ทัน
Training Pipeline มักมีหลายช่วง: อ่านไฟล์ Decode/Tokenize, Transform, รวม Batch, ส่งเข้า RAM/VRAM, คำนวณ แล้วเขียน Log หรือ Checkpoint หาก Data Loader ส่ง Batch ไม่ทัน GPU จะว่าง อาการนี้เรียกอย่างไม่เป็นทางการว่า Data Starvation การเพิ่ม GPU จึงไม่ช่วยถ้าเวลาส่วนใหญ่หมดก่อนข้อมูลถึง GPU
ไฟล์เล็กจำนวนมากสร้าง Metadata Operation และคำขอสุ่ม การรวมข้อมูลเป็น Shard, Record หรือ Container ขนาดเหมาะสมอาจลดจำนวนการเปิดไฟล์ Prefetch และ Parallel Worker ช่วยซ้อนเวลาอ่านกับคำนวณ แต่ถ้า Worker มากเกินไป Queue และ CPU Decode อาจอิ่ม เราต้องเพิ่มทีละขั้นและวัด End-to-end แทนการตั้ง Worker สูงสุด
Local SSD ช่วยลด Network Latency สำหรับ Working Set แต่เพิ่มขั้นตอน Stage Data และความเสี่ยงที่สำเนาท้องถิ่นไม่ตรง Source of Truth Shared Storage ช่วยทีมใช้ข้อมูลชุดเดียวกันแต่มีผู้ใช้แย่งกัน Cache ลดการอ่านซ้ำแต่ต้องกำหนด Version และ Invalidation วิธีที่ดีจึงขึ้นกับขนาดทีม ความถี่อัปเดต และต้นทุนย้ายข้อมูล
Model Weight และ Checkpoint เป็นไฟล์ใหญ่ การโหลดครั้งแรกดู Sequential Read ส่วนการบันทึกอาจเป็น Sequential Write และ Flush หาก Checkpoint เขียนพร้อม Training Read ไดรฟ์เดียวกัน งานจะแย่ง Queue การเขียนแบบ Asynchronous ช่วยลดเวลาหยุดได้บางกรณี แต่ต้องตรวจว่าข้อมูลอยู่บนสื่อครบก่อนนับว่า Checkpoint พร้อมกู้คืน
Inference Service มี Cold Start เมื่อต้องโหลด Model เข้าหน่วยความจำ จากนั้นอาจไม่อ่าน Weight ซ้ำบ่อย หากปัญหาเกิดเฉพาะเริ่มระบบ Storage มีผลมาก แต่ Steady-state อาจติด Compute, Memory Bandwidth หรือ Network Log และ Trace ที่เขียนมากเกินไปกลับสร้างคอขวดใหม่ จึงต้องวัดเป็นช่วงชีวิตของบริการ ไม่สรุปจากวินาทีเดียว
Vector Database, Feature Store และ Retrieval System ใช้รูปแบบ I/O ต่างกันตาม Index, Cache และ Query การเปลี่ยนไป NVMe อาจลด Latency แต่ Algorithm, Memory Mapping, Compaction และ Network ยังมีผล หาก Index อยู่ใน RAM เป็นส่วนใหญ่ ไดรฟ์อาจมีผลตอน Build, Restart หรือ Cache Miss มากกว่าทุก Query
สำหรับทีมเมษา Success Metric ไม่ใช่ “ไดรฟ์อ่านได้กี่ GB/s” แต่คือ GPU รอข้อมูลน้อยลง เวลาสร้าง Batch คงที่ P95 ของการเปิดภาพอยู่ในเกณฑ์ และ Checkpoint ไม่แทรกจนงานหยุด หากปรับ Shard กับ Decode แล้วผลดีขึ้นมากกว่าซื้อไดรฟ์ใหม่ นั่นคือการแก้คอขวดจากกลไกจริง
RECOVERY, NOT JUST COPYING
Storage, Sync, RAID, Archive และ Backup ทำหน้าที่ต่างกัน
Working Storage คือพื้นที่ที่ระบบใช้งานอยู่ Sync ทำให้หลายตำแหน่งมีสถานะใกล้กัน RAID เพิ่ม Availability หรือ Performance ตามรูปแบบ Archive เก็บข้อมูลระยะยาวตาม Retention ส่วน Backup มีเป้าหมายให้ย้อนกลับและกู้คืนหลังข้อมูลสูญหายหรือเสียหาย การมีอย่างหนึ่งไม่รับประกันหน้าที่ของอีกอย่าง
ถ้าผู้ใช้ลบไฟล์ผิด ระบบ Sync อาจลบตามทุกเครื่อง หาก Ransomware เข้าถึงไดรฟ์สำรองที่ต่ออยู่ มันอาจเข้ารหัสสำเนาด้วย หาก RAID Controller หรือหลายไดรฟ์ทำงานผิด ไฟล์อาจหยุดพร้อมกัน การแยก Failure Domain เช่น บัญชี ระบบ ตำแหน่ง และช่วงเวลาจึงสำคัญกว่าจำนวนไดรฟ์อย่างเดียว
หลัก 3-2-1 เป็น Mental Model ที่ใช้เริ่มสนทนา: มีข้อมูลรวมอย่างน้อยสามชุด ใช้สื่อหรือระบบอย่างน้อยสองแบบ และมีหนึ่งชุดแยกนอกสถานที่หรือแยกความเสี่ยง อย่างไรก็ดี องค์กรต้องปรับตาม Threat Model เช่น เพิ่ม Immutable หรือ Offline Copy, Encryption, Versioning และสิทธิ์แยกสำหรับข้อมูลสำคัญ
RPO หรือ Recovery Point Objective บอกว่ายอมเสียข้อมูลย้อนหลังได้เท่าไร RTO หรือ Recovery Time Objective บอกว่ายอมให้บริการหยุดนานเท่าไร Backup วันละครั้งอาจผ่าน RPO ของเอกสารทั่วไปแต่ไม่ผ่านธุรกรรม ส่วน Archive ราคาถูกอาจเรียกคืนช้าเกิน RTO การเลือกสื่อจึงเริ่มจากผลกระทบ ไม่ใช่เริ่มจากยี่ห้อ
การทดสอบ Restore ต้องเลือกตัวอย่างจริง กู้ไปยังพื้นที่แยก ตรวจ Hash หรือความสมบูรณ์ เปิดไฟล์และแอปพลิเคชัน วัดเวลา บันทึกข้อผิดพลาด และยืนยันว่าผู้รับผิดชอบทำซ้ำได้ CISA แนะนำให้เก็บ Backup สำคัญแบบ Offline และเข้ารหัส พร้อมทดสอบขั้นตอนเป็นประจำ เพราะ Malware อาจค้นหาและทำลายสำเนาที่เข้าถึงได้
ในกรณีเมษา ภาพต้นฉบับมี Source of Truth ชัด Working Copy อยู่บน SSD, Archive อีกชุดอยู่บน HDD หรือระบบวัตถุ และ Backup แบบ Versioned แยกสิทธิ์ ทีมทดลองสุ่มกู้ภาพ Metadata และ Model Checkpoint ทุกเดือน หากกู้ไฟล์ได้แต่ Database เปิดไม่ได้หรือ Version ไม่ตรง การทดสอบยังไม่ผ่าน
BENCHMARK WITH CONTEXT
วัดก่อนซื้อ และทำให้การทดสอบใกล้กับงานจริง
เริ่มด้วย Baseline ที่ไม่เปลี่ยน Hardware บันทึกเวลางานตั้งแต่ผู้ใช้กดจนผลพร้อม แยก CPU, RAM, GPU, Storage และ Network เท่าที่ทำได้ สำหรับ Windows มี Counter ของ IOPS, Throughput และ Latency ส่วนระบบอื่นมีเครื่องมือเทียบเท่า เป้าหมายไม่ใช่เก็บทุก Metric แต่เชื่อมอาการกับจุดรอ
สร้าง Test Matrix เล็ก ๆ แทนการกด Benchmark ค่าเดียว เช่น Random Read ไฟล์เล็ก, Sequential Read ไฟล์ใหญ่, Sustained Write ที่ยาวกว่า Cache, Mixed Read/Write และงานจริงหนึ่งรอบ ระบุ Dataset, Block Size, Queue Depth, Thread, Cache State, พื้นที่ว่าง อุณหภูมิ และ Software Version เพื่อให้ทำซ้ำได้
ทดสอบ Cold และ Warm แยกกัน รอบ Cold ช่วยเห็นการเข้าถึง Storage ส่วน Warm สะท้อนการใช้ซ้ำจาก Cache อย่าล้าง Cache บนระบบ Production โดยไม่เข้าใจผล และอย่ารัน Benchmark เขียนหนักบนไดรฟ์ที่มีข้อมูลสำคัญ ใช้ไฟล์ทดสอบ พื้นที่แยก และขอบเขตเวลาที่ปลอดภัย
อ่าน Distribution ไม่ใช่เฉลี่ยอย่างเดียว หาก P50 ดีแต่ P99 แย่ ผู้ใช้บางคำขอจะสะดุด ตรวจช่วงที่ Cache หมด Checkpoint เริ่ม หรืออุณหภูมิสูง แล้วเทียบ Timeline หลายระบบพร้อมกัน การเห็น GPU ต่ำพร้อม Disk Latency สูงเป็นเบาะแส ไม่ใช่ข้อพิสูจน์จนกว่าจะเปลี่ยนตัวแปรหนึ่งอย่างและผลเปลี่ยนตาม
หลังเปลี่ยน Storage ให้ทดสอบ Outcome เดิม ไม่ใช่เพียงคะแนนใหม่ ถ้า Training Time ลดแต่ค่าใช้จ่ายสูงเกินหรือ Restore ยากขึ้น การตัดสินใจอาจไม่ผ่าน หาก Latency ไม่เปลี่ยน ให้ย้อน Data Path และตรวจ Decode, Serialization, Network หรือ Lock แทนการซื้อรุ่นแรงกว่า
วงจรทดลองที่ทำซ้ำได้
- ทำนาย: ระบุว่าคอขวดอยู่ตรงไหนและ Metric ใดควรเปลี่ยน
- วัด: เก็บ Baseline ด้วยข้อมูลและภาระงานคงที่
- เปลี่ยนหนึ่งตัวแปร: เช่น ย้าย Working Set ไป SSD หรือรวมไฟล์เป็น Shard
- เปรียบเทียบ: ดู End-to-end, P95, Throughput, Error และต้นทุน
- อธิบาย: เชื่อมผลกับกลไกและบันทึกสิ่งที่ยังไม่แน่ใจ
- ย้อนกลับ: หากผลไม่ดี ให้คืนค่าและตรวจจุดถัดไปใน Data Path
MISCONCEPTIONS
ความเข้าใจผิดที่พบบ่อย และวิธีตรวจ
ความเข้าใจผิด: SSD เร็วกว่า จึงดีที่สุดทุกงาน
กลไกที่ทำให้คิดเช่นนั้น: SSD ลด Seek และให้ Latency ต่ำ จึงรู้สึกเร็วมากกับระบบปฏิบัติการและไฟล์เล็ก สิ่งที่ถูกต้อง: งาน Archive อาจให้ความสำคัญกับต้นทุนต่อ TB, Retention และเวลาเรียกคืนมากกว่า Random Latency วิธีตรวจ: เขียน SLA และ TCO ของหน้าที่นั้นก่อนเปรียบเทียบสื่อ
ความเข้าใจผิด: NVMe คือ NAND ที่เร็วกว่าชนิดอื่นเสมอ
กลไกที่ทำให้คิดเช่นนั้น: ชื่อ NVMe มักปรากฏกับไดรฟ์ประสิทธิภาพสูง สิ่งที่ถูกต้อง: NVMe เป็น Protocol/Interface Set ส่วนผลจริงขึ้นกับ Controller, NAND, Lane, Cooling, Firmware และ Workload วิธีตรวจ: อ่านสเปกรุ่นจริงและทดสอบ Sustained Performance ใน Slot ที่จะใช้
ความเข้าใจผิด: ตัวเลข MB/s สูงสุดบอกความเร็วทั้งหมด
กลไกที่ทำให้คิดเช่นนั้น: ตัวเลขใหญ่เปรียบเทียบง่ายและเด่นบนกล่อง สิ่งที่ถูกต้อง: งานไฟล์เล็กสนใจ Latency/IOPS งานเขียนยาวสนใจ Sustained Rate และงานผู้ใช้สนใจ End-to-end วิธีตรวจ: จับคู่ Metric กับ I/O Pattern และ Service Metric
ความเข้าใจผิด: SMART ขึ้น Good จึงไม่ต้อง Backup
กลไกที่ทำให้คิดเช่นนั้น: Health Status ดูเหมือนใบรับรอง สิ่งที่ถูกต้อง: SMART ช่วยเฝ้าสัญญาณบางชนิด แต่ไม่ทำนาย Power, Controller, Firmware, Malware หรือการลบผิดทุกกรณี วิธีตรวจ: ตรวจ Backup แยกและทำ Restore Test ตามกำหนด
ความเข้าใจผิด: RAID คือ Backup
กลไกที่ทำให้คิดเช่นนั้น: ข้อมูลกระจายหลายไดรฟ์และยังทำงานได้เมื่อบางลูกเสีย สิ่งที่ถูกต้อง: RAID เน้น Availability ตาม Fault Model แต่การลบผิดหรือ Corruption อาจกระจายทุกลูก วิธีตรวจ: ลองตอบว่าจะย้อนกลับไฟล์เมื่อวานและกู้หลังบัญชีถูกยึดได้จากที่ใด
ความเข้าใจผิด: ซื้อไดรฟ์ใหม่แล้ว Training ต้องเร็วขึ้น
กลไกที่ทำให้คิดเช่นนั้น: GPU Utilization ต่ำถูกตีความว่า Storage ช้า สิ่งที่ถูกต้อง: Data Loader อาจติด CPU Decode, Network, Lock หรือรูปแบบไฟล์ วิธีตรวจ: วัด Timeline และเปลี่ยนเฉพาะ Storage หนึ่งตัวแปร หากเวลารอไม่ลด ให้ตรวจขั้นถัดไป
LIMITS AND HUMAN RESPONSIBILITY
ไม่มี Metric เดียวแทนความน่าเชื่อถือ และไม่มีสื่อใดรับผิดชอบแทนคน
บทเรียนนี้อธิบายหลักทั่วไป ไม่ใช่คำแนะนำซื้อรุ่นเฉพาะ ผลิตภัณฑ์แต่ละรุ่นมี NAND, Firmware, Cache, Endurance, Interface และการรับประกันต่างกัน ราคาก็เปลี่ยนตามเวลา ผู้เรียนต้องตรวจเอกสารทางการและทดสอบกับระบบของตนก่อนตัดสินใจ โดยเฉพาะงานฐานข้อมูล ระบบสุขภาพ การเงิน หรือบริการสำคัญ
Benchmark สังเคราะห์ช่วยแยกความสามารถ แต่ไม่จำลองทุก Application การทดสอบจริงหนึ่งชุดก็ไม่กลายเป็นกฎสากลเพราะ Dataset, OS, Driver, File System และอุณหภูมิต่างกัน เราควรรายงานเงื่อนไขและระดับความมั่นใจ พร้อมบอกสิ่งที่ยังไม่ได้ทดสอบ มากกว่าสรุปว่าอุปกรณ์หนึ่ง “ชนะ” แบบไม่มีบริบท
Encryption ช่วยป้องกันข้อมูลเมื่ออุปกรณ์สูญหาย แต่เพิ่มความรับผิดชอบด้าน Key Management หากกุญแจหาย Backup อาจใช้ไม่ได้ Secure Erase, Disposal และสิทธิ์เข้าถึงสำคัญเมื่อไดรฟ์มีข้อมูลส่วนตัว การเปลี่ยน Hardware จึงต้องมีแผนย้าย ตรวจ และทำลายข้อมูลตามนโยบาย ไม่ใช่เพียงถอดของเก่าเก็บไว้
มนุษย์ต้องกำหนด Data Owner, Source of Truth, Retention, Access Control, RPO, RTO และ Stop Rule เมื่อ Health หรือ Latency เกินเกณฑ์ ทีมต้องรู้ว่าใครมีสิทธิ์หยุดงาน ใครตรวจ Restore และใครรับ Incident หากไม่มีเจ้าของ ระบบ Monitoring ที่แจ้งเตือนก็อาจถูกมองข้าม
การเลือก Storage มีผลต่อพลังงาน วัสดุ และขยะอิเล็กทรอนิกส์ การซื้อเกินความต้องการทุกชั้นไม่ใช่ความปลอดภัยโดยอัตโนมัติ การวัด Capacity Growth และยืดอายุใช้งานด้วยหน้าที่ที่เหมาะ เช่น ย้ายไดรฟ์เก่าไปงานที่ไม่สำคัญหลังตรวจสุขภาพ อาจลดต้นทุนได้ แต่ข้อมูลสำคัญต้องอยู่ในขอบเขต Reliability และ Support ที่ยอมรับได้
PRACTICE
Worksheet: Storage Journey and Recovery Card
เลือกงานหนึ่งงานของคุณ เช่น เปิดโปรเจกต์ ตัดต่อวิดีโอ ฝึกโมเดล สำรองภาพ หรือให้บริการฐานข้อมูล แล้วกรอกการ์ดนี้ เป้าหมายไม่ใช่ทายยี่ห้อ แต่สร้างหลักฐานพอให้รู้ว่าควรเปลี่ยนอะไร
- งานและผู้ใช้: ใครรออะไร งานสำเร็จเมื่อใด และความล่าช้ามีผลอย่างไร
- ข้อมูล: ขนาดรวม จำนวนไฟล์ ขนาดต่อไฟล์ อัตราเติบโต และข้อมูลใดเป็น Source of Truth
- I/O Pattern: Random หรือ Sequential, Read หรือ Write, Block/ไฟล์เล็กหรือใหญ่ และมี Concurrency เท่าไร
- Data Path: Application → File System/Cache → Interface/Network → Controller → Media → RAM/CPU/GPU
- Baseline: End-to-end Time, P50/P95 Latency, IOPS, Throughput, Queue, CPU/GPU Wait และอุณหภูมิ
- คำทำนาย: ถ้าเปลี่ยน Storage Metric ใดควรดีขึ้น และ Metric ใดไม่ควรเปลี่ยน
- การทดลอง: เปลี่ยนหนึ่งตัวแปร ใช้ข้อมูลเดิม และทดสอบ Cold/Warm ตามความเหมาะสม
- Success Signal: ระบุเกณฑ์ผ่านเป็นตัวเลขหรือพฤติกรรมที่ตรวจได้ ไม่ใช้คำว่า “รู้สึกเร็ว” เพียงอย่างเดียว
- Recovery: RPO, RTO, จำนวนสำเนา ตำแหน่งที่แยก สิทธิ์ และวันที่ Restore Test ล่าสุด
- Recovery Step เมื่อการทดลองไม่ดี: คืนค่าเดิม ตรวจ Decode/Network/Lock แล้วเลือกตัวแปรถัดไป
คำถามอธิบาย: เพราะเหตุใด Storage ที่ Throughput สูงกว่าจึงอาจไม่ลดเวลาของงานคุณ และ Failure Case ใดจะทำให้ผลทดสอบสั้นเกินจริง?
สัญญาณว่าทำสำเร็จ: คนอีกคนอ่านการ์ดแล้วสามารถทำการทดสอบซ้ำ อธิบาย Metric ที่เลือก และชี้ตำแหน่ง Backup ที่กู้คืนได้โดยไม่ต้องเดาจากชื่อผลิตภัณฑ์
CHECK YOUR UNDERSTANDING
แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่ดีที่สุดเพียงหนึ่งข้อในแต่ละข้อ แล้วกด “ตรวจคำตอบ” ระบบจะแสดงคะแนนรวม เฉลย เหตุผลรายข้อ และจำนวนข้อที่ยังไม่ได้ตอบ
CONCLUSION
บทสรุป: เลือก Storage จากงานที่เดินผ่านมัน และแผนที่พาข้อมูลกลับมา
กลับมาที่คำถามของเมษา ทีมไม่ได้แก้ปัญหาด้วยประโยคว่า “SSD เร็วกว่า HDD” แต่แยกหน้าที่ก่อน Working Dataset ที่มีไฟล์เล็กและสุ่มอ่านย้ายไป SSD, Archive ที่เน้นความจุอยู่บนสื่อที่คุ้มกว่า Checkpoint ไม่แย่ง Queue โดยไม่จำเป็น และ Backup ถูกแยกสิทธิ์พร้อมทดสอบ Restore
HDD ใช้จานแม่เหล็กและหัวอ่าน จึงมี Seek กับ Rotational Latency แต่ยังเหมาะกับความจุและงานต่อเนื่องบางแบบ SSD ลดเวลารอเชิงกลแต่ต้องจัดการ Page, Block, Garbage Collection, Wear, Cache และ Thermal ทั้งสองแบบมี Controller, Firmware, Interface และ Failure Mode ของตนเอง
Mental Model ที่ควรจำมีสามชั้น: หนึ่ง งานส่งคำขอรูปแบบใด สอง ข้อมูลผ่านทางและ Queue ใด สาม เมื่อข้อมูลหายหรือเสีย เรากู้จากไหนภายในเวลาเท่าไร หากตอบครบ เราจะอ่าน IOPS, Throughput, Latency และ Endurance อย่างมีความหมาย ไม่ถูกตัวเลขสูงสุดนำทาง
Insight Gate: ลองอธิบาย Storage ของงานคุณโดยไม่เอ่ยชื่อยี่ห้อ หากบอก I/O Pattern, จุดคอขวด, Metric ที่พิสูจน์ผล, Failure Case และ Restore Test ได้ คุณพร้อมตัดสินใจจากหลักฐานแล้ว
SUMMARY INFOGRAPHIC
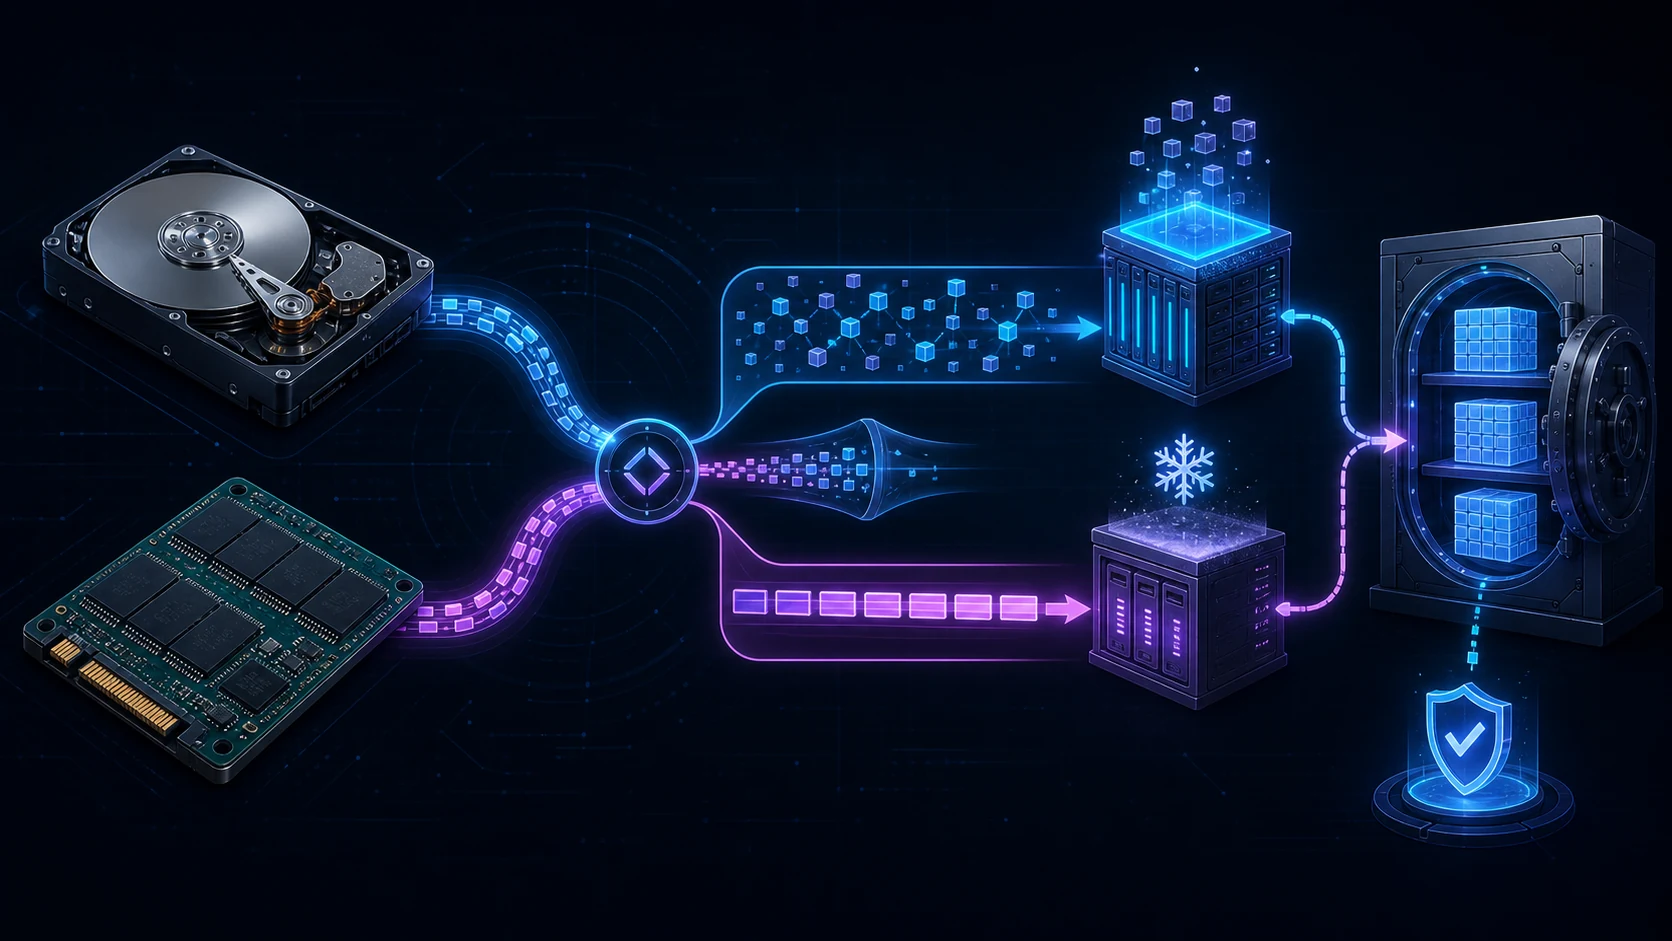
ภาพสรุป: จากสื่อ ผ่านรูปแบบ I/O ไปถึง Archive และ Backup
เรียนต่ออย่างมีทิศทาง
บทถัดไปจะพาเข้าใจ GPU ว่าทำไมงานขนานจึงเร็วเมื่อข้อมูลมาถึงทัน และเหตุใด Storage, CPU และ RAM ยังเป็นส่วนของระบบเดียวกัน ความรู้จากบทนี้จะช่วยให้คุณไม่ตีความ GPU ว่างว่า “ต้องซื้อ GPU เพิ่ม” โดยไม่ตรวจ Data Path ก่อน
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงและบันทึกบรรณาธิการ
- Seagate — Hard Drives and SSDs: กลไก Platter, Head และ Actuator ของ HDD
- Samsung Semiconductor — SSD White Paper: NAND, Controller, Firmware, Wear Leveling และ Garbage Collection
- Samsung Semiconductor — Data Placement and Write Amplification: ความสัมพันธ์ระหว่าง Write Pattern, Garbage Collection และ WAF
- NVM Express — Specifications: ขอบเขต Protocol, Command Set และ Transport ของ NVMe
- SNIA — Throughput, IOPS and Latency: Metric ต้องตีความตาม Workload
- Microsoft Learn — Performance History for Drives: นิยามและหน่วยของ IOPS, Throughput และ Latency
- Microsoft Learn — Benchmark Your Application on Azure Disk Storage: ผลของ Block Size, Random/Sequential, Queue และ Cache ต่อการทดสอบ
- CISA — StopRansomware Guide: Offline/Encrypted Backup และการทดสอบ Restore อย่างสม่ำเสมอ
- NIST SP 1339 — OT Backup Quick Start Guide: การสร้าง ทดสอบ และทบทวน Backup ระหว่าง Recovery Exercise
- Backblaze — Drive Test Data: ตัวอย่างข้อมูลภาคสนามที่ต้องอ่านตามรุ่น กลุ่มประชากร และเงื่อนไข
ตรวจข้อเท็จจริงและทบทวนภาษาไทยล่าสุด 10 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 33 · PATH 01 · กรณีของเมษาเป็นสถานการณ์สมมติเพื่ออธิบายวิธีคิด ไม่ใช่ผล Benchmark ของผลิตภัณฑ์ใด · ภาพสรุปสร้างด้วย OpenAI ImageGen แบบไม่มีข้อความ เวอร์ชัน 1 ผู้สร้าง Insightful AI World ปรับเป็น WebP สำหรับเว็บไซต์
