ลองนึกถึงเช้าวันจันทร์ของบริษัทเล็ก ๆ ชื่อ “สายรุ้งมาร์เก็ต” กล่องอีเมลกลางของบริษัทมีข้อความใหม่เกือบหนึ่งพันฉบับ บางฉบับเป็นคำสั่งซื้อจริง บางฉบับเป็นใบสมัครงาน บางฉบับเป็นโฆษณา และบางฉบับเป็นข้อความหลอกให้พนักงานกดลิงก์ ฝ่ายไอทีจึงเสนอว่า “เราควรใช้ AI ช่วยคัดอีเมล” ประโยคนี้ฟังดูทันสมัย แต่ยังไม่บอกเลยว่าระบบจะทำงานอย่างไร ต้องใช้ข้อมูลชนิดใด หรือหากคัดผิดแล้วใครจะรับผิดชอบ
ทีมแรกเสนอให้เขียนกฎ เช่น ถ้าอีเมลมีคำว่า “รับรางวัลทันที” พร้อมลิงก์ที่ไม่รู้จัก ให้ส่งเข้ากล่องต้องสงสัย ทีมที่สองเสนอให้ฝึกโมเดลจากอีเมลเก่าที่พนักงานเคยระบุว่าเป็นสแปมหรือไม่ใช่สแปม ส่วนทีมที่สามเสนอใช้โครงข่ายประสาทเทียมหลายชั้นเพื่ออ่านทั้งถ้อยคำ ลำดับภาษา และบริบท แต่ละแนวทางอาจอยู่ในระบบ AI ได้เหมือนกัน ทว่าไม่ได้เป็นเทคโนโลยีชนิดเดียวกัน และมีต้นทุนกับความเสี่ยงต่างกัน
แผนที่เริ่มต้นที่จำง่ายคือ Deep Learning อยู่ภายใน Machine Learning และ Machine Learning อยู่ภายใน AI คล้ายวงสามวงซ้อนกัน วงนอกบอกขอบเขตของระบบที่สร้างผลลัพธ์จากการอนุมาน วงกลางบอกว่าส่วนหนึ่งของระบบเรียนรูปแบบจากข้อมูล และวงในบอกว่าใช้โครงข่ายหลายชั้นเรียนตัวแทนของข้อมูล อย่างไรก็ตาม วงซ้อนเป็นเพียงแผนที่คำศัพท์ ไม่ใช่ภาพสถาปัตยกรรมทั้งหมดของระบบจริง
อ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบายความสัมพันธ์ของ AI, Machine Learning และ Deep Learning ด้วยแผนภาพสามวงและภาษาของตนเองได้
- จำแนกระบบตัวอย่างว่าเป็น AI แบบใช้กฎ, Machine Learning หรือ Deep Learning พร้อมให้เหตุผลจากกลไกได้
- อธิบายเส้นทางจากข้อมูลฝึกไปสู่ผลทำนาย รวมถึงจุดที่ระบบอาจผิดพลาดได้
- เปรียบเทียบข้อแลกเปลี่ยนด้านข้อมูล การคำนวณ การอธิบาย และการดูแลระบบของแต่ละแนวทางได้
- ใช้คำถามตรวจสอบห้าข้อเพื่อไม่หลงกับคำโฆษณาว่า “ใช้ AI” และเลือกคำให้ละเอียดพอกับการตัดสินใจได้
แผนที่สามวงบอกอะไรเรา
วงนอกสุดคือ Artificial Intelligence หรือ AI ภายในวงนั้นมี Machine Learning และภายใน Machine Learning มี Deep Learning ความสัมพันธ์นี้เป็นความสัมพันธ์แบบ “เป็นส่วนหนึ่งของ” ไม่ใช่สามตัวเลือกที่อยู่คนละฝั่ง หากระบบหนึ่งใช้ Deep Learning เราจึงพูดได้พร้อมกันว่าระบบนั้นใช้ Machine Learning และอยู่ในขอบเขตของ AI แต่ถ้าระบบหนึ่งเป็น AI เราจะย้อนสรุปทันทีไม่ได้ว่ามันต้องใช้ Machine Learning เพราะ AI ยังครอบคลุมแนวทางที่ใช้กฎ การค้นหา การวางแผน และการแทนความรู้ด้วย
เหตุผลที่คนมักสับสนคือคำทั้งสามถูกใช้คนละระดับ คำว่า AI มักใช้พูดถึงความสามารถหรือระบบโดยรวม เช่น ระบบช่วยตัดสินใจ ระบบแนะนำ หรือระบบสนทนา ส่วน Machine Learning มักใช้พูดถึงวิธีที่โมเดลปรับพารามิเตอร์จากข้อมูล และ Deep Learning มักใช้พูดถึงตระกูลสถาปัตยกรรมที่มีชั้นคำนวณหลายชั้น เมื่อเอาคำที่ตอบคนละคำถามมาเปรียบเทียบกัน จึงเกิดประโยคคลุมเครืออย่าง “ควรใช้ AI หรือ Deep Learning” ทั้งที่ Deep Learning เป็นวิธีหนึ่งภายในงาน AI
สำหรับบริษัทสายรุ้งมาร์เก็ต วงนอกคือเป้าหมายให้ระบบช่วยจัดอีเมลเป็นหมวดเพื่อให้พนักงานทำงานเร็วขึ้น วงกลางปรากฏเมื่อทีมใช้ตัวอย่างอีเมลในอดีตมาฝึกโมเดลให้ค้นหารูปแบบที่สัมพันธ์กับคำว่า “สแปม” วงในปรากฏเมื่อทีมใช้โครงข่ายหลายชั้นเรียนตัวแทนของข้อความและบริบทเอง หากทีมใช้กฎที่ผู้เชี่ยวชาญกำหนด ระบบยังอาจเป็น AI ในความหมายกว้าง แต่ไม่มีขั้นตอนฝึก Machine Learning
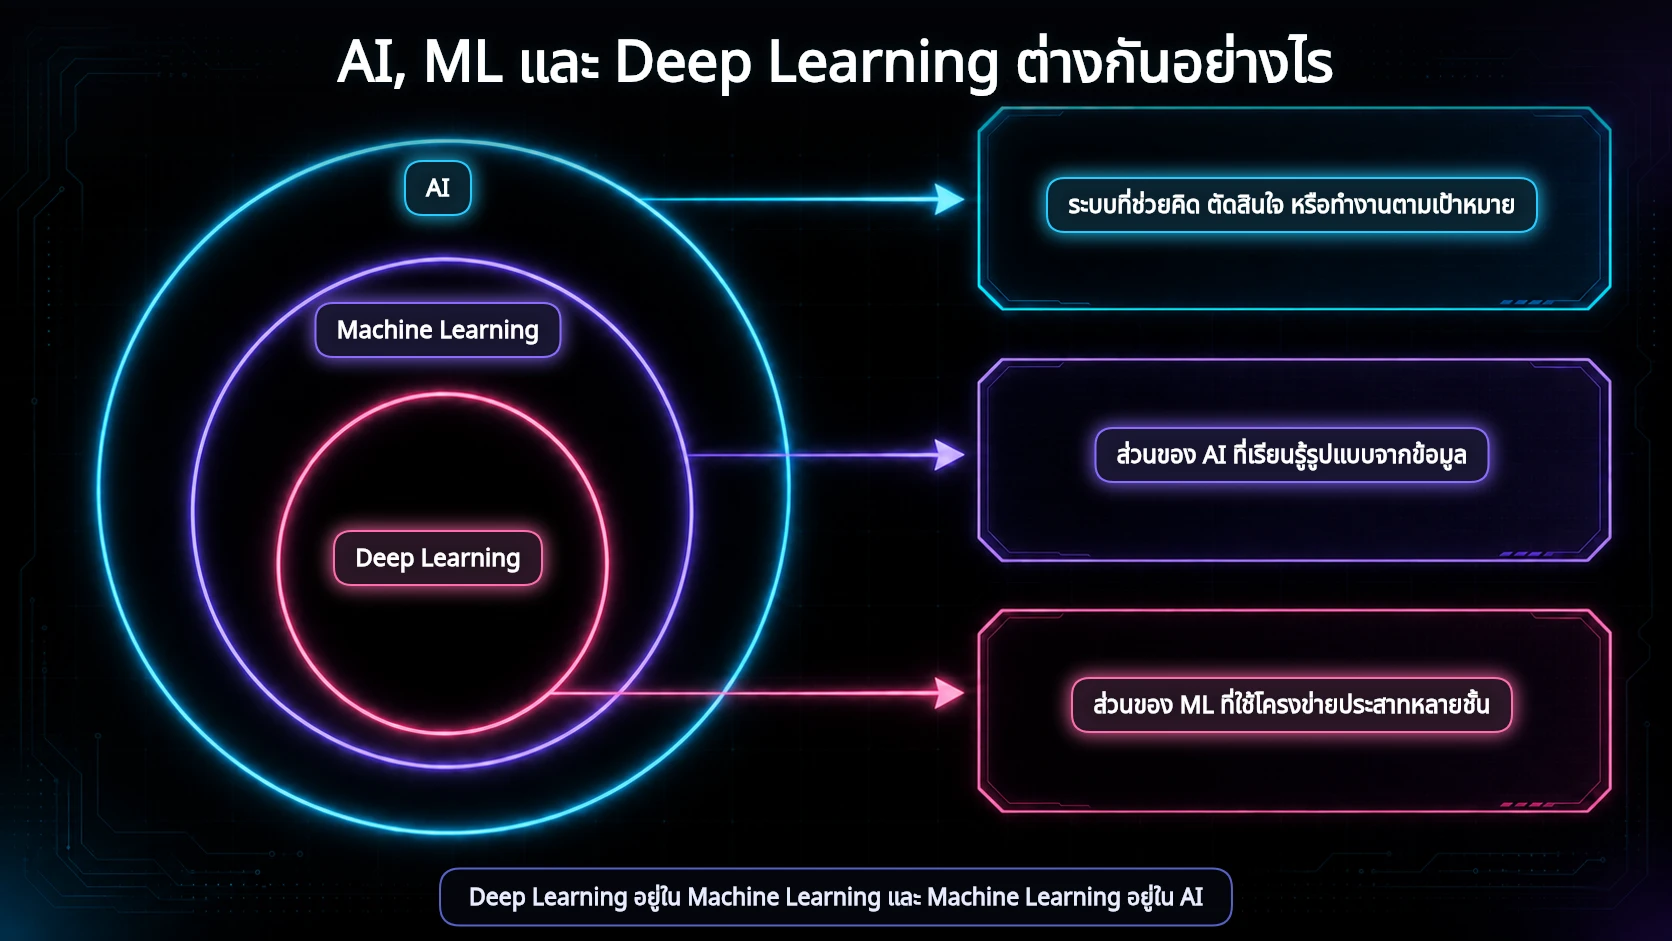
ประโยคสั้นที่สุดที่ควรจำ: AI บอกขอบเขตของระบบ, Machine Learning บอกว่าส่วนหนึ่งเรียนจากข้อมูล, และ Deep Learning บอกว่าใช้โครงข่ายหลายชั้นเรียนตัวแทนของข้อมูล
วงนอก: AI กว้างกว่าโมเดลที่เรียนจากข้อมูล
กรอบนิยามระบบ AI ฉบับปรับปรุงของ OECD เน้นระบบที่อนุมานจากอินพุตเพื่อสร้างผลลัพธ์ เช่น การทำนาย เนื้อหา คำแนะนำ หรือการตัดสินใจ ซึ่งอาจส่งผลต่อสภาพแวดล้อมจริงหรือดิจิทัล นิยามนี้ช่วยให้เราไม่ผูก AI ไว้กับเทคนิคเดียว สิ่งสำคัญคือระบบรับอะไรเข้าไป อนุมานอย่างไร สร้างผลลัพธ์อะไร มีระดับความเป็นอัตโนมัติเท่าใด และสามารถปรับตัวหลังนำไปใช้หรือไม่
AI แบบดั้งเดิมจำนวนมากใช้ความรู้และกฎที่มนุษย์เขียน เช่น ระบบผู้เชี่ยวชาญที่ถามอาการแล้วเดินตามต้นไม้การตัดสินใจ โปรแกรมค้นหาเส้นทางที่ลองหลายทางแล้วเลือกทางที่มีต้นทุนต่ำ หรือโปรแกรมวางแผนที่จัดลำดับงานภายใต้ข้อจำกัด ระบบเหล่านี้อาจแก้ปัญหาที่ต้องใช้การอนุมานได้ โดยไม่จำเป็นต้องมีข้อมูลฝึกหรือกระบวนการปรับน้ำหนักของโมเดล
ในกรณีอีเมล ทีมกฎอาจกำหนดว่าอีเมลจากโดเมนคู่ค้าที่ผ่านการตรวจแล้วให้เข้ากล่องธุรกิจ อีเมลที่แนบไฟล์ชนิดต้องห้ามให้กักไว้ และอีเมลที่มีถ้อยคำเร่งรัดพร้อมลิงก์ไปโดเมนใหม่ให้ส่งตรวจโดยมนุษย์ จุดแข็งคือกฎอ่านได้ ตรวจสอบได้ และบังคับนโยบายที่ห้ามละเมิดได้ตรงไปตรงมา จุดอ่อนคือผู้โจมตีเปลี่ยนคำและรูปแบบได้เร็ว กฎจึงแตกแขนงและดูแลยากเมื่อสถานการณ์ซับซ้อนขึ้น
คำว่า AI จึงไม่ใช่ใบรับรองว่าระบบฉลาด แม่น หรือเหมาะกับงานจริง ระบบที่ติดป้าย AI อาจเป็นเพียงกฎไม่กี่ข้อ หรืออาจเป็นบริการที่มีหลายโมเดลและกระบวนการควบคุมซับซ้อน การประเมินคุณภาพต้องถามต่อถึงข้อมูล กลไก เกณฑ์วัด กลุ่มผู้ใช้ และผลกระทบ ไม่ควรตัดสินจากป้ายผลิตภัณฑ์เพียงอย่างเดียว
เรายังควรแยก AI ออกจาก Automation ให้ระมัดระวัง ระบบที่ย้ายไฟล์ตามเวลาหรือส่งใบแจ้งหนี้ตามตารางอาจเป็นระบบอัตโนมัติ แต่ไม่ได้อนุมานจากสถานการณ์ ส่วนระบบที่ประเมินความเสี่ยงของอีเมลแล้วเลือกการกระทำตามบริบทมีลักษณะของการอนุมานมากกว่า อย่างไรก็ตาม เส้นแบ่งขึ้นกับนิยามและบริบท จึงควรบอกกลไกจริงแทนการทะเลาะว่าป้ายใดถูกเพียงคำเดียว
วงกลาง: Machine Learning เรียนรูปแบบจากข้อมูล
Machine Learning หรือ ML เพิ่มแนวคิดสำคัญเข้ามา นั่นคือแทนที่จะเขียนทุกกฎด้วยมือ เราให้ขั้นตอนวิธีปรับแบบจำลองจากข้อมูล เพื่อให้ผลลัพธ์บนตัวอย่างใหม่ดีขึ้นตามเป้าหมายที่กำหนดไว้ NIST อธิบาย ML ในภาพรวมว่าเป็นการพัฒนาและใช้ระบบคอมพิวเตอร์ที่ปรับตัวและเรียนจากข้อมูล โดยมีเป้าหมายเพื่อปรับปรุงความแม่นยำ แนวคิดนี้ฟังเหมือนเครื่องเรียนเองทั้งหมด แต่ในความจริงมนุษย์ยังเลือกโจทย์ ข้อมูล ป้ายกำกับ Features Metric และเกณฑ์ตัดสินใจ
สำหรับระบบคัดอีเมล ทีมงานอาจรวบรวมอีเมลเก่าหนึ่งแสนฉบับและให้พนักงานระบุว่าแต่ละฉบับเป็นสแปมหรือไม่ จากนั้นแบ่งข้อมูลเป็นชุดฝึก ชุดตรวจสอบ และชุดทดสอบ ชุดฝึกใช้ปรับพารามิเตอร์ ชุดตรวจสอบใช้เลือกแนวทางหรือค่าตั้ง และชุดทดสอบใช้ประมาณว่าระบบจะทำงานกับข้อมูลที่ไม่เคยเห็นได้ดีเพียงใด หากนำข้อมูลทดสอบไปใช้เลือกโมเดลซ้ำ ๆ คะแนนจะดูดีเกินจริง เพราะชุดทดสอบไม่ได้เป็นข้อมูลใหม่สำหรับทีมอีกต่อไป
โมเดล ML แบบคลาสสิก เช่น Logistic Regression, Naive Bayes, Decision Tree, Random Forest หรือ Support Vector Machine ไม่ใช่ Deep Learning โดยอัตโนมัติ ทีมมักต้องแปลงอีเมลเป็นตัวเลขก่อน เช่น จำนวนลิงก์ ความยาวหัวเรื่อง สัดส่วนตัวพิมพ์ใหญ่ อายุโดเมน หรือความถี่ของคำบางกลุ่ม ขั้นตอนนี้เรียกว่า Feature Engineering คือการใช้ความเข้าใจปัญหาช่วยสร้างตัวแปรที่โมเดลใช้ได้
การเรียนใน ML ไม่ได้หมายความว่าโมเดลเข้าใจอีเมลเหมือนมนุษย์ โมเดลกำลังค้นหาความสัมพันธ์เชิงสถิติที่ช่วยลดความผิดพลาดตามฟังก์ชันเป้าหมาย หากอีเมลโฆษณาในอดีตมักมีคำว่า “ฟรี” โมเดลอาจให้น้ำหนักกับคำนั้น แต่ถ้าธุรกิจเริ่มส่งใบเสนอราคาที่มีคำว่า “จัดส่งฟรี” รูปแบบเดิมอาจทำให้โมเดลคัดอีเมลลูกค้าผิด การเรียนรูปแบบจึงไม่เท่ากับการรู้เหตุผลเชิงสาเหตุ
ข้อดีของ ML คือจัดการรูปแบบจำนวนมากที่เขียนเป็นกฎได้ยาก ปรับตามข้อมูลใหม่ได้ และสร้างคะแนนความน่าจะเป็นเพื่อจัดลำดับการตรวจสอบได้ แต่ข้อดีนี้มาพร้อมภาระในการดูแลข้อมูล ตรวจคุณภาพป้ายกำกับ เฝ้าระวังการเปลี่ยนแปลงของข้อมูล และประเมินผลแยกตามกลุ่ม หากข้อมูลฝึกมีอคติหรือสะท้อนพฤติกรรมเก่า โมเดลก็อาจเรียนอคตินั้นอย่างมีประสิทธิภาพ
วงใน: Deep Learning เรียนตัวแทนผ่านหลายชั้น
Deep Learning เป็นส่วนหนึ่งของ Machine Learning ที่ใช้โครงข่ายประสาทเทียมซึ่งมีชั้นการแปลงหลายชั้น คำว่า “ลึก” ไม่ได้หมายถึงคิดลึกเหมือนมนุษย์ แต่หมายถึงข้อมูลผ่านการแปลงต่อเนื่องหลายระดับ แต่ละชั้นคำนวณจากผลของชั้นก่อนหน้าและปรับพารามิเตอร์จากข้อมูล งานทบทวนของ LeCun, Bengio และ Hinton อธิบายจุดเด่นว่าหลายชั้นช่วยเรียนตัวแทนของข้อมูลในหลายระดับของนามธรรม
ในระบบคัดอีเมล โมเดล Deep Learning อาจรับลำดับข้อความโดยตรงแล้วเรียนว่าคำใดสัมพันธ์กันอย่างไร ชั้นต้นอาจตอบสนองต่อรูปแบบคำหรือสัญลักษณ์ ชั้นกลางอาจรวมเป็นวลีและโครงสร้าง ส่วนชั้นสูงอาจสร้างตัวแทนที่ใช้แยกเจตนาหรือบริบท โมเดลไม่ได้ถูกโปรแกรมให้มีช่อง “คำเร่งรัด” หรือ “คำขอข้อมูลลับ” อย่างชัดเจนเสมอไป แต่เรียนตัวแทนที่มีประโยชน์ต่อการจำแนกจากตัวอย่างจำนวนมาก
ความสามารถในการเรียน Representation ทำให้ Deep Learning เด่นในข้อมูลที่ไม่มีโครงสร้างตายตัว เช่น ภาพ เสียง ภาษา และวิดีโอ เพราะมนุษย์ไม่ต้องออกแบบ Features ทุกตัวด้วยมือ อย่างไรก็ตาม คำว่า “ไม่ต้องทำ Feature Engineering” เป็นการพูดเกินจริง ทีมยังต้องเลือกข้อมูล วิธีแบ่งหน่วยข้อความ ความยาวอินพุต สถาปัตยกรรม เป้าหมายการฝึก และวิธีประเมิน อีกทั้งโมเดลสมัยใหม่จำนวนมากเริ่มจากโมเดลที่ฝึกมาก่อนแล้วจึงปรับให้เข้ากับงานเฉพาะ
Deep Learning มักต้องการข้อมูลและการคำนวณมากกว่าโมเดลคลาสสิก มีพารามิเตอร์จำนวนมากและอธิบายเหตุผลของผลลัพธ์ได้ยากกว่า ต้นทุนไม่ได้มีเฉพาะเวลาฝึก แต่รวมถึงเวลาอนุมาน หน่วยความจำ การตรวจสอบรุ่นโมเดล การป้องกันการโจมตี และการติดตามว่าคุณภาพเปลี่ยนเมื่อภาษาของผู้ใช้เปลี่ยนหรือไม่ สำหรับตารางข้อมูลขนาดเล็ก โมเดลง่ายอาจให้ผลเท่ากันหรือดีกว่าโดยดูแลสะดวกกว่า
Neural Network ทุกตัวไม่จำเป็นต้องเรียก Deep Learning โครงข่ายตื้นที่มีชั้นไม่มากยังเป็น Neural Network และเป็น Machine Learning แต่คำว่า Deep Learning มักใช้เมื่อมีลำดับการแปลงหลายชั้นอย่างมีนัยสำคัญ เส้นแบ่งจำนวนชั้นไม่ได้ตายตัวตามกฎหมายสากล สิ่งที่สำคัญกว่าคืออธิบายสถาปัตยกรรมและบทบาทของมันให้ตรงกับการตัดสินใจ
กรณีศึกษา: สามแนวทางคัดอีเมลในระบบเดียวกัน
กลับมาที่สายรุ้งมาร์เก็ต ทีมไม่ได้จำเป็นต้องเลือกแนวทางเดียวตลอดระบบ พวกเขาอาจใช้กฎสำหรับข้อห้ามที่ชัดเจน ใช้โมเดล ML ขนาดเล็กสำหรับประเมินคะแนนความเสี่ยง และใช้ Deep Learning อ่านความหมายของข้อความที่ซับซ้อน จากนั้นให้มนุษย์ตรวจกรณีที่คะแนนอยู่ในช่วงไม่แน่นอน ระบบจริงจึงมักเป็น Hybrid System ซึ่งประกอบด้วยหลายเทคนิคและขั้นตอนปฏิบัติงานร่วมกัน
| แนวทาง | สิ่งที่ทีมกำหนด | สิ่งที่ระบบเรียน | จุดแข็ง | จุดต้องระวัง |
|---|---|---|---|---|
| กฎภายในระบบ AI | เงื่อนไขและการกระทำทีละข้อ | ไม่มีการฝึกโมเดล | อ่านและตรวจสอบง่าย บังคับนโยบายได้ตรง | กฎแตกแขนง ปรับไม่ทันรูปแบบใหม่ |
| Machine Learning แบบคลาสสิก | Features ป้ายกำกับ เป้าหมาย และ Metric | น้ำหนักหรือเส้นแบ่งจากข้อมูล | ใช้ข้อมูลตารางได้ดี ต้นทุนมักต่ำกว่า | พึ่งคุณภาพ Features และข้อมูลฝึก |
| Deep Learning | ข้อมูล สถาปัตยกรรม เป้าหมาย และข้อจำกัด | ทั้งตัวแทนข้อมูลและฟังก์ชันจำแนก | เด่นกับข้อความ ภาพ เสียง และบริบทซับซ้อน | ใช้ทรัพยากรมาก อธิบายและดูแลยากขึ้น |
สมมติว่าบริษัทได้รับอีเมล “กรุณาตรวจใบเสนอราคาที่แนบมา ภายในวันนี้” จากคู่ค้าประจำ กฎที่มองคำว่า “ภายในวันนี้” อาจตีความว่าเร่งรัดและกักอีเมลผิด โมเดล ML อาจพิจารณาอายุโดเมน ประวัติผู้ส่ง ชนิดไฟล์ และคำสำคัญร่วมกันจึงลดความผิดพลาด ส่วนโมเดล Deep Learning อาจเข้าใจบริบทของประโยคได้ดีขึ้น แต่ถ้าไฟล์แนบมีรูปแบบโจมตีใหม่ที่ไม่เคยอยู่ในข้อมูลฝึก โมเดลก็ยังพลาดได้
อีกกรณีหนึ่งคืออีเมลหลอกที่เลียนแบบภาษาของผู้บริหารและมาจากโดเมนคล้ายของจริง โมเดลข้อความอาจให้คะแนนว่าภาษาเป็นธรรมชาติ ขณะที่กฎตรวจความเหมือนของโดเมนพบความผิดปกติ ระบบผสมจึงอาจปลอดภัยกว่าการเชื่อโมเดลเดียว การออกแบบที่ดีไม่ถามว่าเทคนิคใด “ฉลาดที่สุด” แต่ถามว่าความผิดพลาดชนิดใดรับไม่ได้ และควรใช้การควบคุมหลายชั้นอย่างไร
เมื่อผลลัพธ์ของระบบเป็นเพียงการจัดลำดับอีเมลให้พนักงานดู ความผิดพลาดหนึ่งครั้งอาจแก้ได้ง่าย แต่ถ้าระบบลบอีเมลทันทีหรือแจ้งหน่วยรักษาความปลอดภัยโดยอัตโนมัติ ผลกระทบสูงกว่า วิธีเลือกโมเดลและ Threshold จึงต้องสัมพันธ์กับการกระทำปลายทาง ไม่ใช่ดู Accuracy อย่างเดียว ระบบที่แม่น 99% ยังอาจสร้างปัญหาใหญ่หากหนึ่งเปอร์เซ็นต์ที่ผิดคือใบสั่งซื้อสำคัญทั้งหมด
กลไกการเรียนรู้: จากอีเมลตัวอย่างไปสู่ผลทำนาย
เพื่อไม่ให้คำว่า “เรียนรู้” กลายเป็นเวทมนตร์ เราจะเปิดกระบวนการเป็นหกขั้น ขั้นแรก ทีมกำหนดงานให้ชัดว่าต้องการจำแนกสแปม ไม่ใช่ทำนายทุกความเสี่ยงทางไซเบอร์ ขั้นที่สอง รวบรวมข้อมูลที่สอดคล้องกับการใช้งานจริง ขั้นที่สาม สร้างป้ายกำกับพร้อมคู่มือให้คนติดป้ายสม่ำเสมอ ขั้นที่สี่ แบ่งข้อมูลเพื่อฝึกและประเมิน ขั้นที่ห้า ปรับโมเดลเพื่อลดความผิดพลาดตามเป้าหมาย ขั้นที่หก นำคะแนนไปประกอบกฎและการตัดสินใจของมนุษย์
ระบุให้ชัดว่าสแปมหมายถึงอะไร อีเมลขายสินค้าที่ผู้รับเคยยินยอมถือเป็นสแปมหรือไม่ และอีเมลต้องสงสัยควรถูกกัก ลบ หรือส่งให้คนตรวจ
รวบรวมอีเมลจากช่วงเวลาและหน่วยงานที่เป็นตัวแทนการใช้งานจริง พร้อมปกป้องข้อมูลส่วนบุคคลและความลับทางธุรกิจ
โมเดลคลาสสิกใช้ Features ที่ออกแบบไว้ ส่วนโมเดล Deep Learning เรียนตัวแทนข้อความผ่านหลายชั้น แต่ทั้งสองแบบยังต้องมีอินพุตและขั้นตอนเตรียมข้อมูลที่ตรวจสอบได้
ขั้นตอนวิธีเปรียบเทียบผลทำนายกับป้ายกำกับ คำนวณความสูญเสีย และปรับพารามิเตอร์เพื่อให้ความผิดพลาดบนชุดฝึกลดลง
วัด Precision, Recall และผลกระทบของ False Positive กับ False Negative ไม่ใช้คะแนนเดียวแทนทุกคำถาม
ติดตามรูปแบบอีเมลใหม่ อัตราการร้องเรียน ความผิดพลาดตามหน่วยงาน และกำหนดเงื่อนไขย้อนกลับไปใช้กฎหรือให้มนุษย์ตรวจ
คำว่า Training คือช่วงที่โมเดลปรับพารามิเตอร์จากตัวอย่าง ส่วน Inference คือช่วงที่โมเดลที่ฝึกแล้วรับอีเมลใหม่และให้คะแนน สองช่วงนี้มีข้อมูล ต้นทุน และความเสี่ยงต่างกัน ในการฝึก ทีมต้องป้องกันข้อมูลรั่วจากชุดทดสอบ ในการอนุมาน ทีมต้องควบคุมเวลาในการตอบ ความเป็นส่วนตัว และการเปลี่ยนแปลงของอินพุต หากสับสนสองช่วงนี้ เราอาจคิดว่าระบบ “เรียนสดจากทุกอีเมล” ทั้งที่หลายระบบไม่ปรับโมเดลเลยหลังติดตั้งจนกว่าจะฝึกใหม่เป็นรอบ
โมเดลอาจส่งคะแนน 0.82 ว่าอีเมลเป็นสแปม แต่คะแนนไม่ใช่ข้อเท็จจริง ทีมต้องเลือก Threshold เช่น ถ้าสูงกว่า 0.95 จึงกักอัตโนมัติ ถ้าอยู่ระหว่าง 0.60–0.95 ให้พนักงานตรวจ และถ้าต่ำกว่า 0.60 ให้ส่งเข้ากล่องปกติ การเปลี่ยน Threshold ไม่ได้ฝึกโมเดลใหม่ แต่เปลี่ยนสมดุลระหว่างการจับสแปมให้ได้มากกับการไม่กักอีเมลจริงผิด
หากเป้าหมายของบริษัทคือไม่พลาดใบสั่งซื้อ False Positive มีต้นทุนสูง เพราะอีเมลจริงถูกคัดเป็นสแปม หากเป้าหมายคือกันการโจมตี False Negative มีต้นทุนสูง เพราะอีเมลอันตรายหลุดเข้ากล่องปกติ ไม่มี Threshold เดียวที่ดีที่สุดโดยไม่รู้บริบท ผู้ดูแลต้องแปลง Metric ทางเทคนิคกลับเป็นผลกระทบต่อคนและกระบวนการธุรกิจ
เมื่อระบบคัดผิด: สาเหตุ สัญญาณ และวิธีรับมือ
Failure Case แรกคือข้อมูลฝึกไม่เป็นตัวแทน สมมติข้อมูลส่วนใหญ่มาจากฝ่ายบัญชี โมเดลอาจคุ้นกับคำว่าใบแจ้งหนี้และเลขบัญชี แต่ทำงานไม่ดีกับอีเมลของฝ่ายออกแบบที่มีลิงก์แชร์ไฟล์จำนวนมาก สัญญาณคือผลรวมดูดี แต่บางหน่วยงานร้องเรียนสูง วิธีรับมือคือประเมินแยกตามกลุ่มงาน ช่วงเวลา ภาษา และชนิดผู้ส่ง ไม่อาศัยค่าเฉลี่ยเดียว
กรณีที่สองคือป้ายกำกับไม่สม่ำเสมอ พนักงานคนหนึ่งถือจดหมายข่าวที่สมัครไว้เป็นสแปม แต่อีกคนถือว่าเป็นอีเมลปกติ โมเดลจึงได้รับคำตอบที่ขัดกันและเรียนเส้นแบ่งไม่ชัด สัญญาณคือผู้ติดป้ายเห็นต่างกันบ่อยหรือโมเดลสับสนกับตัวอย่างชนิดเดิม วิธีรับมือคือเขียนคู่มือป้ายกำกับ ยกตัวอย่างขอบเขต และให้ผู้เชี่ยวชาญทบทวนกรณีที่คนไม่เห็นตรงกัน
กรณีที่สามคือ Data Drift รูปแบบอีเมลหลังใช้งานเปลี่ยนจากข้อมูลฝึก เช่น ผู้โจมตีเปลี่ยนภาษา ใช้รูปภาพแทนข้อความ หรือส่งจากบริการใหม่ โมเดลเดิมอาจมั่นใจผิด สัญญาณคือสัดส่วนคะแนนเปลี่ยน อัตราการแก้หมวดโดยมนุษย์เพิ่ม หรือประเภทข้อผิดพลาดใหม่เกิดขึ้น วิธีรับมือคือเฝ้าระวังข้อมูลจริง เก็บตัวอย่างที่ได้รับอนุญาต ตรวจซ้ำตามรอบ และมีแผนย้อนกลับเมื่อคุณภาพต่ำกว่าเกณฑ์
กรณีที่สี่คือ Shortcut Learning โมเดลเรียนทางลัดที่สัมพันธ์กับป้ายในข้อมูลเก่าแต่ไม่ใช่เหตุผลของงาน เช่น อีเมลสแปมในชุดฝึกส่วนใหญ่ถูกเก็บวันหยุด โมเดลจึงใช้อดีตเวลาเป็นสัญญาณมากเกินไป เมื่อธุรกิจเริ่มรับคำสั่งซื้อช่วงวันหยุด ระบบก็คัดผิด การดูเฉพาะคะแนนทดสอบแบบสุ่มอาจไม่เห็นปัญหา ควรทดสอบข้ามช่วงเวลาและสร้างชุดท้าทายที่ควบคุมสัญญาณลวง
กรณีที่ห้าคือ Automation Bias พนักงานเชื่อผลระบบมากเกินไป เมื่อป้าย “ปลอดภัย” ปรากฏ คนอาจกดลิงก์โดยไม่ตรวจ แม้ระบบไม่เคยรับประกันความปลอดภัยทั้งหมด วิธีรับมือคือออกแบบข้อความให้สื่อระดับความไม่แน่นอน ฝึกผู้ใช้ให้รู้ขอบเขต และรักษาช่องทางรายงานความผิดพลาด ระบบ AI ที่ดีไม่ได้แทนความรับผิดชอบขององค์กร แต่ช่วยจัดลำดับความสนใจภายใต้การควบคุมที่เหมาะสม
กรณีที่หกคือการโจมตีโดยตั้งใจ ผู้ส่งอาจเปลี่ยนตัวอักษร แทรกข้อความซ่อน หรือเลียนแบบรูปแบบที่โมเดลถือว่าปลอดภัย โมเดล Deep Learning ก็ไม่รอดโดยอัตโนมัติ เพราะความซับซ้อนอาจสร้างพื้นที่โจมตีใหม่ การป้องกันควรใช้หลายชั้น ได้แก่ การตรวจโดเมน การสแกนไฟล์ การจำกัดสิทธิ์ การกักกรณีไม่แน่นอน และการทดสอบระบบกับตัวอย่างโจมตีที่ได้รับอนุญาต
เมื่อเกิดข้อผิดพลาด ทีมต้องตอบได้ว่าใครเห็นแจ้งเตือน ใครหยุดระบบ ใครตรวจตัวอย่าง ใครอนุมัติรุ่นใหม่ และข้อมูลใดต้องเก็บเพื่อสืบสวน หากไม่มี Runbook แม้โมเดลดี ทีมก็อาจตอบสนองช้า มาตรฐานการเรียนรู้เรื่อง AI จึงต้องพาผู้เรียนมองเกินตัวโมเดลไปถึงคน กระบวนการ และการกำกับดูแลด้วย
จุดที่แผนภาพวงซ้อนอธิบายไม่หมด
แผนภาพสามวงบอกอนุกรมวิธาน แต่ไม่บอกสถาปัตยกรรมระบบ มันไม่แสดงว่าข้อมูลมาจากไหน กฎทำงานก่อนหรือหลังโมเดล ผลลัพธ์ถูกส่งให้ใคร หรือมนุษย์แทรกอยู่ตรงจุดใด ระบบคัดอีเมลจริงอาจมี Deep Learning อ่านข้อความ มี ML แบบคลาสสิกประเมินโดเมน มีกฎบังคับนโยบาย และมีพนักงานตรวจกรณีเสี่ยง ทั้งหมดทำงานเป็นสายเดียวกัน แต่ในวงซ้อนเราเห็นเพียงความสัมพันธ์ของคำศัพท์
วงซ้อนก็ไม่บอกคุณภาพ ระบบ Deep Learning ไม่จำเป็นต้องแม่นกว่า ML แบบคลาสสิก และ ML ไม่จำเป็นต้องดีกว่ากฎในทุกงาน หากโจทย์มีเงื่อนไขตายตัว ข้อมูลน้อย และต้องอธิบายได้ทันที กฎอาจเหมาะที่สุด หากมีตารางข้อมูลสะอาดขนาดกลาง โมเดลคลาสสิกอาจชนะทั้งเวลา ต้นทุน และความง่ายในการดูแล หากข้อมูลเป็นภาษา ภาพ หรือเสียงจำนวนมาก Deep Learning จึงอาจให้ประโยชน์ที่คุ้มกับต้นทุน
คำว่า Generative AI ก็อยู่คนละแกนกับ Deep Learning คำว่า Generative อธิบายลักษณะผลลัพธ์หรือการสร้างตัวอย่างใหม่ ส่วน Deep Learning อธิบายตระกูลวิธี ระบบสร้างข้อความสมัยใหม่จำนวนมากใช้ Deep Learning จึงอยู่ในทั้งสามวง แต่แนวคิด Generative Model มีประวัติและขอบเขตกว้างกว่าสถาปัตยกรรมสมัยใหม่แบบเดียว การวาดวงเพิ่มโดยไม่กำหนดแกนอาจทำให้ผู้เรียนคิดว่าทุกคำเป็นระดับเดียวกัน
คำศัพท์ยังเปลี่ยนตามชุมชน งานวิจัย มาตรฐาน และกฎหมาย เมื่อใช้ในรายงานหรือสัญญา ควรระบุนิยามที่อ้าง ไม่ควรยืนยันว่าเส้นแบ่งเดียวใช้ได้ทุกบริบท หากวัตถุประสงค์คือสื่อสารกับผู้เริ่มต้น วงซ้อนเหมาะมาก แต่ถ้าวัตถุประสงค์คือประเมินความเสี่ยง ต้องเพิ่มแผนผังข้อมูล การตัดสินใจ และผู้รับผิดชอบ
เกณฑ์เลือกวิธีและเลือกคำให้ตรงกับการตัดสินใจ
เริ่มจากคำถามว่าเราต้องตัดสินใจอะไร หากกำลังอธิบายภาพรวมของผลิตภัณฑ์ คำว่า AI อาจพอ หากกำลังวางแผนข้อมูลและการประเมิน ควรระบุว่าใช้ Machine Learning แบบใด หากกำลังคำนวณทรัพยากร วิเคราะห์ Latency หรือประเมินความสามารถกับภาพและภาษา ต้องลงรายละเอียดถึง Deep Learning และสถาปัตยกรรมที่เกี่ยวข้อง ยิ่งความเสี่ยงสูง ความละเอียดของคำยิ่งต้องสูงตาม
ใช้กฎเมื่อใด
เงื่อนไขชัด เปลี่ยนไม่บ่อย ต้องตรวจสอบเหตุผลได้ และความผิดพลาดบางชนิดห้ามเกิด ระบบภาษีตามสูตรหรือข้อห้ามด้านนโยบายมักเริ่มจากกฎได้ดี
ใช้ ML เมื่อใด
มีตัวอย่างที่เชื่อถือได้ รูปแบบซับซ้อนกว่ากฎ และสามารถวัดความสำเร็จบนข้อมูลใหม่ได้ ต้องมีเจ้าของข้อมูลและแผนติดตามคุณภาพ
ใช้ Deep Learning เมื่อใด
ข้อมูลเป็นข้อความ ภาพ เสียง หรือรูปแบบซับซ้อน มีข้อมูลและทรัพยากรพอ และประโยชน์จากการเรียน Representation คุ้มกับต้นทุนการอธิบายและดูแล
คำถามห้าข้อที่ควรถามทุกครั้งเมื่อได้ยินว่า “เราใช้ AI” คือ หนึ่ง ระบบรับอินพุตอะไรและสร้างผลลัพธ์อะไร สอง ส่วนใดมาจากกฎและส่วนใดเรียนจากข้อมูล สาม ข้อมูลฝึกเป็นตัวแทนผู้ใช้จริงหรือไม่ สี่ ความผิดพลาดชนิดใดมีต้นทุนสูงและวัดอย่างไร ห้า ใครตรวจ หยุด หรือแก้ระบบเมื่อผลลัพธ์ผิด หากผู้เสนอระบบตอบไม่ได้ คำว่า AI ยังไม่ให้ข้อมูลพอสำหรับอนุมัติ
สำหรับสายรุ้งมาร์เก็ต ทีมอาจเริ่มด้วยกฎและโมเดลคลาสสิกก่อน เพราะมีข้อมูลไม่มากและต้องการอธิบายเหตุผลให้พนักงานรักษาความปลอดภัยฟัง หากปริมาณอีเมลหลายภาษาเพิ่มและโมเดลเดิมไม่เข้าใจบริบท จึงทดลอง Deep Learning ใน Sandbox เทียบกับ Baseline เดิม การเริ่มจากวิธีที่ง่ายที่สุดซึ่งตอบโจทย์ได้ช่วยให้เห็นคุณค่าของความซับซ้อนที่เพิ่มขึ้นอย่างเป็นหลักฐาน
การเปรียบเทียบต้องใช้ข้อมูลทดสอบเดียวกันและ Metric ที่สัมพันธ์กับผลกระทบ นอกจาก Precision และ Recall ควรวัดเวลาตอบ ต้นทุนต่ออีเมล อัตราที่มนุษย์ต้องตรวจ ความเสถียรข้ามภาษา และความสามารถในการอธิบายเหตุผล หาก Deep Learning เพิ่มความแม่นเพียงเล็กน้อยแต่ทำให้ต้นทุนและเวลาตอบเพิ่มมาก อาจไม่ใช่ตัวเลือกที่เหมาะที่สุด
Checklist ก่อนอนุมัติระบบ
- นิยามปัญหาและการกระทำปลายทางชัด ไม่ใช้คำว่า AI แทนความต้องการ
- มี Baseline แบบกฎหรือวิธีง่ายสำหรับเปรียบเทียบ
- ระบุแหล่งข้อมูล สิทธิ์ใช้ คุณภาพ และข้อจำกัดของป้ายกำกับ
- แยกข้อมูลฝึก ตรวจสอบ และทดสอบโดยป้องกันข้อมูลรั่ว
- เลือก Metric ตามต้นทุนของ False Positive และ False Negative
- ทดสอบแยกตามภาษา หน่วยงาน เวลา และกลุ่มผู้ใช้ที่สำคัญ
- กำหนด Threshold และช่วงที่ต้องให้มนุษย์ตรวจ
- มีระบบบันทึก เฝ้าระวัง Rollback และเจ้าของการตัดสินใจ
- สื่อสารข้อจำกัดให้ผู้ใช้เข้าใจ ไม่สร้างความเชื่อว่า AI ถูกเสมอ
แบบฝึกปฏิบัติ: ตรวจวิธีทำงานก่อนจัดประเภท
ส่วนที่ 1 — จัดหมวดพร้อมเหตุผล
- โปรแกรมคำนวณภาษีตามสูตรที่ประกาศและไม่มีขั้นตอนฝึกจากข้อมูล
- Random Forest ทำนายว่าเครื่องจักรจะเสียในเจ็ดวันจากค่าการสั่นและอุณหภูมิ
- Convolutional Neural Network ตรวจรอยร้าวจากภาพสะพาน
- ระบบแนะนำวิดีโอใช้ Neural Network จัดอันดับ แล้วใช้กฎอายุกรองเนื้อหา
- โปรแกรมค้นหาเส้นทางที่ใช้ขั้นตอนวิธี A* และแผนที่ที่กำหนดไว้
วิธีทำ: อย่าตอบด้วยป้ายเดียว ให้เขียนว่าเป็น AI หรือไม่ ใช้ ML หรือไม่ ใช้ Deep Learning หรือไม่ แล้วระบุหลักฐานจากกลไก เช่น “มีการเรียนพารามิเตอร์จากข้อมูล” หรือ “ใช้โครงข่ายหลายชั้น”
เปิดดูแนวคำตอบ
ข้อ 1 เป็นระบบอัตโนมัติแบบกฎ และอาจถูกจัดเป็น AI แบบใช้ความรู้ตามขอบเขตนิยาม แต่ไม่ใช่ ML ข้อ 2 เป็น ML และ AI แต่ไม่ใช่ DL ข้อ 3 เป็น DL จึงเป็นทั้ง ML และ AI ข้อ 4 เป็นระบบ AI แบบผสม มี DL อยู่ในส่วนจัดอันดับและมีกฎในส่วนควบคุม ข้อ 5 อยู่ใน AI สาย Search/Planning โดยไม่จำเป็นต้องเป็น ML
ส่วนที่ 2 — ออกแบบระบบคัดอีเมลฉบับแรก
สมมติคุณมีอีเมลติดป้ายเพียงสองพันฉบับ ทีมมีเวลาแปดสัปดาห์ และทุกอีเมลที่ระบบกักต้องมีเหตุผลให้พนักงานตรวจได้ ให้เขียนแผนหนึ่งหน้าโดยตอบว่า จะเริ่มจากกฎหรือโมเดลใด จะสร้าง Baseline อย่างไร จะวัด False Positive และ False Negative อย่างไร และเมื่อใดจึงยอมให้ระบบกักอัตโนมัติ
เกณฑ์สำเร็จ: แผนที่ดีไม่จำเป็นต้องเลือกเทคโนโลยีทันสมัยที่สุด แต่ต้องเชื่อมข้อจำกัดของข้อมูลกับวิธีที่เลือก มีชุดทดสอบที่กันไว้ กำหนด Threshold ตามต้นทุน และมี Human Review สำหรับกรณีไม่แน่นอน หากแผนระบุเพียง “ใช้ AI วิเคราะห์” โดยไม่บอกกลไก ถือว่ายังไม่ผ่าน
ส่วนที่ 3 — วิเคราะห์ความผิดพลาด
หลังใช้งานสามเดือน อัตรากักอีเมลของฝ่ายจัดซื้อเพิ่มจาก 3% เป็น 18% แต่ฝ่ายอื่นไม่เปลี่ยน ให้เสนอสมมติฐานอย่างน้อยสามข้อและลำดับตรวจสอบ ตัวอย่างสมมติฐานคือคู่ค้าเปลี่ยนระบบส่งเอกสาร รูปแบบข้อมูลของฝ่ายจัดซื้อเปลี่ยน หรือโมเดลใช้ Feature ที่เป็นทางลัด หลักคิดคืออย่ารีบฝึกโมเดลใหม่ก่อนตรวจว่าปัญหาเกิดที่ข้อมูล ป้ายกำกับ การเชื่อมต่อ หรือกฎปลายทาง
วิธีกู้คืนเมื่อไม่ผ่าน: ลดการทำงานอัตโนมัติ เปลี่ยนช่วงคะแนนเสี่ยงให้มนุษย์ตรวจ เปรียบเทียบกับรุ่นก่อน ตรวจตัวอย่างจริงที่ได้รับอนุญาต และบันทึกสาเหตุ เมื่อแก้แล้วต้องทดสอบย้อนหลังและทดสอบกับข้อมูลช่วงใหม่ก่อนเปิดอัตโนมัติอีกครั้ง
แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่อธิบายแนวคิดหรือการตัดสินใจได้ดีที่สุด แล้วกด “ตรวจคำตอบ” ระบบจะแสดงคะแนนรวม เฉลย และเหตุผลรายข้อ
สรุปบทเรียน: มองให้เห็นภาพรวม แล้วเจาะลึกวิธีทำงาน
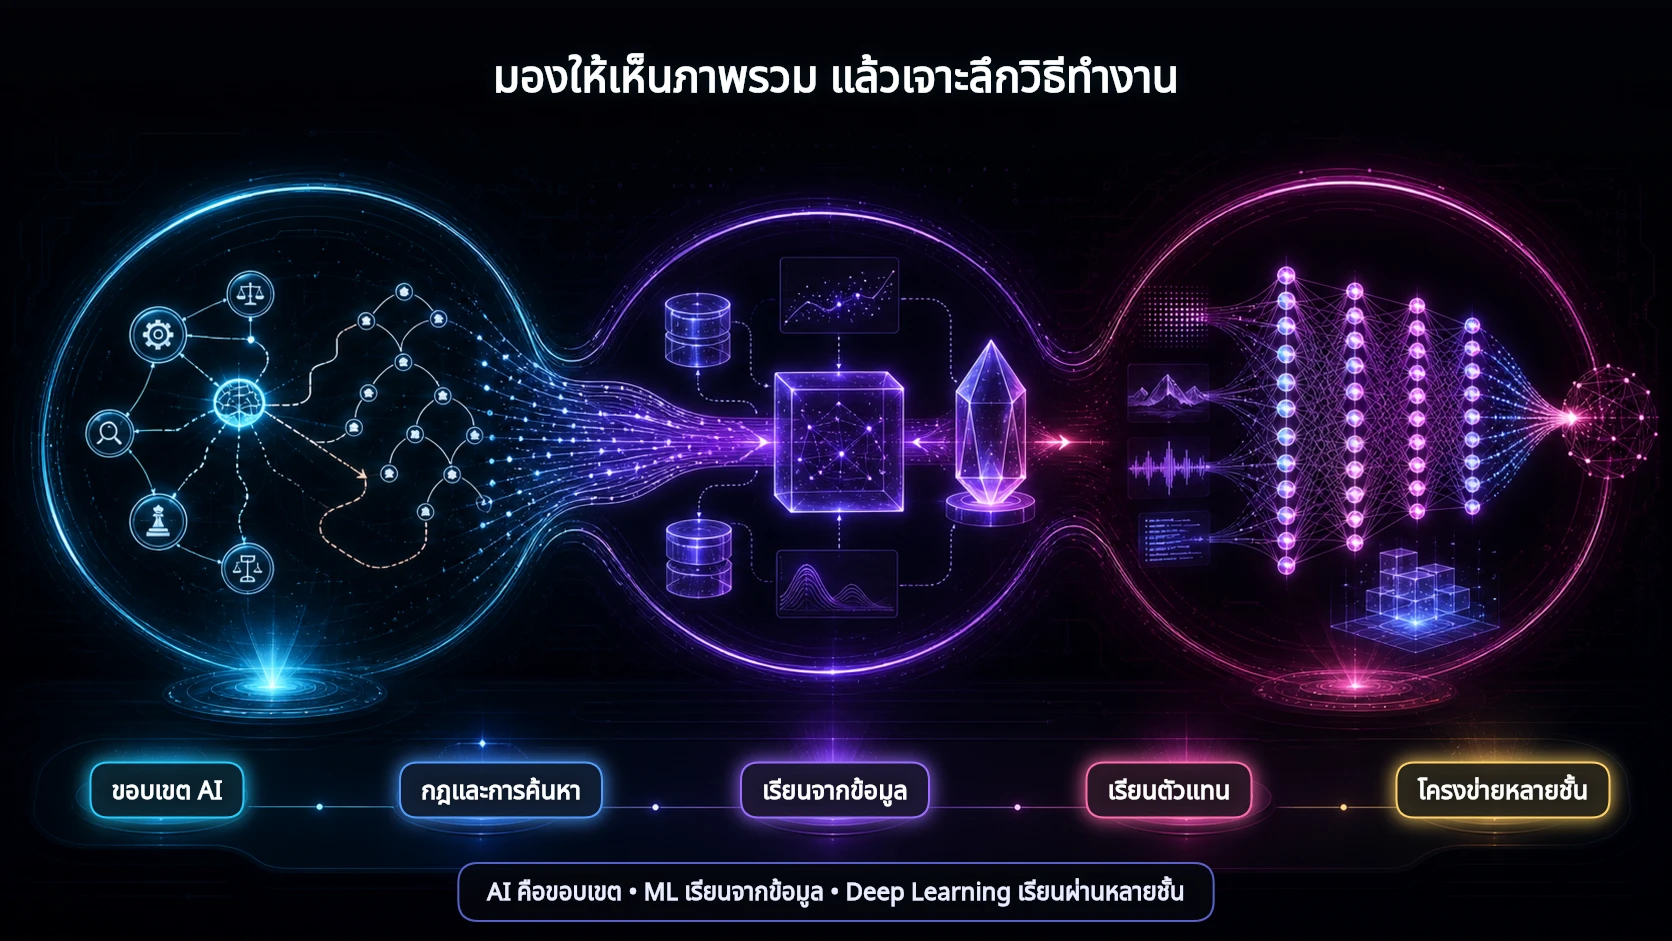
ถ้าจำได้เพียงภาพเดียว ให้จำวงสามวง: Deep Learning อยู่ใน Machine Learning และ Machine Learning อยู่ใน AI ถ้าจำได้สองเรื่อง ให้เพิ่มว่าแผนภาพนี้บอกความสัมพันธ์ของคำ ไม่ได้บอกคุณภาพหรือสถาปัตยกรรมระบบ ถ้าต้องตัดสินใจจริง ให้ตรวจดูข้อมูล โมเดล กฎ Threshold มนุษย์ และผลกระทบทุกครั้ง
กรณีสายรุ้งมาร์เก็ตสอนเราว่าเทคนิคหลายชนิดอาจร่วมกันสร้างระบบเดียว กฎเหมาะกับข้อห้ามที่ชัด ML ช่วยเรียนรูปแบบจากข้อมูล และ Deep Learning ช่วยเรียนตัวแทนของภาษาอันซับซ้อน ไม่มีวิธีใดชนะอัตโนมัติ วิธีที่เหมาะคือวิธีที่ผ่านการเปรียบเทียบกับ Baseline บนข้อมูลจริง มีต้นทุนสมเหตุผล และมีแผนรับมือเมื่อผิด
บทถัดไปจะเปลี่ยนแกนคำถามจาก “ระบบใช้วิธีอะไร” ไปเป็น “ระบบมีขอบเขตความสามารถกว้างเพียงใด” ผ่านความต่างระหว่าง Narrow AI และ General AI สองแกนนี้ต้องแยกกันให้ชัด เพราะระบบที่ใช้ Deep Learning อาจยังเก่งเพียงงานแคบ ๆ และไม่ได้มีความสามารถทั่วไปเหมือนมนุษย์
ภารกิจหลังเรียน: ครั้งต่อไปที่เห็นคำว่า “ใช้ AI” ให้ถามต่ออย่างน้อยสามข้อ—เรียนจากข้อมูลหรือไม่ ใช้โมเดลชนิดใด และเมื่อผลผิดใครเป็นคนตรวจ การถามให้ลึกกว่าป้ายคือทักษะสำคัญกว่าการจำชื่อเทคโนโลยี
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงหลัก
- OECD — Explanatory memorandum on the updated definition of an AI system ใช้รองรับกรอบระบบที่อนุมานจากอินพุตเพื่อสร้างผลลัพธ์และระดับความเป็นอัตโนมัติ
- NIST CSRC — Machine Learning Glossary ใช้รองรับแนวคิดการปรับตัวและเรียนจากข้อมูลเพื่อปรับปรุงผลการทำงาน
- NIST — The Language of Trustworthy AI: An In-Depth Glossary of Terms ใช้เป็นกรอบคำศัพท์ด้านความน่าเชื่อถือและการสื่อสารร่วมกัน
- LeCun, Bengio & Hinton — Deep learning, Nature 2015 ใช้รองรับการอธิบายการเรียน Representation หลายระดับและงานภาพ เสียง และภาษา
- Google for Developers — Accuracy, precision, and recall ใช้ประกอบคำอธิบาย Metric สำหรับงานจำแนก
- NIST AI Risk Management Framework ใช้ประกอบหลักคิดการวัด เฝ้าระวัง และจัดการความเสี่ยงตลอดวงจรระบบ
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 3 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 09 · PATH 01 · เนื้อหานี้มีวัตถุประสงค์เพื่อการศึกษา
