ความรู้ก่อนเรียน: ควรรู้จักองค์ประกอบพื้นฐานของคอมพิวเตอร์จากหัวข้อ 30 เช่น CPU, RAM, Storage และอุปกรณ์รับ–ส่งข้อมูล
PATH 01 · พื้นฐานดิจิทัล คอมพิวเตอร์ และภาพรวม AI
CPU ทำงานอย่างไร: วงจร Fetch–Decode–Execute ที่ทำให้โปรแกรมเคลื่อน
คำตอบสั้น: โปรแกรมไม่ได้ “วิ่ง” ด้วยตัวเอง แต่ถูกแปลงเป็นคำสั่งเครื่องที่ CPU ดึงมา แปลความหมาย ลงมือทำ และบันทึกผลซ้ำเป็นวงจร ระหว่างทางประสิทธิภาพขึ้นกับการรอข้อมูล การจัดลำดับงาน การคาดเดาทางเลือก และข้อจำกัดด้านพลังงาน ไม่ใช่ Clock เพียงตัวเลขเดียว
จำภาพนี้ไว้: CPU คือครัวที่รับบัตรสั่งอาหารทีละชุด ส่วน Register คือพื้นที่หน้าเตา Cache คือชั้นวัตถุดิบใกล้มือ RAM คือคลังด้านหลัง และ Pipeline คือการให้หลายเมนูอยู่คนละสถานีในเวลาเดียวกัน
อ่านจบบทนี้ คุณจะทำอะไรได้
- เล่าเส้นทางของคำสั่งหนึ่งคำสั่งตั้งแต่ Fetch ถึง Write-back ได้ด้วยภาษาของตนเอง
- แยกบทบาทของ Control Unit, ALU, Register, Cache และ RAM ได้โดยไม่ปะปนกัน
- อธิบายว่า Pipeline และ Branch Prediction ช่วยเพิ่มงานที่เสร็จต่อเวลาได้อย่างไร
- อ่านอาการคอขวดเบื้องต้นและเลือกหลักฐานที่จะวัดก่อนสรุปว่า “CPU ช้า” ได้
- ใช้ Worksheet ติดตาม Input → Process → Output → Feedback ของงานจริงหนึ่งงานได้
MENTAL MODEL
โปรแกรมกลายเป็นงานได้อย่างไร
เมื่อเรากดปุ่มในแอป สิ่งที่เกิดขึ้นไม่ใช่ CPU “เข้าใจ” เจตนาของเราโดยตรง ซอฟต์แวร์และระบบปฏิบัติการต้องจัดเตรียมข้อมูลและคำสั่งในรูปแบบที่เครื่องรองรับ จากนั้น CPU จึงอ่านคำสั่งเหล่านั้นและเปลี่ยนสถานะของระบบทีละขั้น ผลที่เราเห็น—ตัวเลขบนหน้าจอ ไฟล์ที่บันทึก หรือข้อความที่ส่งออก—จึงเป็นปลายทางของการเปลี่ยนสถานะจำนวนมาก
ภาพ “วงจร” สำคัญกว่าการจำชื่อชิ้นส่วน เพราะผลของคำสั่งหนึ่งอาจกลายเป็นข้อมูลของคำสั่งถัดไป หากข้อมูลยังมาไม่ถึงหรือเส้นทางที่คาดไว้ผิด ขั้นอื่นอาจต้องรอหรือเริ่มใหม่ การมอง CPU เป็นสายธารของงานจึงช่วยอธิบายทั้งความเร็วและความล่าช้าได้ดีกว่ามองเพียง GHz
FROM APP TO INSTRUCTION
จากการกดปุ่มในแอป ถึงคำสั่งที่ CPU มองเห็น
ลองนึกถึงการกดปุ่ม “คำนวณยอดรวม” ในโปรแกรมตารางข้อมูล เราเห็นเพียงปุ่มหนึ่งปุ่มกับตัวเลขที่ปรากฏขึ้น แต่ก่อน CPU จะเริ่มบวกค่า ซอฟต์แวร์หลายชั้นต้องทำงานร่วมกัน แอปแปลการกดปุ่มเป็นเหตุการณ์ ฟังก์ชันที่เกี่ยวข้องถูกเรียก Runtime หรือ Compiler เตรียมลำดับคำสั่ง ระบบปฏิบัติการจัดเวลาให้ Thread ได้ใช้ Core และหน่วยจัดการหน่วยความจำเชื่อมที่อยู่ซึ่งโปรแกรมมองเห็นกับข้อมูลจริงใน RAM จากนั้น CPU จึงรับคำสั่งเครื่องตามข้อตกลงของ ISA
ลำดับนี้ช่วยแก้ความเข้าใจผิดสำคัญ: CPU ไม่ได้อ่านความหมายของคำว่า “รวมยอด” และไม่ได้อ่าน Python, JavaScript หรือภาษาไทยโดยตรง สิ่งที่มันเห็นคือรูปแบบบิตซึ่งระบุการกระทำและตำแหน่งข้อมูล เช่น โหลดค่า เปรียบเทียบ บวก เก็บผล หรือเปลี่ยนตำแหน่งคำสั่งถัดไป คำสั่งระดับภาษาที่มนุษย์เขียนหนึ่งบรรทัดอาจกลายเป็นคำสั่งเครื่องหลายคำสั่ง และ Runtime อาจสร้างคำสั่งต่างกันตามแพลตฟอร์ม สถานะโปรแกรม หรือการปรับแต่งของ Compiler
ชั้นซอฟต์แวร์ไม่ได้เป็นเพียงทางผ่าน
แต่ละชั้นมีผลต่อสิ่งที่ CPU ต้องทำ Compiler อาจเรียงคำสั่งใหม่โดยยังรักษาความหมายเดิม Runtime อาจเลือกเส้นทางที่เหมาะกับชนิดข้อมูล ระบบปฏิบัติการอาจสลับ Thread เมื่อมีงานอื่นต้องใช้เวลา และระบบหน่วยความจำอาจต้องดึงหน้าข้อมูลที่ยังไม่อยู่ใน RAM เข้ามาก่อน จึงเป็นไปได้ที่ CPU จะพร้อมคำนวณ แต่โปรแกรมยังช้าเพราะกำลังรอข้อมูลหรือรอทรัพยากรจากชั้นอื่น
ภาพที่ควรเก็บไว้คือ “สัญญาหลายชั้น” แอปบอกว่าต้องการผลอะไร ภาษาและ Runtime แปลงความตั้งใจเป็นงานที่ละเอียดขึ้น ระบบปฏิบัติการจัดทรัพยากร ส่วน ISA กำหนดพฤติกรรมที่ซอฟต์แวร์คาดหวังจากหน่วยประมวลผล Microarchitecture ภายใน CPU มีอิสระเลือกว่าจะทำตามสัญญานั้นอย่างไร เช่น ใช้ Pipeline ลึกเพียงใด คาดเดา Branch แบบไหน หรือจัด Cache กี่ระดับ ตราบใดที่ผลลัพธ์ที่สังเกตได้ยังตรงกับกติกาของ ISA
| ชั้น | รับอะไรเข้า | ส่งอะไรต่อ | จุดที่อาจทำให้รอ |
|---|---|---|---|
| แอปและ Runtime | การกระทำของผู้ใช้และข้อมูล | ฟังก์ชัน งานย่อย และลำดับการคำนวณ | การแปลงข้อมูล การเก็บกวาดหน่วยความจำ หรือโค้ดที่ทำงานซ้ำเกินจำเป็น |
| ระบบปฏิบัติการ | Process, Thread และคำขอใช้ทรัพยากร | เวลาบน Core และมุมมองหน่วยความจำ | การสลับบริบท การรอ Lock การรอ I/O และ Page Fault |
| ISA | คำสั่งเครื่องและสถานะที่มองเห็นได้ | พฤติกรรมที่ CPU ต้องทำให้ถูกต้อง | คำสั่งพึ่งกัน Branch หรือการเข้าถึงข้อมูล |
| Microarchitecture | คำสั่งตาม ISA | ผลลัพธ์ที่ยืนยันแล้ว | Cache Miss, Hazard, ทรัพยากรภายในเต็ม หรือการกู้คืนจากการคาดผิด |
วิธีตรวจความเข้าใจ: เลือกการกระทำหนึ่งอย่างในแอป แล้วอธิบายให้ได้สี่ชั้นว่า ผู้ใช้ต้องการอะไร ซอฟต์แวร์แตกเป็นงานใด ระบบปฏิบัติการจัดทรัพยากรอะไร และ CPU เปลี่ยนสถานะใด หากคำอธิบายกระโดดจากปุ่มไปถึง ALU ทันที แสดงว่ายังมีชั้นกลางที่ควรเติมให้ครบ
THE CONTRACT
ISA และคำสั่งเครื่อง: ภาษากลางระหว่างซอฟต์แวร์กับหน่วยประมวลผล
Instruction Set Architecture (ISA) คือข้อตกลงว่าซอฟต์แวร์มองเห็นคำสั่ง รีจิสเตอร์ ชนิดข้อมูล และพฤติกรรมพื้นฐานของเครื่องอย่างไร ตัวอย่างตระกูล ISA ที่พบได้คือ x86 และ RISC‑V รายละเอียดภายในของ CPU แต่ละรุ่นอาจต่างกันมาก แต่ตราบใดที่ทำตามข้อตกลงเดียวกัน โปรแกรมที่คอมไพล์สำหรับ ISA นั้นย่อมมีพื้นฐานร่วมกัน
Opcode
ส่วนที่บอกว่าจะทำอะไร เช่น ย้ายข้อมูล บวก เปรียบเทียบ หรือกระโดดไปยังตำแหน่งอื่น
Operand
ส่วนที่บอกว่าจะทำกับข้อมูลใด ซึ่งอาจอยู่ใน Register, Memory หรือเป็นค่าที่ฝังมากับคำสั่ง
Program Counter
สถานะที่ช่วยชี้ว่าคำสั่งถัดไปควรมาจากตำแหน่งใด และอาจเปลี่ยนเมื่อเกิด Branch
ISA เป็นระดับที่เหมาะกับการสร้างความเข้าใจ ส่วนวิธีที่ผู้ผลิตทำให้คำสั่งเหล่านั้นวิ่งจริงเรียกว่า Microarchitecture ซึ่งอาจใช้ Pipeline, Cache, Out-of-order Execution หรือกลไกอื่นต่างกัน บทนี้จึงอธิบายวงจรเชิงแนวคิด ไม่ได้อ้างว่าทุก CPU มีจำนวนขั้นหรือเส้นทางภายในเหมือนกัน
INSTRUCTION CYCLE
วงจร Fetch–Decode–Execute ไม่ได้หยุดแค่สามคำ
Fetch: หา “งานถัดไป”
CPU ใช้ตำแหน่งคำสั่งถัดไปเพื่อขอข้อมูลคำสั่ง หากคำสั่งอยู่ใกล้และอยู่ใน Cache การดึงย่อมสะดวกกว่าต้องรอจากหน่วยความจำที่ไกลกว่า หลังดึงแล้วตำแหน่งถัดไปมักเดินหน้า แต่คำสั่ง Branch, การเรียกฟังก์ชัน หรือเหตุการณ์อื่นอาจทำให้เส้นทางเปลี่ยน
Decode: แปลรูปแบบให้เป็นการควบคุมภายใน
ขั้น Decode ตรวจว่าคำสั่งต้องใช้หน่วยทำงานใด ต้องอ่านข้อมูลจากที่ไหน และจะส่งผลไปที่ใด ใน CPU จริง คำสั่งที่ซับซ้อนอาจถูกแตกเป็นงานย่อยภายใน แต่ผู้เรียนควรจับแก่นว่า Decode คือการเปลี่ยน “รหัสคำสั่ง” ให้เป็นแผนปฏิบัติที่วงจรภายในทำตามได้
Execute, Memory และ Write-back: ทำงานกับสถานะ
Execute อาจเป็นการบวก เปรียบเทียบ คำนวณที่อยู่ หรือเลือกเส้นทาง ถ้าต้องอ่านหรือเขียนหน่วยความจำจะมีขั้น Memory และเมื่อได้ผลแล้วจึงบันทึกกลับ การแยกชื่อขั้นนี้เป็นแบบจำลองเพื่อเรียนรู้ ไม่ใช่ข้อกำหนดว่าทุกสถาปัตยกรรมต้องมีห้ากล่องพอดี
FOLLOW ONE INSTRUCTION
ตามรอยคำสั่งหนึ่งชุด ตั้งแต่สถานะเริ่มต้นจนยืนยันผล
เพื่อเห็นวงจรแบบจับต้องได้ ให้ใช้สถานการณ์สมมติที่ตั้งใจลดรายละเอียด: โปรแกรมต้องอ่านยอดขายหนึ่งค่า บวกเข้ากับยอดสะสม แล้วเก็บยอดใหม่ไว้ เราจะไม่ผูกกับรหัสคำสั่งของ CPU รุ่นใด เพราะเป้าหมายคือมองการไหลของข้อมูล ไม่ใช่จำเลข Opcode
ก่อนเริ่ม สมมติว่า Program Counter ชี้ไปยังคำสั่งโหลดข้อมูล Register หนึ่งตัวเก็บยอดสะสมเดิม และที่อยู่ของข้อมูลถูกคำนวณไว้แล้ว สถานะเริ่มต้นนี้สำคัญมาก เพราะคำสั่งไม่ได้ลอยอยู่ลำพัง มันอาศัยผลจากคำสั่งก่อนหน้า ตำแหน่งข้อมูล และสิทธิ์ในการเข้าถึงหน่วยความจำ หากสิ่งใดไม่พร้อม วงจรอาจต้องรอหรือส่งเหตุการณ์ให้ระบบปฏิบัติการจัดการ
หน่วย Fetch ขอไบต์คำสั่งจากตำแหน่งที่ Program Counter ชี้ หากคำสั่งอยู่ใน Instruction Cache การตอบสนองมักเร็วกว่าไปยังระดับหน่วยความจำที่ไกลกว่า ตำแหน่งคำสั่งถัดไปถูกเตรียมไว้ แต่ยังอาจเปลี่ยนหากพบ Branch หรือเหตุการณ์พิเศษ
Decode แยกว่าคำสั่งต้องทำอะไร ใช้ Register ใด และต้องส่งงานไปยังหน่วยใด ใน CPU จริง คำสั่งหนึ่งรายการอาจแตกเป็นงานย่อยภายใน จุดสำคัญคือข้อมูลควบคุมต้องบอกเส้นทางของ Input และปลายทางของ Output ให้ชัด
ถ้าคำสั่งต้องโหลดข้อมูล CPU คำนวณที่อยู่และค้นหาในลำดับชั้นหน่วยความจำ หากข้อมูลอยู่ใน Cache ใกล้มือ งานเดินต่อได้เร็ว หากไม่อยู่ คำขอจะไล่ไปยังระดับที่ไกลขึ้น ระหว่างนั้นงานอื่นที่ไม่พึ่งข้อมูลนี้อาจเดินหน้าได้ แต่คำสั่งที่ต้องใช้ค่านั้นยังยืนยันผลไม่ได้
เมื่อยอดขายมาถึง หน่วยคำนวณบวกค่ากับยอดสะสม การบวกอาจใช้เวลาไม่นานเมื่อเทียบกับการรอข้อมูล สิ่งนี้อธิบายว่าทำไมการเพิ่มความเร็วของ ALU ไม่ช่วยมาก หากคอขวดจริงอยู่ที่การเคลื่อนข้อมูล
ผลลัพธ์ถูกเขียนกลับไปยัง Register หรือสถานะที่กำหนด เมื่อถึงจุดที่ CPU แน่ใจว่าคำสั่งนี้อยู่บนเส้นทางที่ถูกและไม่มีเหตุการณ์ก่อนหน้ามายกเลิก มันจึงยืนยันผลตามลำดับที่โปรแกรมควรสังเกตเห็น จากนั้นคำสั่งถัดไปใช้ผลนี้ต่อได้
สถานะที่ซอฟต์แวร์เห็น กับงานชั่วคราวภายใน
CPU สมัยใหม่สามารถเริ่มงานหลายรายการล่วงหน้าและอาจทำบางคำสั่งเสร็จภายในก่อนคำสั่งที่อยู่ด้านหน้า แต่ซอฟต์แวร์ไม่ควรเห็นผลที่ทำให้ความหมายของโปรแกรมผิดไป เราจึงควรแยก “งานที่กำลังคาดและคำนวณ” ออกจาก “ผลที่ยืนยันแล้ว” เมื่อ Branch Prediction เดาผิด งานจากเส้นทางผิดอาจถูกทิ้งโดยไม่กลายเป็นสถานะถาวรของโปรแกรม
ข้อยกเว้น เช่น การเข้าถึงที่อยู่ซึ่งไม่มีสิทธิ์ หรือ Page Fault ทำให้เส้นทางปกติหยุดชั่วคราว CPU และระบบปฏิบัติการต้องรักษาข้อมูลมากพอที่จะรายงานหรือกลับมาทำต่อได้อย่างถูกต้อง รายละเอียดแตกต่างตามสถาปัตยกรรม แต่แก่นเหมือนกัน: ความเร็วห้ามแลกกับการยืนยันผลผิดลำดับหรือผิดสิทธิ์
คำถามตรวจตนเอง: ในตัวอย่างนี้ หากการบวกใช้เวลาเท่าเดิมแต่ข้อมูลอยู่ไกลขึ้น ขั้นใดได้รับผลโดยตรง ขั้นใดต้องรอ และ Metric ปลายทางใดจะเปลี่ยน? คำตอบที่ดีต้องเชื่อมระยะรอข้อมูลกับ Latency หรือ Throughput ของงาน ไม่หยุดที่คำว่า “Cache ช้า”
WORKING PARTS
ชิ้นส่วนที่ร่วมมือกันใน CPU
Control Unit
ประสานลำดับและสัญญาณควบคุม ให้ข้อมูลและคำสั่งไปถึงหน่วยที่เหมาะสม
ALU / Execution Units
ทำเลขคณิต ตรรกะ การเปรียบเทียบ และงานเฉพาะชนิดตามที่สถาปัตยกรรมรองรับ
Registers
พื้นที่เก็บสถานะขนาดเล็กที่อยู่ใกล้หน่วยทำงาน ใช้ถือค่า ที่อยู่ และผลชั่วคราว
Cache
เก็บสำเนาข้อมูลหรือคำสั่งที่คาดว่าจะใช้ เพื่อหลีกเลี่ยงการรอจากหน่วยความจำที่ไกลกว่า
Load / Store
จัดการการอ่านและเขียนระหว่างโลกของ Register กับลำดับชั้นหน่วยความจำ
Clock & Coordination
ช่วยกำกับจังหวะของวงจร แต่จำนวนจังหวะไม่เท่ากับจำนวนงานที่เสร็จเสมอไป
ไม่มีชิ้นส่วนใด “เก่ง” แยกจากระบบ หาก ALU พร้อมแต่ข้อมูลยังไม่มา หน่วยคำนวณก็อาจว่าง หากข้อมูลพร้อมแต่ Branch เปลี่ยนทาง งานบางส่วนที่เตรียมไว้ก็อาจถูกทิ้ง ประสิทธิภาพจึงเป็นผลจากการประสานกัน ไม่ใช่ชัยชนะของส่วนใดส่วนหนึ่ง
DATA DISTANCE
Memory Hierarchy และ Cache: ปัญหาหลักคือ “ข้อมูลอยู่ไกลแค่ไหน”
CPU ทำงานได้ต่อเนื่องเมื่อคำสั่งและข้อมูลมาถึงทันเวลา แต่พื้นที่ที่ใกล้ CPU มากมีจำกัด ระบบจึงใช้ลำดับชั้น ตั้งแต่ Register และ Cache ไปยัง RAM และ Storage แต่ละชั้นแลกความเร็ว ความจุ ราคา และการใช้พลังงานต่างกัน
| ชั้น | หน้าที่เชิงแนวคิด | คำถามเวลาวิเคราะห์ |
|---|---|---|
| Register | ถือค่าที่กำลังใช้งานโดยตรง | คำสั่งต้องย้ายค่าเข้าออกมากเกินไปหรือไม่ |
| Cache | เก็บสิ่งที่คาดว่าจะใช้ใกล้ ๆ | รูปแบบการเข้าถึงมี Locality หรือทำให้ Cache Miss บ่อย |
| RAM | เก็บโปรแกรมและข้อมูลที่กำลังใช้งานในระบบ | CPU กำลังรอข้อมูลหรือแย่งแบนด์วิดท์กับงานอื่นหรือไม่ |
| Storage | เก็บข้อมูลระยะยาวและโหลดเข้าสู่หน่วยความจำ | ช้าก่อนถึง CPU เพราะ I/O หรือไม่ |
Locality คือแนวโน้มที่โปรแกรมจะใช้ข้อมูลเดิมซ้ำหรือใช้ข้อมูลใกล้กัน หากโค้ดอ่านตารางต่อเนื่อง Cache มักช่วยได้ดีกว่าการกระโดดไปยังตำแหน่งที่ไม่สัมพันธ์กัน แต่ไม่ควรสรุปจากรูปแบบโค้ดอย่างเดียว—ควรใช้เครื่องมือวัดกับงานจริง
OVERLAP
Pipeline: ให้หลายคำสั่งอยู่คนละขั้นพร้อมกัน
ถ้ารอให้คำสั่งหนึ่งผ่านทุกขั้นก่อนเริ่มคำสั่งถัดไป หน่วยบางส่วนจะว่าง Pipeline จึงแบ่งงานเป็นช่วงและให้คำสั่งหลายรายการเดินคนละช่วง เหมือนสายการผลิตที่สินค้าหลายชิ้นอยู่คนละสถานี เป้าหมายหลักคือเพิ่ม Throughput หรือจำนวนงานที่เสร็จต่อเวลา ไม่ได้หมายความว่า Latency ของคำสั่งเดี่ยวจะหายไป
| ช่วงเวลา | คำสั่ง A | คำสั่ง B | คำสั่ง C |
|---|---|---|---|
| จังหวะแรก | Fetch | — | — |
| จังหวะถัดมา | Decode | Fetch | — |
| เมื่อสายงานเดินต่อ | Execute | Decode | Fetch |
Pipeline ไม่ได้ลบความสัมพันธ์ระหว่างคำสั่ง หาก B ต้องใช้ผลจาก A, B อาจต้องรอหรือรับผลผ่านกลไกภายใน หากทรัพยากรถูกใช้ชนกันก็เกิดคอขวด และหากคาด Branch ผิด คำสั่งที่อยู่ในเส้นทางผิดอาจต้องถูกล้างออก
Data Hazard
คำสั่งใหม่ต้องพึ่งผลจากคำสั่งก่อนหน้า จึงยังเดินต่อไม่ได้ตามปกติ
Structural Hazard
คำสั่งหลายรายการต้องการทรัพยากรเดียวกันในเวลาใกล้กัน
Control Hazard
ยังไม่รู้แน่ว่าคำสั่งถัดไปควรมาจากเส้นทางใด
UNCERTAIN PATH
Branch Prediction และการกู้คืนเมื่อคาดทางผิด
โค้ดเต็มไปด้วยเงื่อนไขและลูป CPU ต้องตัดสินใจว่าคำสั่งถัดไปอยู่ทางใด หากหยุดรอทุกครั้ง Pipeline จะขาดช่วง จึงมีการคาดเดาทางที่น่าจะเกิดและเตรียมงานล่วงหน้า เมื่อคาดถูก งานเดินต่อได้ แต่เมื่อคาดผิดต้องยกเลิกผลที่ยังไม่ควรถูกยืนยัน แล้วกลับไปยังเส้นทางที่ถูกต้อง
การคาดเดาเพิ่มประสิทธิภาพแต่เพิ่มความซับซ้อน ทั้งด้านการออกแบบ พลังงาน และการรักษาขอบเขตของสถานะ สถาปัตยกรรมสมัยใหม่จึงต้องพิจารณาความถูกต้องและความปลอดภัยร่วมกับความเร็ว ผู้เรียนไม่ควรตีความว่า “คาดเดา” หมายถึง CPU ยอมให้ผลผิดออกไปถึงโปรแกรมโดยตั้งใจ—ผลสถาปัตยกรรมที่ยืนยันต้องยังคงสอดคล้องกับกติกาของ ISA
PARALLEL WORK
Core, Thread และ Parallelism: มีคนเพิ่มไม่ได้ทำให้งานแบ่งได้เสมอ
Core คือหน่วยประมวลผลที่สามารถดำเนินสายคำสั่งของตน ส่วน Thread คือสายงานที่ระบบปฏิบัติการจัดตารางให้รันบนทรัพยากรเหล่านั้น บาง CPU ทำให้หนึ่ง Core เก็บสถานะของหลาย Hardware Threads ได้ แต่ทรัพยากรภายในอาจยังใช้ร่วมกัน
งานที่แบ่งเป็นส่วนอิสระอาจใช้หลาย Core ได้ดี เช่น ประมวลผลไฟล์หลายชิ้น แต่ลูปที่แต่ละรอบพึ่งผลจากรอบก่อนอาจแบ่งยาก นอกจากนี้หลาย Thread อาจแย่ง Cache, Memory Bandwidth หรือ Lock เดียวกัน การเพิ่ม Thread จึงต้องดูโครงสร้างงานและหลักฐาน ไม่ใช่คาดว่าจำนวน Core ที่มากขึ้นจะลดเวลาแบบเส้นตรง
Parallelizable
แบ่งงานย่อยที่เป็นอิสระ มีข้อมูลและผลลัพธ์แยกกันชัดเจน
Dependency-bound
งานถัดไปต้องรอผลก่อนหน้า ต่อให้มี Core ว่างก็ช่วยไม่ได้ทันที
Shared-resource-bound
หลายสายงานแย่งหน่วยความจำ Cache, I/O หรือจุดล็อกเดียวกัน
MEASURE THE RIGHT THING
Clock, IPC, Latency และ Throughput: ตัวเลขเดียวตอบไม่ได้
Clock บอกอัตราจังหวะอ้างอิง แต่ไม่ได้บอกว่าทุกจังหวะทำงานสำเร็จกี่ชิ้น IPC เป็นแนวคิดเรื่องจำนวนคำสั่งที่เสร็จต่อจังหวะและเปลี่ยนตามลักษณะงาน ขณะที่ Latency สนใจเวลาของงานหนึ่งชิ้น และ Throughput สนใจปริมาณงานรวมต่อเวลา การเลือกตัวชี้วัดต้องเริ่มจากคำถามของผู้ใช้
| คำถาม | ตัวชี้วัดที่ควรเริ่มดู | ข้อควรระวัง |
|---|---|---|
| ผู้ใช้รอนานเท่าไร | เวลาตอบสนองปลายทางและช่วงเวลาของแต่ละขั้น | ค่าเฉลี่ยอาจซ่อนกรณีที่ช้ามาก |
| ระบบทำงานได้กี่ชิ้นต่อเวลา | Throughput ภายใต้ภาระที่นิยามชัด | อย่าแลกความถูกต้องเพื่อเพิ่มจำนวนงาน |
| CPU ไม่ว่างจริงหรือกำลังรอ | Utilization ร่วมกับ Stall, Cache และ Memory | CPU สูงไม่ได้แปลว่าคอขวดอยู่ที่คำนวณเสมอ |
| ปรับแล้วดีขึ้นหรือไม่ | เปรียบเทียบงาน ชุดข้อมูล สภาพแวดล้อม และผลลัพธ์เดียวกัน | เปลี่ยนหลายตัวพร้อมกันทำให้สรุปสาเหตุยาก |
ONE STORY THROUGH THE LESSON
กรณีศึกษา: โปรแกรมรวมยอดจากตารางขนาดใหญ่
สมมติว่าโปรแกรมต้องอ่านแถวในตาราง ตรวจว่าแถวนั้นผ่านเงื่อนไขหรือไม่ แล้วรวมค่าเข้าสู่ยอดสะสม กรณีนี้ไม่มีตัวเลขผลทดสอบที่แต่งขึ้น เราจะใช้เพื่อเชื่อมแนวคิดและกำหนดสิ่งที่ควรวัดเท่านั้น
หนึ่งรอบของลูปเกิดอะไรขึ้น
- Fetch: CPU ดึงคำสั่งของลูปและคำสั่งถัดไปตามเส้นทางที่คาด
- Decode: ระบุว่าต้องโหลดข้อมูล เปรียบเทียบ อาจบวกค่า และเลื่อนตำแหน่งไปยังแถวถัดไป
- Execute: คำนวณที่อยู่ เปรียบเทียบเงื่อนไข และบวกค่าหากผ่านเงื่อนไข
- Memory: ข้อมูลแถวต้องมาถึงจาก Cache หรือหน่วยความจำ หากไม่อยู่ใกล้ CPU อาจต้องรอ
- Write-back: ยอดสะสมและตำแหน่งปัจจุบันถูกอัปเดต ก่อน Branch ส่งวงจรกลับไปต้นลูป
คอขวดอาจอยู่คนละที่ แม้อาการเหมือนกัน
ข้อมูลไม่ต่อเนื่อง
Cache ช่วยได้น้อยและต้องรอข้อมูลบ่อย แม้หน่วยคำนวณไม่ได้ทำเลขหนัก
เงื่อนไขเดายาก
Branch สลับทางจนงานที่เตรียมไว้ถูกทิ้งและ Pipeline ต้องกู้คืนบ่อย
แบ่ง Thread มากเกินไป
ค่าใช้จ่ายการประสานและการแย่งทรัพยากรอาจกลบประโยชน์จาก Core เพิ่ม
ขั้นวิเคราะห์ที่ดีคือเก็บ Baseline ตรวจความถูกต้องของยอดรวม วัดเวลาปลายทาง แล้วทดลองเปลี่ยนเพียงสมมติฐานสำคัญ เช่น การจัดข้อมูลให้ต่อเนื่องหรือการแบ่งงานเป็นก้อน จากนั้นเปรียบเทียบภายใต้เงื่อนไขเดียวกัน หากผลไม่ดีขึ้นให้ย้อนกลับ ไม่ใช่บังคับคำอธิบายให้เข้ากับสิ่งที่อยากเชื่อ
PERFORMANCE INVESTIGATION
วิเคราะห์คำว่า “CPU ช้า” ให้กลายเป็นคำถามที่ตรวจได้
คำว่า “CPU ช้า” เป็นเพียงอาการ ยังไม่ใช่สาเหตุ เครื่องอาจตอบสนองช้าเพราะ Core ทำงานเต็มจริง หรือเพราะ CPU ว่างเป็นช่วง ๆ ระหว่างรอ Memory, Storage, Network, Lock หรืออุปกรณ์อื่น หากเริ่มจากการเลือกสเปกใหม่ทันที เราอาจแก้ส่วนที่ไม่ใช่คอขวดและได้ระบบที่แพงขึ้นแต่เร็วขึ้นน้อยมาก
ขั้นที่ 1 เริ่มจากผลลัพธ์ของผู้ใช้
กำหนดงานให้ชัด เช่น “รวมยอดไฟล์นี้ให้เสร็จภายในกี่วินาที” หรือ “หน้าโปรแกรมตอบสนองหลังคลิกภายในกี่มิลลิวินาที” ระบุข้อมูล ขนาดงาน รุ่นซอฟต์แวร์ สภาพแวดล้อม และเกณฑ์ความถูกต้อง เพราะตัวเลขจากคนละงานเทียบกันไม่ได้ ถ้าผลลัพธ์เร็วขึ้นแต่ยอดรวมผิด การปรับนั้นไม่ถือว่าสำเร็จ
ขั้นที่ 2 เก็บ Baseline ที่ทำซ้ำได้
รันงานเดิมหลายครั้งภายใต้เงื่อนไขใกล้กัน บันทึก Latency, Throughput และความถูกต้อง พร้อมสังเกต CPU Utilization, เวลารอ, Memory, I/O และจำนวน Thread เท่าที่เครื่องมือรองรับ Baseline ไม่ได้มีไว้สร้างตัวเลขสวย แต่ใช้ตอบว่าความแปรปรวนปกติอยู่แค่ไหน และการเปลี่ยนครั้งต่อไปต่างจากเดิมจริงหรือเป็นเพียงจังหวะของระบบ
ขั้นที่ 3 ตั้งสมมติฐานจากเส้นทางข้อมูล
| รูปแบบอาการ | สมมติฐานที่ควรตรวจ | หลักฐานที่หักล้างได้ |
|---|---|---|
| Core หนึ่งหรือหลาย Core ทำงานสูงต่อเนื่อง | งานอาจติดการคำนวณหรือมีส่วนที่ทำขนานไม่ได้ | เวลาส่วนใหญ่กลับอยู่ที่การรอ I/O หรือ Lock ไม่ใช่ฟังก์ชันคำนวณ |
| Utilization ไม่เต็มแต่ Latency สูง | งานอาจรอ Memory, Storage, Network หรือ Dependency | Trace แสดงว่าหน่วยคำนวณทำงานต่อเนื่องและไม่มีช่วงรอเด่น |
| เพิ่ม Thread แล้วช้าลง | เกิดการแย่ง Cache, Memory bandwidth, Lock หรือมีค่าใช้จ่ายในการประสานงาน | Throughput เพิ่มตามจำนวน Thread โดย Latency และความถูกต้องยังอยู่ในเกณฑ์ |
| เร็วช่วงสั้นแต่ช้าลงเมื่อรันนาน | ข้อจำกัดด้านพลังงาน ความร้อน หรือทรัพยากรสะสมอาจมีผล | ความถี่ อุณหภูมิ และเวลาต่อรอบคงที่ ขณะที่สาเหตุอยู่ชั้นซอฟต์แวร์อื่น |
ขั้นที่ 4 เปลี่ยนทีละสมมติฐาน
ถ้าสงสัยรูปแบบการเข้าถึงข้อมูล ให้ทดลองจัดข้อมูลให้ต่อเนื่องขึ้นโดยรักษาอัลกอริทึมและผลลัพธ์ ถ้าสงสัย Branch ให้แยกข้อมูลที่ทำให้เงื่อนไขคาดเดาง่ายกับยาก ถ้าสงสัยจำนวน Thread ให้ทดลองหลายค่าโดยไม่เปลี่ยนฮาร์ดแวร์พร้อมกัน การเปลี่ยนหลายอย่างในรอบเดียวอาจทำให้เร็วขึ้น แต่เราไม่รู้ว่าส่วนใดเป็นเหตุและนำบทเรียนไปใช้ต่อไม่ได้
ขั้นที่ 5 กำหนด Guardrail และ Stop Rule
ทุกการปรับต้องมี Test ความถูกต้อง ใช้ข้อมูลที่ไม่เปิดเผยข้อมูลส่วนตัวโดยไม่จำเป็น และไม่ทำให้เครื่องร้อนหรือไม่เสถียรเกินขอบเขตที่ผู้ผลิตกำหนด หากผลต่างเล็กกว่าความแปรปรวนของ Baseline หรือเกิดความผิดพลาด ให้ย้อนกลับก่อนสรุป การตัดสินใจที่ดีไม่ใช่ปรับได้มากที่สุด แต่รู้ว่าเมื่อใดหลักฐานยังไม่พอ
Performance Monitor และ Performance Counter ช่วยเก็บภาพรวมบน Windows ได้ แต่ Counter แต่ละตัวมีขอบเขตและอาจต้องดูร่วมกับ Trace หรือ Profiler อื่น เอกสาร Microsoft แนะนำให้เริ่มจากคำถามว่าอาการทำซ้ำได้หรือไม่ เกิดเมื่อใด และมีรูปแบบใด ก่อนเลือกวิธีเก็บข้อมูล หลักนี้ใช้ได้กว้างกว่าเครื่องมือใดเครื่องมือหนึ่ง: เก็บบริบทก่อนเก็บตัวเลข และอ่านหลายสัญญาณร่วมกัน
MISCONCEPTIONS
ความเข้าใจผิดที่ทำให้วิเคราะห์ CPU ผิดจุด
“Clock สูงกว่า จึงเร็วกว่าเสมอ”
กลไกที่ทำให้คิดเช่นนั้น: GHz เป็นตัวเลขเดียวที่มองเห็นง่าย และ Clock บอกจำนวนจังหวะต่อวินาทีจริง จึงดูเหมือนใช้แทนความเร็วทั้งหมดได้
สิ่งที่ถูกต้อง: งานที่เสร็จต่อเวลาขึ้นกับทั้งจำนวนรอบ งานที่ทำได้ต่อรอบ การรอข้อมูล การคาด Branch จำนวน Core ข้อจำกัดพลังงาน และซอฟต์แวร์ CPU สองรุ่นที่ Clock เท่ากันอาจให้ผลต่างกัน และรุ่นที่ Clock ต่ำกว่าอาจเร็วกว่าสำหรับงานบางชนิด
วิธีตรวจ: ใช้ Benchmark หรือ Workflow เดียวกัน รักษาข้อมูลและความถูกต้องให้เทียบกันได้ แล้วดู Latency/Throughput ร่วมกับทรัพยากร ไม่เทียบจากชื่อรุ่นหรือ GHz เพียงค่าเดียว
“CPU Utilization ไม่เต็ม แปลว่า CPU เหลือและไม่ใช่คอขวด”
กลไกที่ทำให้คิดเช่นนั้น: ค่าเฉลี่ยทั้งเครื่องอาจซ่อน Core ที่เต็มหนึ่ง Core หรือช่วงทำงานสลับกับช่วงรอ อีกทั้งงานที่พึ่งกันอาจใช้ Core เพิ่มไม่ได้
สิ่งที่ถูกต้อง: Utilization เป็นหลักฐานหนึ่งชิ้น ไม่ใช่คำตัดสิน งานอาจติดส่วนที่ทำขนานไม่ได้ รอ Memory หรือรอ Lock แม้ค่าเฉลี่ยไม่เต็ม ในทางกลับกัน Utilization สูงก็ไม่ได้แปลว่าการเพิ่ม CPU จะช่วย หากงานที่ทำอยู่เป็นงานซ้ำหรือเกิดจากข้อผิดพลาด
วิธีตรวจ: ดูระดับ Process, Thread และ Core ตามช่วงเวลา เทียบกับ Latency และช่วงรอ ถามว่า Thread สำคัญกำลังทำอะไรในเวลาที่ผู้ใช้รู้สึกช้า
“เพิ่ม Core หรือ Thread แล้วต้องเร็วขึ้นตามสัดส่วน”
กลไกที่ทำให้คิดเช่นนั้น: ภาพคนหลายคนช่วยกันทำงานทำให้เราลืมว่าบางขั้นต้องรอผลก่อนหน้า และทุกคนอาจต้องใช้โต๊ะหรือวัตถุดิบชุดเดียวกัน
สิ่งที่ถูกต้อง: Speedup ถูกจำกัดด้วยส่วนที่แบ่งไม่ได้ ค่าใช้จ่ายการสื่อสาร Lock, Cache coherence และ Memory bandwidth การเพิ่ม Thread เกินจุดเหมาะสมอาจทำให้การแย่งทรัพยากรสูงขึ้นและช้าลง
วิธีตรวจ: วัดหลายจำนวน Thread บนงานเดิม บันทึกทั้ง Throughput, Latency, ความถูกต้อง และทรัพยากร หากกราฟเริ่มแบนหรือถอย ให้หาจุดแย่งทรัพยากรก่อนเพิ่ม Thread ต่อ
“Cache คือ RAM ขนาดเล็กที่โปรแกรมสั่งใช้ตรง ๆ”
กลไกที่ทำให้คิดเช่นนั้น: ทั้งสองเก็บข้อมูลและ Cache อยู่ใกล้ CPU จึงดูเหมือนเป็นกล่องเก็บข้อมูลชนิดเดียวกันต่างกันแค่ขนาด
สิ่งที่ถูกต้อง: Cache เป็นส่วนของลำดับชั้นหน่วยความจำที่ฮาร์ดแวร์จัดการตามนโยบายและรูปแบบการเข้าถึง โปรแกรมมักควบคุมได้ทางอ้อมผ่านโครงสร้างข้อมูล ลำดับการอ่าน และขนาด Working Set มากกว่าสั่งว่า “เก็บค่านี้ใน Cache” แบบทั่วไป อุปมาชั้นวางใกล้มือช่วยเห็นระยะ แต่ไม่อธิบายนโยบายแทนที่ ความสอดคล้องระหว่าง Core หรือรายละเอียดทุกระดับ
วิธีตรวจ: เปลี่ยนรูปแบบการเข้าถึงโดยรักษาปริมาณคำนวณใกล้เดิม แล้วดูผลที่ทำซ้ำได้ หากการเดินข้อมูลต่อเนื่องให้ผลต่างจากการกระโดดตำแหน่ง แสดงว่าระยะและรูปแบบข้อมูลมีบทบาท
“CPU ทำคำสั่งตามลำดับทีละรายการเสมอ”
กลไกที่ทำให้คิดเช่นนั้น: โมเดล Fetch → Decode → Execute วาดเป็นเส้นตรง และโปรแกรมต้องให้ผลเสมือนลำดับถูกต้อง
สิ่งที่ถูกต้อง: ภายใน CPU อาจซ้อนหลายคำสั่ง จัดลำดับงานย่อยใหม่ หรือทำเส้นทางที่คาดไว้ล่วงหน้า แต่ต้องยืนยันผลให้ซอฟต์แวร์สังเกตได้อย่างถูกต้อง ความต่างระหว่าง “ลำดับที่ทำภายใน” กับ “ลำดับผลที่ยืนยัน” คือกุญแจของ Pipeline, Out-of-order Execution และ Branch Recovery
วิธีตรวจ: อธิบายให้ได้ว่าทำไมคำสั่งหลังอาจเริ่มก่อน แต่ผลจาก Branch ผิดไม่ควรถูกยืนยัน หากตอบได้โดยไม่ขัดกับความหมายของโปรแกรม แสดงว่า Mental Model เริ่มแม่นขึ้น
FAILURE CASES & HUMAN CONTROL
สิ่งที่พลาดบ่อย Trade-off และบทบาทของมนุษย์
| Failure Case | เหตุใดจึงพลาด | สิ่งที่ควรทำ |
|---|---|---|
| ซื้อ CPU Clock สูงกว่าโดยยังไม่วัด | งานอาจติด Memory, I/O, Lock หรือเส้นทางซอฟต์แวร์ | นิยามงาน เก็บ Baseline และแยกช่วงเวลาก่อนตัดสินใจ |
| ดู CPU Utilization ค่าเดียว | ค่ารวมซ่อน Core ที่ตัน การรอ หรือช่วงสั้นที่สำคัญ | ดูร่วมกับเวลาใช้งานจริง Cache/Memory และคิวงาน |
| เพิ่ม Thread จนสุด | งานอาจมี Dependency และแย่งทรัพยากรร่วม | ทดสอบระดับ Parallelism หลายค่าโดยรักษาผลลัพธ์เดิม |
| ปรับเพื่อ Benchmark แต่ทำให้ผลผิด | ประสิทธิภาพถูกแยกจากความถูกต้อง | มี Test, Validation และเกณฑ์หยุด/ย้อนกลับทุกครั้ง |
| สรุปจากเครื่องเดียวหรือรอบเดียว | สภาวะ Background, Thermal และข้อมูลอาจต่างกัน | บันทึกสภาพแวดล้อม ทำซ้ำ และรายงานข้อจำกัด |
Trade-off หลัก: การเพิ่ม Cache หรือกลไกคาดเดาช่วยบางงานแต่เพิ่มพื้นที่และความซับซ้อน การเพิ่ม Core ช่วยงานที่แบ่งได้แต่เพิ่มภาระการประสาน การเร่ง Clock กระทบพลังงานและความร้อน ส่วนการปรับโค้ดให้เฉพาะแพลตฟอร์มอาจลดความพกพา ไม่มีคำตอบที่ดีที่สุดนอกบริบท
Human-in-the-loop สำหรับงานปรับประสิทธิภาพ
- มนุษย์กำหนดว่า “เร็วขึ้น” หมายถึง Latency, Throughput, Cost หรือประสบการณ์ใด
- มนุษย์ยืนยันว่าข้อมูลทดสอบและผลลัพธ์ถูกต้องก่อนเชื่อ Counter
- มนุษย์ตรวจผลกระทบด้านพลังงาน ความร้อน ความเสถียร และความสามารถดูแลต่อ
- มนุษย์กำหนด Stop Rule เมื่อการปรับไม่คุ้มค่า หรือผลลัพธ์เริ่มผิดจากเงื่อนไข
PRACTICE
Worksheet: CPU Trace Card
เลือกงานหนึ่งงาน เช่น เปิดไฟล์ คำนวณตาราง บีบอัดข้อมูล หรือรันโมเดลขนาดเล็ก แล้วกรอกการ์ดนี้โดยไม่เดาค่าที่ไม่มีหลักฐาน หากยังวัดไม่ได้ให้เขียนว่า “ยังไม่ทราบ” และระบุเครื่องมือหรือข้อมูลที่ต้องใช้
- งานและผลลัพธ์: Input คืออะไร Output ที่ถูกต้องหน้าตาอย่างไร
- เส้นทางคำสั่ง: ส่วนใดมีการอ่านข้อมูล คำนวณ เงื่อนไข และเขียนผล
- แหล่งรอ: อาจรอ Storage, RAM, Cache, Lock, Network หรืออุปกรณ์ใด
- Parallelism: งานย่อยใดเป็นอิสระ และส่วนใดมี Dependency
- Baseline: จะวัด Latency/Throughput ภายใต้ข้อมูลและสภาพแวดล้อมใด
- สมมติฐานเดียว: จะเปลี่ยนอะไรเพียงหนึ่งอย่าง และคาดว่าจะเห็นหลักฐานใด
- Guardrail: จะตรวจความถูกต้อง พลังงาน ความร้อน หรือความเสถียรอย่างไร
- Stop Rule: เมื่อใดควรหยุดหรือย้อนกลับ
เกณฑ์สำเร็จ: คุณไม่จำเป็นต้องแก้คอขวดในครั้งแรก แต่ต้องสามารถแยกสิ่งที่รู้ สิ่งที่ยังไม่รู้ และหลักฐานที่จะใช้ตัดสินขั้นถัดไปได้
CHECK YOUR UNDERSTANDING
แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่ดีที่สุดเพียงหนึ่งข้อ แล้วกด “ตรวจคำตอบ” เพียงครั้งเดียว ระบบจะแสดงผลรายข้อ คะแนนรวม และจำนวนข้อที่ยังไม่ได้ตอบ
CONCLUSION
บทสรุป: CPU คือระบบเปลี่ยนสถานะที่ต้องรักษาทั้งความเร็วและความหมาย
กลับไปที่ปุ่ม “คำนวณยอดรวม” ตอนต้น เรามองเห็นเพียงผลลัพธ์หนึ่งค่า แต่ตอนนี้เราตามเส้นทางได้แล้วว่า แอปและระบบปฏิบัติการเตรียมงานอย่างไร ISA กำหนดสัญญาอะไร CPU ดึงและแปลคำสั่งอย่างไร ข้อมูลเดินผ่าน Register, Cache และ Memory อย่างไร และผลถูกยืนยันเมื่อใด
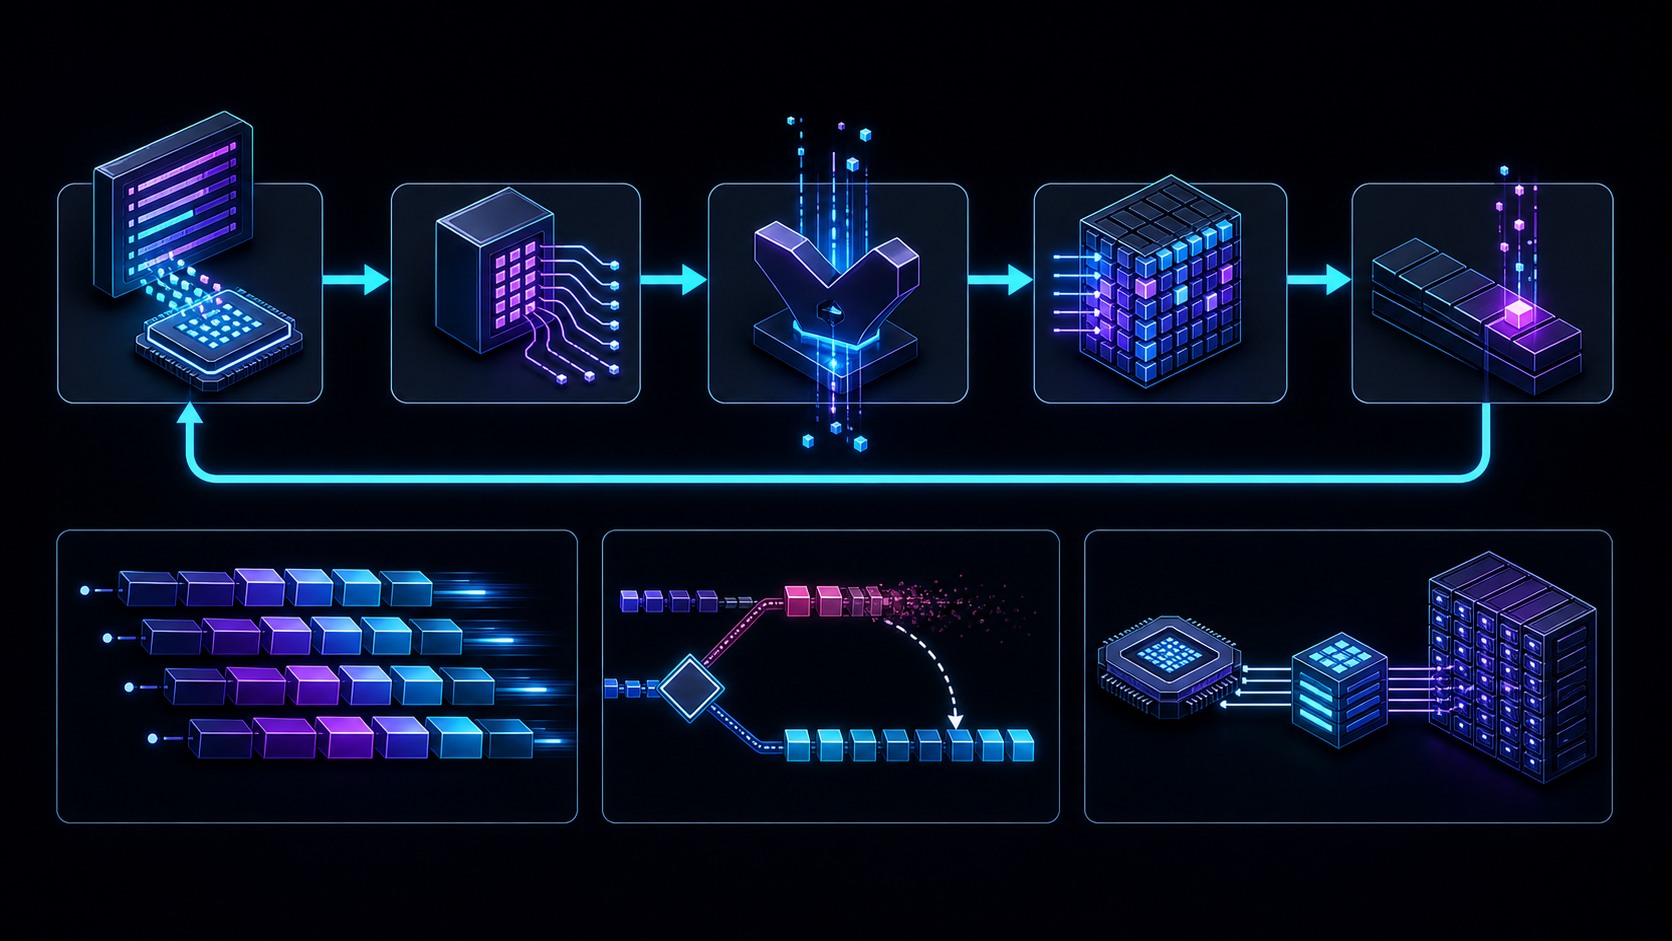
วงจร Fetch → Decode → Execute → Memory → Write-back เป็นแผนที่สำหรับตั้งคำถาม ไม่ใช่คำบรรยายตายตัวของ CPU ทุกเครื่อง Pipeline ช่วยซ้อนงาน Branch Prediction ลดช่วงว่างเมื่อคาดถูก Cache ลดระยะรอข้อมูล และหลาย Core เปิดโอกาสให้งานขนาน แต่กลไกเหล่านี้ช่วยได้ต่อเมื่อรูปแบบงานเอื้อ และทุกกลไกมี Failure Case หรือ Trade-off ของตนเอง
กฎจำง่ายมีสามข้อ หนึ่ง เริ่มจากผลลัพธ์ที่ผู้ใช้สัมผัส ไม่เริ่มจากสเปก สอง แยกเวลาที่ระบบกำลังคำนวณออกจากเวลาที่กำลังรอ สาม เปลี่ยนสมมติฐานทีละอย่างและรักษาความถูกต้องเป็น Guardrail หากทำสามข้อนี้ได้ คำว่า “CPU ช้า” จะเปลี่ยนจากการคาดเดาเป็นคำถามที่เก็บหลักฐานและตัดสินใจต่อได้
อย่าวัด CPU จากจังหวะที่มันเดินเพียงอย่างเดียว ให้ดูว่างานใดเสร็จ ข้อมูลรออยู่ที่ไหน และผลที่ได้ยังถูกต้องหรือไม่
SUMMARY
สรุปและภาพจำ
เรียนต่ออย่างมีทิศทาง
บทถัดไปจะต่อยอดจาก CPU ไปสู่หน่วยความจำและการจัดการข้อมูล ระหว่างนี้ใช้ CPU Trace Card แยกสิ่งที่กำลังคำนวณออกจากสิ่งที่กำลังรอ เพื่อไม่ให้ตัดสินระบบจาก Clock เพียงค่าเดียว
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงและบันทึกบรรณาธิการ
- Intel® 64 and IA-32 Architectures Software Developer Manuals — เอกสารทางการสำหรับ ISA, สถานะสถาปัตยกรรม และสภาพแวดล้อมการเขียนโปรแกรม
- The RISC‑V Instruction Set Manual, Volume I: Unprivileged Architecture — เอกสารปฐมภูมิสำหรับแยก ISA ออกจากวิธีสร้าง Microarchitecture
- Intel® 64 and IA-32 Architectures Optimization Reference Manual — แนวทางและข้อจำกัดด้าน Microarchitecture และการปรับประสิทธิภาพ
- AMD Software Optimization Guide for Family 17h Processors — ตัวอย่างเอกสารผู้ผลิตที่อธิบายผลของ Cache, Branch และรูปแบบข้อมูลต่อประสิทธิภาพ
- Microsoft Learn: Troubleshoot issues using Performance Monitor — แนวทางเริ่มจากอาการ บริบท และการเก็บ Counter อย่างเป็นระบบ
- Microsoft Learn: Get-Counter — เอกสารทางการของเครื่องมืออ่าน Performance Counter
ขอบเขต: บทนี้ใช้แบบจำลองเชิงแนวคิดเพื่อการเรียนรู้ รายละเอียด Pipeline, Cache, Prediction, การยืนยันผล และหน่วยทำงานต่างกันตาม ISA และ Microarchitecture ควรอ้างเอกสารของแพลตฟอร์มที่ใช้งานเมื่อวิเคราะห์ระดับลึก
บันทึกบรรณาธิการ: ตรวจข้อเท็จจริงและลิงก์ล่าสุด 10 สิงหาคม 2026 ตัวอย่าง “รวมยอดจากตารางขนาดใหญ่” และการตามรอยคำสั่งเป็นสถานการณ์สมมติเพื่ออธิบายกลไก ไม่ใช่ผล Benchmark ของ CPU รุ่นใด ภาพสรุปเป็น ImageGen รุ่น v2 แบบไม่มีข้อความ และมี Source, Version กับ Modification record ในคลังสื่อของโครงการ
