หัวข้อ 30 จาก 50 · ความคืบหน้า 60%
ความรู้ก่อนเรียน: เข้าใจการประเมินความคุ้มค่าโครงการ AI จากหัวข้อ 29 จะช่วยให้เชื่อมสเปกกับต้นทุนและผลลัพธ์ได้
ระดับเริ่มต้น · ใช้เวลาประมาณ 45–55 นาที
เวลามองคอมพิวเตอร์ เรามักเริ่มจากชื่อรุ่น จำนวน Core ขนาด RAM หรือราคา GPU แต่ตัวเลขเหล่านี้ยังตอบไม่ได้ว่าเครื่องจะทำงานของเราได้ดีเพียงใด คำถามที่มีประโยชน์กว่าคือ ข้อมูลเริ่มจากไหน ต้องพักที่ใด ถูกประมวลผลอย่างไร ส่งออกไปหาใคร และขั้นใดทำให้ส่วนอื่นต้องรอ
บทนี้จะพาคุณมองฮาร์ดแวร์เป็นระบบส่งต่อข้อมูล ไม่ใช่การแข่งขันว่าชิ้นไหนแรงที่สุด เราจะตามกรณีของ “ทีมอรุณ” ซึ่งกำลังสร้างผู้ช่วยค้นเอกสารภายในองค์กร ทีมไม่ได้เริ่มจากการซื้อ GPU แต่เริ่มจากแผนที่งาน ขนาด Working Set เวลาตอบสนองที่ต้องการ และหลักฐานว่าทรัพยากรใดเป็นคอขวดจริง
เมื่ออ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบายหน้าที่ของ CPU, RAM, Storage, GPU, Network และ Power/Cooling โดยเชื่อมกับเส้นทางข้อมูลได้
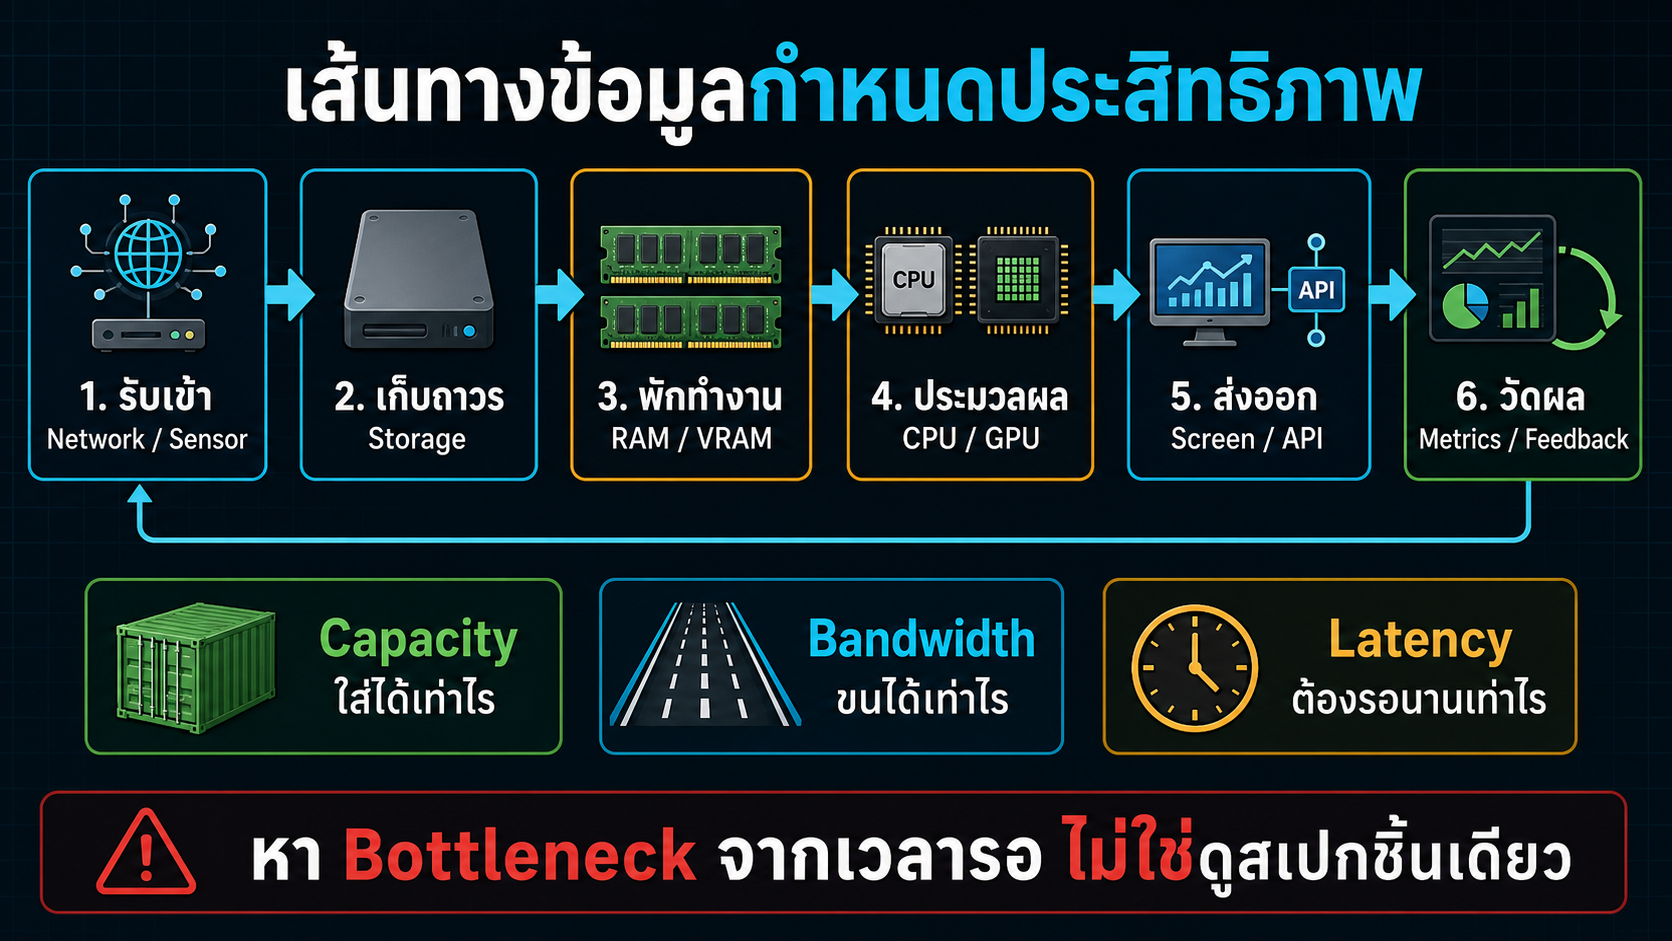
- วาด Input → Storage → Memory → Compute → Output → Metrics ของงานหนึ่งงานได้
- แยก Capacity, Bandwidth, Throughput และ Latency โดยไม่ใช้แทนกันได้
- ตั้งสมมติฐาน Bottleneck และออกแบบการวัดที่เปลี่ยนทีละตัวแปรได้
- เขียน Hardware Decision Brief ที่ระบุ Baseline, Working Set, Service Goal, Trade-off และเกณฑ์หยุดได้
1. Mental Model: เครื่องหนึ่งเครื่องคือระบบส่งข้อมูล
คอมพิวเตอร์รับข้อมูลจากคีย์บอร์ด เซนเซอร์ ไฟล์ หรือ Network เก็บข้อมูลระยะยาวไว้ใน Storage ย้ายส่วนที่กำลังใช้เข้าหน่วยความจำ ส่งคำสั่งให้ CPU หรือ GPU ประมวลผล แล้วเขียนผลกลับเป็นภาพ ไฟล์ หรือ API ทุกขั้นมีขีดจำกัดของตนเอง ถ้าขั้นหนึ่งส่งต่อไม่ทัน ขั้นถัดไปอาจว่างรอ แม้หน่วยคำนวณนั้นจะมีศักยภาพสูงมาก
ดังนั้น “เครื่องเร็ว” ไม่ใช่คุณสมบัติเดี่ยว แต่เป็นความสัมพันธ์ระหว่างภาระงานกับเส้นทางข้อมูล งานเปิดเอกสารจำนวนมากอาจติด Storage และ RAM งานตอบคำขอสั้นจำนวนมากอาจไวต่อ Latency และ CPU งานคำนวณเมทริกซ์ขนาดใหญ่ที่จัดรูปแบบข้อมูลพร้อมแล้วอาจได้ประโยชน์จาก GPU ส่วนงานที่ต้องส่งข้อมูลไปกลับระหว่าง CPU กับ GPU บ่อยอาจเสียเวลาที่การเคลื่อนย้ายมากกว่าที่ประหยัดจากการคำนวณ
กรณีของทีมอรุณเริ่มจากเอกสารภายใน ผู้ใช้พิมพ์คำถาม ระบบค้นส่วนข้อความที่เกี่ยวข้อง ส่งบริบทให้โมเดล สร้างคำตอบ แล้วบันทึกเหตุการณ์เพื่อให้ผู้ดูแลตรวจสอบได้ เส้นทางนี้มีทั้งการอ่านไฟล์ การทำดัชนี การพักข้อมูล การคำนวณ การส่งผ่าน Network และการเขียน Log หากทีมซื้อชิ้นส่วนจากชื่อเสียงเพียงอย่างเดียว ทีมอาจเพิ่มกำลังในจุดที่ไม่ได้ทำให้ผู้ใช้รอน้อยลง
2. ชิ้นส่วนหลัก: อ่านจากหน้าที่ ไม่ใช่อันดับความแรง
| ส่วนประกอบ | หน้าที่ในเส้นทาง | อาการเมื่อเป็นข้อจำกัด | สิ่งที่ต้องตรวจร่วมกัน |
|---|---|---|---|
| CPU | จัดลำดับงาน ควบคุมโปรแกรม ทำตรรกะ และเตรียมข้อมูล | คิวงานยาว การตอบสนองช้า หรือบาง Core ทำงานหนัก | รูปแบบ Thread, Software, I/O และเวลารอต่อคำขอ |
| RAM | เก็บข้อมูลและโปรแกรมที่กำลังใช้งาน | สลับข้อมูลกับ Storage บ่อย โปรแกรมสะดุดหรือปิด | Working Set, Page/Swap และจำนวนงานพร้อมกัน |
| Storage | เก็บระบบ โปรแกรม โมเดล ดัชนี เอกสาร และ Log ระยะยาว | โหลดช้า Queue สูง หรือเขียน Log ไม่ทัน | รูปแบบอ่าน/เขียน ขนาดไฟล์ IOPS, Throughput และ Latency |
| GPU/VRAM | เร่งงานขนานและพักข้อมูลที่ GPU ต้องใช้ | งานคำนวณช้า โมเดลหรือ Batch ไม่พอดี หรือ GPU รอข้อมูล | ความเข้ากันได้ของ Software, Transfer และขนาด Working Set |
| Network | รับคำขอ ดึงข้อมูลจากระบบอื่น และส่งผลลัพธ์ | รอเชื่อมต่อ ดาวน์โหลดช้า หรือผลตอบกลับแกว่ง | Latency, Bandwidth, Packet loss และบริการปลายทาง |
| Power/Cooling | จ่ายพลังงานและรักษาสภาวะให้ทุกชิ้นทำงานต่อเนื่อง | ลดความถี่ รีสตาร์ต หรือไม่เสถียรเมื่อโหลดต่อเนื่อง | อุณหภูมิ กำลังไฟ Airflow เสียง และสภาพแวดล้อม |
ตารางนี้ไม่ได้บอกให้เฝ้าดูเปอร์เซ็นต์ตัวเดียว แต่ช่วยตั้งคำถาม ตัวอย่างเช่น RAM ใช้มากไม่แปลว่าเป็นปัญหาเสมอ ระบบอาจใช้ RAM เป็น Cache อย่างมีประโยชน์ ในทางกลับกัน RAM ที่ดูยังเหลืออาจไม่ช่วยถ้าโปรแกรมต้องย้ายข้อมูลชุดใหญ่เข้าออก GPU ซ้ำ ๆ จึงต้องดูอาการของผู้ใช้ เวลาในแต่ละช่วง และความสัมพันธ์ของ Metric หลายตัว
คำว่า GPU ก็ไม่ใช่คำตอบอัตโนมัติสำหรับทุกงาน AI การเตรียมข้อความ การเรียกฐานข้อมูล การจัดคิว และตรรกะของบริการยังพึ่ง CPU กับระบบ I/O ส่วน GPU จะมีประโยชน์เมื่อส่วนคำนวณรองรับการทำงานขนานและ Software Stack ใช้งานอุปกรณ์นั้นได้จริง ฮาร์ดแวร์ที่ไม่มี Driver, Library หรือรูปแบบข้อมูลที่เหมาะสมอาจกลายเป็นทรัพยากรที่แพงแต่ถูกใช้ไม่เต็มที่
3. ตามเส้นทางข้อมูลหนึ่งคำขอ แล้วภาพทั้งระบบจะชัด
เมื่อผู้ใช้ถามผู้ช่วยของทีมอรุณ Network รับคำขอและส่งให้บริการ CPU ตรวจสิทธิ์และแยกคำ ระบบค้นอ่านดัชนีจาก Storage หรือ Cache ใน RAM จากนั้นนำข้อความที่เกี่ยวข้องมาประกอบเป็นบริบท หากใช้โมเดลบน GPU น้ำหนักโมเดลและข้อมูลที่ต้องคำนวณต้องอยู่ใน VRAM หรือถูกส่งเข้าไปอย่างเหมาะสม เมื่อได้ผล CPU อาจจัดรูปแบบ ตรวจ Guardrail และส่งคำตอบกลับ ส่วน Log และ Metric ถูกเขียนไว้เพื่อวิเคราะห์ภายหลัง
เส้นทางเดียวกันอาจเปลี่ยนตามสถาปัตยกรรม ถ้าใช้บริการ Cloud ภายนอก งานคำนวณหลักอาจไม่ได้อยู่ในเครื่องของทีม แต่ Latency ของ Network อัตราคำขอ และข้อจำกัดของบริการจะเข้ามาแทน ถ้าใช้โมเดลภายในเครื่อง ทีมต้องรับผิดชอบ Memory, Cooling, Power และการอัปเดต Software มากขึ้น ไม่มีทางเลือกใดดีที่สุดโดยไม่ผูกกับความเป็นส่วนตัว ปริมาณงาน เวลาตอบสนอง ความพร้อมใช้งาน และงบตลอดอายุ
Metrics ทำให้เส้นทางนี้เป็นวงจร ไม่ใช่ท่อทางเดียว ทีมต้องเก็บเวลาของแต่ละช่วงแทนการเก็บเพียงเวลารวม เพราะเวลารวมบอกว่า “ช้า” แต่ไม่บอกว่า “ช้าที่ไหน” การแยกเวลารอค้นเอกสาร เวลาเตรียมข้อมูล เวลาคำนวณ และเวลาส่งกลับ ทำให้สมมติฐานเรื่อง Bottleneck ตรวจสอบได้
4. Capacity, Bandwidth, Throughput และ Latency ต้องแยกให้ขาด
Capacity
พื้นที่หรือปริมาณที่รองรับได้ เช่น ข้อมูลที่เก็บได้ หรือ Working Set ที่อยู่ใน RAM/VRAM พร้อมกันได้
Bandwidth / Throughput
Bandwidth คือศักยภาพการขนส่ง ส่วน Throughput คือปริมาณที่ทำได้จริงภายใต้ภาระและข้อจำกัดทั้งหมด
Latency
เวลารอก่อนงานหรือคำขอหนึ่งจะเดินทางถึงผลลัพธ์ ผู้ใช้มักรับรู้คำนี้โดยตรงที่สุด
เปรียบเทียบง่าย ๆ Capacity คือขนาดโกดัง Bandwidth คือความกว้างของเส้นทางขนส่ง Throughput คือจำนวนกล่องที่ส่งถึงจริงต่อเวลา และ Latency คือเวลาที่กล่องหนึ่งใบใช้ตั้งแต่ออกจากต้นทางจนถึงปลายทาง โกดังใหญ่ไม่ได้ทำให้กล่องมาถึงเร็วขึ้น ถนนกว้างไม่ได้รับประกันว่าการเดินทางเที่ยวแรกจะเริ่มทันที และรถที่เร็วไม่ได้ช่วยเมื่อประตูคลังเปิดช้า
ในระบบทีมอรุณ ถ้าโมเดลและบริบทไม่พอดีใน VRAM ปัญหาแรกคือ Capacity แต่ถ้าพอดีแล้วและ GPU รอข้อมูลจากหน่วยความจำ ปัญหาอาจเป็น Bandwidth หรือรูปแบบการเข้าถึงข้อมูล ถ้าผู้ใช้ส่งคำถามทีละรายการและต้องรอการเชื่อมต่อบริการภายนอก ปัญหาอาจเป็น Latency แม้ Throughput รวมของระบบยังสูง การแก้ต้องตรงกับชนิดของข้อจำกัด
คำว่า “เร็วขึ้น” จึงต้องแปลงเป็น Metric ที่ชัด เช่น เวลาตอบสนองของคำขอหนึ่ง ปริมาณคำขอต่อเวลา เวลาทำงาน Batch ทั้งชุด หรือจำนวนงานที่ทำพร้อมกันโดยไม่เกินเกณฑ์ ผู้เรียนไม่จำเป็นต้องเลือก Metric จำนวนมาก แต่ต้องเลือก Metric ที่สะท้อนประสบการณ์ผู้ใช้และต้นทุนการปฏิบัติงาน
5. CPU กับ GPU: เลือกจากรูปแบบงานและการเคลื่อนย้ายข้อมูล
CPU เหมาะเมื่อ
- งานมีลำดับและตรรกะแตกแขนงมาก
- ต้องตอบสนองต่อเหตุการณ์หลายชนิด
- มีการควบคุม I/O, Service และระบบปฏิบัติการ
- Software ยังไม่ได้ออกแบบให้ใช้ GPU
GPU เหมาะเมื่อ
- งานคำนวณแบบเดียวกันซ้ำบนข้อมูลจำนวนมาก
- Library และโมเดลรองรับการเร่งด้วย GPU
- ข้อมูลจัดเป็น Batch หรือรูปแบบที่ใช้การขนานได้
- ประโยชน์จากการคำนวณมากกว่าต้นทุนการส่งข้อมูล
CPU และ GPU ทำงานร่วมกันมากกว่าทำหน้าที่แทนกัน CPU รับผิดชอบระบบโดยรวมและเตรียมงาน ส่วน GPU เร่งบางช่วงที่เหมาะกับการขนาน ในงาน AI จริง การส่งข้อมูลระหว่าง Host Memory กับ Device Memory มีต้นทุน จึงไม่ควรประเมินเฉพาะเวลาคำนวณ Kernel แล้วละเลยเวลาเตรียมและเคลื่อนย้ายข้อมูล เอกสารแนวปฏิบัติของ NVIDIA จึงเน้นการลดการส่งข้อมูลที่ไม่จำเป็นระหว่าง Host กับ Device
สำหรับทีมอรุณ การทดลองต้องแยกเวลาค้นเอกสาร เวลาประกอบบริบท เวลาโมเดลประมวลผล และเวลาส่งผล หากโมเดลกินเวลาส่วนใหญ่และงานรองรับ GPU การเร่งส่วนนั้นอาจคุ้มค่า แต่ถ้าการค้นเอกสารหรือ Network เป็นส่วนที่ผู้ใช้รอนาน การเปลี่ยน GPU จะไม่แตะคอขวดหลัก และอาจเพิ่มค่าไฟ ความร้อน และภาระดูแลโดยไม่เปลี่ยน Service Goal
อีกประเด็นคือความเข้ากันได้ ต้องตรวจระบบปฏิบัติการ Driver, Runtime, Framework, รุ่น Library และรูปแบบตัวเลขที่โมเดลรองรับก่อนซื้อ การเห็นว่าซอฟต์แวร์ “รองรับ GPU” ไม่ได้หมายความว่าอุปกรณ์ทุกแบบให้ผลเหมือนกัน การทำ Pilot บนงานจริงจึงน่าเชื่อถือกว่าการเทียบชื่อรุ่นจากตารางเพียงอย่างเดียว
6. Working Set และลำดับชั้นหน่วยความจำ: สิ่งที่กำลังใช้ต้องอยู่ใกล้จุดคำนวณ
Working Set คือชุดข้อมูล โค้ด และสถานะที่งานต้องใช้ในช่วงหนึ่ง ไม่เท่ากับขนาดไฟล์ทั้งหมดบน Storage เสมอไป งานอาจมีเอกสารจำนวนมากแต่ใช้ดัชนีเพียงบางส่วนต่อคำขอ หรือมีโมเดลขนาดหนึ่งแต่ต้องเผื่อพื้นที่สำหรับบริบท Cache และข้อมูลชั่วคราว การวางแผน Capacity จึงต้องดูสิ่งที่อยู่พร้อมกันเมื่อโหลดจริง ไม่ใช่บวกขนาดไฟล์แบบหยาบเพียงอย่างเดียว
หน่วยความจำมีลำดับชั้น ตั้งแต่พื้นที่ใกล้หน่วยคำนวณที่เร็วแต่มีจำกัด ไปจนถึง Storage ที่จุมากกว่าแต่เข้าถึงช้ากว่า ระบบพยายามย้ายข้อมูลที่คาดว่าจะใช้เข้ามาใกล้ CPU หรือ GPU หาก Working Set ใหญ่เกินพื้นที่ ระบบอาจสลับข้อมูลบ่อย เกิดการรอ หรือปิดงานเพราะหน่วยความจำไม่พอ อาการเหล่านี้ต้องดูร่วมกับ Log และ Metric ไม่ใช่ตัดสินจากเปอร์เซ็นต์เดียว
ทีมอรุณอาจลด Working Set ก่อนเพิ่มฮาร์ดแวร์ เช่น โหลดเฉพาะส่วนที่ต้องใช้ ลดข้อมูลซ้ำ แบ่งงานเป็นช่วง ใช้ Cache อย่างมีขอบเขต หรือลดขนาดโมเดลเมื่อคุณภาพยังผ่านเกณฑ์ การปรับซอฟต์แวร์อาจคืน Capacity และลด Bandwidth ได้พร้อมกัน แต่ต้องทดสอบผลต่อความถูกต้อง ความสดของข้อมูล และความซับซ้อนในการดูแล
7. หา Bottleneck จากหลักฐาน: กรณีศึกษาทีมอรุณ
ทีมอรุณได้รับคำบอกว่า “ระบบตอบช้า” แต่ไม่เริ่มจากการซื้อของ ทีมกำหนดเหตุการณ์ที่ทำซ้ำได้ก่อน: ใช้เอกสารชุดเดิม คำถามประเภทเดิม จำนวนผู้ใช้ใกล้เคียงกัน และบันทึกเวลาตั้งแต่รับคำขอจนส่งคำตอบ จากนั้นแยกช่วงค้นข้อมูล เตรียมบริบท คำนวณ และส่งออกเพื่อให้เห็นว่าความล่าช้าเกิดที่ใด
- นิยามอาการ: ใครรอ งานใดช้า เกิดเมื่อไร และส่งผลต่ออะไร
- สร้าง Baseline: บันทึกเวลารวม เวลารายช่วง ปริมาณงาน และข้อผิดพลาดภายใต้เงื่อนไขเดียวกัน
- ตั้งสมมติฐาน: เช่น Storage อ่านดัชนีไม่ทัน RAM ไม่พอ CPU เตรียมข้อมูลช้า GPU รอข้อมูล หรือ Network แกว่ง
- เปลี่ยนทีละตัวแปร: ลดขนาดข้อมูล อุ่น Cache เปลี่ยน Batch หรือย้ายเฉพาะช่วงทดลอง โดยคงเงื่อนไขอื่นให้ใกล้เดิม
- ตรวจว่าคอขวดย้ายหรือไม่: เมื่อแก้จุดหนึ่ง จุดอื่นอาจกลายเป็นข้อจำกัดใหม่ ต้องวัดทั้งระบบอีกครั้ง
ถ้าอุ่น Cache แล้วช่วงค้นเร็วขึ้น แต่เวลารวมแทบไม่เปลี่ยน สมมติฐานว่า Storage เป็นคอขวดหลักอาจไม่ผ่าน ถ้าลดขนาดบริบทแล้วเวลาคำนวณลดโดยคุณภาพยังผ่าน Guardrail ทีมได้ทางเลือกซอฟต์แวร์ก่อนลงทุน ถ้าเพิ่มงานพร้อมกันแล้ว Latency พุ่งและ Queue สะสม ทีมต้องพิจารณา Throughput, การจัดคิว หรือการขยายระบบ ไม่ใช่ดูเวลาของคำขอเดี่ยวอย่างเดียว
Utilization สูงไม่ใช่ความเสียหายโดยตัวมันเอง ทรัพยากรที่ซื้อมาเพื่อทำงานควรถูกใช้ แต่ถ้า Utilization สูงพร้อม Queue ยาว Latency เกินเกณฑ์ และข้อผิดพลาดเพิ่ม นั่นคือหลักฐานว่าทรัพยากรหรือการออกแบบไม่รองรับโหลด ส่วน Utilization ต่ำก็ไม่ได้หมายว่าเหลือเสมอ งานอาจติด Lock รอ I/O หรือถูกจำกัดด้วย Thread และ Software
8. เลือกฮาร์ดแวร์จาก Service Goal และอ่าน Trade-off ทั้งระบบ
Service Goal แปลงคำว่า “เร็วพอ” ให้เป็นเงื่อนไขตัดสินใจ เช่น ผู้ใช้ควรได้รับผลภายในช่วงเวลาที่องค์กรยอมรับ งาน Batch ต้องเสร็จก่อนรอบถัดไป ระบบต้องรองรับจำนวนคำขอที่คาดโดยไม่ทำให้ Error เพิ่ม และเมื่อชิ้นส่วนล้มเหลวต้องกู้คืนได้ภายในขอบเขตที่กำหนด เป้าหมายเหล่านี้ต้องมาจากบริบทงาน ไม่ควรคัดลอกตัวเลขขององค์กรอื่น
| ทางเลือก | ประโยชน์ที่คาด | ต้นทุน/ข้อแลกเปลี่ยน | หลักฐานก่อนตัดสินใจ |
|---|---|---|---|
| ปรับ Software/Data Flow | ลดงานซ้ำ ลด Working Set หรือ Transfer | เวลาออกแบบ ทดสอบ และดูแลความซับซ้อน | Profiling ชี้ช่วงที่ปรับได้และคุณภาพยังผ่าน |
| เพิ่ม RAM/VRAM | รองรับ Working Set หรือ Concurrent Work มากขึ้น | ราคา พลังงาน และข้อจำกัดของ Platform | หลักฐานการสลับข้อมูล OOM หรือ Capacity ไม่พอ |
| เปลี่ยน CPU/GPU | เพิ่มกำลังคำนวณในช่วงที่เหมาะ | Compatibility, Cooling, Power และ Software Stack | เวลาส่วนคำนวณเป็นคอขวดและ Pilot แสดงผล |
| เปลี่ยน Storage/Network | ลดเวลารอ I/O หรือบริการภายนอก | Migration, Reliability, Security และค่าใช้ต่อเนื่อง | Trace/Queue/Latency ชี้การรอในเส้นทางนั้น |
| ใช้ Cloud/Managed Service | ทดลองและปรับขนาดได้โดยไม่ซื้อทันที | ค่าใช้ตามปริมาณ Network, Lock-in และข้อมูล | ประมาณโหลด ข้อกำกับ และแผนหยุด/ย้ายออก |
อย่าประเมินราคาซื้ออย่างเดียว ต้องรวม Power, Cooling, พื้นที่ การรับประกัน เวลาผู้ดูแล Software License ค่า Network การสำรอง และค่าเสียโอกาสเมื่อระบบหยุด ฮาร์ดแวร์ที่ราคาต่อหน่วยสูงกว่าอาจคุ้มถ้าลดเวลางานสำคัญและลดภาระดูแล แต่ก็อาจไม่คุ้มถ้างานเกิดเป็นครั้งคราวหรือใช้บริการตามต้องการได้
การซื้อเผื่อมีทั้งประโยชน์และต้นทุน Capacity สำรองช่วยรับการเติบโตและเหตุผิดปกติ แต่การเผื่อจากความกลัวโดยไม่มี Scenario อาจทำให้เงินถูกล็อกกับเทคโนโลยีที่เสื่อมมูลค่าเร็ว ทีมอรุณจึงกำหนดช่วงโหลดที่ต้องรองรับ สัญญาณที่จะขยาย และทางเลือกเมื่อการใช้งานต่ำกว่าคาด ก่อนอนุมัติการลงทุน
9. Power, Cooling และความต่อเนื่อง: ประสิทธิภาพต้องอยู่ได้นานกว่าการทดสอบสั้น
ผลทดสอบช่วงสั้นอาจไม่สะท้อนการทำงานต่อเนื่อง เมื่ออุณหภูมิสูง ระบบสามารถลดความถี่เพื่อควบคุมความร้อน ทำให้ Throughput ลดหรือ Latency แกว่ง เอกสารฮาร์ดแวร์ของ Raspberry Pi แสดงตัวอย่างการจัดการอุณหภูมิและการลดความถี่ ซึ่งเตือนให้เราแยก “แรงในช่วงสั้น” ออกจาก “รักษาผลงานได้ต่อเนื่อง” แม้เครื่องของเราจะเป็น Platform อื่น หลักการวัดภายใต้โหลดต่อเนื่องยังใช้ได้
Power Supply และสายไฟที่ไม่เหมาะสมอาจทำให้เครื่องไม่เสถียร อุปกรณ์ Storage เสียหาย หรือ Peripheral ทำงานผิดปกติ การออกแบบจึงต้องดู Peak Load, อุปกรณ์ต่อพ่วง และ Margin ตามข้อกำหนดผู้ผลิต ห้ามเดาค่ากำลังไฟหรือดัดแปลงระบบโดยไม่มีผู้เชี่ยวชาญ โดยเฉพาะเครื่องที่ติดตั้งในพื้นที่ใช้งานจริง
ความต่อเนื่องยังรวมการสำรองข้อมูล การตรวจสุขภาพ Storage การอัปเดต Driver การเก็บ Log และแผนกู้คืน ถ้าระบบทีมอรุณต้องให้บริการคนจำนวนมาก การมีเครื่องแรงเพียงเครื่องเดียวอาจสร้าง Single Point of Failure การตัดสินใจจึงต้องพิจารณาว่าจะหยุดได้หรือไม่ กู้คืนอย่างไร และใครมีอำนาจตัดการทำงานเมื่ออุณหภูมิหรือความผิดพลาดเกิน Guardrail
10. Failure Cases: อาการเดียวกันอาจมาจากคนละชั้น
ซื้อ GPU แล้วระบบยังช้า
สาเหตุที่เป็นไปได้: งานติด Network, Storage, CPU หรือ Transfer ไม่ได้ติดการคำนวณ GPU
การตรวจ: แยกเวลารายช่วงและดู Queue ก่อน–หลัง
RAM มากแต่โปรแกรมยังค้าง
สาเหตุที่เป็นไปได้: Memory leak, Lock, Thread หรือ I/O ไม่ใช่ Capacity
การตรวจ: ดูแนวโน้มราย Process, Page/Swap, Log และเหตุการณ์ก่อนค้าง
ทดสอบเร็ว แต่ของจริงแกว่ง
สาเหตุที่เป็นไปได้: โหลดพร้อมกัน Cache อุณหภูมิ หรือบริการปลายทางต่างจาก Pilot
การตรวจ: ทดสอบโหลดต่อเนื่องและเงื่อนไขใกล้ของจริง
เปอร์เซ็นต์ต่ำแต่ผู้ใช้รอนาน
สาเหตุที่เป็นไปได้: งานรอ I/O, Lock, Queue ภายนอก หรือใช้ทรัพยากรได้ไม่ครบ
การตรวจ: Trace เวลารอ ไม่อาศัย Utilization เพียงตัวเดียว
อีก Failure Case คือการวัดผิดบริบท เช่น ทดสอบด้วยข้อมูลเล็กกว่าของจริง ใช้ Cache ที่อุ่นแล้วตลอด ไม่มีผู้ใช้พร้อมกัน หรือไม่รวมเวลาการตรวจสิทธิ์และเขียน Log ผลที่ได้อาจถูกต้องในห้องทดลองแต่ไม่ตอบคำถามการใช้งานจริง วิธีป้องกันคือระบุ Test Envelope ให้ชัดว่าข้อมูล โหลด ระยะเวลา และ Software Version ใดอยู่ในขอบเขต
ความเสี่ยงด้านข้อมูลก็เกี่ยวกับฮาร์ดแวร์ หากทีมคัดลอกเอกสารจริงไปทดสอบบนเครื่องส่วนตัวหรือบริการที่ไม่ได้รับอนุมัติ ประสิทธิภาพที่ดีขึ้นอาจแลกกับการรั่วไหลของข้อมูล การทดลองต้องใช้ข้อมูลที่ได้รับอนุญาต ลดข้อมูลส่วนบุคคล กำหนดสิทธิ์ และมีแผนลบข้อมูลทดสอบ ฮาร์ดแวร์ไม่ใช่ข้ออ้างให้ข้าม Governance
อ่าน Storage จากรูปแบบการเข้าถึง ไม่ใช่ดูคำว่าเร็วเพียงคำเดียว
งานอ่านไฟล์ขนาดใหญ่ต่อเนื่อง งานอ่านไฟล์เล็กจำนวนมาก งานเขียน Log และงานฐานข้อมูลสร้างภาระต่างกัน อุปกรณ์ที่ให้ Throughput สูงกับไฟล์ต่อเนื่องอาจไม่ได้ลด Latency ของการเข้าถึงแบบสุ่มตามสัดส่วนเดียวกัน ทีมต้องบันทึกขนาดคำขอ รูปแบบอ่านหรือเขียน Queue และสัดส่วน Cache Hit ก่อนสรุปว่า Storage เป็นคอขวด การย้ายข้อมูลไปอุปกรณ์ใหม่โดยไม่เข้าใจ Access Pattern อาจย้ายปัญหาแต่ไม่แก้เหตุ
ความจุที่เหลือก็มีความหมายต่อการปฏิบัติงาน พื้นที่เต็มอาจทำให้ Log เขียนไม่ได้ การอัปเดตล้มเหลว หรือระบบสำรองไม่มีที่ทำงาน แต่การซื้อ Capacity มากไม่ได้แก้การเข้าถึงช้าโดยอัตโนมัติ Hardware Decision Brief จึงต้องแยกพื้นที่ที่ต้องเก็บ ระยะเวลาการเก็บ รูปแบบเข้าถึง และแผนสำรองออกจากกัน
Network เป็นส่วนหนึ่งของเครื่องเมื่อระบบพึ่งบริการอื่น
แม้ CPU, RAM และ GPU อยู่ในเครื่องเดียวกัน งานสมัยใหม่ยังดึงข้อมูลจากฐานข้อมูลกลาง Object Storage, API หรือบริการโมเดลภายนอก Latency ของ DNS การเชื่อมต่อ การเข้ารหัส การส่งคำขอ และบริการปลายทางรวมกันเป็นเวลาที่ผู้ใช้รอ การวัดเพียงอัตรารับส่งสูงสุดของ Network Adapter จึงไม่พอ ต้อง Trace ขอบเขตระหว่างเครื่องและแยกว่าเวลาหายไปก่อนส่ง ระหว่างส่ง หรือหลังปลายทางรับคำขอ
การแก้ Network อาจเป็นการลดจำนวนรอบ รวมคำขอ ใช้ Cache ที่ปลอดภัย ย้ายข้อมูลให้ใกล้จุดคำนวณ หรือปรับ Timeout และ Retry ไม่ใช่เพิ่ม Bandwidth เสมอ Retry ที่ไม่มี Backoff อาจทำให้บริการที่เริ่มช้าได้รับโหลดซ้ำจนแย่ลง การออกแบบต้องมีขีดจำกัดและให้มนุษย์มองเห็นเมื่อระบบภายนอกผิดปกติ
Concurrency, Queue และ Backpressure
เมื่อมีงานเข้ามาเร็วกว่าที่ระบบทำเสร็จ Queue จะยาวขึ้น แม้ Throughput ช่วงสั้นดูสูง Latency ของงานที่รอจะเพิ่มและ Memory อาจถูกใช้เก็บสถานะมากขึ้น การเพิ่มผู้ใช้พร้อมกันจึงไม่ใช่เพียงคูณสเปกต่อคน ระบบต้องกำหนดจำนวนงานพร้อมกัน ขนาด Queue เงื่อนไขปฏิเสธหรือชะลอ และข้อความที่แจ้งผู้ใช้เมื่อเกินขีดจำกัด
Backpressure คือการส่งสัญญาณให้ต้นทางลดอัตราเมื่อปลายทางรับไม่ไหว หากไม่มีระบบนี้ งานอาจสะสมจนทุกคำขอล้มพร้อมกัน ทีมอรุณสามารถจำกัดงานพร้อมกัน จัดลำดับความสำคัญ และส่งต่อมนุษย์ในช่วงผิดปกติ การจัดคิวที่ดีบางครั้งให้ผลต่อความน่าเชื่อถือมากกว่าการเพิ่มชิ้นส่วน เพราะป้องกันโหลดพุ่งจากการทำลายบริการทั้งหมด
Observability ต้องเชื่อม Metric, Log และ Trace
Metric ช่วยเห็นแนวโน้มและสัญญาณกว้าง Log ช่วยอ่านเหตุการณ์และข้อผิดพลาด ส่วน Trace ช่วยตามคำขอผ่านหลายช่วง ทั้งสามอย่างตอบคำถามต่างกัน การมีกราฟ CPU อย่างเดียวไม่พอจะเชื่อมกับคำถามของผู้ใช้ และการมี Log จำนวนมากโดยไม่มี Request ID ก็ยากต่อการต่อเหตุการณ์ การออกแบบการวัดควรเริ่มพร้อม Data Path ไม่ใช่รอให้ระบบช้าแล้วค่อยเติม
Observability มีต้นทุน การเก็บละเอียดเกินไปใช้ Storage, Network และเวลาในการวิเคราะห์ อีกทั้ง Log อาจมีข้อมูลอ่อนไหว ทีมต้องเลือก Sampling, ระยะเวลาเก็บ การปกปิดข้อมูล และสิทธิ์เข้าถึงให้เหมาะสม เป้าหมายคือหลักฐานเพียงพอสำหรับตัดสิน ไม่ใช่เก็บทุกอย่างโดยไม่รู้ว่าจะใช้ตอบคำถามใด
Benchmark ภายนอกเป็นจุดเริ่ม ไม่ใช่คำตัดสิน
ผล Benchmark จากผู้ผลิตหรือผู้ทดสอบช่วยจำกัดตัวเลือก แต่ต่างจากงานจริงได้ทั้ง Software Version, Driver, Precision, Batch, Dataset, Cooling และ Power Limit การเปรียบเทียบต้องอ่านวิธีทดสอบและดูว่า Metric ตรงกับ Service Goal หรือไม่ ห้ามนำคะแนนสังเคราะห์หนึ่งค่ามาแทน Latency, Throughput, Memory และความเสถียรทั้งหมด
ทีมอรุณใช้ Benchmark ภายนอกเพื่อเลือกอุปกรณ์มาทดลอง แต่ใช้ Pilot ภายในเพื่ออนุมัติการตัดสินใจ ชุดทดสอบต้องมี Golden Cases, โหลดที่คาด และกรณีหนักที่สมเหตุผล พร้อมบันทึก Configuration เพื่อทำซ้ำ หากผลดีขึ้นเฉพาะเมื่อปิด Guardrail หรือใช้ข้อมูลเล็กกว่าจริง ผลนั้นไม่ผ่านเกณฑ์นำไปใช้
การตัดสินใจต้องมีเจ้าของและรอบทบทวน
ผู้เสนอซื้อ ผู้ดูแลระบบ ผู้ใช้ เจ้าของข้อมูล และผู้อนุมัติงบมองความสำเร็จต่างกัน ผู้เสนออาจสนใจความเร็ว ผู้ดูแลสนใจเสถียรภาพ เจ้าของข้อมูลสนใจสิทธิ์และความเสี่ยง ส่วนผู้ใช้สนใจเวลารอกับคุณภาพ การตัดสินใจที่ดีต้องบันทึกว่าใครรับผิดชอบ Metric ใครอนุมัติ Pilot และใครมีอำนาจ Rollback เมื่อผลจริงไม่ตรงสมมติฐาน
หลังนำไปใช้ต้องกำหนดรอบทบทวน เพราะโหลด Software และราคาบริการเปลี่ยนได้ การตัดสินใจที่เคยคุ้มอาจไม่คุ้มตลอดไป ทีมควรตรวจ Service Goal, Error, Utilization, ค่าใช้ และเหตุขัดข้อง พร้อมเกณฑ์ว่าจะปรับ ลดขนาด ขยาย หรือเลิกใช้เมื่อใด ฮาร์ดแวร์จึงเป็นวงจรบริหารสินทรัพย์ ไม่ใช่การซื้อครั้งเดียวแล้วจบ
11. Worksheet: เขียน Hardware Decision Brief หนึ่งหน้า
เลือกงานจริงหนึ่งงาน เช่น เปิดวิดีโอ บีบอัดไฟล์ ประมวลผลตาราง หรือรันโมเดลเล็ก แล้วกรอกหัวข้อต่อไปนี้ ห้ามเริ่มจากชื่อรุ่นที่อยากซื้อ
เกณฑ์สำเร็จ
- แผนที่มี Input, Storage, Memory, Compute, Output และ Metrics ครบ
- แยก Capacity, Throughput และ Latency ได้ ไม่ใช้คำว่า “เร็วขึ้น” ลอย ๆ
- สมมติฐานเชื่อมกับหลักฐานและมีวิธีหักล้าง
- ทางเลือกมีต้นทุน ความเสี่ยง และ Rollback ไม่ใช่มีแต่ประโยชน์
- สรุปได้ว่าควรทำอะไรต่อ แม้คำตอบจะเป็น “ยังไม่ซื้อ”
12. แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่ดีที่สุดให้ครบ แล้วกด “ตรวจคำตอบ” เพียงครั้งเดียว
13. สรุปและภาพจำ: ประสิทธิภาพเกิดจากเส้นทาง ไม่ใช่ชิ้นส่วนเดียว
เริ่มที่ Input ตามข้อมูลผ่าน Storage และ Memory ไปยัง CPU/GPU แล้วตรวจ Output กับ Metrics แยก Capacity ว่าใส่ได้เท่าไร Bandwidth/Throughput ว่าขนหรือทำได้เท่าไร และ Latency ว่าต้องรอนานเท่าไร เมื่อระบบช้า ให้สร้าง Baseline ตั้งสมมติฐาน เปลี่ยนทีละตัวแปร และดูว่าคอขวดย้ายหรือไม่
เรียนต่ออย่างมีทิศทาง
บทนี้วางภาพรวมของระบบฮาร์ดแวร์ บทถัดไปจะเจาะลึกว่า CPU รับคำสั่ง จัดลำดับ และประมวลผลงานทั่วไปอย่างไร
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงหลักและขอบเขต
- Intel — CPU vs. GPU: What’s the Difference?
- NVIDIA — CUDA C++ Best Practices Guide
- Microsoft Support — System configuration tools and Task Manager
- Microsoft Learn — Performance Monitor
- Linux Kernel Documentation — Pressure Stall Information
- Raspberry Pi — Computer hardware, thermal control and power
- AWS — Choosing a storage service: latency, throughput and access patterns
ขอบเขต: บทนี้สอน Mental Model และวิธีวัด ไม่แนะนำยี่ห้อ รุ่น ค่า Threshold หรือขนาดสเปกตายตัว เพราะคำตอบขึ้นกับงาน Software, Driver, ข้อมูล โหลด และ Service Goal ควรตรวจเอกสารของผู้ผลิตและทดสอบกับระบบจริงก่อนตัดสินใจ
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 10 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 30 · PATH 01 · เนื้อหาเพื่อการศึกษา
