ความรู้ก่อนเรียน: ควรรู้ว่า CPU ทำหน้าที่ประมวลผลคำสั่ง และ Storage ใช้เก็บไฟล์ระยะยาว หากยังไม่คุ้น ให้ทบทวนบทเรียนหัวข้อ 31 ก่อน
PATH 01 · พื้นฐานดิจิทัล คอมพิวเตอร์ และภาพรวม AI
RAM คืออะไร: โต๊ะทำงานของโปรแกรมที่ความจุและความเร็วต้องพอดี
คุณเปิดเบราว์เซอร์หลายแท็บ เอกสารขนาดใหญ่ และโมเดล AI ในเครื่องพร้อมกัน ช่วงแรกทุกอย่างยังลื่น แต่เมื่อโหลดไฟล์ชุดใหม่ เครื่องเริ่มหน่วง เสียงพัดลมดัง การสลับหน้าต่างใช้เวลานาน และโปรแกรมอาจปิดตัวเอง คำอธิบายว่า “RAM เต็ม” ฟังดูง่าย ทว่าสิ่งที่เกิดขึ้นจริงไม่ใช่แค่ตัวเลขเปอร์เซ็นต์ขึ้นสูง ระบบกำลังตัดสินใจตลอดเวลาว่าข้อมูลใดควรอยู่ใกล้หน่วยประมวลผล ข้อมูลใดพักไว้ได้ และข้อมูลใดต้องย้ายกลับไปยัง Storage
คำตอบสั้น: RAM คือพื้นที่ทำงานชั่วคราวที่ระบบใช้เก็บโค้ดและข้อมูลซึ่งกำลังถูกใช้งาน เพื่อให้ CPU เข้าถึงได้เร็วกว่าอ่านจาก Storage ความจุของ RAM บอกว่างานอยู่พร้อมกันได้มากเพียงใด ส่วน Bandwidth และ Latency บอกว่าข้อมูลเดินได้มากและต้องรอนานแค่ไหน การมี RAM มากจึงช่วยชัดเจนเมื่อของเดิมไม่พอ แต่ไม่ได้เร่งทุกงานโดยอัตโนมัติ
ภาพจำเริ่มต้นคือโต๊ะทำงาน: Storage เป็นตู้เอกสาร RAM เป็นโต๊ะกว้าง Cache เป็นถาดเล็กข้างมือ และ CPU เป็นคนทำงาน โต๊ะใหญ่ขึ้นช่วยลดการเดินไปตู้ แต่ไม่ได้ทำให้คนคิดหรือขนเอกสารเร็วขึ้นเอง
อ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบายเส้นทางข้อมูลจาก Storage ผ่าน RAM และ Cache ไปยัง CPU ได้ด้วยภาษาของตนเอง
- แยก Capacity, Bandwidth, Latency, Channel และ Timing ได้โดยไม่ใช้คำว่า “ความเร็ว RAM” รวมทุกอย่างเข้าด้วยกัน
- ติดตาม Virtual Address, Page, Working Set, Memory Pressure และ Swap ในระดับแนวคิดได้
- วิเคราะห์กรณีเครื่องช้าจากงาน AI โดยแยกอาการ RAM ไม่พอออกจากคอขวด CPU, GPU และ Storage ได้
- วัด Peak Working Set และใช้ Checklist เลือก RAM โดยคำนึงถึง Headroom, Compatibility, ECC และทางขยายได้
MENTAL MODEL
RAM คือพื้นที่ทำงาน ไม่ใช่โกดังถาวรและไม่ใช่คะแนนความเร็ว
เมื่อเราเปิดโปรแกรม ระบบปฏิบัติการไม่สั่งให้ CPU อ่านทุกอย่างจาก SSD หรือ HDD ซ้ำทุกครั้ง ส่วนของโปรแกรมและข้อมูลที่จำเป็นถูกนำเข้ามาอยู่ใน RAM ก่อน เพราะหน่วยประมวลผลต้องการแหล่งข้อมูลที่ตอบสนองเร็วและเข้าถึงตำแหน่งต่าง ๆ ได้โดยตรง คำว่า Random Access ในชื่อ Random Access Memory ชี้ว่าการเข้าถึงตำแหน่งหนึ่งไม่ต้องไล่อ่านทุกตำแหน่งที่มาก่อนเหมือนสื่อแบบลำดับ แต่ไม่ได้แปลว่าทุกตำแหน่งตอบสนองด้วยเวลาเท่ากันในระบบจริง
RAM ส่วนใหญ่ในคอมพิวเตอร์ทั่วไปเป็น DRAM ซึ่งต้องใช้ไฟเลี้ยงและรีเฟรชสถานะอย่างต่อเนื่อง เมื่อปิดเครื่อง ข้อมูลที่เก็บอยู่จึงหายไป คุณสมบัตินี้เรียกว่า Volatile Memory ตรงข้ามกับ Storage ที่ออกแบบมาเก็บไฟล์ระยะยาว การบันทึกเอกสารจึงเป็นการส่งข้อมูลจากพื้นที่ทำงานกลับไปยังสื่อเก็บถาวร หากไฟดับก่อนบันทึก สำเนาที่มีอยู่เฉพาะใน RAM อาจสูญหายได้
อุปมาโต๊ะทำงานช่วยเปิดประตู แต่มีขอบเขต โต๊ะจริงไม่มีระบบแปลงที่อยู่ ไม่มี Page Table และไม่เคลื่อนเอกสารระหว่างระดับด้วยนโยบายของระบบปฏิบัติการ RAM ก็ไม่ได้ “รู้” ว่าไฟล์ใดสำคัญ ตัวระบบปฏิบัติการ โปรแกรม Memory Controller และฮาร์ดแวร์ร่วมกันจัดสรรพื้นที่และเคลื่อนข้อมูล ภาพโต๊ะจึงเหมาะกับการแยกความจุจากความเร็ว แต่เมื่อวิเคราะห์อาการจริง เราต้องใช้แบบจำลอง Page, Working Set และเส้นทางข้อมูลที่แม่นกว่า
CONTENTS
ใน RAM ไม่ได้มีแค่ “โปรแกรมที่เปิดอยู่”
พื้นที่ RAM ของระบบถูกใช้โดยหลายส่วนพร้อมกัน ตัวโปรแกรมมีโค้ดที่ใช้รันและข้อมูลที่สร้างขึ้น Stack เก็บสถานะการเรียกฟังก์ชันและตัวแปรบางชนิด Heap รองรับข้อมูลที่โปรแกรมขอเพิ่มระหว่างทำงาน Buffer ช่วยพักข้อมูลระหว่างส่วนที่ผลิตและบริโภคด้วยความเร็วต่างกัน ส่วนระบบปฏิบัติการใช้หน่วยความจำกับ Kernel, Driver, ตารางจัดการ Page และบริการเบื้องหลัง จึงไม่ควรนำขนาดไฟล์โปรแกรมมาบวกกันแล้วคาดว่าจะได้ปริมาณ RAM ที่ใช้จริง
ระบบยังใช้ RAM ที่ว่างเป็น File Cache เพื่อเก็บข้อมูลจาก Storage ซึ่งมีโอกาสถูกใช้ซ้ำ การเห็น RAM ถูกใช้มากจึงไม่ใช่ข่าวร้ายเสมอไป Cache ช่วยให้เปิดไฟล์หรือโปรแกรมเดิมเร็วขึ้น และมักคืนพื้นที่ได้เมื่อแอปต้องการ สิ่งที่ควรถามไม่ใช่เพียง “ใช้กี่เปอร์เซ็นต์” แต่คือมีพื้นที่ที่เรียกคืนได้หรือไม่ ระบบกำลังย้าย Page บ่อยเพียงใด และ Latency ของงานเพิ่มขึ้นหรือยัง
Shared Memory ทำให้หลาย Process หรือหลายส่วนของระบบอ้างข้อมูลชุดเดียวกันได้ ขณะที่ Memory-mapped File เปิดทางให้โปรแกรมมองไฟล์เป็นช่วง Address และให้ระบบนำ Page ที่จำเป็นเข้ามาตามการใช้งาน รายการในเครื่องมือตรวจระบบจึงอาจนับหน่วยความจำต่างกัน เช่น Private, Shared, Cached, Committed และ Resident หากไม่รู้คำนิยามของ Metric นั้น เราอาจบวกซ้ำหรือสรุปว่าโปรแกรมหนึ่งใช้ RAM มากเกินจริง
DATA PATH
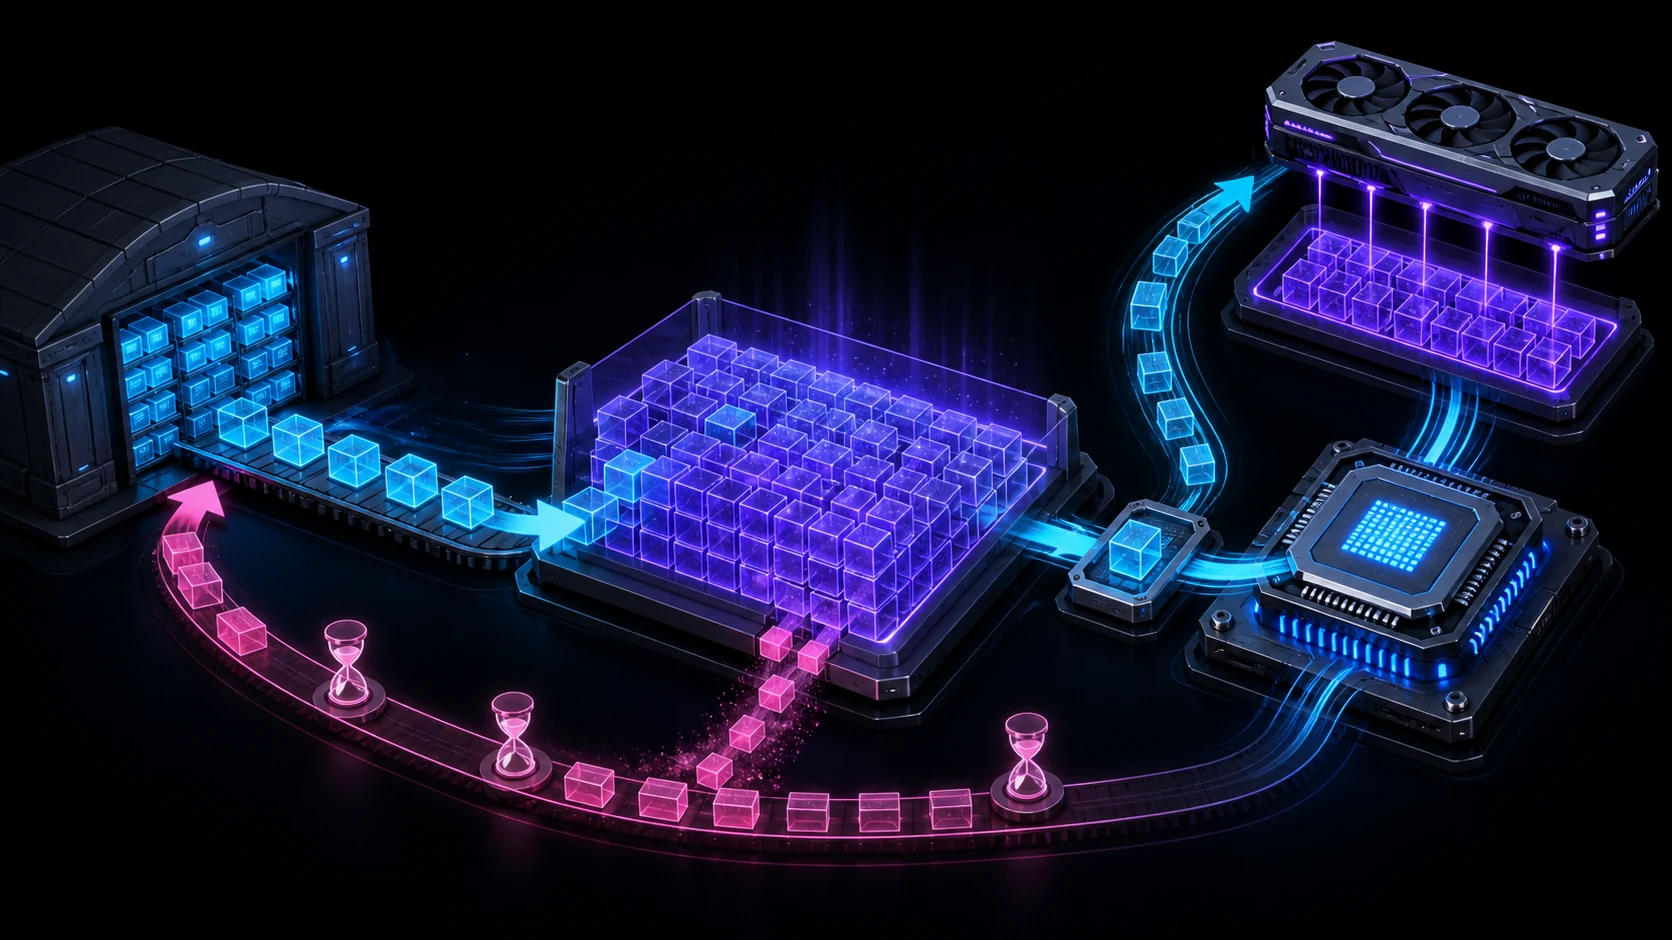
ข้อมูลเดินจาก Storage เข้า RAM แล้วจึงเข้าใกล้ CPU
ลองตามเหตุการณ์เปิดไฟล์ PDF ในกรณีศึกษาของเรา ไฟล์เริ่มอยู่บน SSD ระบบไฟล์ค้นหาตำแหน่งและอ่านข้อมูลเข้ามา ระบบปฏิบัติการวางข้อมูลใน Page ของหน่วยความจำ แอปแยกโครงสร้าง PDF และสร้างวัตถุใหม่ในพื้นที่ของ Process เมื่อ CPU ต้องใช้ข้อมูล มันตรวจระดับ Cache ก่อน หากไม่พบจึงเกิด Cache Miss และคำขอเดินออกไปยัง Memory Controller เพื่ออ่านจาก DRAM ผลลัพธ์ถูกส่งกลับผ่าน Cache Line เข้าสู่ Cache และ Register ที่หน่วยคำนวณใช้ได้
แต่ละช่วงตอบโจทย์ต่างกัน Storage ให้ความคงทนและความจุ RAM ให้ Working Space ที่ใหญ่กว่า Cache มาก Cache ลดเวลารอของข้อมูลที่ใช้บ่อย และ Register เก็บค่าที่หน่วยคำนวณต้องใช้ทันที การเพิ่มความจุระดับหนึ่งไม่สามารถชดเชยข้อจำกัดของอีกระดับทั้งหมดได้ SSD ที่เร็วช่วยลดเวลาโหลดและ Page-in แต่ยังช้ากว่า DRAM มากในแง่ Latency ส่วน RAM ขนาดใหญ่ไม่ช่วยหากอัลกอริทึมใช้ Cache ได้แย่และ CPU รอข้อมูลกระจัดกระจาย
รูปแบบการเข้าถึงสำคัญพอ ๆ กับปริมาณ หากโปรแกรมอ่านข้อมูลต่อเนื่อง ฮาร์ดแวร์และระบบสามารถ Prefetch หรือรวมการขนส่งได้ง่าย งานที่กระโดดไปมาอาจใช้ Bandwidth รวมไม่สูงแต่เสียเวลารอแต่ละคำขอมาก โครงสร้างข้อมูลเดียวกันเมื่อจัดเรียงใหม่จึงเร็วขึ้นได้โดยไม่เพิ่ม RAM เพราะทำให้ Cache Line ที่ถูกดึงมาใช้ประโยชน์มากขึ้น
ADDRESS AND PAGE
โปรแกรมเห็น Virtual Address ส่วนระบบจัดการ Physical Memory
โปรแกรมทั่วไปไม่ได้ถือหมายเลขตำแหน่งชิป RAM โดยตรง แต่ทำงานใน Virtual Address Space ของตน แนวคิดนี้ช่วยแยก Process ออกจากกัน ทำให้แต่ละโปรแกรมมีมุมมอง Address ที่เป็นระเบียบ และเปิดทางให้ระบบย้ายหรือแชร์ Page ได้โดยไม่ต้องให้โปรแกรมรู้รายละเอียดทุกครั้ง ตาราง Page และหน่วยแปลที่อยู่ของฮาร์ดแวร์เชื่อม Virtual Address ไปยัง Physical Page Frame ที่อยู่ใน RAM
Page คือหน่วยย่อยที่ระบบใช้จัดการ Mapping และการเคลื่อนข้อมูล เมื่อโปรแกรมอ้าง Page ที่ยังไม่พร้อม อาจเกิด Page Fault คำนี้ไม่ได้หมายถึงข้อผิดพลาดร้ายแรงเสมอไป Fault บางครั้งแก้ได้รวดเร็วเพราะ Page มีอยู่ใน RAM แต่ยังไม่ได้ Mapping ให้ Process ขณะที่ Hard Page Fault ต้องอ่านข้อมูลจาก Storage ซึ่งช้ากว่าและส่งผลต่อ Latency ชัดเจน การเห็น Page Fault เพียงจำนวนเดียวจึงต้องแยกชนิดและดูเวลาที่เสียไปด้วย
Working Set คือชุด Page ของ Process ที่กำลังอยู่ใน Physical Memory ณ เวลาหนึ่ง แต่ไม่ใช่ภาพทั้งหมดของต้นทุนหน่วยความจำ เพราะอาจมี Page ที่แชร์ File Cache หรือบริการระบบช่วยรองรับ Microsoft เตือนว่า Working Set ขึ้นกับสถานะเครื่อง ปริมาณ RAM และระดับ Memory Pressure การใช้ค่านี้จึงเหมาะกับการดูแนวโน้มและ Peak ภายใต้ Workflow ที่ควบคุม มากกว่านำตัวเลขจากคนละเครื่องมาเทียบตรง ๆ
Committed Memory ตอบอีกคำถามหนึ่ง คือระบบรับปากว่าจะมีที่รองรับ Allocation เหล่านั้นจาก RAM หรือ Paging Store แม้ไม่ใช่ทุก Page จะอยู่ใน RAM พร้อมกัน หาก Commit เข้าใกล้ขีดจำกัด โปรแกรมใหม่อาจขอหน่วยความจำไม่สำเร็จ ทั้งที่หน้าจอแสดง Working Set ต่ำกว่าอยู่ การวิเคราะห์จึงควรดู Resident/Working Set, Commit, Available, Page-in และ Swap ร่วมกัน
INSIDE DRAM
Module, Chip, Rank, Bank, Row และ Controller ทำงานร่วมกัน
แผงหน่วยความจำที่ติดตั้งในเดสก์ท็อปมักเรียกว่า DIMM ส่วนโน้ตบุ๊กบางรุ่นใช้ SODIMM ภายในแผงมีชิป DRAM จัดเป็น Rank และแบ่งทรัพยากรภายในเป็น Bank, Row และ Column เซลล์ DRAM เก็บสถานะด้วยประจุซึ่งค่อย ๆ รั่ว จึงต้อง Refresh เป็นระยะ รายละเอียดเหล่านี้อธิบายว่าทำไมการอ่าน RAM ไม่ได้เป็นกล่องดำที่ทุกคำขอใช้เวลาเท่ากัน
Memory Controller รับคำขอจากหน่วยประมวลผล จัดลำดับ และสื่อสารกับโมดูลผ่าน Channel การเข้าถึง Row ที่เปิดอยู่แล้วอาจต่างจากการปิด Row เดิมและเปิด Row ใหม่ งานที่กระจายคำขออย่างเหมาะสมระหว่าง Bank อาจใช้ทรัพยากรขนานได้ดีกว่า แต่ผู้ใช้ทั่วไปไม่ต้องปรับ Row เอง สิ่งที่ควรรู้คือ Latency ที่สังเกตได้ขึ้นกับทั้ง Timing, Data Rate, รูปแบบคำขอ และภาระของ Controller
คำว่า Dual Channel ไม่ได้แปลว่าโปรแกรมเร็วขึ้นสองเท่าเสมอ มันเพิ่มช่องทางขนข้อมูลรวมเมื่อการติดตั้งและแพลตฟอร์มรองรับ งานที่ต้องสตรีมข้อมูลจำนวนมากอาจได้ประโยชน์ชัด ส่วนงานที่รอ Dependency ทีละจุดอาจติด Latency มากกว่า Bandwidth การเสียบโมดูลผิดช่องหรือใช้รูปแบบที่คู่มือเมนบอร์ดไม่แนะนำอาจทำให้ระบบทำงานเพียง Channel เดียว แม้ความจุรวมถูกต้อง
ECC เพิ่มความสามารถตรวจและแก้ข้อผิดพลาดบางประเภท แต่ต้องพิจารณาทั้ง CPU, เมนบอร์ด, Firmware และโมดูลว่ารองรับร่วมกันหรือไม่ มันช่วยลดความเสี่ยงข้อมูลผิดเงียบในงานที่รันนานหรือสำคัญ แต่ไม่แทน Backup, การตรวจความถูกต้องของซอฟต์แวร์ หรือการทดสอบฮาร์ดแวร์ ข้อผิดพลาดจากโปรแกรมยังคงให้ผลผิดแม้บิตใน RAM สมบูรณ์
METRICS
Capacity, Bandwidth และ Latency ตอบคนละคำถาม
| ตัวชี้วัด | คำถามที่ตอบ | อาการเมื่อเป็นคอขวด | สิ่งที่ต้องอ่านร่วมกัน |
|---|---|---|---|
| Capacity | Working Set อยู่พร้อมกันได้มากเท่าไร | Swap, OOM, แอปปิด หรือ Batch โหลดไม่ได้ | Available, Commit, Peak และ Headroom |
| Bandwidth | ขนข้อมูลรวมได้มากเพียงใดต่อเวลา | Core หรือ GPU รอข้อมูลในงานสตรีมจำนวนมาก | Channel, Data Rate และรูปแบบ Access |
| Latency | คำขอหนึ่งต้องรอนานเพียงใด | งานสุ่มตำแหน่งหรือพึ่งผลก่อนหน้าหน่วง | Timing, Cache Miss และ Queue |
| Data Rate | ส่งข้อมูลกี่ครั้งต่อวินาทีตามสเปก | อัตราขนส่งต่ำกว่าที่ Workflow ต้องการ | ความกว้าง Bus และจำนวน Channel |
| Timing | การทำงานภายในใช้กี่รอบในเงื่อนไขหนึ่ง | เวลารอเพิ่มเมื่อคำขอไวต่อ Latency | Clock จริงและ Platform Setting |
Capacity เป็นเงื่อนไขแบบหน้าผา เมื่อ Working Set พอดี งานอาจเดินต่อได้ตามปกติ แต่เมื่อเกินจนระบบต้องย้าย Page บ่อย Latency อาจกระโดดและ Throughput ลดแรง การเพิ่มจาก 16 เป็น 32 GB จึงอาจเปลี่ยนประสบการณ์อย่างมากใน Workflow ที่ใช้เกิน 16 GB ขณะเดียวกัน การเพิ่มจาก 64 เป็น 128 GB อาจแทบไม่เปลี่ยนเวลาเลยหาก Peak อยู่ที่ 20 GB และคอขวดคือ CPU
Bandwidth เปรียบเหมือนความกว้างถนน ส่วน Latency เปรียบเหมือนเวลาที่รถหนึ่งคันใช้ถึงปลายทาง ถนนกว้างส่งรถหลายคันพร้อมกันได้ แต่รถคันแรกอาจยังใช้เวลาเท่าเดิม งาน AI ที่อ่าน Tensor จำนวนมากมักสนใจ Bandwidth ขณะที่โครงสร้างข้อมูลแบบ Pointer กระโดดไปมาอาจไวต่อ Latency การพูดว่า RAM รุ่นหนึ่ง “เร็วกว่า” โดยไม่บอกงานจึงไม่พอสำหรับการตัดสินใจ
CAS Latency ที่เห็นบนกล่องเป็นจำนวนรอบ ไม่ใช่เวลานาโนวินาทีโดยตรง รุ่นที่ Data Rate สูงขึ้นอาจมีตัวเลขรอบมากขึ้นแต่เวลาจริงใกล้เคียงหรือต่ำกว่า และการเข้าถึงจริงมีขั้นตอนมากกว่า CAS เพียงค่าเดียว จึงไม่ควรเลือกจาก CL ต่ำที่สุดโดยแยกจาก Data Rate, Stability, Compatibility และราคา
MAIN CASE STUDY
กรณีศึกษา: ผู้ช่วย AI วิเคราะห์ PDF ภาษาไทย 50 ไฟล์
ใช้กรณีเดียวตลอดบท: คุณกำลังรันผู้ช่วย AI ในเครื่องเพื่ออ่าน PDF ภาษาไทย 50 ไฟล์ แยกข้อความ แบ่ง Chunk สร้าง Embedding และตอบคำถามจากเอกสาร เครื่องมี RAM 16 GB และ GPU VRAM 8 GB เป้าหมายไม่ใช่ทำคะแนน Benchmark แต่ต้องตอบคำถามหนึ่งชุดให้เสร็จโดยระบบยังตอบสนองดีและผลลัพธ์ถูกต้อง
ตอนเริ่ม ระบบปฏิบัติการและบริการพื้นหลังใช้ RAM ส่วนหนึ่ง เบราว์เซอร์เปิดเอกสารอ้างอิงหลายแท็บ โปรแกรมอ่าน PDF โหลดไฟล์และสร้างโครงสร้างข้อความ โมเดล Embedding มีน้ำหนักและ Runtime ของตน Vector ที่ได้ถูกสะสมในหน่วยความจำ ขณะเดียวกัน Local LLM ใช้ RAM หรือ VRAM ตามรูปแบบ Offload และเก็บ KV Cache ซึ่งโตตามความยาว Context เมื่อองค์ประกอบเหล่านี้ทำงานพร้อมกัน Peak Working Set สูงกว่าขนาดไฟล์ PDF รวมมาก
Input คือ PDF และคำถาม Process คืออ่านไฟล์ ถอดข้อความ แบ่ง Chunk สร้าง Embedding ค้นคืน และ Inference Output คือคำตอบพร้อมหลักฐาน Baseline คือเวลาตั้งแต่กดถามจนคำตอบพร้อมและความถูกต้องของแหล่งอ้างอิง Failure Mode หลักคือ RAM ตึงจนเกิด Swap, VRAM ไม่พอจน Offload มาก, Storage อ่านไฟล์เล็กช้า หรือ CPU เตรียมข้อมูลไม่ทัน บทบาทมนุษย์คือกำหนด Batch, Context, จำนวน Worker และเกณฑ์หยุดโดยรักษาความถูกต้องของคำตอบ
ช่วงนำเข้า
ไฟล์และ Buffer เพิ่ม RAM ตามจำนวนงานที่เปิดพร้อมกัน การอ่านแบบ Batch ใหญ่เกินไปอาจดัน Peak โดยไม่เพิ่ม Throughput ตามสัดส่วน
ช่วงสร้างตัวแทน
โมเดล Embedding, Tensor ชั่วคราว และผล Vector ใช้ทั้ง RAM และ VRAM รูปแบบข้อมูลกับ Precision เปลี่ยน Footprint ได้
ช่วงตอบคำถาม
น้ำหนักโมเดล Runtime, Context และ KV Cache ใช้พื้นที่เพิ่ม หาก Offload ข้าม PCIe บ่อย Latency อาจสูงแม้ Capacity รวมพอ
การทดลองที่ดีเริ่มด้วย Batch เล็ก เก็บ Peak และเวลาของแต่ละช่วง จากนั้นเพิ่ม Batch ทีละขั้นโดยไม่เปลี่ยนโมเดลหรือข้อมูลพร้อมกัน หาก Throughput ดีขึ้นแต่ Swap เริ่มต่อเนื่องและ P95 แย่ลง จุดนั้นไม่ใช่ชัยชนะ ผู้ใช้สนใจเวลารอและความเสถียรของระบบด้วย ไม่ใช่จำนวนไฟล์ต่อรอบอย่างเดียว
FAILURE CASE
เมื่อ RAM ไม่พอ ระบบอาจย้าย Page, บีบอัด หรือหยุดโปรแกรม
เมื่อความต้องการ Physical Memory สูง ระบบพยายามคืนพื้นที่จาก Cache ที่เรียกคืนได้ ตัด Working Set ของ Process บางส่วน บีบอัดข้อมูลในหน่วยความจำ หรือย้าย Page ที่ไม่ค่อยใช้ไป Swap/Pagefile บน Storage กลไกเหล่านี้ช่วยให้ระบบอยู่รอดและเปิดโปรแกรมต่อได้ แต่มีต้นทุน หาก Page ที่ถูกย้ายต้องใช้ซ้ำ ระบบต้องอ่านกลับและงานจะรอ I/O
Pagefile หรือ Swap ไม่ใช่ RAM ฟรี มันขยายพื้นที่รองรับ Commit และช่วยหลีกเลี่ยงการล้มทันที แต่ Latency ของ Storage สูงกว่า DRAM มาก ต่อให้ใช้ SSD การสลับ Page ไปกลับยังทำให้ระบบหน่วง หากรูปแบบงานแตะ Page ที่เพิ่งถูกย้ายออกซ้ำ ๆ จะเกิด Thrashing คือระบบใช้เวลาส่วนใหญ่กับการเคลื่อน Page แทนทำงานที่ผู้ใช้ต้องการ อาการที่เห็นคือดิสก์ทำงานหนัก แอปสลับช้า และเวลาตอบเพิ่มแบบไม่เป็นเส้นตรง
ระบบปฏิบัติการแต่ละตระกูลมีนโยบายและชื่อ Metric ต่างกัน บางระบบอาจเลือกหยุด Process เมื่อหน่วยความจำหมด บางระบบบีบอัดก่อน และบางงานล็อก Page ไม่ให้ Swap เช่น Pinned Memory สำหรับการส่งข้อมูล CPU–GPU แบบ Asynchronous NVIDIA ระบุว่า Pinned Memory ช่วยการส่งข้อมูล แต่ไม่ควรใช้มากเกินไป เพราะลดทรัพยากรที่ระบบจัดการได้อย่างยืดหยุ่น
ในกรณี PDF 50 ไฟล์ ถ้าเพิ่ม Worker จาก 2 เป็น 12 แล้วทุก Worker ถือสำเนาโมเดลหรือ Buffer ชุดใหญ่ Peak อาจเพิ่มเร็วกว่าปริมาณงาน เมื่อเริ่ม Swap การเพิ่ม Worker ต่อไม่ทำให้เสร็จเร็วขึ้น กลับทำให้ทุก Worker รอพร้อมกัน วิธีแก้ที่มีเหตุผลอาจเป็นลด Concurrency, ใช้ Queue, ปล่อยวัตถุที่ไม่ใช้, Stream ไฟล์ หรือแบ่งขั้นตอน ไม่ใช่ซื้อ RAM ก่อนวัดเสมอไป
KEY DISTINCTIONS
RAM, Cache, Storage และ VRAM ต่างกันอย่างไร
| ชั้น | อยู่ใกล้ใคร | หน้าที่หลัก | เมื่อไม่พอหรือช้า |
|---|---|---|---|
| Register | หน่วยคำนวณใน CPU | เก็บค่าที่ใช้ทันที | Compiler/CPU ต้องย้ายค่าหรือรอ Dependency |
| Cache | Core หรือกลุ่ม Core | เก็บ Cache Line ที่มีโอกาสใช้ซ้ำ | Cache Miss เพิ่มการออกไปขอ RAM |
| RAM | CPU และระบบปฏิบัติการ | Working Memory หลักของ Process และ Cache ระบบ | Memory Pressure, Swap, OOM |
| Storage | ระบบไฟล์ | เก็บข้อมูลถาวรและรองรับ Paging | โหลดไฟล์และ Page-in ช้า |
| VRAM | GPU | เก็บ Weight, Tensor, Texture และข้อมูลที่ GPU ใช้ | ลด Batch, OOM หรือ Offload ข้าม Bus |
RAM กับ VRAM อาจใช้เทคโนโลยีหน่วยความจำตระกูลใกล้กัน แต่ตำแหน่งและเส้นทางต่างกัน ในระบบที่มีการ์ดจอแยก CPU และ GPU มีพื้นที่ DRAM คนละฝั่ง การส่งข้อมูลข้าม PCIe มีต้นทุน NVIDIA แนะนำให้ลดการส่ง Host–Device ที่ไม่จำเป็นและรวมการส่งย่อยเมื่อทำได้ เพราะ Bandwidth ภายใน VRAM สูงกว่าทางเชื่อม Host–Device มาก
Integrated GPU บางระบบแชร์หน่วยความจำกายภาพกับ CPU แต่คำว่า Shared ไม่ได้ทำให้ข้อจำกัดหายไป CPU และ GPU ยังแข่งขัน Bandwidth และความจุ ส่วน Framework อาจมีวิธีจัดสรรต่างกัน จึงต้องดูเอกสารแพลตฟอร์มและวัด Workflow จริง ไม่ควรสรุปว่า RAM 32 GB เท่ากับ VRAM 32 GB ที่ใช้กับโมเดลได้เต็มจำนวน
Storage Cache และ Page Cache ทำให้เส้นแบ่งดูซับซ้อน ไฟล์บน SSD อาจมีสำเนา Page ที่อยู่ใน RAM ทำให้เปิดรอบสองเร็วขึ้น แต่ข้อมูลนั้นยังไม่กลายเป็น Storage ถาวรจนระบบเขียนเสร็จ การปิดเครื่องหรือโปรแกรมกะทันหันจึงอาจทำให้ข้อมูลที่ยังอยู่ใน Buffer สูญหาย นโยบาย Flush และความถูกต้องของระบบไฟล์ยังสำคัญ
AI WORKLOAD
งาน AI ใช้หน่วยความจำมากกว่าขนาดไฟล์โมเดล
ไฟล์โมเดลบอกขนาดน้ำหนักที่เก็บบนดิสก์ แต่ขณะรันต้องมี Runtime, Workspace, Tensor Input, Output และตัวแทนระหว่างชั้นของเครือข่าย หากใช้ Quantization ขนาด Weight อาจลดลง แต่ Overhead อื่นยังอยู่ สำหรับโมเดลภาษา KV Cache โตตามจำนวน Token, Batch และโครงสร้างโมเดล จึงเป็นไปได้ว่าโมเดลโหลดได้ตอนเริ่ม แต่ล้มเมื่อ Context ยาวขึ้นหรือมีผู้ใช้พร้อมกัน
การฝึกโมเดลต้องเก็บมากกว่าการ Inference เพราะนอกจาก Weight ยังมี Activation สำหรับ Backpropagation, Gradient และ Optimizer State บางชนิดใช้หลายเท่าของขนาด Weight Precision, Batch Size, Sequence Length, Checkpointing และ Parallel Strategy เปลี่ยน Peak ได้มาก การพูดว่า “โมเดล 7B ใช้ RAM เท่าไร” จึงตอบไม่ได้ครบหากไม่บอกรูปแบบไฟล์ Precision, Runtime และงานที่ทำ
เมื่อ VRAM ไม่พอ Framework อาจ Offload บางส่วนไป System RAM หรือ Storage เทคนิคนี้ช่วยให้รันโมเดลใหญ่ขึ้น แต่การคัดลอกผ่านทางเชื่อมเพิ่ม Latency และอาจทำให้ GPU รอ หาก System RAM เองเริ่ม Swap สองชั้นของการเคลื่อนข้อมูลจะทำให้เวลาตอบแย่มาก เป้าหมายจึงไม่ใช่แค่ “โหลดได้” แต่ต้องดู Time-to-first-token, Throughput, Peak RAM/VRAM และความเสถียรตลอด Context ที่ใช้งานจริง
ในกรณีศึกษาของเรา การลด Batch Embedding อาจลด Peak โดยแลกกับจำนวนรอบเพิ่ม การใช้ Chunk สั้นลงลด Memory แต่เพิ่มจำนวน Vector และต้นทุนค้นคืน การลด Context ช่วย KV Cache แต่เสี่ยงตัดหลักฐานสำคัญ ทุกการปรับจึงมี Trade-off ระหว่าง Memory, Latency, Throughput และคุณภาพคำตอบ ต้องรักษา Evaluation ชุดเดิมเป็น Guardrail
MEASURE FIRST
วัด Peak และ Pressure ก่อนสรุปว่าต้องเพิ่ม RAM
เริ่มจากกำหนด Workflow ตัวแทน ไม่วัดตอนเครื่องว่าง หากงานจริงคือเปิด PDF 50 ไฟล์ ให้ใช้จำนวนและขนาดใกล้เคียง เปิดโปรแกรมร่วมที่ใช้จริง และรันจนผ่านช่วงพีก เก็บเวลาตั้งแต่เริ่มจนผลพร้อม พร้อมดู RAM, Swap/Pagefile, Disk I/O, CPU และ GPU Timeline การวัดเฉพาะภาพหน้าจอหนึ่งวินาทีอาจพลาด Peak ที่เกิดระหว่างโหลดโมเดลหรือรวม Batch
บน Windows ให้ดูอย่างน้อย Working Set ของ Process, Available Memory, Committed Bytes และกิจกรรม Paging โดยตีความ Pages/sec อย่างระวัง เพราะ Paging มีหลายสาเหตุและค่ามากไม่ได้พิสูจน์ RAM ขาดเสมอ บน Linux ดู Resident Set, Available, Swap, Page Fault, I/O Wait และ OOM Log ร่วมกัน ชื่อเครื่องมือไม่สำคัญเท่าการบันทึกเวลาและเชื่อม Metric กับช่วงของ Workflow
ทำ Baseline สามรอบขึ้นไปเพื่อเห็นความแปรปรวน จากนั้นเปลี่ยนสิ่งสำคัญทีละอย่าง เช่น Batch 4 เป็น 8 โดยคงไฟล์ โมเดล และจำนวน Worker ถ้าเวลาลดและ Peak ยังมี Headroom การเพิ่มมีเหตุผล หากเวลารอบเร็วขึ้นเล็กน้อยแต่ P95 แย่และ Swap เริ่มสูง การตั้งค่าใหม่อาจไม่เหมาะกับผู้ใช้จริง
สัญญาณที่ควรเก็บร่วมกัน
- Peak Working Set/Resident: งานต้องมี RAM จริงช่วงพีกเท่าไร
- Available และ Commit: ระบบยังมีทางรองรับ Allocation เพิ่มหรือไม่
- Page-in/Swap I/O: กำลังอ่านข้อมูลกลับจาก Storage ต่อเนื่องหรือไม่
- Latency และ P95/P99: ผู้ใช้รอนานขึ้นในช่วง Pressure หรือไม่
- Throughput: งานสำเร็จต่อเวลาเพิ่มจริงหรือเพียงเปิดพร้อมกันมากขึ้น
- Correctness: การลด Batch, Precision หรือ Context ทำให้ผลเปลี่ยนหรือไม่
Recovery Step เมื่อวัดไม่ได้คือเริ่มจากเครื่องมือระบบที่มีอยู่ บันทึกวิดีโอหรือ Timeline พร้อมเวลา และทำงานขนาดเล็กที่ทำซ้ำได้ก่อน อย่าเดาตัวเลขจากสเปกหรือรีวิวคนอื่น เพราะ Driver, Runtime, ไฟล์ และโปรแกรมร่วมของคุณอาจต่างกัน
DECISION RULE
เลือก RAM จาก Peak Working Set, Headroom และทางขยาย
หลักเริ่มต้นคือวัด Peak Working Set ของ Workflow จริง รวมระบบปฏิบัติการ โปรแกรมหลัก Browser, Dataset, Model, Buffer และงานเบื้องหลัง แล้วเพิ่ม Headroom สำหรับ Spike, การอัปเดต และการเปลี่ยนพฤติกรรมผู้ใช้ Headroom ไม่ใช่ตัวเลขตายตัว งานที่ควบคุมได้และรันคนเดียวอาจเผื่อน้อยกว่าบริการหลายผู้ใช้ที่ Context และ Batch ผันผวน
อย่าเลือก Capacity แยกจาก Platform ตรวจจำนวน Slot ความจุสูงสุดต่อ Slot จำนวน Channel และรูปแบบโมดูลที่ผู้ผลิตรองรับ เครื่องที่มีสอง Slot หากใส่เต็มด้วยโมดูลเล็กอาจต้องเปลี่ยนทั้งหมดเมื่ออัปเกรด แต่การเว้น Slot ก็ต้องดูว่าการติดตั้งยังใช้ Channel ตามที่ต้องการหรือไม่ ต้นทุนการอัปเกรดในอนาคตควรอยู่ใน Decision Rule ตั้งแต่แรก
Data Rate และ Timing มีผลเมื่อ Workload ใช้ Memory Bandwidth หรือไวต่อ Latency แต่ Stability มาก่อนสเปกสูง โปรไฟล์เร่งความเร็วอาจไม่ทำงานกับทุก CPU/เมนบอร์ดและอาจต้องทดสอบยาว หากงานสำคัญควรใช้ค่าที่แพลตฟอร์มรองรับ ตรวจ Memory Error และเก็บ Baseline หลังการเปลี่ยน ไม่สรุปจากการบูตผ่านครั้งเดียว
Readiness Checklist ก่อนซื้อหรืออัปเกรด
- มี Baseline และ Peak จาก Workflow ที่ทำซ้ำได้ ไม่ใช่เปอร์เซ็นต์ตอนว่าง
- ยืนยันว่ามี Memory Pressure หรือ Capacity จำกัดงานจริง
- ตรวจ CPU, เมนบอร์ด, Firmware, ชนิด DDR, Slot, Channel, Rank และ ECC จากคู่มือ
- กำหนด Headroom และทางขยายตามอายุใช้งานที่คาด
- เปรียบเทียบต้นทุนกับทางเลือก เช่น ลด Batch, Stream ข้อมูล หรือแก้ Leak
- กำหนด Success Signal: Swap ลด, P95 ดีขึ้น, งานไม่ OOM และผลยังถูกต้อง
- กำหนด Recovery: คืนค่าเดิมหรือถอดโมดูลได้หากไม่เสถียร
COMPATIBILITY
รูปร่างใส่ได้ไม่ได้แปลว่าระบบรองรับทุกค่า
DDR ต่างรุ่นใช้มาตรฐานไฟฟ้าและกลไกคนละแบบ จึงไม่ควรผสมหรือบังคับใส่ แม้อยู่ในตระกูลเดียวกัน CPU และเมนบอร์ดมีข้อจำกัดความจุ Data Rate, จำนวนโมดูลต่อ Channel และ ECC ต่างกัน การใส่หลายโมดูลอาจทำให้ Controller เลือกค่าต่ำลงเพื่อความเสถียร คู่มือ QVL เป็นสัญญาณว่าผู้ผลิตเคยทดสอบชุดหนึ่ง แต่ไม่ใช่รายชื่อเดียวที่ทำงานได้เสมอ และต้องดู Revision ให้ตรง
การผสมโมดูลต่างขนาด ต่าง Timing หรือคนละชุดอาจทำงานที่ค่าร่วมต่ำสุด หรืออาจเกิด Error ภายใต้โหลดแม้เปิดเครื่องได้ การทดสอบควรครอบคลุม Memory Test, Workflow จริง, Sleep/Wake และโหลดต่อเนื่อง ตรวจ Log ที่เกี่ยวข้องและอุณหภูมิด้วย หากพบ Error อย่าปรับหลายค่าในครั้งเดียว เพราะจะไม่รู้สาเหตุและ Recovery ยาก
ECC เหมาะเมื่อข้อมูลผิดเงียบมีต้นทุนสูง งานวิจัยระยะยาว เซิร์ฟเวอร์หรือการฝึกโมเดลหลายวันอาจได้รับประโยชน์ แต่ต้องรองรับครบทั้งเส้นทาง ECC ไม่ป้องกัน Power Failure, Storage Corruption, Bug หรือผลโมเดลผิด การตัดสินใจจึงต้องดูความน่าเชื่อถือทั้งระบบ ไม่ใช้ป้าย ECC แทนกระบวนการตรวจสอบ
MISCONCEPTIONS
ความเข้าใจผิดที่พบบ่อย และวิธีตรวจ
RAM 80% ต้องเพิ่มทันที
กลไก: ระบบใช้พื้นที่ว่างทำ Cache ได้ วิธีตรวจ: ดู Available, Pressure, Swap และ Latency ร่วมกัน
RAM มากทำให้ CPU เร็ว
กลไก: Capacity ลดการย้ายข้อมูลเมื่อเดิมไม่พอ แต่ไม่เพิ่ม Clock หรือ IPC วิธีตรวจ: วัดเวลาหลัง Swap หายแล้ว
CL ต่ำกว่าชนะเสมอ
กลไก: CL เป็นจำนวนรอบและการเข้าถึงจริงมี Timing หลายค่า วิธีตรวจ: อ่านร่วมกับ Data Rate และ Benchmark งานจริง
Swap คือ RAM เพิ่ม
กลไก: Swap ช่วยรองรับ Page แต่ใช้ Storage ที่ Latency สูงกว่า วิธีตรวจ: ดู Page-in และเวลารอ I/O
ไฟล์โมเดล 8 GB ใช้แค่ 8 GB
กลไก: Runtime, Cache, Tensor และ Workspace เพิ่ม Footprint วิธีตรวจ: วัด Peak ตั้งแต่โหลดถึง Context สูงสุด
VRAM กับ RAM ใช้แทนกันได้
กลไก: อยู่คนละฝั่งของทางเชื่อมและ Runtime จัดการต่างกัน วิธีตรวจ: ดู Placement และ Transfer Timeline
ทุกความเข้าใจผิดมีเหตุผลที่ฟังดูน่าเชื่อ เพราะหยิบตัวเลขหนึ่งค่ามาแทนระบบทั้งชุด วิธีแก้ไม่ใช่จำข้อห้ามเพิ่ม แต่ฝึกถามว่า Metric นี้วัดอะไร ไม่วัดอะไร และถ้าสมมติฐานถูก เราควรเห็นหลักฐานอีกตัวใดตามมา เช่น ถ้า RAM ขาดจริง การเพิ่ม Capacity ควรลด Swap และทำให้ Latency ช่วงพีกดีขึ้น หากไม่เกิด คอขวดเดิมอาจอยู่ที่อื่น
LIMITS AND HUMAN ROLE
RAM แก้ข้อจำกัดบางแบบ แต่ไม่แก้อัลกอริทึม ข้อมูล และความรับผิดชอบ
การเพิ่ม RAM ไม่แก้โค้ดที่เก็บข้อมูลซ้ำโดยไม่จำเป็น Memory Leak หรืออัลกอริทึมที่ขยายการใช้หน่วยความจำเร็วเกินไป มันอาจทำให้ปัญหาเกิดช้าลงจนทีมเข้าใจผิดว่าหายแล้ว การแก้ต้องระบุเจ้าของ Metric, ตั้ง Alert และตรวจแนวโน้มต่อหน่วยงาน เช่น Memory ต่อเอกสารหรือ Token ไม่ใช่ดูยอดรวมอย่างเดียว
ข้อมูลอ่อนไหวอาจอยู่ใน RAM, Swap, Crash Dump หรือ Hibernation File แม้ผู้ใช้ไม่ได้บันทึกเอง ระบบที่จัดการข้อมูลส่วนบุคคลหรือความลับต้องกำหนดสิทธิ์ การเข้ารหัส Storage, นโยบาย Dump และการล้างข้อมูลตามบริบท การเพิ่ม Swap เพื่อให้รันงานได้จึงมีมิติความเป็นส่วนตัวและความปลอดภัย ไม่ใช่เพียงประสิทธิภาพ
มนุษย์ต้องกำหนดว่า “พอ” หมายถึงอะไร สำหรับเครื่องส่วนบุคคลอาจเป็นการสลับแอปไม่สะดุด สำหรับบริการ AI อาจเป็น P95 ต่ำกว่าเกณฑ์และไม่มี OOM ภายใต้จำนวนผู้ใช้ช่วงพีก ผู้รับผิดชอบต้องสามารถหยุด Rollout, ลด Concurrency, ย้อนค่า และตรวจว่าการปรับยังรักษาคุณภาพคำตอบ ไม่มีโมดูล RAM ใดตัดสิน Trade-off เหล่านี้แทนทีมได้
บทเรียนนี้เป็นกรอบแนวคิด ไม่ใช่คำแนะนำซื้อรุ่นเฉพาะ สเปก ราคา ความเข้ากันได้ และพฤติกรรม Runtime เปลี่ยนตามแพลตฟอร์มและเวอร์ชัน ควรอ้างคู่มือ CPU/เมนบอร์ดและเอกสารซอฟต์แวร์ที่ใช้งานจริงก่อนตัดสินใจ
PRACTICE
Worksheet: Memory Journey Card
เลือก Workflow หนึ่งงาน เช่น เปิดโปรเจกต์ขนาดใหญ่ ตัดต่อวิดีโอ รันโมเดล Local LLM หรือวิเคราะห์ PDF แล้วกรอกการ์ดนี้จากหลักฐาน หากยังวัดไม่ได้ให้เขียน “ยังไม่ทราบ” พร้อมระบุวิธีหาคำตอบ ห้ามเติมตัวเลขจากความรู้สึก
- งานและผลลัพธ์: Input คืออะไร Output ที่ถูกต้องหน้าตาอย่างไร และผู้ใช้ยอมรอได้นานเท่าไร
- เส้นทางข้อมูล: ข้อมูลเริ่มที่ Storage ใด ผ่าน RAM, Cache, CPU, GPU หรือ Network อย่างไร
- ผู้ใช้หน่วยความจำ: Process, Browser, Runtime, Dataset, Model, Buffer และบริการเบื้องหลังมีอะไรบ้าง
- Baseline: บันทึก Peak RAM/VRAM, Available, Commit, Swap, Latency, P95 และ Throughput อย่างน้อยสามรอบ
- Failure Case: ระบุอาการเมื่อ Batch หรือ Context สูงสุด เช่น Swap, OOM, แอปค้าง หรือคุณภาพลด
- การเปลี่ยนหนึ่งอย่าง: เลือกลด Batch, จำนวน Worker, ขนาด Context หรือเพิ่ม Capacity เพียงหนึ่งตัวแปร
- Success Signal: ระบุหลักฐานที่จะยืนยัน เช่น Swap ลดเป็นศูนย์ในช่วงพีกและ P95 ดีขึ้นโดยคำตอบยังถูก
- Recovery Step: เขียนวิธีย้อนค่าหรือหยุดงานเมื่อ Error, Temperature หรือ Latency เกินเกณฑ์
เกณฑ์สำเร็จ: คุณต้องอธิบายได้ว่าเวลาหายไปกับการคำนวณหรือการเคลื่อนข้อมูล จุดใดเป็น Capacity Limit และหลักฐานใดจะทำให้ข้อสรุปเปลี่ยน หากตอบได้แม้ยังไม่ซื้ออุปกรณ์ คุณก็ผ่านกิจกรรมนี้
CHECK YOUR UNDERSTANDING
แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่ดีที่สุดเพียงหนึ่งข้อในแต่ละข้อ แล้วกด “ตรวจคำตอบ” ระบบจะแสดงคะแนนรวม เฉลย เหตุผลรายข้อ และจำนวนข้อที่ยังไม่ได้ตอบ
CONCLUSION
บทสรุป: RAM ที่พอดีทำให้งานอยู่ใกล้หน่วยประมวลผลโดยไม่ผลักภาระไป Storage
กลับไปยังฉากเริ่มต้นที่เครื่องหน่วงขณะอ่าน PDF 50 ไฟล์ ตอนนี้เราไม่ต้องหยุดที่คำว่า “RAM เต็ม” อีกแล้ว เราตามเส้นทางได้ว่าไฟล์ถูกอ่านจาก Storage เข้าสู่ Page ใน RAM โปรแกรมสร้าง Working Set อย่างไร CPU ขอข้อมูลผ่าน Cache อย่างไร โมเดลและ KV Cache เพิ่ม Footprint ตรงไหน และเหตุใดการย้าย Page กลับไปยัง Storage ทำให้เวลารอกระโดด
Mental Model ที่ควรจำมีสามชั้น หนึ่ง Capacity บอกว่างานอยู่พร้อมกันได้หรือไม่ สอง Bandwidth และ Latency บอกว่าข้อมูลเดินได้มากและต้องรอนานเพียงใด สามระบบปฏิบัติการใช้ Virtual Memory, Cache และ Swap เพื่อจัดการความต้องการที่เปลี่ยนตลอดเวลา การตัดสินใจที่ดีต้องอ่านทั้งสามชั้น ไม่ใช้เปอร์เซ็นต์เดียวแทนความจริงทั้งหมด
กฎนำไปใช้คือ วัด Workflow จริง หา Peak และ Memory Pressure แยก RAM จาก VRAM/Storage/CPU เปลี่ยนสมมติฐานทีละอย่าง และรักษาความถูกต้องกับ Latency เป็น Guardrail ถ้า Capacity เพิ่มแล้ว Swap หายและ P95 ดีขึ้น คุณมีหลักฐานว่าการอัปเกรดช่วย แต่ถ้าเวลาคงเดิม ให้กลับไปหา Data Path และคอขวดชั้นอื่น
RAM ที่ดีไม่ใช่ RAM ที่มีตัวเลขสูงที่สุด แต่คือ RAM ที่ทำให้ Working Set ของงานจริงอยู่ได้พอดี ส่งข้อมูลได้เหมาะกับแพลตฟอร์ม และเหลือทางให้ระบบรับมือช่วงพีกอย่างมั่นคง
SUMMARY INFOGRAPHIC
ภาพสรุป: จาก Storage สู่ RAM, Cache, CPU และ VRAM
เรียนต่ออย่างมีทิศทาง
บทถัดไปจะลงลึก Storage และแยกว่า SSD กับ HDD ต่างกันอย่างไร เมื่อเข้าใจ RAM แล้ว คุณจะเห็นชัดขึ้นว่าเวลาโหลดไฟล์และ Swap ขึ้นกับ Latency, Throughput และรูปแบบ I/O ของพื้นที่จัดเก็บอย่างไร
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงและบันทึกบรรณาธิการ
- Microsoft Learn — Virtual Address Space and Physical Storage — นิยาม Working Set, Page และความสัมพันธ์ระหว่าง Virtual Address กับ Physical Storage
- Microsoft Learn — Reference Sets and system-wide memory effects — ข้อจำกัดของการใช้ Working Set เพียงค่าเดียว
- Microsoft Learn — RAM, virtual memory and pagefile management — Commit, Working Set, Pagefile และการตีความ Counter
- Linux Kernel Documentation — Memory Management — ภาพรวม Virtual Memory, Demand Paging, Mapping, Reclaim และ Swap
- Linux Kernel Documentation — Memory Management internals — Page Cache, Page Reclaim, Swap และ Out-of-memory
- Intel® 64 and IA-32 Architectures Software Developer Manuals — สถาปัตยกรรมหน่วยความจำ, Address Translation และ Cache
- NVIDIA CUDA Programming Guide — Unified and System Memory — Host/Device Memory และ Page-locked Memory
- NVIDIA CUDA C++ Best Practices Guide — Memory Optimizations — ต้นทุนการส่งข้อมูล CPU–GPU, Bandwidth และข้อจำกัดของ Pinned Memory
ขอบเขต: รายละเอียด Page Size, Memory Controller, Timing, Channel, ECC, Compression, Swap และ OOM ต่างกันตามสถาปัตยกรรม ระบบปฏิบัติการ Firmware และรุ่นอุปกรณ์ ต้องอ้างคู่มือแพลตฟอร์มจริงก่อนปรับค่า
บันทึกบรรณาธิการ: ตรวจข้อเท็จจริงและลิงก์ล่าสุด 10 สิงหาคม 2026 กรณี “ผู้ช่วย AI วิเคราะห์ PDF ภาษาไทย 50 ไฟล์” เป็นสถานการณ์สมมติเพื่ออธิบายกลไก ไม่ใช่ผล Benchmark ภาพสรุปสร้างด้วย ImageGen รุ่น v1 แบบไม่มีข้อความในภาพ มีไฟล์ต้นฉบับ WebP ภาพตรวจ 1024×576/300×169 และ Manifest ใน Visual Register ของโครงการ
