จากบทก่อนหน้าที่ฝึกชั่งน้ำหนักสัญญาณกับสิทธิ เราจะถอยมาดูว่า “ขอบเขตที่เชื่อได้” ของระบบ AI ถูกสร้างขึ้นอย่างไร
เช้าวันจันทร์ ทีมร้านค้าปลีกเปิดระบบ ShelfCheck ให้ตรวจภาพชั้นสินค้าและแจ้งว่าป้ายราคาใดหาย ระบบเคยทำคะแนนดีมากกับภาพทดสอบจากสิบสองสาขา จึงมีคนเสนอว่า “ปล่อยให้ AI ส่งงานแก้ไขไปยังพนักงานอัตโนมัติได้เลย” แต่พอเปิดสาขาใหม่ กล้องคนละรุ่น แสงสะท้อนแรงกว่าเดิม และป้ายสองภาษามีรูปแบบใหม่ ระบบกลับทำเครื่องหมายผิดหลายจุด บางภาพให้คะแนนมั่นใจสูงเสียด้วย
คำถามสำคัญจึงไม่ใช่เพียงว่า AI เก่งแค่ไหน แต่คือ มันเก่งภายใต้เงื่อนไขใด เรารู้ได้อย่างไรว่ากำลังหลุดจากเงื่อนไขนั้น และใครต้องหยุดหรือรับช่วงเมื่อหลักฐานไม่พอ
บทเรียนนี้จะใช้ ShelfCheck เป็นเส้นเรื่องเดียวเพื่อไล่ตั้งแต่ภาพที่เข้าระบบ กระบวนการให้คะแนน เกณฑ์ตัดสิน ความผิดพลาด ผลกระทบ จนถึงการเฝ้าระวังหลังใช้งานจริง
อ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบายได้ว่าความสามารถของ AI ผูกกับข้อมูล เป้าหมาย บริบท และกระบวนการใช้งานอย่างไร
- แยกคำว่า ข้อจำกัด ความผิดพลาด ความไม่แน่นอน และความเสี่ยง โดยใช้เหตุผลจากสถานการณ์จริงได้
- ตรวจสัญญาณ Distribution Shift, งานนอกขอบเขต และคะแนนความมั่นใจที่ตีความเกินหลักฐานได้
- ออกแบบจุดตรวจ เกณฑ์ส่งต่อมนุษย์ และตัวชี้วัดเฝ้าระวังสำหรับระบบตัวอย่างได้
- เขียน Limit Statement ที่ระบุสิ่งที่ใช้ได้ สิ่งที่ห้ามใช้ ข้อมูลที่รองรับ Failure Mode และเจ้าของการตัดสินใจได้
คิดถึง AI เหมือนเครื่องมือที่มี “ขอบเขตที่เชื่อได้”
เครื่องชั่งในร้านค้าไม่ได้ถูกตัดสินจากคำว่า “ชั่งได้” อย่างเดียว เราต้องรู้ช่วงน้ำหนักที่รองรับ ความคลาดเคลื่อน วิธีสอบเทียบ อุณหภูมิที่ใช้งาน และสัญญาณว่าเครื่องเริ่มเสีย โมเดล AI ก็คล้ายกันตรงที่ความน่าเชื่อถือเกิดจากหลักฐานภายใต้เงื่อนไขหนึ่ง ไม่ได้เกิดจากชื่อเทคโนโลยีหรือความรู้สึกว่าผลลัพธ์ดูฉลาด
สำหรับ ShelfCheck ขอบเขตเริ่มต้นอาจเป็นภาพชั้นสินค้าจากกล้องรุ่นที่กำหนด ถ่ายในระยะสองถึงสามเมตร แสงภายในร้านตามมาตรฐาน ป้ายภาษาไทยรูปแบบเดิม และสินค้ากลุ่มที่มีตัวอย่างเพียงพอ ถ้าภาพใหม่อยู่ในขอบเขตนี้ คะแนนทดสอบช่วยบอกบางอย่างได้ แต่ถ้ากล้อง แสง ภาษา มุม หรือชนิดป้ายเปลี่ยน เราไม่ได้มีหลักฐานเดิมรองรับโดยอัตโนมัติ
อุปมาเรื่องเครื่องมือวัดมีขอบเขตจำกัด โมเดล AI ไม่ได้วัดค่าทางกายภาพตรง ๆ เสมอไป หลายระบบประมาณรูปแบบจากข้อมูลและอาจเปลี่ยนพฤติกรรมเมื่อข้อมูลหรือขั้นตอนรอบตัวเปลี่ยน ดังนั้นคำว่า “ผ่านการทดสอบ” ต้องผูกกับชุดทดสอบ ตัวชี้วัด กลุ่มผู้ใช้ และบริบทจริง ไม่ใช่ตราประทับถาวร
ความเก่งของ AI ไม่ใช่คุณสมบัติลอยตัว แต่เป็นความสัมพันธ์ระหว่างงาน ข้อมูล เกณฑ์วัด บริบท และผลกระทบที่เรายอมรับได้
NIST AI Risk Management Framework เน้นการมอง AI ตลอดวงจรชีวิตและจัดการความเสี่ยงตามบริบท เพราะระบบเดียวกันอาจยอมรับได้ในงานที่ผลย้อนกลับง่าย แต่ไม่เหมาะกับงานที่ความผิดพลาดกระทบสิทธิ สุขภาพ หรือความปลอดภัย การพูดว่า “โมเดลแม่น 95%” จึงยังไม่ตอบว่าใช้กับใคร เมื่อไร และผิดแบบใด
แยก “ข้อจำกัด” ออกจากความผิดพลาด ความไม่แน่นอน และความเสี่ยง
คำสี่คำนี้มักถูกใช้แทนกันจนการแก้ปัญหาเลือนหาย ลองแยกด้วยเหตุการณ์เดียวกัน: ShelfCheck อาจมีข้อจำกัดด้านแสงมืด ภาพหนึ่งอาจถูกตัดสินผิด คะแนนอาจมีความไม่แน่นอน และความผิดนั้นอาจสร้างความเสี่ยงต่อพนักงานหรือผู้ซื้อ แต่ละคำชี้ไปคนละคำถาม
| คำ | หมายถึงอะไร | ตัวอย่าง ShelfCheck | คำถามที่ควรถาม |
|---|---|---|---|
| ข้อจำกัด | ขอบเขตของสิ่งที่ระบบรองรับหรือหลักฐานยังไม่ครอบคลุม | ยังไม่ผ่านการทดสอบกับป้ายสองภาษาและแสงสะท้อนแรง | เราไม่ควรคาดหวังให้ระบบทำอะไร? |
| ความผิดพลาด | ผลลัพธ์หนึ่งไม่ตรงกับคำตอบอ้างอิงหรือผลจริง | ระบบแจ้งว่าป้ายหายทั้งที่ป้ายยังอยู่ | ผิดแบบใด บ่อยแค่ไหน และกระจุกตรงไหน? |
| ความไม่แน่นอน | ระดับที่หลักฐานไม่พอหรือผลอาจเปลี่ยนเมื่อเงื่อนไขเปลี่ยน | ภาพเบลอทำให้คะแนนสองคลาสใกล้กัน | คะแนนนี้ผ่านการ Calibration และสะท้อนโอกาสจริงหรือไม่? |
| ความเสี่ยง | โอกาสและความรุนแรงของผลเสียจากการใช้หรือไม่ใช้ระบบ | คำสั่งแก้ป้ายผิดทำให้พนักงานเสียเวลา หรือป้ายผิดจริงหลุดรอดไปถึงลูกค้า | ใครได้รับผลกระทบ ย้อนกลับได้ไหม และใครรับผิดชอบ? |
การแยกคำทำให้วิธีรับมือแม่นขึ้น ข้อจำกัดต้องสื่อสารและทดสอบเพิ่ม ความผิดพลาดต้องวิเคราะห์รูปแบบ ความไม่แน่นอนต้องตรวจวิธีคำนวณและ Calibration ส่วนความเสี่ยงต้องตัดสินร่วมกับผลกระทบ กฎ และทางเยียวยา เราไม่ควรตอบทุกอย่างด้วยคำกว้าง ๆ ว่า “เพิ่มข้อมูล”
ข้อมูลเป็นหน้าต่างบานหนึ่ง ไม่ใช่โลกทั้งหมด
โมเดลไม่ได้เดินเข้าไปสำรวจร้านทุกสาขา มันเห็นเฉพาะภาพที่ทีมรวบรวมและป้ายกำกับ หากข้อมูลฝึกมาจากสิบสองสาขาในเมือง ใช้กล้องรุ่นเดียว และถ่ายกลางวัน โมเดลย่อมเรียนรู้รูปแบบที่ปรากฏบ่อยในชุดนั้น สิ่งที่หายไป—สาขาเล็ก แสงสีเหลือง ชั้นโค้ง ป้ายเก่า ภาษาท้องถิ่น หรือเลนส์ที่มีรอย—ไม่กลายเป็นความรู้เพียงเพราะเรามีรูปจำนวนมาก
คำว่า “ข้อมูลเยอะ” จึงไม่เท่ากับ “ข้อมูลครอบคลุม” ภาพหนึ่งล้านภาพจากเงื่อนไขเดิมอาจให้รายละเอียดมากขึ้นในพื้นที่เดิม แต่ยังเว้นพื้นที่สำคัญไว้ การตรวจควรดูองค์ประกอบ เช่น สาขา เวลา อุปกรณ์ มุมกล้อง ประเภทสินค้า ภาษา และกลุ่มผู้ใช้ แล้วเปรียบเทียบกับบริบทที่ตั้งใจนำไปใช้
ข้อมูลยังพกการตัดสินใจของมนุษย์มาด้วย หากผู้ติดป้ายกำกับนิยาม “ป้ายหาย” ไม่เหมือนกัน บางคนมองป้ายเอียงว่าใช้ได้ บางคนมองว่าเสียหาย โมเดลจะได้รับสัญญาณที่ไม่สม่ำเสมอ ความไม่ชัดของงานจึงถูกฝังเข้าไปในผลลัพธ์ ก่อนโทษโมเดลต้องตรวจคู่มือการติดป้าย อัตราความเห็นตรงกัน และตัวอย่างกรณีขอบเขต
อีกปัญหาคือข้อมูลอดีตอาจสะท้อนกระบวนการเดิมที่ไม่เป็นธรรม เช่น สาขาที่มีทีมตรวจเข้มอาจมีบันทึกข้อผิดพลาดมากกว่า ทั้งที่คุณภาพจริงไม่ได้แย่กว่า หากนำจำนวนข้อผิดพลาดเดิมไปเป็นตัวแทนความเสี่ยง โมเดลอาจเรียนรู้ว่าบางสาขา “น่าสงสัย” เพราะถูกตรวจมาก ไม่ใช่เพราะมีปัญหามาก
Input ที่เห็น: ภาพชั้นสินค้าและป้ายกำกับว่าป้ายอยู่หรือหาย
Input ที่อาจหาย: สาขาต่างจังหวัด แสงน้อย กล้องรุ่นใหม่ ป้ายสองภาษา ช่วงโปรโมชัน และภาพที่พนักงานถ่ายรีบ ๆ
วิธีตรวจ: สร้างตาราง Coverage แยกตามปัจจัย ตรวจผลรายกลุ่ม และบันทึกเงื่อนไขที่ยังไม่มีหลักฐานแทนการรวมเป็นค่าเฉลี่ยเดียว
แนวคิด Datasheets for Datasets เสนอให้บันทึกแรงจูงใจ องค์ประกอบ กระบวนการเก็บ การใช้งาน และข้อจำกัดของชุดข้อมูล เพื่อให้ผู้ใช้รู้ว่าข้อมูลถูกสร้างมาอย่างไร เอกสารเช่นนี้ไม่ได้ทำให้ข้อจำกัดหาย แต่ทำให้ทีมเห็นและจัดการมันได้ก่อนผลกระทบเกิด
สิ่งที่โมเดลปรับให้ดีเป็นเพียงตัวแทนของเป้าหมาย
โมเดลต้องมีเกณฑ์ให้ปรับ ไม่ว่าจะเป็นการลดความผิดพลาด เพิ่มความแม่นยำ หรือจัดอันดับผลลัพธ์ เกณฑ์นี้เรียกว่า Objective หรือฟังก์ชันเป้าหมาย แต่เป้าหมายทางคณิตศาสตร์มักเป็นตัวแทนย่อของสิ่งที่องค์กรต้องการจริง
ShelfCheck อาจถูกฝึกให้ทายว่า “ป้ายอยู่” หรือ “ป้ายหาย” ให้ถูกมากที่สุด ทว่าร้านไม่ได้ต้องการเพียงเปอร์เซ็นต์คำตอบถูก ร้านต้องการลดป้ายผิดจริงโดยไม่เพิ่มภาระตรวจเกินเหตุ ไม่ทำให้พนักงานวิ่งแก้งานปลอม ไม่มองข้ามสาขาบางประเภท และแก้เหตุฉุกเฉินได้ทันเวลา Accuracy รวมจึงเป็นเพียงหน้าต่าง ไม่ใช่เป้าหมายทั้งหมด
สมมติข้อมูลมีภาพป้ายปกติ 98 ภาพและป้ายหาย 2 ภาพ ระบบที่ตอบว่า “ป้ายอยู่” ทุกภาพจะได้ Accuracy 98% แต่จับป้ายหายไม่ได้เลย ถ้าเหตุการณ์ที่พบยากเป็นเหตุการณ์สำคัญ ค่าเฉลี่ยสูงกลับปิดบังความล้มเหลว เราจึงต้องดู False Positive, False Negative, Precision, Recall และผลกระทบตามบริบท
False Positive ของ ShelfCheck คือแจ้งว่าป้ายหายทั้งที่ยังอยู่ ต้นทุนคือเวลาตรวจและความรำคาญ False Negative คือบอกว่าป้ายปกติทั้งที่หาย ต้นทุนอาจเป็นข้อมูลราคาไม่ครบและข้อร้องเรียน ทั้งสองแบบไม่จำเป็นต้องมีน้ำหนักเท่ากัน ทีมต้องกำหนดร่วมกับเจ้าของงาน ไม่ใช่ให้โมเดลตัดสินคุณค่าทางธุรกิจแทน
Metric ยังถูก “เล่นตามกติกา” ได้ หากทีมถูกวัดจากจำนวนงานที่ระบบปิดเร็ว อาจลด Threshold เพื่อสร้างงานน้อยลงและทำตัวเลขสวย แต่ปัญหาจริงหลุดรอดมากขึ้น หรือถ้าเน้นจับทุกกรณี ระบบอาจแจ้งเตือนจนคนเลิกสนใจ นี่คือเหตุผลที่ต้องใช้ Metric ของโมเดลร่วมกับ Metric ของผลลัพธ์จริง เช่น เวลาที่พนักงานใช้ อัตราป้ายผิดหลังตรวจ และข้อร้องเรียน
ตามกลไกของ ShelfCheck ตั้งแต่ภาพหนึ่งใบถึงผลจริง
การบอกว่า “AI ดูภาพแล้วรู้ว่าป้ายหาย” ข้ามขั้นสำคัญมากเกินไป ลองเปิดกล่องระบบออกเป็นหกช่วง ทุกช่วงมี Input, Process, Output, วิธีตรวจ และทางย้อนกลับของตนเอง
พนักงานหรือกล้องส่งภาพเข้าระบบ ซอฟต์แวร์ตรวจชนิดไฟล์ ขนาด แสง ความคม และข้อมูลสาขา หากภาพเสียควรขอถ่ายใหม่ก่อนเรียกโมเดล ไม่ควรบังคับให้โมเดลเดาจากข้อมูลที่ใช้ไม่ได้
ระบบครอปชั้นสินค้า ปรับขนาด และแปลงค่าสี ขั้นตอนนี้ต้องเหมือนกับตอนฝึก หาก Pipeline เปลี่ยน แม้ภาพต้นฉบับเดิม โมเดลอาจเห็นอินพุตคนละแบบ
โมเดลส่งคะแนนสำหรับคลาส “ป้ายอยู่” และ “ป้ายหาย” คะแนนเป็นผลจากรูปแบบที่เรียน ไม่ใช่คำรับรองว่ามีโอกาสจริงเท่ากับตัวเลขนั้น จึงต้องตรวจ Calibration ในข้อมูลใช้งาน
ทีมกำหนด Threshold เช่น สูงกว่าเกณฑ์จึงสร้างงาน ต่ำกว่าเกณฑ์จึงไม่ทำอะไร และช่วงกลางส่งให้คนตรวจ เกณฑ์นี้อยู่ในระบบรอบโมเดล ไม่ได้อยู่ในโมเดลเพียงอย่างเดียว
พนักงานเห็นภาพ เหตุผลประกอบ และทางเลือกยืนยัน ปฏิเสธ หรือขอภาพใหม่ Interface ต้องแสดงความไม่แน่นอนและไม่ใช้สีหรือข้อความที่ทำให้คำแนะนำดูเป็นคำสั่งเด็ดขาด
ทีมบันทึกว่าป้ายหายจริงหรือไม่ เวลาแก้ไข ผลกระทบ และเหตุการณ์ผิดปกติ ข้อมูล Feedback ต้องผ่านการตรวจคุณภาพก่อนนำไปฝึกใหม่ มิฉะนั้นระบบอาจเรียนซ้ำจากคำตัดสินที่ผิดของตนเอง
เมื่อเกิดปัญหา การแยกขั้นทำให้แก้ตรงจุด ภาพมืดต้องแก้การรับข้อมูล คะแนนไม่สัมพันธ์กับความถูกต้องต้องตรวจ Calibration งานเตือนมากเกินไปอาจต้องปรับ Threshold หรือ Workflow และคำตัดสินคนที่ไม่สม่ำเสมอต้องแก้คู่มือกับการฝึกผู้ใช้ ไม่ใช่ฝึกโมเดลใหม่ทุกครั้ง
กลไกนี้ยังชี้ว่า “โมเดลผ่าน QA” ไม่เท่ากับ “ระบบผ่าน QA” โมเดลอาจคำนวณถูกตามสเปก แต่ API ส่งรูปผิดสาขา หน้าจอซ่อนภาพต้นฉบับ หรือผู้ใช้ไม่มีเวลาตรวจ ผลสุดท้ายจึงผิดได้แม้โมเดลไม่เปลี่ยนเลย
เมื่อโลกเปลี่ยน ความสามารถเดิมอาจลดลง
Distribution Shift หมายถึงการกระจายของข้อมูลขณะใช้งานต่างจากข้อมูลที่ใช้ฝึกหรือทดสอบ คำว่า “การกระจาย” ในที่นี้ไม่จำเป็นต้องคำนวณสูตร ผู้เริ่มต้นคิดง่าย ๆ ว่า สัดส่วนและรูปแบบของสิ่งที่ระบบเห็นเปลี่ยนไป
การเปลี่ยนแบบแรกคือ Input เปลี่ยน เช่น กล้องใหม่ให้สีต่าง ภาพมีแสงสะท้อน หรือสาขาเริ่มใช้ป้ายสองภาษา ความสัมพันธ์ระหว่างภาพกับคำตอบอาจยังเหมือนเดิม แต่โมเดลต้องรับรูปลักษณ์ที่ไม่คุ้น การเปลี่ยนแบบที่สองคือความสัมพันธ์เปลี่ยน เช่น ร้านเปลี่ยนกฎว่าป้ายโปรโมชันแบบเก่าถือว่าไม่ถูกต้อง ภาพแบบเดียวกันจึงมีคำตอบอ้างอิงใหม่
การเปลี่ยนยังค่อย ๆ เกิดได้ สินค้าเปลี่ยนตามฤดูกาล กล้องเสื่อม เลนส์มีฝุ่น หรือพนักงานเปลี่ยนมุมถ่าย โมเดลอาจไม่พังทันที แต่ประสิทธิภาพลดทีละน้อยจนค่าเฉลี่ยรายเดือนกลบสัญญาณ หากรอข้อร้องเรียนอย่างเดียว ทีมจะรู้ช้าเกินไป
การเฝ้าระวังควรมีทั้ง Leading Indicator และ Outcome Indicator สัญญาณนำ เช่น สัดส่วนภาพเบลอ ความสว่าง ขนาดไฟล์ กล้องรุ่นใหม่ หรือคะแนนที่กระจุกผิดปกติ ช่วยเตือนก่อนรู้คำตอบจริง ส่วนตัวชี้วัดผล เช่น อัตรายืนยันโดยคน ป้ายผิดหลังตรวจ และข้อร้องเรียน บอกว่าระบบยังสร้างผลลัพธ์ที่ต้องการหรือไม่
งานวิจัยเรื่อง Predictive Uncertainty Under Dataset Shift พบว่าคุณภาพของค่าความไม่แน่นอนอาจเสื่อมเมื่อข้อมูลเปลี่ยน และวิธี Calibration หลังฝึกบางแบบไม่ได้คงประสิทธิภาพในทุกระดับของ Shift ข้อสรุปเชิงปฏิบัติคืออย่าตั้งกฎว่า “คะแนนต่ำจึงไม่มั่นใจ คะแนนสูงจึงปลอดภัย” โดยไม่ทดสอบกับสภาพที่เปลี่ยนจริง
- กล้องหรือกระบวนการถ่ายภาพเปลี่ยนโดยไม่ผ่านการทดสอบ
- สัดส่วนงานที่คนแก้คำตอบเพิ่มเกินเกณฑ์
- พบกลุ่มสาขาที่ผลต่างจาก Baseline อย่างต่อเนื่อง
- คะแนนสูงแต่ผิดบ่อยขึ้น หรือคำตอบกระจุกที่คลาสเดียว
- ไม่มีคำตอบอ้างอิงทันเวลา จนทีมประเมินผลจริงไม่ได้
คะแนนสูงไม่เท่ากับความจริงแน่นอน
โมเดลจำแนกภาพมักให้คะแนนแต่ละคลาสและเลือกค่าที่สูงที่สุด แต่คะแนนดังกล่าวเกิดจากการคำนวณภายใน ไม่ได้หมายความว่า “มั่นใจ 90% จึงถูก 90 ครั้งใน 100 ครั้ง” โดยอัตโนมัติ ความสัมพันธ์แบบนั้นต้องพิสูจน์ด้วย Calibration
โมเดลที่ Calibrated ดีควรมีแนวโน้มว่า ในกลุ่มตัวอย่างที่ให้ความมั่นใจประมาณ 80% จะตอบถูกใกล้ 80% เมื่อประเมินในบริบทเดียวกัน งานของ Guo และคณะในปี 2017 แสดงว่าโครงข่ายสมัยใหม่อาจมี Calibration ไม่ดีแม้ Accuracy สูง และเสนอ Temperature Scaling เป็นวิธีหลังฝึกที่เรียบง่ายในหลายชุดทดลอง แต่ผลนั้นไม่ได้รับประกันว่าจะคงเดิมเมื่อโลกเปลี่ยน
ยังมีความไม่แน่นอนอย่างน้อยสองมุม มุมแรกมาจากความกำกวมของข้อมูล เช่น ป้ายถูกบังครึ่งหนึ่ง แม้มีข้อมูลมากก็อาจแยกยาก มุมที่สองมาจากสิ่งที่โมเดลไม่เคยเรียนเพียงพอ เช่น รูปแบบป้ายใหม่ การเพิ่มความคมของภาพอาจช่วยมุมแรก แต่ไม่แก้ความไม่รู้มุมที่สองเสมอไป
Out-of-Distribution หรือ OOD คืออินพุตที่อยู่นอกการกระจายที่ระบบคุ้น เช่น ShelfCheck ได้รับภาพใบเสร็จแทนภาพชั้นสินค้า โมเดลบางตัวถูกบังคับให้เลือกคลาสที่ใกล้ที่สุดและอาจให้คะแนนสูง งานวิจัยด้าน OOD Detection จึงพยายามสร้างสัญญาณให้ระบบรู้ว่าตัวอย่างไม่เหมือนข้อมูลเดิม แต่ไม่มีตัวตรวจเดียวที่ครอบคลุมทุกโลกใหม่
ทางออกที่ใช้งานได้คือผสมหลายชั้น: ตรวจคุณภาพและชนิดภาพก่อนเรียกโมเดล ตรวจความใหม่ของอินพุต วัด Calibration ในกลุ่มใช้งานจริง สร้างช่วง Abstain หรือปฏิเสธการตอบ และส่งช่วงกำกวมให้มนุษย์ ที่สำคัญต้องวัดว่ากฎส่งต่อช่วยลดความเสียหายจริงหรือเพียงโยนงานให้คนมากขึ้น
คำตอบที่ลื่นไหลไม่ใช่ใบรับรองความจริง
ข้อจำกัดของ Generative AI มองยากกว่าระบบจำแนกภาพ เพราะผลลัพธ์เป็นภาษาที่อ่านลื่นและอธิบายเป็นเหตุเป็นผล โมเดลภาษาเรียนรูปแบบการต่อคำจากข้อมูลจำนวนมาก จึงสร้างประโยคที่ดูเหมาะกับบริบทได้โดยไม่ตรวจโลกภายนอกทุกข้อ
หากใช้ผู้ช่วยภาษาเขียนรายงาน ShelfCheck มันอาจสรุปว่า “สาขา A มีปัญหาเพราะกล้องรุ่นเก่า” ทั้งที่ข้อมูลมีเพียงอัตราคำตอบผิด ไม่ได้บันทึกรุ่นกล้อง หรืออาจสร้างชื่อเอกสารและตัวเลขที่ฟังน่าเชื่อแต่ไม่มีอยู่ NIST Generative AI Profile เรียกความเสี่ยงนี้ว่า Confabulation คือการสร้างเนื้อหาที่ผิดหรือเป็นเท็จอย่างมั่นใจ
ความสุภาพ ความยาว และรูปแบบอ้างอิงจึงเป็นคุณสมบัติด้านภาษา ไม่ใช่หลักฐาน งานที่ต้องแม่นควรผูกคำตอบกับแหล่งข้อมูลที่เปิดตรวจได้ ให้ระบบอ้างตำแหน่งต้นฉบับ แยกข้อความที่ดึงจากข้อมูลออกจากการตีความ และอนุญาตให้ตอบว่า “ข้อมูลไม่พอ”
แม้ใช้ Retrieval หรือค้นเอกสารก่อนตอบ ข้อจำกัดยังอยู่ เอกสารอาจล้าสมัย การค้นอาจหยิบส่วนผิด คำถามอาจกำกวม และโมเดลอาจสรุปเกินข้อความต้นฉบับ การออกแบบที่ดีจึงตรวจทั้งคุณภาพแหล่งค้น ความตรงของหลักฐาน และการสรุป ไม่ใช่ดูเพียงว่ามีลิงก์แนบมาหรือไม่
สำหรับเรื่องสุขภาพ กฎหมาย การเงิน สิทธิ หรือความปลอดภัย ห้ามใช้คำตอบดิบเป็นคำตัดสินสุดท้าย ควรกำหนดขอบเขตข้อมูล วันตรวจล่าสุด ผู้เชี่ยวชาญที่รับช่วง และข้อความเตือนที่บอกการกระทำถัดไปอย่างชัดเจน
คำอธิบายของโมเดลอาจช่วยชี้เบาะแส แต่ไม่พิสูจน์เหตุผล
ระบบบางแบบแสดง Heatmap ว่าพื้นที่ใดของภาพสัมพันธ์กับคำตอบ หรือเรียงคุณลักษณะที่มีอิทธิพลต่อคะแนน สิ่งเหล่านี้มีประโยชน์ในการตั้งคำถาม แต่ไม่จำเป็นต้องเป็น “เหตุผลที่แท้จริง” แบบเหตุและผล
ถ้า Heatmap ของ ShelfCheck เน้นบริเวณป้าย เราอาจอุ่นใจขึ้น แต่ยังต้องทดสอบว่าเมื่อเปลี่ยนพื้นหลังหรือปิดส่วนป้าย ผลเปลี่ยนตามที่คาดหรือไม่ โมเดลอาจใช้เงาสะท้อน ขอบชั้น หรือรูปแบบของสาขาเป็นทางลัดพร้อมกับมองป้ายไปด้วย ภาพอธิบายสวยจึงไม่ลบความจำเป็นของ Counterfactual Test และชุดทดสอบที่ออกแบบเฉพาะ
คำอธิบายยังอาจไม่เสถียร ภาพเปลี่ยนเพียงเล็กน้อยแล้วพื้นที่เด่นเปลี่ยนมาก หรือเครื่องมืออธิบายสองตัวให้เรื่องคนละแบบ ทีมควรบันทึกวิธี รุ่น เงื่อนไข และตรวจหลายตัวอย่าง ไม่เลือกเฉพาะภาพที่สนับสนุนเรื่องที่อยากเชื่อ
สำหรับโมเดลภาษา การขอให้ “อธิบายเหตุผลทีละขั้น” ไม่ได้เปิดหน้าต่างตรงเข้าสู่กระบวนการภายใน คำอธิบายที่สร้างขึ้นอาจเป็นเรื่องเล่าหลังคำตอบ การตรวจจึงต้องพึ่งหลักฐานภายนอก การทำซ้ำ เงื่อนไขทดสอบ และผลจริง มากกว่าความรู้สึกว่าคำอธิบายฟังดี
Explainability ช่วยตั้งคำถามกับระบบได้ดีขึ้น แต่ไม่ควรถูกใช้แทนการวัดผล การทดสอบขอบเขต และความรับผิดชอบของมนุษย์
ข้อจำกัดจำนวนมากเกิดนอกตัวโมเดล
เมื่อผลผิด คนมักชี้ไปที่โมเดลก่อน แต่ระบบ AI ประกอบด้วยคน ข้อมูล ซอฟต์แวร์ กฎ หน้าจอ การสื่อสาร และองค์กร ข้อจำกัดที่จุดใดจุดหนึ่งสามารถเปลี่ยนผลสุดท้ายได้
Input
ภาพเบลอ เซนเซอร์เสีย ข้อมูลมาช้า หรือ Metadata ผิด ทำให้โมเดลเห็นโลกคนละแบบกับที่ทีมคิด วิธีรับมือคือ Validation และทางขอข้อมูลใหม่
Pipeline
การครอป แปลงสี หรือจัดลำดับข้อมูลไม่ตรงกับตอนฝึก ทำให้ผลเปลี่ยนโดยโมเดลไม่เปลี่ยน ต้อง Version Pipeline และทดสอบแบบ End-to-end
Interface
หน้าจออาจซ่อนภาพต้นฉบับ ใช้สีเขียวกับคะแนนสูง หรือวางปุ่มยืนยันเด่นกว่าปุ่มแก้ ทำให้ผู้ใช้เชื่อตามระบบเกินไป
Workflow
หากพนักงานมีเวลาเพียงไม่กี่วินาที “Human in the Loop” อาจมีชื่อแต่ไม่มีการตรวจจริง ต้องวัดภาระงานและอำนาจตัดสินของคน
Feedback
การนำคำตอบของระบบกลับเป็น Label โดยไม่ตรวจอาจสร้างวงจรขยายความผิด ต้องแยกคำแนะนำของ AI ออกจากคำตอบยืนยันภายหลัง
Ownership
ถ้าไม่มีเจ้าของ Threshold, Monitoring, Incident และ Rollback ระบบจะค้างอยู่แม้ทุกคนเห็นปัญหา ความรับผิดชอบต้องระบุเป็นชื่อบทบาทและเวลา
ข้อจำกัดขององค์กรก็สำคัญ ทีมอาจไม่มีข้อมูลผลจริง ไม่มีผู้เชี่ยวชาญในช่วงกลางคืน หรือผู้ขายไม่เปิดเผยเวอร์ชันโมเดล สิ่งเหล่านี้ต้องอยู่ใน Risk Register และ Limit Statement ไม่ควรถูกซ่อนไว้เพราะไม่ใช่ปัญหาทางเทคนิค
NIST AI RMF แบ่งการจัดการเป็น Govern, Map, Measure และ Manage เพื่อย้ำว่าการกำกับ บริบท การวัด และการตอบสนองต้องเชื่อมกัน การทดสอบโมเดลเป็นส่วนหนึ่งของ Measure แต่การตัดสินว่าใครมีอำนาจหยุดอยู่ใน Govern และ Manage ด้วย
Failure Case: ทำไมคะแนนทดสอบดี แต่สาขาใหม่กลับพลาด
สมมติ ShelfCheck ได้คะแนน Recall สำหรับป้ายหาย 92% ในชุดทดสอบ ทีมจึงตั้ง Threshold และเปิดใช้กับสาขาใหม่โดยไม่เก็บ Pilot Label ช่วงแรก ตัวเลข 92% เป็น ตัวอย่างสมมติเพื่อการอธิบาย ไม่ใช่ผลทดสอบของระบบจริง
สัปดาห์แรก พนักงานพบงานแจ้งเตือนเพิ่มขึ้นมาก ทีมคิดว่าโมเดล “ขยัน” และยอมรับ ต่อมาพบว่ากล้องใหม่เพิ่ม Contrast อัตโนมัติจนขอบป้ายสว่างคล้ายช่องว่าง โมเดลใช้ทางลัดจากความสว่างซึ่งสัมพันธ์กับป้ายหายในข้อมูลเก่า จึงเกิด False Positive มาก
พร้อมกันนั้น ป้ายโปรโมชันแบบใหม่มีข้อความสองบรรทัดและถูกวางชิดสินค้า โมเดลเคยเห็นน้อย จึงมองข้ามป้ายหายบางประเภท เกิด False Negative แต่ทีมไม่เห็นทันที เพราะไม่มีการสุ่มตรวจภาพที่ระบบบอกว่า “ปกติ” การตรวจเฉพาะ Alert ทำให้รู้จักความผิดแบบหนึ่งและมองไม่เห็นอีกแบบ
คะแนน Confidence ยังสูงเพราะรูปแบบแสงใหม่ผลักค่าภายในไปทางคลาสหนึ่ง ไม่ได้หมายความว่าโมเดลรู้ว่ากล้องเปลี่ยน Dashboard แสดงค่าเฉลี่ยทุกสาขารวมกัน ผลของสาขาใหม่จึงถูกสาขาเดิมกลบ และ KPI ของทีมวัดจำนวนงานที่ปิด ไม่ได้วัดป้ายผิดหลังการตรวจ
นี่คือความล้มเหลวเชิงระบบหลายชั้น: ข้อมูลฝึกไม่ครอบคลุม, Distribution Shift, Shortcut Learning, Monitoring รวมกลุ่ม, Sampling ไม่ครบ และ Metric ไม่ตรงผลจริง หากแก้ด้วยการเพิ่มรูปผิดจากสาขาใหม่เพียงอย่างเดียว อาจดีขึ้นชั่วคราว แต่ปัญหากระบวนการตรวจยังอยู่
แผนกู้คืนควรหยุดการสร้างงานอัตโนมัติในสาขาใหม่ เปลี่ยนเป็นโหมดแนะนำ เก็บ Ground Truth ทั้ง Alert และ Non-alert แยกผลตามกล้องและประเภทป้าย ทดสอบ Pipeline ใหม่ ปรับ Threshold หลัง Calibration และกำหนด Rollback หากอัตราแก้คำตอบเกินเกณฑ์ จากนั้นค่อยขยายทีละสาขา
ถ้าสาเหตุคือ Contrast ของกล้อง ผลควรต่างตามรุ่นกล้องและลดลงเมื่อใช้ Pipeline ที่ควบคุม Contrast หากผลไม่เปลี่ยน สมมติฐานอาจผิด ต้องกลับไปดูมุมถ่าย ประเภทป้าย หรือกระบวนการติด Label อย่าเลือกคำอธิบายแรกแล้วหยุดทดสอบ
มนุษย์ไม่ได้มีไว้กด “ยืนยัน” แต่ต้องมีอำนาจและข้อมูลพอ
คำว่า Human in the Loop ฟังปลอดภัย แต่ถ้าคนเห็นเพียงคำตอบของ AI ไม่มีภาพต้นฉบับ ไม่มีเวลา ไม่มีทางปฏิเสธ หรือถูกวัดว่าต้องเห็นด้วยกับระบบ การมีคนอยู่ใน Workflow ไม่ได้สร้างการกำกับที่มีความหมาย
สำหรับ ShelfCheck ผู้ตรวจควรเห็นภาพเต็ม พื้นที่ที่ระบบสนใจ คะแนนพร้อมคำอธิบายว่าไม่ใช่ความน่าจะเป็นรับรอง ข้อมูลสาขา และตัวเลือก “ยืนยัน”, “ปฏิเสธ”, “ขอภาพใหม่”, “อยู่นอกขอบเขต” การเลือกอยู่นอกขอบเขตสำคัญเพราะไม่บังคับให้ทุกกรณีถูกยัดเข้าในสองคลาส
มนุษย์ยังมี Automation Bias คือแนวโน้มเชื่อตามคำแนะนำอัตโนมัติ โดยเฉพาะเมื่อระบบดูแม่นและงานซ้ำมาก Interface จึงควรลดการชี้นำ เช่น ไม่เลือกคำตอบไว้ล่วงหน้า สุ่มตรวจ Non-alert และแสดงตัวอย่างกรณีที่โมเดลมักพลาดในการฝึกผู้ใช้
ในงานที่กระทบคน ควรมีช่องอุทธรณ์ แก้ไข และระบุผู้รับผิดชอบ UNESCO Recommendation on the Ethics of AI ย้ำว่าความรับผิดชอบขั้นสุดท้ายต้องผูกกับบุคคลหรือนิติบุคคล ไม่ควรถูกผลักให้ระบบ AI เอง ข้อความว่า “AI ตัดสิน” จึงไม่ใช่คำตอบเรื่อง Accountability
บทบาทควรแบ่งชัด: เจ้าของผลิตภัณฑ์กำหนดวัตถุประสงค์และเกณฑ์หยุด ทีมข้อมูลดู Coverage ทีมโมเดลดูประสิทธิภาพและ Calibration ทีมปฏิบัติการดูภาระงาน ทีมกำกับดูผลกระทบและสิทธิ และผู้มีอำนาจอนุมัติการกลับมาใช้หลัง Incident
คำถามสุดท้ายคือมนุษย์ช่วยได้จริงหรือไม่ หากปริมาณงานเกินกำลังหรือการตัดสินต้องใช้ผู้เชี่ยวชาญที่ไม่มีในเวลานั้น ทางออกอาจเป็นการจำกัดขอบเขต ชะลอผล หรือไม่ใช้ AI ในส่วนนั้น ไม่ใช่ใส่คำว่า Human Review ลงในเอกสารแล้วถือว่าความเสี่ยงจบ
Limit Statement ที่ดีต้องช่วยตัดสินใจ ไม่ใช่คำเตือนกว้าง ๆ
ข้อความว่า “AI อาจผิดพลาด โปรดใช้วิจารณญาณ” จริงแต่ใช้การไม่ค่อยได้ เพราะไม่บอกว่าผิดแบบใด เกิดเมื่อไร และใครต้องทำอะไร Limit Statement ที่ดีควรเป็นคู่มือปฏิบัติย่อสำหรับผู้ใช้ ผู้ดูแล และผู้อนุมัติ
ระบุ Task, ผู้ใช้ และผลลัพธ์ เช่น “ช่วยคัดกรองภาพชั้นสินค้าเพื่อเสนอจุดที่ควรตรวจ โดยพนักงานร้านเป็นผู้ยืนยันก่อนสร้างงานแก้ไข”
ระบุขอบเขตต้องห้าม เช่น “ห้ามใช้ผลลัพธ์ตัดสินความผิดของพนักงาน ห้ามใช้กับภาพจากกล้องที่ยังไม่ผ่านการทดสอบ และห้ามปิดงานโดยไม่มีคนตรวจ”
บอกสาขา เวลา ภาษา อุปกรณ์ ประเภทป้าย ช่วงวันที่ และเวอร์ชัน Pipeline ที่อยู่ในชุดประเมิน รวมสิ่งที่ยังขาด
อธิบาย False Positive, False Negative, กลุ่มที่ผลต่าง และต้นทุนของแต่ละแบบ ไม่ใช้ค่าเฉลี่ยอย่างเดียว
กำหนดคุณภาพภาพ คะแนน OOD, Threshold, สัญญาณ Shift, Incident และผู้รับผิดชอบ พร้อมเวลาในการตอบสนอง
ระบุตัวชี้วัดผลจริง ความถี่ทบทวน เวอร์ชันล่าสุด และเงื่อนไขที่ต้องประเมินใหม่ เช่น เปลี่ยนกล้อง ป้าย หรือสาขา
ShelfCheck ใช้เสนอภาพที่อาจมีป้ายราคาหายจากกล้องและรูปแบบป้ายที่ระบุในเวอร์ชันประเมิน พนักงานต้องยืนยันก่อนสร้างงาน ห้ามใช้ประเมินผลงานบุคคลหรือกับสาขา/อุปกรณ์ใหม่ที่ยังไม่มีผลทดสอบ ระบบอาจแจ้งเกินเมื่อแสงสะท้อนและพลาดป้ายสองภาษาบางรูปแบบ หากภาพไม่ผ่าน Quality Gate, พบ OOD, อัตราแก้คำตอบเกินเกณฑ์ หรือผลรายสาขาต่ำกว่า Baseline ให้หยุด Auto-action และส่งทีมปฏิบัติการตรวจ ทบทวนอย่างน้อยรายเดือนและทุกครั้งที่ข้อมูลหรือ Pipeline เปลี่ยน
Limit Statement ควรอยู่ใกล้จุดใช้งาน ไม่ถูกฝังในเอกสารยาวเพียงแห่งเดียว และต้อง Version ตามโมเดล ข้อมูล และ Workflow เมื่อเงื่อนไขเปลี่ยน ข้อความเดิมอาจกลายเป็นข้อมูลผิดได้
Readiness Checklist ก่อนปล่อย AI ทำงานจริง
Checklist นี้ไม่ได้ถามว่า “มีเอกสารหรือยัง” เท่านั้น แต่ถามถึงหลักฐาน เจ้าของ เกณฑ์ผ่าน และทางแก้เมื่อไม่ผ่าน ลองตอบให้ได้ทุกข้อก่อนเพิ่มอำนาจให้ระบบ
- งานและผลกระทบ: เราระบุ Task, ผู้ใช้ ผู้ได้รับผลกระทบ และความเสียหายจาก False Positive/Negative แล้วหรือยัง? ถ้ายัง ให้หยุดกำหนด Threshold
- Coverage: มีตารางว่าข้อมูลครอบคลุมเวลา พื้นที่ ภาษา อุปกรณ์ และกลุ่มใด พร้อมช่องว่างหรือไม่? ถ้ายัง ให้จำกัด Pilot
- Baseline: เปรียบเทียบกับวิธีเดิมหรือการไม่ใช้ AI ด้วยเกณฑ์เดียวกันหรือไม่? ถ้ายัง เราไม่รู้ว่า AI เพิ่มคุณค่าจริงหรือเพียงเพิ่มขั้นตอน
- Metric หลายมิติ: วัดทั้งประสิทธิภาพโมเดล ผลลัพธ์จริง ภาระงาน และผลต่างรายกลุ่มหรือไม่? ถ้ายัง ค่าเฉลี่ยอาจซ่อนปัญหา
- Uncertainty/OOD: คะแนนผ่าน Calibration ในบริบทใช้งาน และมีทาง Abstain หรือไม่? ถ้ายัง ห้ามตีความคะแนนเป็นโอกาสจริง
- Human Review: คนมีข้อมูล เวลา ทักษะ และอำนาจปฏิเสธหรือหยุดหรือไม่? ถ้ายัง Human in the Loop เป็นเพียงป้าย
- Monitoring: มี Leading Indicator, Outcome Indicator, เกณฑ์เตือน และเจ้าของ Dashboard หรือไม่? ถ้ายัง จะรู้ปัญหาหลังผลเสียเกิด
- Recovery: มี Rollback, Manual fallback, Incident channel และเวลาตอบสนองหรือไม่? ถ้ายัง อย่าเปิด Auto-action
- Documentation: Limit Statement, Dataset record, Model/System card และ Change log ตรงเวอร์ชันจริงหรือไม่? ถ้ายัง ผู้ใช้กำลังตัดสินจากข้อมูลเก่า
- Review date: ระบุวันทบทวนและเหตุการณ์ที่บังคับให้ประเมินใหม่หรือไม่? ถ้ายัง การอนุมัติครั้งเดียวอาจถูกใช้ตลอดไป
การ “ไม่ผ่าน” Checklist ไม่ได้แปลว่าต้องยกเลิกโครงการเสมอไป อาจลดอำนาจจากอัตโนมัติเป็นคำแนะนำ จำกัดเฉพาะกลุ่มที่มีหลักฐาน เพิ่มการสุ่มตรวจ หรือสร้าง Pilot ที่เก็บผลจริงก่อนขยาย จุดสำคัญคือให้ขอบเขตตามหลักฐาน ไม่ให้ความทะเยอทะยานนำหน้าความเข้าใจ
ความเข้าใจผิดที่ทำให้เราเชื่อ AI เกินหลักฐาน
กลไกที่ทำให้คิดเช่นนั้น: ตัวเลขเดียวสื่อสารง่ายและลืมเงื่อนไขของชุดทดสอบ
สิ่งที่ถูกต้อง: คะแนนรองรับบริบทที่ข้อมูลและการประเมินครอบคลุม
วิธีตรวจ: แยกผลตามสาขา เวลา อุปกรณ์ กลุ่ม และทดสอบ Shift ที่คาดได้
กลไกที่ทำให้คิดเช่นนั้น: ปริมาณถูกใช้แทน Coverage และคุณภาพ
สิ่งที่ถูกต้อง: ข้อมูลมากจากพื้นที่เดิมยังทิ้งโลกส่วนอื่นไว้ และอาจขยาย Label ผิด
วิธีตรวจ: ทำ Coverage Matrix, Data Quality Audit และทบทวนนิยาม Label
กลไกที่ทำให้คิดเช่นนั้น: หน้าจอแสดงเป็นเปอร์เซ็นต์จึงดูเหมือนความน่าจะเป็นที่สอบเทียบแล้ว
สิ่งที่ถูกต้อง: คะแนนต้องผ่าน Calibration และอาจเสื่อมเมื่อข้อมูลเปลี่ยน
วิธีตรวจ: ใช้ Reliability Diagram หรือ Calibration metric ในข้อมูลเป้าหมายและติดตามหลัง Deploy
กลไกที่ทำให้คิดเช่นนั้น: นับการมีมนุษย์ แต่ไม่วัดคุณภาพการตัดสิน
สิ่งที่ถูกต้อง: คนต้องมีข้อมูล เวลา อำนาจ และช่องทางแก้
วิธีตรวจ: วัดเวลา Review, อัตราเห็นต่าง, คุณภาพคำตัดสิน และภาระงาน
กลไกที่ทำให้คิดเช่นนั้น: คำอธิบายที่เป็นภาพหรือภาษาให้ความรู้สึกโปร่งใส
สิ่งที่ถูกต้อง: คำอธิบายเป็นหลักฐานอีกชิ้น ไม่ใช่การพิสูจน์เหตุและผล
วิธีตรวจ: ใช้ Perturbation, Counterfactual, หลายวิธีอธิบาย และผลจริงร่วมกัน
แบบฝึก: เขียน “บัตรขอบเขตการใช้งาน” ให้ AI หนึ่งระบบ
สิ่งที่ต้องเลือก: เลือก AI ที่คุณใช้หรือพบเห็นหนึ่งระบบ เช่น ตัวช่วยเขียน ระบบแนะนำสินค้า ระบบคัดกรองเอกสาร หรือระบบจำแนกภาพ หลีกเลี่ยงการเขียนกว้างว่า “Chatbot” โดยไม่บอกงาน
- เขียน Task: ระบบรับ Input อะไร ส่ง Output อะไร และมนุษย์นำผลไปทำอะไรต่อ
- ระบุขอบเขตหลักฐาน: ผ่านการทดสอบกับภาษา เวลา อุปกรณ์ กลุ่ม หรือประเภทข้อมูลใด และอะไรยังไม่รู้
- วาดเส้นทาง: Input → Validation → Model → Rule/Threshold → Human → Action → Feedback
- สร้าง Failure Case สองแบบ: อย่างน้อยหนึ่ง False Positive และหนึ่ง False Negative พร้อมคนที่ได้รับผล
- ตั้งจุดส่งต่อ: เขียนสัญญาณอย่างน้อยสามข้อที่ทำให้ระบบปฏิเสธ ขอข้อมูลเพิ่ม หรือให้มนุษย์รับช่วง
- กำหนด Monitoring: เลือกสัญญาณนำหนึ่งตัวและตัวชี้วัดผลจริงหนึ่งตัว ระบุผู้ดูและความถี่
- เขียนข้อห้าม: ระบุการใช้หนึ่งแบบที่ระบบไม่ควรทำ แม้ทางเทคนิคจะส่งผลลัพธ์ได้
หลักฐานว่าทำสำเร็จ: เพื่อนที่ไม่รู้ระบบมาก่อนอ่านแล้วตอบได้ว่า ใช้ทำอะไร ห้ามใช้ทำอะไร ผิดแบบใด และเมื่อไรต้องหยุด โดยไม่ต้องเดาจากชื่อโมเดล
คำถามอธิบาย Why/How: ถ้าข้อมูลเปลี่ยนหนึ่งอย่าง ข้อสรุปใดในบัตรต้องเปลี่ยน? เหตุใด Threshold เดิมจึงอาจใช้ไม่ได้? มนุษย์ในระบบมีอำนาจแก้อะไรจริง?
Recovery Step: ถ้าไม่มีข้อมูลการทดสอบ ให้เขียนว่า “ยังไม่มีหลักฐาน” และออกแบบ Pilot ขนาดเล็กแทนการเติมตัวเลขสมมติ หากไม่รู้เจ้าของ ให้ทำเป็นคำถามที่ต้องปิดก่อน Deploy
คำถามที่พบบ่อยเกี่ยวกับข้อจำกัดของ AI
AI ทุกชนิดมีข้อจำกัดเหมือนกันหรือไม่?
มีหลักร่วมคือผูกกับข้อมูล เป้าหมาย และบริบท แต่รูปแบบต่างกัน ระบบกฎจำกัดด้วยกฎที่เขียน ระบบ Machine Learning จำกัดด้วยข้อมูลและวิธีเรียน Generative AI เพิ่มความเสี่ยงด้านการสร้างเนื้อหาที่ดูจริง ส่วนระบบที่ลงมือกระทำผ่านเครื่องมือเพิ่มความเสี่ยงจากสิทธิ์และผลกระทบ ควรเริ่มจาก Task และระบบจริง ไม่ใช้รายการข้อจำกัดเดียวครอบทุกอย่าง
ถ้าคะแนนแม่น 99% ยังต้องมีคนตรวจหรือไม่?
ต้องดูความรุนแรงของ 1% ที่ผิด ความถี่ใช้งาน การกระจายข้อผิดพลาด และความย้อนกลับได้ งานคัดภาพเพื่อช่วยค้นอาจยอมรับต่างจากการปฏิเสธสิทธิ นอกจากนี้ 99% ในชุดทดสอบไม่ได้รับรองข้อมูลใหม่ ทางเลือกอาจไม่ใช่ตรวจทุกกรณี แต่ออกแบบ Risk-based Review เช่น ตรวจช่วงกำกวม กลุ่มใหม่ และสุ่ม Non-alert
เราทำให้ AI ไม่มีข้อผิดพลาดได้ไหม?
ในโลกเปิดและงานซับซ้อน ไม่ควรสัญญาศูนย์ความผิดพลาด เป้าหมายคือรู้รูปแบบความผิด ลดโอกาสและผลเสีย ตรวจพบเร็ว และมีทางกู้คืน บางงานที่มีกฎแคบอาจทดสอบครอบคลุมมาก แต่การเปลี่ยนข้อมูล ซอฟต์แวร์ หรือมนุษย์ยังสร้างความเสี่ยงได้
ระบบบอกว่า “ไม่รู้” ได้จริงหรือ?
ออกแบบให้ Abstain หรือส่งต่อได้ผ่าน Threshold, OOD signal, Quality Gate และกฎธุรกิจ แต่สัญญาณเหล่านี้ก็มีข้อจำกัด ต้องทดสอบว่าเมื่อไม่รู้จริง ระบบปฏิเสธได้ดีเพียงใด และไม่ปฏิเสธบางกลุ่มมากเกินไป การมีคำว่า “ไม่รู้” จึงเป็นคุณสมบัติที่ต้องวัด ไม่ใช่ข้อความตกแต่ง
ควรอัปเดต Limit Statement บ่อยแค่ไหน?
อย่างน้อยตามรอบที่กำหนดและทุกครั้งที่มี Trigger เช่น เปลี่ยนโมเดล ข้อมูล กล้อง ภาษา กลุ่มผู้ใช้ Threshold, Interface หรือวัตถุประสงค์ รวมถึงหลัง Incident เอกสารต้องมี Version และวันตรวจล่าสุด เพื่อไม่ให้คำเตือนเก่าถูกใช้กับระบบใหม่
ข้อจำกัดกับความเสี่ยงจาก AI ต่างกันอย่างไร?
ข้อจำกัดบอกขอบเขตของความสามารถหรือหลักฐาน ความเสี่ยงบอกผลเสียที่อาจเกิดเมื่อระบบถูกใช้ภายใต้สถานการณ์หนึ่ง ข้อจำกัดเดียวอาจเสี่ยงน้อยในงานช่วยค้นและเสี่ยงมากในงานตัดสินสิทธิ หัวข้อถัดไปจะต่อยอดจากขอบเขตไปสู่การประเมินโอกาส ความรุนแรง ผู้ได้รับผล และการควบคุม
แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่ดีที่สุดให้ครบทั้งห้าข้อ แล้วกด ตรวจคำตอบ ระบบจะแสดงคะแนนรวม เฉลย และเหตุผลรายข้อ หากเว้นว่างจะบอกจำนวนข้อที่ยังไม่ได้ตอบ
บทสรุป: รู้ขอบเขตจึงใช้ความสามารถได้เต็มที่
กลับมาที่เช้าวันจันทร์ของ ShelfCheck ปัญหาไม่ได้เกิดเพราะ AI “ไม่มีประโยชน์” และไม่ได้แก้ด้วยการเชื่อคะแนนเดิมต่อ ความผิดเกิดเมื่อทีมย้ายความสามารถที่พิสูจน์ในเงื่อนไขหนึ่งไปใช้ในโลกที่เปลี่ยน โดยไม่ตรวจว่าขอบเขตหลักฐานยังอยู่หรือไม่
โมเดลเห็นตัวอย่าง ไม่ได้เห็นโลกทั้งหมด มันปรับตาม Objective ที่เป็นตัวแทนของเป้าหมาย ให้คะแนนที่อาจไม่ Calibrated และทำงานอยู่ในระบบที่มี Input, Pipeline, Interface, คน และ Feedback ข้อจำกัดจึงไม่ได้อยู่ในกล่องโมเดลเพียงจุดเดียว
Mental Model ที่ควรจำคือ ขอบเขต → สัญญาณ → จุดส่งต่อ → ผลจริง เริ่มจากระบุขอบเขตที่ผ่านการทดสอบ เฝ้าสัญญาณว่าข้อมูลหรือผลเปลี่ยน กำหนดจุดที่ AI ต้องปฏิเสธหรือให้มนุษย์รับช่วง แล้วตรวจผลจริงเพื่อทบทวนขอบเขตอีกครั้ง
เมื่อคุณตอบได้ว่า AI ระบบหนึ่งใช้ทำอะไร ผ่านกับข้อมูลใด ไม่เห็นอะไร พลาดแบบไหน กระทบใคร เมื่อไรต้องหยุด และใครรับผิดชอบ คุณไม่ได้เพียงรู้ว่า “AI มีข้อจำกัด” แต่มีวิธีจัดการข้อจำกัดให้กลายเป็นการตัดสินใจที่ตรวจสอบได้
ภาพสรุป: AI ทำงานภายในขอบเขตที่ผ่านการทดสอบ
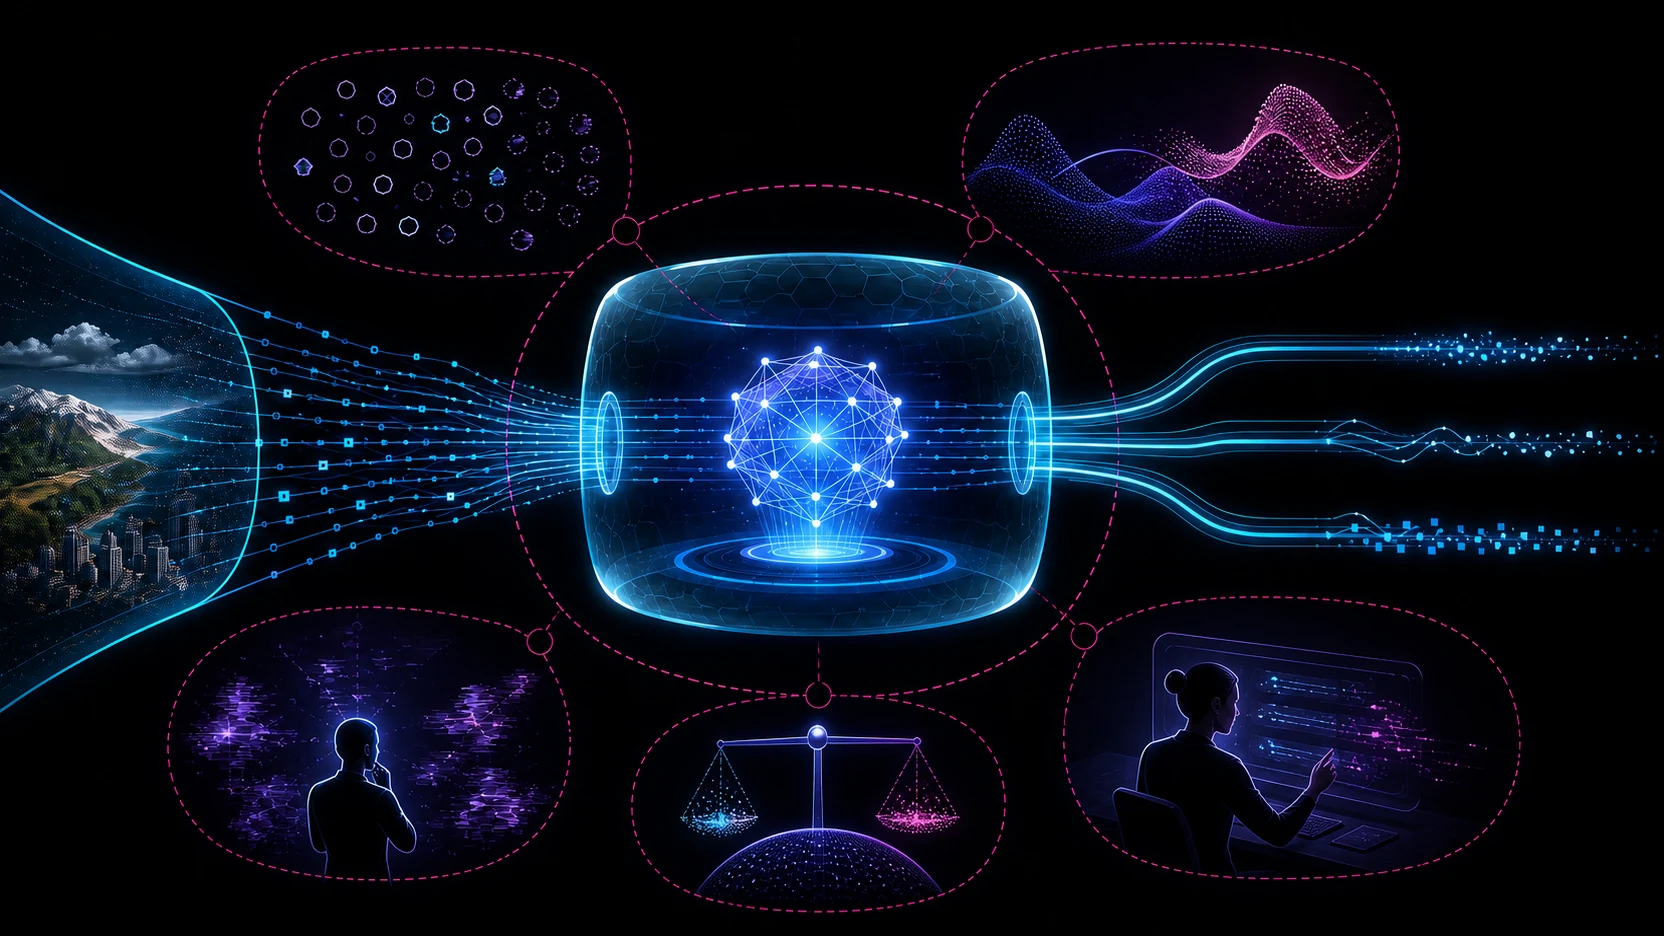
อ่านภาพจากซ้ายไปขวา: โลกจริงส่งข้อมูลเข้ามา แต่โมเดลตรงกลางรองรับเฉพาะรูปแบบที่เคยเห็นและผ่านการทดสอบ เส้นผลลัพธ์ด้านขวาแยกเป็นผลที่นิ่ง ผลที่กำกวม และผลที่แตกกระจาย
วงรอบนอกห้าวง: แทนข้อมูลที่หายไป การกระจายที่เปลี่ยน ความไม่แน่นอน เป้าหมายที่ให้น้ำหนักไม่ครบ และกระบวนการตรวจโดยมนุษย์ ทุกวงเชื่อมกลับมายังขอบเขตเดียวกันเพื่อย้ำว่าไม่มี Failure Case ใดแยกขาดจากระบบ
เรียนต่ออย่างไร
หัวข้อนี้ตอบว่า AI มีขอบเขตตรงไหน หัวข้อ 25 จะต่อยอดเป็น ความเสี่ยงจากการใช้ AI โดยถามต่อว่า เมื่อข้อจำกัดเจอสถานการณ์จริง ใครอาจเสียหาย ความเสียหายรุนแรงแค่ไหน และเราควรวางการควบคุมระดับใด
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงหลักและหมายเหตุบรรณาธิการ
- NIST — Artificial Intelligence Risk Management Framework (AI RMF 1.0) — กรอบจัดการความเสี่ยง AI ตามบริบทและวงจรชีวิต
- NIST AI RMF Playbook — แนวทางเชิงปฏิบัติสำหรับ Govern, Map, Measure และ Manage รวมถึงข้อจำกัดและ Human Oversight
- NIST AI 600-1 — Generative AI Profile — ความเสี่ยงเฉพาะของ Generative AI รวม Confabulation และการประเมินตลอดวงจรชีวิต
- Guo et al. (2017) — On Calibration of Modern Neural Networks — หลักฐานเรื่อง Calibration และ Temperature Scaling ในชุดทดลองของงานวิจัย
- Ovadia et al. (2019) — Predictive Uncertainty Under Dataset Shift — การเปรียบเทียบค่าความไม่แน่นอนเมื่อข้อมูลเปลี่ยน
- Hendrycks & Gimpel (2016) — Detecting Misclassified and Out-of-Distribution Examples — งานฐานด้านการตรวจตัวอย่างผิดและนอกการกระจาย
- Gebru et al. — Datasheets for Datasets — แนวทางบันทึกแรงจูงใจ องค์ประกอบ การเก็บ และการใช้งานชุดข้อมูล
- OECD AI Principle — Robustness, Security and Safety — การประเมินและจัดการความเสี่ยงตลอดอายุระบบ พร้อมกลไก Override และ Decommission
- UNESCO Recommendation on the Ethics of Artificial Intelligence — Human Oversight, Accountability, Monitoring และการคุ้มครองสิทธิ
ตรวจข้อมูลล่าสุด: 9 สิงหาคม 2026 · NIST ระบุว่า AI RMF 1.0 อยู่ระหว่างการปรับปรุง จึงอ้างตามเวอร์ชัน 1.0 และหน้าแหล่งข้อมูลทางการ ณ วันที่ตรวจ
ขอบเขตหลักฐาน: ShelfCheck, ชื่อสาขา เหตุการณ์ และตัวเลข 92% เป็นกรณีสมมติเพื่อการอธิบาย ไม่ใช่ระบบหรือผลทดลองจริง ข้อเสนอด้าน Calibration/OOD ต้องทดสอบใหม่กับข้อมูลเป้าหมายของแต่ละระบบ
การทบทวน: เนื้อหาผ่านการตรวจข้อเท็จจริงและ Thai Editorial แบบอ่านต่อเนื่อง โดยแยกข้อเท็จจริงจากตัวอย่าง การตีความ และคำแนะนำ
