วันแรกที่ทีมมหาวิทยาลัยประชุมเรื่องผู้ช่วย AI ทุกคนเห็นภาพปลายทางคล้ายกัน: นักศึกษาถามเรื่องลงทะเบียน ระบบค้นระเบียบ ร่างคำตอบ และเจ้าหน้าที่กดส่ง ทีมจึงรีบคุยเรื่องโมเดล ฐานข้อมูล และวันเปิดใช้งาน แต่ยังไม่มีใครตอบชัดว่า ถ้าระเบียบเปลี่ยนใครจะอัปเดตข้อมูล ถ้าคำตอบผิดใครหยุดระบบ ถ้าบริการภายนอกเปลี่ยนรุ่นใครทดสอบซ้ำ หรือเมื่อโครงการไม่คุ้มแล้วจะถอนระบบกับข้อมูลอย่างไร
ภาพนี้เกิดขึ้นบ่อย เพราะเรามักวางแผนโครงการ AI เหมือนสร้างฟีเจอร์ทั่วไป: กำหนดงาน พัฒนา ทดสอบ แล้วเปิดใช้ แต่ AI เรียนรู้หรืออาศัยรูปแบบจากข้อมูล ทำงานอยู่ในบริบทที่เปลี่ยน และอาจมีผลกระทบที่มองไม่เห็นในห้องทดลอง การเปิดใช้จึงไม่ใช่ตอนจบ แต่เป็นจุดเริ่มของหลักฐานชุดใหม่จากโลกจริง
วงจรชีวิตของโครงการ AI คือการจัดงานตั้งแต่กำหนดโจทย์ ตรวจทางเลือก เตรียมข้อมูล พัฒนา ประเมิน อนุมัติ นำขึ้นใช้ ติดตาม ปรับปรุง จนถึงเลิกใช้ ให้ทุกช่วงมีผลส่งมอบ เจ้าของงาน เกณฑ์ผ่าน และทางถอยของตนเอง บทเรียนนี้ใช้กรณีสมมติชื่อ Campus Help เป็นเส้นเรื่องเดียว เพื่อให้เราเห็นว่าคำถามหนึ่งข้อเดินทางผ่านวงจรอย่างไร และเหตุใดลูกศรย้อนกลับจึงสำคัญพอ ๆ กับลูกศรไปข้างหน้า
อ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบายขั้นหลักของวงจรชีวิตโครงการ AI และเหตุผลที่วงจรต้องมีลูกศรย้อนกลับได้
- ระบุผลส่งมอบ เจ้าของงาน และเกณฑ์ Go/No-Go ในแต่ละช่วงได้
- แยกการประเมินก่อนใช้ ออกจาก Monitoring หรือการติดตามหลังใช้ได้
- วาง Feedback, Incident Response, Rollback และ Stop Rule ลงในแผนโครงการได้
- วิเคราะห์ Failure Case ว่าควรย้อนกลับไปแก้โจทย์ ข้อมูล โมเดล ขั้นตอนคน หรือการนำขึ้นใช้ได้
- ร่างแผนเลิกใช้ที่ครอบคลุมระบบ ข้อมูล สิทธิ์ การสื่อสาร และบริการปลายทางได้
1. ภาพจำที่ถูกต้อง: วงจรชีวิตคือการวิ่งผลัด ไม่ใช่สายพานทางเดียว
ลองนึกถึงทีมวิ่งผลัด นักวิ่งแต่ละคนไม่ได้เพียงวิ่งให้เร็ว แต่ต้องรับไม้ในเขตที่กำหนด รู้ว่าใครส่ง รู้ว่าใครรอรับ และมีกรรมการตัดสินว่าการส่งไม้ถูกกติกาหรือไม่ โครงการ AI ก็คล้ายกัน ช่วงกำหนดโจทย์ส่ง Requirement และขอบเขตให้ทีมข้อมูล ช่วงข้อมูลส่งชุดข้อมูลกับข้อจำกัดให้ทีมพัฒนา ช่วงพัฒนาส่งรุ่นระบบและผลทดลองให้ทีมประเมิน ช่วงประเมินส่งหลักฐานกับความเสี่ยงคงเหลือให้ผู้อนุมัติ แล้วฝ่ายปฏิบัติการรับไม้ไปดูแลโลกจริง
แต่ภาพเปรียบเทียบนี้มีข้อจำกัด การแข่งขันวิ่งมีเส้นชัยเดียว ขณะที่โครงการ AI ต้องวนกลับ เมื่อข้อมูลเปลี่ยน เหตุการณ์ใหม่เกิด หรือผลกระทบไม่ตรงกับเป้าหมาย เราอาจต้องย้อนจาก Monitoring ไปแก้ข้อมูล หน้าจอ หรือแม้แต่ Problem Statement คำว่า Feedback Loop จึงหมายถึงเส้นทางที่ข้อมูลจากการใช้งานจริงกลับไปเปลี่ยนการตัดสินใจในรอบถัดไป ไม่ใช่เพียงกล่องรับความคิดเห็นท้ายหน้า
Campus Help ช่วยให้เห็นวงจรนี้ชัด ทีมอาจพบหลัง Pilot ว่าโมเดลร่างคำตอบถูก แต่เจ้าหน้าที่ใช้เวลาตรวจนานกว่าเดิม เพราะแหล่งอ้างอิงซ่อนอยู่หลังหลายคลิก ปัญหานี้ไม่ควรแก้ด้วยการฝึกโมเดลใหม่ทันที ลูกศรต้องย้อนกลับไปยังการออกแบบหน้าจอและขั้นตอนงาน การรู้ว่าจะย้อนกลับไปแก้ช่วงใดคือความสามารถหลักของทีมที่ดูแลวงจรชีวิต ไม่ใช่การพยายามเดินหน้าไป Deploy ทุกครั้ง
ประโยคที่ควรจำ: ทุกลูกศรในวงจรต้องมีผู้ส่ง ผู้รับ หลักฐานที่ส่งมอบ เกณฑ์ผ่าน และคำตอบว่า “ถ้าไม่ผ่านจะย้อนกลับไปไหน”
| สิ่งที่มอง | คำถามระดับโมเดล | คำถามระดับระบบ | หลักฐานที่ต้องมี |
|---|---|---|---|
| อินพุต | โมเดลรับข้อความหรือเวกเตอร์รูปแบบใด | ข้อมูลมาจากใคร ผ่านการทำความสะอาดและขอสิทธิ์อย่างไร | Data Sheet, Schema, Provenance และตัวอย่างข้อมูลจริง |
| การประมวลผล | โมเดลสร้างคะแนนหรือข้อความอย่างไร | มีตัวค้น กฎ เครื่องมือ หรือโมเดลอื่นเปลี่ยนผลระหว่างทางหรือไม่ | Architecture Diagram, Version และ Test Case |
| เอาต์พุต | คะแนนมีความหมายทางสถิติอย่างไร | ใครเห็นผล ใครกดส่ง และผลนำไปสู่อะไร | หน้าจอจริง Decision Log และสิทธิ์อนุมัติ |
| ความล้มเหลว | โมเดลพลาดกับตัวอย่างแบบใด | ระบบตรวจพบ จำกัดผลกระทบ หยุด และฟื้นกลับอย่างไร | Alert, Incident Playbook, Rollback และเจ้าของเหตุการณ์ |
2. กำหนดโจทย์และทางเลือก: ก่อนถามว่าใช้โมเดลอะไร ให้ถามว่าควรใช้ AI หรือไม่
ระบบ AI ไม่ควรเริ่มจากคำถามว่า “จะใช้โมเดลอะไร” แต่เริ่มจากคำถามว่า “เราต้องการช่วยใครทำงานใด ภายใต้ข้อจำกัดอะไร” Campus Help อาจตั้งเป้ากว้างว่า “ตอบนักศึกษาให้เร็วขึ้น” แต่เป้าหมายนี้ยังไม่บอกว่าตอบเรื่องใดได้ ใครเป็นผู้ใช้ คำตอบเร็วแค่ไหนจึงมีคุณค่า หรือความผิดพลาดแบบใดรับไม่ได้ หากทีมต่างคนต่างตีความ เป้าหมายเดียวกันอาจกลายเป็นสามระบบที่วัดผลคนละเรื่อง
เราจึงเขียนขอบเขตให้ชัดขึ้นว่า “ช่วยเจ้าหน้าที่ค้นเอกสารที่ประกาศใช้แล้วและร่างคำตอบสำหรับคำถามลงทะเบียนทั่วไป โดยเจ้าหน้าที่ต้องตรวจทุกคำตอบก่อนส่ง ระบบห้ามตัดสินสิทธิ์ ยกเว้นค่าธรรมเนียม หรือสถานะทางวินัย และต้องส่งต่อกรณีเร่งด่วนหรือไม่แน่ใจ” ประโยคนี้ระบุผู้ใช้ งาน เอาต์พุต คนอนุมัติ สิ่งที่ห้ามทำ และเส้นทางส่งต่อ ทำให้ทีมข้อมูล วิศวกร นักออกแบบ และเจ้าของนโยบายสร้างหลักฐานไปในทิศเดียวกัน
เป้าหมายยังต้องเชื่อมกับผลลัพธ์ของมนุษย์ ถ้าเวลาตอบเฉลี่ยลดลง แต่คำตอบผิดทำให้นักศึกษาพลาดกำหนดการ ระบบไม่สำเร็จ ถ้าเจ้าหน้าที่ทำงานเร็วขึ้นแต่ต้องอ่านคำตอบยาวกว่าเดิมหรือเชื่อผลมากเกินไป คุณค่าอาจน้อยกว่าที่ Dashboard แสดง เราจึงแยก Metric อย่างน้อยสี่ระดับ: คุณภาพของโมเดล ประสิทธิภาพ End-to-End ประสบการณ์ของผู้ใช้ และผลกระทบที่เกิดกับคน
Boundary หรือขอบเขตการใช้งานเป็นส่วนหนึ่งของคุณภาพ ไม่ใช่คำเตือนตัวเล็กท้ายหน้า ระบบที่ประกาศชัดว่ารองรับคำถามลงทะเบียนทั่วไปภาษาไทยในปีการศึกษาปัจจุบัน อาจน่าเชื่อถือกว่าระบบที่อ้างว่าตอบทุกเรื่อง แต่ไม่มีการทดสอบทุกบริบท ขอบเขตช่วยกำหนดข้อมูล การทดสอบ ผู้อนุมัติ และ Stop Rule หากคำถามออกนอกขอบเขต ระบบควรยอมรับว่าไม่รู้และส่งต่อ ไม่ใช่พยายามตอบเพื่อรักษาภาพลักษณ์ว่าเก่งเสมอ
Goal Card ของ Campus Help
- ผู้ใช้หลัก: เจ้าหน้าที่ศูนย์ช่วยเหลือ ไม่ใช่นักศึกษาที่รับคำตอบโดยตรงโดยไม่มีคนตรวจ
- งาน: ค้นแหล่งอ้างอิง ร่างคำตอบ และเสนอระดับความเร่งด่วน
- สิ่งที่ห้าม: ตัดสินสิทธิ์ การลงโทษ หรือข้อยกเว้นแทนผู้มีอำนาจ
- เงื่อนไขสำเร็จ: ลดเวลาค้นเอกสารโดยไม่เพิ่มอัตราคำตอบที่ทำให้พลาดกำหนดการ
- ทางหนี: ส่งต่อเจ้าหน้าที่เฉพาะทางเมื่อหลักฐานขัดกัน ไม่ครบ หรืออยู่นอกขอบเขต
3. คน ผลกระทบ และเจ้าของ: ใครต้องร่วมตั้งแต่ก่อนสร้าง
คำว่า “ผู้ใช้” มักทำให้เรานึกถึงคนที่กดหน้าจอ แต่ระบบหนึ่งอาจกระทบคนที่ไม่เคยเห็นหน้าจอเลย Campus Help มีเจ้าหน้าที่เป็นผู้ใช้โดยตรง นักศึกษาเป็นผู้รับผล เจ้าของระเบียบเป็นแหล่งนโยบาย ฝ่ายไอทีดูแลระบบ ฝ่ายคุ้มครองข้อมูลกำหนดการเข้าถึง ผู้บริหารจัดสรรทรัพยากร และผู้ให้บริการภายนอกอาจประมวลผลข้อความ ทุกกลุ่มเห็นความเสี่ยงคนละมุม
นักศึกษาอาจกังวลว่าข้อความส่วนตัวถูกเก็บนานเกินไป เจ้าหน้าที่อาจกังวลว่าระบบทำให้ต้องรับผิดแทนคำตอบที่ตนไม่มีเวลาตรวจ เจ้าของระเบียบอาจกังวลว่าเอกสารฉบับร่างถูกนำไปตอบก่อนประกาศ ฝ่ายไอทีอาจกังวลเรื่องบัญชีและ Secret รั่ว หากเก็บ Requirement จากผู้บริหารเพียงกลุ่มเดียว ความเสี่ยงเหล่านี้จะไม่ปรากฏใน Accuracy ของโมเดล
เราจึงต้องทำ Stakeholder Map ระบุว่าใครได้ประโยชน์ ใครรับความเสี่ยง ใครมีข้อมูล ใครอนุมัติ ใครอุทธรณ์ และใครหยุดระบบได้ คำถามสำคัญคือคนที่ได้รับผลกระทบมองเห็นหรือไม่ว่ากำลังมี AI ช่วยร่างคำตอบ เข้าถึงมนุษย์ได้หรือไม่ และถ้าคำตอบผิดสามารถแก้บันทึกหรือยื่นทบทวนได้อย่างไร Transparency ที่ดีไม่ใช่ป้าย “ขับเคลื่อนด้วย AI” อย่างเดียว แต่เป็นข้อมูลที่ช่วยให้คนเลือกการกระทำได้
Human-in-the-loop ไม่ได้แปลว่ามีมนุษย์อยู่ที่ใดสักแห่งแล้วระบบปลอดภัย คนจะช่วยได้จริงเมื่อเห็นข้อมูลที่จำเป็น มีเวลา มีอำนาจปฏิเสธ และได้รับ Feedback ว่าการตัดสินใจของตนถูกนำไปใช้อย่างไร หากหน้าจอซ่อนแหล่งอ้างอิงและวางปุ่ม “ส่ง” เด่นกว่าปุ่ม “แก้ไข” มนุษย์อาจกลายเป็นตราประทับโดยไม่ตั้งใจ ดังนั้นการออกแบบงานของคนเป็นองค์ประกอบระบบ ไม่ใช่เพียงขั้นตอนหลังโมเดล
4. เตรียมข้อมูล: ความพร้อมไม่ได้แปลว่ามีไฟล์มากพอ
ข้อมูลในระบบ AI มีมากกว่าชุดฝึกโมเดล Campus Help ใช้เอกสารระเบียบที่ค้นคืน ข้อความคำถามที่เข้ามา ตัวอย่างคำตอบที่ผ่านการอนุมัติ ป้ายความเร่งด่วน ข้อมูล Feedback ของเจ้าหน้าที่ Log การค้นหา และ Metadata เช่น เวลาประกาศ เจ้าของเอกสาร เวอร์ชัน ภาษา และสิทธิ์เข้าถึง ข้อมูลแต่ละชนิดมีวงจรชีวิตและข้อจำกัดไม่เหมือนกัน
คำว่า Provenance หมายถึงร่องรอยที่มาของข้อมูล เราควรรู้ว่าเอกสารมาจากระบบใด ใครอนุมัติ เมื่อไร มีผลใช้ช่วงไหน ถูกแก้ไขอย่างไร และได้รับอนุญาตให้นำมาใช้กับงานนี้หรือไม่ หากคำตอบอ้างระเบียบผิด ทีมต้องย้อนดูได้ว่าเกิดจากเอกสารต้นทาง ตัวแปลงไฟล์ การแบ่งข้อความ เครื่องมือค้น หรือ Prompt การเก็บเพียงข้อความสุดท้ายโดยไม่เก็บร่องรอยทำให้แก้ปัญหาเหมือนตามหาต้นน้ำโดยไม่มีแผนที่
คุณภาพข้อมูลไม่ได้แปลว่าไม่มีช่องว่างเท่านั้น เราต้องดูความเกี่ยวข้อง ความครอบคลุม ความเป็นปัจจุบัน ความสอดคล้อง ความเป็นตัวแทน ความปลอดภัย และฐานสิทธิ์ด้วย เอกสารที่สะอาดแต่อยู่คนละปีการศึกษายังเป็นข้อมูลคุณภาพต่ำสำหรับคำถามปัจจุบัน ชุดตัวอย่างที่มีแต่คำถามสั้นอาจไม่เป็นตัวแทนของนักศึกษาต่างชาติหรือผู้ใช้เทคโนโลยีช่วยการเข้าถึง ป้ายที่เจ้าหน้าที่แต่ละคนตีความไม่เหมือนกันทำให้การประเมินคลุมเครือ
ISO/IEC 8183:2023 วางกรอบวงจรข้อมูลสำหรับระบบ AI ตั้งแต่การได้มา การสร้าง การพัฒนา การใช้งาน การบำรุงรักษา ไปจนถึงการเลิกใช้ แนวคิดสำคัญคือข้อมูลไม่หยุดนิ่งหลังวันเปิดระบบ Campus Help ต้องมีเจ้าของเอกสารและกำหนดรอบทบทวน เมื่อมีระเบียบใหม่ ต้องรู้ว่าชิ้นส่วนใดต้องสร้างดัชนีใหม่ ชุดทดสอบใดต้องอัปเดต และข้อมูลเก่าใดต้องเก็บหรือลบ
| ข้อมูล | ใช้ทำอะไร | ความเสี่ยง | การควบคุม |
|---|---|---|---|
| ข้อความนักศึกษา | เป็นอินพุตและใช้วิเคราะห์หัวข้อ | มีข้อมูลส่วนบุคคลหรือรายละเอียดละเอียดอ่อน | ลดข้อมูล เก็บตามระยะเวลา จำกัดสิทธิ์ และปกปิดก่อนใช้ทดสอบ |
| ระเบียบและประกาศ | เป็นฐานความรู้สำหรับค้นคืน | ผิดเวอร์ชัน ขัดกัน หรือยังไม่ประกาศใช้ | เจ้าของเอกสาร สถานะอนุมัติ วันที่มีผล และ Versioning |
| คำตอบที่อนุมัติ | ใช้เป็นตัวอย่างและชุดประเมิน | คำตอบเดิมอาจไม่เหมาะกับบริบทใหม่ | แยกช่วงเวลา ตรวจสิทธิ์ และทบทวนโดยผู้เชี่ยวชาญ |
| Feedback และ Log | ตรวจปัญหาและปรับระบบ | Feedback มีอคติ Log เปิดเผยข้อมูลมากเกินจำเป็น | นิยามป้าย การสุ่มตรวจ การควบคุมการเข้าถึง และนโยบายลบ |
5. พัฒนาและทดลอง: เริ่มจาก Baseline ก่อนเพิ่มความซับซ้อน
Baseline คือวิธีอ้างอิงที่เรียบง่ายซึ่งใช้ตอบว่า AI ใหม่ให้คุณค่าเพิ่มจริงหรือไม่ สำหรับ Campus Help Baseline อาจเป็นการค้นคำในเอกสารเดิม หรือ Template ที่เจ้าหน้าที่เลือกเอง ทีมควรวัดเวลาค้น ความถูกต้อง เหตุการณ์ผิด และภาระงานของวิธีนี้ก่อน หากระบบ AI ซับซ้อนขึ้นแต่ไม่ดีกว่า Baseline อย่างมีความหมาย การหยุดหรือกลับไปใช้วิธีง่ายกว่าเป็นผลทดลองที่มีคุณค่า ไม่ใช่ความพ่ายแพ้
โมเดล AI รับอินพุตแล้วสร้างเอาต์พุตตามรูปแบบที่เรียนจากข้อมูล เช่น จัดหมวดหมู่ ประมาณคะแนน สร้างข้อความ หรือค้นความคล้าย Campus Help อาจใช้โมเดลหนึ่งจำแนกหัวข้อ โมเดลหนึ่งสร้าง Embedding สำหรับค้นเอกสาร และโมเดลภาษาร่างคำตอบ ผลลัพธ์ที่ผู้ใช้เห็นจึงไม่ใช่ผลงานของโมเดลตัวเดียว แต่เป็นผลจากลำดับและเงื่อนไขการเรียกหลายส่วน
กฎธุรกิจทำหน้าที่กำหนดข้อห้ามและแปลงคะแนนเป็นการกระทำ ตัวอย่างเช่น ถ้ามีคำว่า “วันนี้” ร่วมกับ “ลงทะเบียนไม่ได้” ให้ยกระดับความเร่งด่วน หากเอกสารที่ค้นได้มีสถานะร่าง ห้ามใช้เป็นแหล่งอ้างอิง หากคะแนนความมั่นใจต่ำกว่าเกณฑ์ ให้ส่งต่อเจ้าหน้าที่ กฎเหล่านี้อาจเขียนในโค้ด Prompt Workflow หรือระบบสิทธิ์ เราจึงต้องเก็บเวอร์ชันและทดสอบเหมือนส่วนอื่น ไม่ใช่ถือว่ากฎที่มนุษย์เขียนจะถูกเสมอ
เครื่องมือหรือ Tool ช่วยให้โมเดลทำสิ่งนอกเหนือจากความรู้ภายใน เช่น ค้นฐานข้อมูล อ่านปฏิทิน คำนวณ หรือสร้าง Ticket แต่การเพิ่ม Tool เพิ่มเส้นทางความล้มเหลวด้วย เครื่องมือค้นอาจคืนศูนย์ผลลัพธ์ API อาจช้า Schema อาจเปลี่ยน และสิทธิ์อาจกว้างเกินไป ระบบต้องตรวจอินพุตของเครื่องมือ จำกัดคำสั่ง ตรวจเอาต์พุต และกำหนดว่าถ้าเครื่องมือล้มเหลวจะหยุด ลดความสามารถ หรือให้คนทำต่อ
Prompt ก็เป็นองค์ประกอบที่เปลี่ยนพฤติกรรม แม้ไม่ใช่โมเดล Prompt บอกบทบาท รูปแบบคำตอบ ขั้นตอนตรวจแหล่งอ้างอิง และเงื่อนไขปฏิเสธ การแก้ประโยคเดียวอาจเปลี่ยนความยาว ความมั่นใจ หรืออัตราการอ้างแหล่งผิด จึงต้อง Version Prompt ผูกกับผลทดสอบ และหลีกเลี่ยงการแก้ในระบบจริงโดยไม่มี Regression Test
คำว่า “ระบบถูกจำกัดด้วยจุดอ่อนที่สุด” ใช้เป็นภาพเตือนได้ แต่ไม่ใช่กฎคณิตศาสตร์สากล จุดอ่อนบางอย่างถูกชดเชยด้วยตัวตรวจหรือมนุษย์ได้ ขณะที่จุดผิดเล็กในส่วนต้นอาจขยายเป็น Cascading Error ผ่านหลายขั้น สิ่งที่แม่นกว่าคือคุณภาพรวมขึ้นกับทั้งคุณภาพของแต่ละส่วนและวิธีเชื่อมต่อระหว่างส่วน เราจึงประเมินทั้ง Component Test และ End-to-End Test
6. ประกอบระบบและทำซ้ำได้: เปลี่ยนเดโมให้เป็นรุ่นที่ตรวจย้อนกลับได้
โมเดลที่รันบนโน้ตบุ๊กของนักพัฒนายังไม่ใช่บริการสำหรับผู้ใช้ ซอฟต์แวร์ต้องรับคำขอ ตรวจรูปแบบ จัดคิว เรียกโมเดลและเครื่องมือ จัดการข้อผิดพลาด บันทึกเหตุการณ์ และส่งผลกลับอย่างสม่ำเสมอ โครงสร้างพื้นฐานรวมเครื่องประมวลผล พื้นที่เก็บข้อมูล เครือข่าย ระบบยืนยันตัวตน Secret Management การสำรองข้อมูล และการสังเกตสถานะของบริการ
Campus Help อาจตอบถูกในห้องทดลอง แต่วันลงทะเบียนมีคำถามเข้ามาพร้อมกันจำนวนมาก หากคิวเต็ม ระบบอาจตอบช้าจนหมดประโยชน์ หาก Timeout ทำให้ตัวค้นเอกสารไม่คืนผลแต่โมเดลยังร่างคำตอบจากความจำ ความเสี่ยงจะเพิ่มโดยผู้ใช้ไม่รู้ หาก Retry โดยไม่มีขอบเขตอาจสร้าง Ticket ซ้ำหรือเพิ่มค่าใช้จ่าย ระบบจึงต้องกำหนด Timeout, Retry, Rate Limit, Circuit Breaker และ Fallback ที่สอดคล้องกับผลกระทบ
Versioning ต้องเชื่อมหลายชิ้นเข้าด้วยกัน: รุ่นโมเดล รุ่น Prompt รุ่นดัชนีเอกสาร รุ่นกฎ และรุ่นโค้ด เมื่อพบเหตุการณ์ ทีมควรตอบได้ว่าเวลา 10:32 น. คำถามนี้ผ่านชุดใด การบอกเพียงชื่อโมเดลไม่พอ เพราะโมเดลเดิมกับเอกสารใหม่อาจให้ผลต่างกัน และโมเดลใหม่กับ Prompt เดิมอาจเปลี่ยนรูปแบบคำตอบ
ความปลอดภัยไม่ใช่ชั้นเสริมหลังระบบเสร็จ ต้องถามว่าข้อมูลไหลออกไปที่ใด ผู้ให้บริการเก็บอะไร ใครอ่าน Log ได้ Secret ถูกเก็บอย่างไร ผู้ใช้สามารถทำ Prompt Injection ให้ระบบดึงเอกสารที่ไม่มีสิทธิ์หรือไม่ และเมื่อบัญชีถูกยึดครองความเสียหายหยุดตรงไหน การให้สิทธิ์ขั้นต่ำ แยกสภาพแวดล้อม กรองข้อมูล และบันทึก Audit Trail ช่วยลดความเสี่ยง แต่ไม่มีมาตรการใดทำให้ปลอดภัยสมบูรณ์
7. ออกแบบการใช้งานและ Human Oversight: คนต้องมีข้อมูล เวลา และอำนาจ
โมเดลอาจคืนคะแนน 0.82 แต่คะแนนนั้นไม่ใช่การตัดสินใจจนกว่าระบบจะแปลเป็นการกระทำ Threshold อาจทำให้คะแนนเกิน 0.80 ถูกส่งอัตโนมัติ คะแนนต่ำกว่านั้นต้องให้คนตรวจ หรือระบบอาจใช้คะแนนเพียงจัดลำดับคิว รูปแบบเดียวกันให้ผลกระทบต่างกันมาก เราจึงต้องบันทึก Decision Policy แยกจาก Model Output
หน้าจอควรแสดงสิ่งที่ช่วยให้เจ้าหน้าที่ตัดสิน ไม่ใช่แสดงทุกอย่างที่ระบบมี Campus Help อาจแสดงร่างคำตอบ เอกสารที่อ้าง วันที่มีผล ข้อความส่วนที่รองรับคำตอบ ระดับความไม่แน่ใจ และเหตุผลที่ส่งต่อ หากหน้าจอแสดงเพียงร่างที่เขียนลื่น เจ้าหน้าที่อาจเกิด Automation Bias หรือโน้มเอียงเชื่อตามระบบโดยไม่ตรวจหลักฐาน
ตำแหน่ง สี และค่าเริ่มต้นเปลี่ยนพฤติกรรมได้ ปุ่ม “ส่ง” สีเด่นและปุ่ม “ขอผู้เชี่ยวชาญ” ซ่อนอยู่ในเมนูทำให้คนส่งมากขึ้น คำเตือนที่ปรากฏทุกครั้งอาจเกิด Alert Fatigue จนถูกมองข้าม การทดสอบ Usability จึงต้องดูว่าคนเข้าใจความหมายของคะแนนหรือไม่ ใช้แหล่งอ้างอิงจริงหรือไม่ และรู้ว่าจะทำอะไรเมื่อระบบไม่แน่ใจ ไม่ใช่ถามเพียงว่าชอบหน้าตาหรือไม่
มนุษย์ต้องมีเวลาพอและมีอำนาจจริง หากเป้าหมายความเร็วบังคับให้เจ้าหน้าที่ตรวจร่างหลายร้อยรายการต่อชั่วโมง การมีปุ่มแก้ไขไม่ได้หมายความว่ามี Human Oversight เราควรวัดอัตราการแก้ไข เวลาตรวจ อัตราการส่งต่อ เหตุผลที่ปฏิเสธ และภาระทางความคิด พร้อมฟัง Feedback เชิงคุณภาพจากคนทำงาน
8. ประเมินและอนุมัติ: ประตู Go/No-Go ต้องอาศัยหลักฐานหลายชั้น
การประเมินที่ดีเริ่มจากคำถาม ไม่ใช่เริ่มจาก Metric ยอดนิยม สำหรับตัวจำแนกความเร่งด่วน เราอาจดู Precision, Recall และ Confusion Matrix เพราะการพลาดกรณีเร่งด่วนมีต้นทุนต่างจากการเตือนเกิน สำหรับการค้นเอกสาร เราดูว่าแหล่งที่ถูกต้องอยู่ในผลลัพธ์อันดับต้นหรือไม่ สำหรับร่างคำตอบ เราตรวจความถูกต้อง ความครบ การยึดโยงกับหลักฐาน และการปฏิบัติตามขอบเขต แต่ละส่วนต้องมีชุดทดสอบตรงกับหน้าที่
จากนั้นต้องทดสอบ End-to-End ด้วยข้อความใกล้ของจริง เพราะส่วนที่ดีแยกกันอาจประกอบแล้วพัง ตัวค้นอาจคืนเอกสารถูกแต่ Prompt ใช้เอกสารรองก่อน ตัวจำแนกหัวข้ออาจส่งไปฐานความรู้ผิดชุด หรือหน้าจออาจตัดข้อความเตือนออก ชุดทดสอบควรเก็บทั้งคำถามทั่วไป กรณีขอบเขต กรณีข้อมูลไม่ครบ ภาษาไม่เป็นทางการ ข้อความยาว เอกสารขัดกัน และการโจมตีที่คาดได้
Slice หมายถึงการแยกผลตามกลุ่มหรือเงื่อนไข เช่น ประเภทคำถาม ภาษา ช่วงเวลา คณะ ช่องทาง และระดับความเร่งด่วน คะแนนเฉลี่ยอาจดูดีแต่ซ่อนกลุ่มเล็กที่พลาดบ่อย Campus Help จึงต้องรายงานผลแยกกลุ่มที่มีความหมายต่อการใช้งานและความเป็นธรรม โดยระวังไม่สร้างหรือเผยข้อมูลละเอียดอ่อนเกินจำเป็น
Baseline ช่วยให้รู้ว่าความซับซ้อนมีคุณค่าจริงหรือไม่ เราอาจเทียบกับการค้นคำธรรมดา Template ที่เจ้าหน้าที่เลือกเอง หรือกระบวนการเดิม หากระบบ AI ลดเวลาเล็กน้อยแต่เพิ่มเหตุการณ์ร้ายแรงและภาระตรวจ ผลลัพธ์อาจไม่คุ้ม การผ่านเกณฑ์ต้องระบุล่วงหน้าว่าตัวเลขใดสำคัญ ความผิดแบบใดรับได้ และใครอนุมัติข้อยกเว้น
หลักฐานมีระดับความเชื่อมั่นต่างกัน เดโมที่ทีมสร้างเองช่วยค้นปัญหาเบื้องต้น ชุดทดสอบย้อนหลังช่วยเปรียบรุ่น Pilot ในสภาพจำกัดช่วยดูพฤติกรรมจริง และการติดตามหลังเปิดใช้ช่วยเห็น Distribution Shift ไม่มีชุดใดแทนทุกอย่าง เราควรบันทึกสิ่งที่ยังไม่ได้ทดสอบแทนการใช้คำว่า “ผ่านแล้ว” แบบไร้ขอบเขต
| ระดับ | ตัวอย่างคำถาม | ตัวอย่างหลักฐาน | สิ่งที่คะแนนนี้ยังไม่บอก |
|---|---|---|---|
| โมเดล | จำแนกความเร่งด่วนถูกหรือไม่ | Precision, Recall, Calibration และผลแยก Slice | ยังไม่บอกว่าค้นเอกสารถูกหรือคนใช้ผลอย่างไร |
| ระบบ | จากข้อความถึงร่างคำตอบสำเร็จหรือไม่ | End-to-End Accuracy, Latency, Failure Rate และ Cost | ยังไม่บอกว่าคำตอบช่วยผู้รับจริงหรือไม่ |
| ผู้ใช้ | เจ้าหน้าที่ตรวจได้เร็วและเข้าใจหรือไม่ | เวลาแก้ อัตราปฏิเสธ Usability Test และภาระงาน | ยังไม่บอกผลระยะยาวต่อผู้ได้รับผล |
| ผลกระทบ | นักศึกษาได้รับคำตอบทันและไม่เสียสิทธิ์หรือไม่ | เวลารอ ข้อร้องเรียน เหตุการณ์พลาดกำหนด และช่องว่างระหว่างกลุ่ม | ต้องตีความร่วมกับบริบทและข้อมูลเชิงคุณภาพ |
9. Deploy แบบจำกัดและติดตาม: วันเปิดใช้คือวันเริ่มรับหลักฐานใหม่
Deploy หมายถึงการนำระบบรุ่นที่กำหนดขึ้นไปทำงานในสภาพแวดล้อมที่ผู้ใช้หรือกระบวนการจริงเข้าถึงได้ ทีมไม่จำเป็นต้องเปิดให้ทุกคนพร้อมกัน ทางเลือกที่ปลอดภัยกว่าคือ Shadow Mode ซึ่งระบบทำงานแต่ผลยังไม่ถูกใช้, Pilot หรือการทดลองกับกลุ่มเล็ก และ Phased Rollout หรือการขยายทีละช่วง ทุกแบบต้องระบุว่าใครอยู่ในขอบเขต ผลลัพธ์มีอำนาจแค่ไหน ใช้เวลานานเท่าไร และสัญญาณใดทำให้หยุดหรือขยาย
เมื่อระบบเปิดใช้ ข้อมูลจริงมักต่างจากชุดทดสอบ นักศึกษาอาจเริ่มใช้คำใหม่ มหาวิทยาลัยเปลี่ยนปฏิทิน เอกสารถูกย้าย โครงสร้าง API เปลี่ยน หรือผู้ใช้เรียนรู้วิธีถามให้ระบบตอบตามต้องการ ปรากฏการณ์ที่รูปแบบข้อมูลหรือความสัมพันธ์เปลี่ยนเรียกโดยกว้างว่า Distribution Shift แต่ Monitoring ต้องแปลคำกว้างนี้เป็นสัญญาณที่ตรวจและตอบสนองได้
NIST AI 800-4 อธิบายความท้าทายของการติดตามระบบ AI ที่นำไปใช้แล้ว เช่น ข้อมูลจริงเปลี่ยน การเข้าถึง Ground Truth ล่าช้า ความซับซ้อนของระบบ และความยากในการเชื่อมสัญญาณกับผลกระทบ เราจึงไม่ควรเฝ้าเพียง Uptime หรือเวลาตอบ ต้องเฝ้าคุณภาพอินพุต อัตราไม่พบเอกสาร การกระจายหัวข้อ อัตราการแก้คำตอบ เหตุการณ์ส่งต่อ ข้อร้องเรียน และผลลัพธ์สำคัญเมื่อหา Ground Truth ได้
Alert ที่ดีต้องมี Threshold เจ้าของ และการกระทำ หากอัตราเอกสารไม่มีสถานะอนุมัติเกินศูนย์ อาจหยุดการร่างทันที หากเวลาเฉลี่ยสูงขึ้น อาจลดฟีเจอร์แต่ยังให้เจ้าหน้าที่ค้นเอง หากอัตราการแก้คำตอบสูงขึ้นต่อเนื่อง ต้องสุ่มตรวจและเปรียบเทียบเวอร์ชัน ไม่ควรสร้าง Dashboard สีแดงโดยไม่มีคนรับผิดชอบ เพราะการมองเห็นปัญหาแต่ไม่มีอำนาจตอบสนองไม่ใช่การควบคุม
Stop Rule คือเงื่อนไขที่ระบบลดความสามารถ หยุดอัตโนมัติ หรือกลับไปวิธีเดิม ควรกำหนดก่อนเกิดเหตุ เช่น เมื่อพบคำตอบที่อ้างเอกสารร่าง เมื่อ Recall ของกรณีเร่งด่วนต่ำกว่าเกณฑ์ในชุดตรวจรายวัน หรือเมื่อผู้ให้บริการไม่ยืนยันสถานะข้อมูล ระบบจะส่งทุกกรณีให้เจ้าหน้าที่และปิดการสร้างร่างจนเจ้าของนโยบายกับหัวหน้าคุณภาพอนุมัติ การหยุดไม่ใช่ความล้มเหลวของทีม แต่เป็นความสามารถด้านความปลอดภัยของระบบ
Feedback Loop ต้องระวังข้อมูลย้อนกลับที่สร้างอคติ หากนำคำตอบที่เจ้าหน้าที่กดส่งกลับไปฝึกโดยถือว่าถูกเสมอ ระบบอาจเรียนข้อผิดเดิมและทำให้มันดูเป็นมาตรฐาน ต้องแยก “ถูกส่ง” ออกจาก “ตรวจแล้วถูก” เก็บเหตุผลการแก้ และสุ่มตรวจตัวอย่างอย่างอิสระ วงจรเรียนรู้จึงต้องมีการควบคุม ไม่ใช่ดูดทุกการคลิกกลับเป็นความจริง
10. ปฏิบัติการ เหตุการณ์ และการกู้คืน: เมื่อระบบผิด ใครทำอะไรภายในกี่นาที
Incident หรือเหตุการณ์ผิดปกติคือเหตุที่คุณภาพ ความปลอดภัย สิทธิ์ หรือผลกระทบออกนอกเงื่อนไขที่ยอมรับ ทีมต้องมี Runbook หรือคู่มือปฏิบัติที่บอกวิธีจำแนกระดับ ใครเป็น On-call หรือผู้รับผิดชอบในเวลานั้น จะจำกัดผลกระทบอย่างไร เก็บหลักฐานใด แจ้งใคร และเมื่อไรจึงกลับมาใช้ได้ ส่วน Rollback คือการย้อนกลับไปใช้รุ่นหรือวิธีทำงานก่อนหน้าที่ทราบสถานะ ไม่ใช่เพียงกดปิดแล้วหวังว่าปัญหาหาย
Governance ไม่ใช่เอกสารเซ็นครั้งเดียว แต่คือวิธีที่องค์กรกำหนดอำนาจ หน้าที่ หลักฐาน และการตัดสินใจตลอดวงจร NIST AI RMF จัดงานเป็น Govern, Map, Measure และ Manage เพื่อช่วยให้องค์กรมองทั้งบริบท การวัด และการจัดการความเสี่ยง สำหรับผู้เริ่มต้น เราแปลได้ว่า ต้องมีกติกา เข้าใจระบบ วัดสิ่งสำคัญ และลงมือเมื่อความเสี่ยงเปลี่ยน
Campus Help ต้องมีเจ้าของเป้าหมายที่ตอบว่าระบบยังแก้ปัญหาที่ถูกต้องหรือไม่ เจ้าของข้อมูลที่อนุมัติแหล่งและวงจรชีวิต เจ้าของโมเดลและซอฟต์แวร์ที่ดู Version เจ้าของนโยบายที่ตีความระเบียบ เจ้าของประสบการณ์ที่ดูการใช้งาน เจ้าของความปลอดภัยและความเป็นส่วนตัว และ Incident Owner ที่มีอำนาจหยุดระบบ บทบาทหนึ่งคนอาจทำหลายหน้าที่ในทีมเล็กได้ แต่หน้าที่ต้องไม่หายไป
RACI เป็นเครื่องมือหนึ่งที่ช่วยแยกผู้ลงมือ ผู้รับผิดชอบสูงสุด ผู้ให้คำปรึกษา และผู้รับทราบ แต่ตารางสวยไม่พอ หากไม่มีเวลาหรือสิทธิ์จริง เจ้าของ Alert ต้องมีช่องทางติดต่อและ SLA เจ้าของข้อมูลต้องปฏิเสธเอกสารที่ไม่พร้อมได้ เจ้าหน้าที่ต้องส่งต่อโดยไม่ถูกลงโทษจากเป้าความเร็ว และผู้ได้รับผลกระทบต้องมีช่องทางแก้ไข
ผู้ขายภายนอกไม่ทำให้ความรับผิดชอบหายไป ทีมควรรู้ว่าบริการใช้ข้อมูลอย่างไร เก็บนานเท่าไร รุ่นโมเดลเปลี่ยนได้หรือไม่ แจ้งเหตุอย่างไร มีข้อจำกัดด้านภูมิภาคหรือสิทธิ์ใด และส่งออก Log ที่จำเป็นได้หรือไม่ สัญญา การตั้งค่า และการทดสอบต้องสอดคล้องกัน คำโฆษณาว่า “Enterprise-ready” ไม่ใช่หลักฐานแทนนโยบายและพฤติกรรมที่ตรวจได้
Owner Map ขั้นต่ำ
- Business Owner: เป้าหมาย ขอบเขต และการตัดสินใจว่าจะใช้ต่อหรือหยุด
- Data Owner: แหล่งข้อมูล สิทธิ์ คุณภาพ เวอร์ชัน และการลบ
- Technical Owner: โมเดล Prompt โค้ด โครงสร้างพื้นฐาน และ Rollback
- Policy Expert: ความถูกต้องของระเบียบและข้อยกเว้น
- Human Workflow Owner: หน้าจอ ภาระงาน การส่งต่อ และการฝึกเจ้าหน้าที่
- Risk and Incident Owner: Alert การสอบสวน การสื่อสาร และเงื่อนไขกลับมาใช้
11. ปรับปรุง เปลี่ยนรุ่น และเลิกใช้: ทุกระบบต้องมีทางออก
ระบบ AI มีชีวิตยาวกว่าวันเปิดตัว ช่วงค้นปัญหาต้องตรวจว่าควรใช้ AI หรือวิธีธรรมดา ช่วงออกแบบต้องกำหนดขอบเขต ข้อมูล ผู้ได้รับผล และสถาปัตยกรรม ช่วงพัฒนาต้อง Version ส่วนประกอบและสร้าง Test ช่วงตรวจรับต้องทดสอบทั้งส่วนย่อยและ End-to-End ช่วง Pilot ต้องจำกัดผู้ใช้และผลกระทบ ช่วงใช้งานต้อง Monitoring ช่วงเปลี่ยนแปลงต้องประเมินซ้ำ และช่วงเลิกใช้ต้องจัดการข้อมูล บัญชี เอกสาร และการสื่อสาร
Stage Gate ช่วยให้แต่ละช่วงมีคำถามผ่านก่อนเดินต่อ เช่น ก่อน Pilot ต้องมีแหล่งอ้างอิงที่อนุมัติ ชุดทดสอบกรณีเร่งด่วน หน้าจอแสดงหลักฐาน และ Stop Rule ก่อนขยายผู้ใช้ต้องมีผล Pilot ตามเกณฑ์ เหตุการณ์ถูกแก้ และทีมสนับสนุนพร้อม Gate ไม่ควรเป็นพิธีกรรมที่ติ๊กช่อง แต่เป็นจุดตัดสินจากหลักฐานว่า ความเสี่ยงที่เหลือยอมรับได้ภายใต้ขอบเขตใด
Change Management สำคัญเพราะการเปลี่ยนเล็กอาจกระทบหลายส่วน อัปเดตโมเดลอาจทำให้รูปแบบข้อความเปลี่ยนและหน้าจอตัดบรรทัด อัปเดตดัชนีเอกสารอาจทำให้คำตอบเก่าหาย อัปเดต Prompt อาจเพิ่มจำนวน Tool Call ทุกการเปลี่ยนควรมี Impact Analysis ชุด Regression Test แผน Rollback และผู้อนุมัติตามระดับความเสี่ยง
การเลิกใช้หรือ Decommission ไม่ได้แปลว่าปิดปุ่มแล้วจบ ต้องปิดบัญชีและ Secret ยกเลิกการไหลข้อมูล กำหนดว่าจะเก็บหรือลบ Log อย่างไร ส่งออกหลักฐานที่ต้องรักษา แจ้งผู้ใช้ เปลี่ยน Workflow กลับ และตรวจว่าไม่มีระบบปลายทางยังพึ่งเอาต์พุตเดิม หากลืมส่วนนี้ ระบบเงาอาจยังประมวลผลข้อมูลโดยไม่มีเจ้าของ
ยืนยันผู้ใช้ งาน ต้นทุนความผิด และเหตุผลที่ AI อาจมีประโยชน์
ทำแผนที่ข้อมูล สถาปัตยกรรม เจ้าของ ขอบเขต และหลักฐานทดสอบ
จำกัดผลกระทบ ทดสอบกรณีปกติ ขอบเขต และเหตุล้มเหลว พร้อม Fallback
เฝ้าสัญญาณระดับโมเดล ระบบ ผู้ใช้ และผลกระทบ แล้วตอบสนองตาม Playbook
ประเมินซ้ำ Rollback จัดการข้อมูล สิทธิ์ เอกสาร และการพึ่งพาปลายทาง
12. หก Failure Cases: แต่ละปัญหาต้องย้อนกลับคนละช่วง
กรณีที่ 1: เป้าหมายผิด แต่ Metric ดูดี
Campus Help ถูกวัดด้วยจำนวนคำตอบต่อชั่วโมง ทีมจึงลดข้อความเตือนและส่งร่างเร็วขึ้น ตัวเลขดีขึ้น แต่เจ้าหน้าที่ส่งต่อกรณีซับซ้อนน้อยลง นักศึกษาบางคนได้รับคำตอบเร็วแต่ผิดประเด็น สาเหตุอยู่ที่ Objective Function ระดับองค์กร ไม่ใช่โมเดล วิธีป้องกันคือใช้ชุด Metric สมดุล มีเหตุการณ์ร้ายแรงและคุณภาพผลลัพธ์เป็น Guardrail พร้อมสิทธิ์หยุดเมื่อแรงจูงใจพาออกนอกเป้าหมาย
กรณีที่ 2: เอกสารถูกต้อง แต่หมดอายุ
ระบบค้นคู่มือปีที่แล้วซึ่งเขียนถูกในเวลานั้น โมเดลอ้างข้อความตรงต้นฉบับและตอบอย่างลื่น แต่คำตอบปัจจุบันผิด นี่คือปัญหา Freshness และ Version ไม่ใช่ Hallucination แบบสร้างข้อมูลไม่มีแหล่งอย่างเดียว วิธีป้องกันคือใช้วันที่มีผล สถานะอนุมัติ เจ้าของเอกสาร และกฎไม่ให้ค้นแหล่งหมดอายุ พร้อม Test เมื่อเปลี่ยนปีการศึกษา
กรณีที่ 3: ส่วนย่อยผ่าน แต่จุดเชื่อมต่อพัง
ตัวจำแนกหัวข้อแม่น ตัวค้นเอกสารถูก และโมเดลร่างดีเมื่อทดสอบแยก แต่ API ส่งรหัสคณะเป็นตัวพิมพ์เล็ก ขณะที่ดัชนีคาดตัวพิมพ์ใหญ่ จึงค้นผิดชุด ปัญหานี้อยู่ที่ Interface Contract วิธีป้องกันคือ Schema Validation, Contract Test, End-to-End Test และ Log ที่ผูก Request ID เดียวกันตลอดสาย
กรณีที่ 4: คนอยู่ในวงจร แต่ไม่มีอำนาจจริง
เจ้าหน้าที่ต้องตรวจคำตอบ แต่มีเวลาสิบวินาทีต่อรายการและถูกวัดจากความเร็ว หน้าจอไม่แสดงแหล่งอ้างอิง การกดส่งจึงกลายเป็นพฤติกรรมปกติ แม้เอกสารนโยบายเขียนว่ามี Human Review วิธีป้องกันคือออกแบบภาระงานและสิทธิ์ส่งต่อ วัดอัตราการแก้และเวลาอ่าน ทดสอบความเข้าใจ และไม่ลงโทษคนที่หยุดกรณีไม่แน่ใจ
กรณีที่ 5: Feedback Loop ขยายข้อผิด
ทีมเอาคำตอบที่ถูกส่งทั้งหมดกลับเป็นชุดตัวอย่างโดยไม่มีการตรวจ หากระบบร่างผิดแต่เจ้าหน้าที่ไม่ได้แก้ ข้อผิดนั้นถูกติดป้ายว่าถูก รุ่นต่อไปจึงเลียนแบบมากขึ้น วิธีป้องกันคือแยกการคลิกออกจาก Ground Truth ใช้การสุ่มตรวจโดยผู้เชี่ยวชาญ เก็บเหตุผลแก้ไข และตรวจ Drift ของป้ายกับคำตอบ ไม่ปล่อยให้ระบบยืนยันตัวเอง
กรณีที่ 6: ระบบรู้ว่าผิด แต่ไม่มีทางหยุด
Dashboard แจ้งอัตราคำตอบไม่มีแหล่งสูงขึ้น แต่ทีมสนับสนุนไม่มีสิทธิ์ปิดฟีเจอร์ ต้องรอผู้บริหารที่ไม่อยู่ เหตุการณ์จึงดำเนินต่อ ปัญหาไม่ใช่การตรวจไม่พบ แต่เป็น Governance Gap วิธีป้องกันคือกำหนดเจ้าของเวร Threshold การลดระดับบริการ ปุ่มหยุด การสื่อสาร และเกณฑ์อนุมัติกลับมาใช้ล่วงหน้า พร้อมซ้อมเหมือนแผนรับเหตุระบบอื่น
| จุดพลาด | สัญญาณ | การลดผลกระทบทันที | เจ้าของหลัก |
|---|---|---|---|
| เป้าหมายผิด | ความเร็วดีแต่ข้อร้องเรียนหรือเหตุร้ายเพิ่ม | หยุดการขยายและทบทวน Guardrail | Business Owner |
| เอกสารหมดอายุ | แหล่งอ้างอิงไม่มีสถานะปัจจุบัน | ปิดการร่างและส่งให้คนค้น | Data/Policy Owner |
| จุดเชื่อมต่อพัง | ผลส่วนย่อยดีแต่ End-to-End ผิด | Rollback รุ่น Integration | Technical Owner |
| Human Review ลวง | เวลาอ่านสั้นผิดปกติและแทบไม่แก้ | ลดคิว เพิ่มข้อมูล และเปิดทางส่งต่อ | Workflow Owner |
| Feedback ปนเปื้อน | ข้อผิดเดิมเพิ่มหลัง Retrain | หยุดการนำข้อมูลย้อนกลับและ Audit ชุดฝึก | Data/Model Owner |
| ไม่มีทางหยุด | Alert ค้างโดยไม่มี Action | ใช้ Emergency Disable และแผนสื่อสาร | Incident Owner |
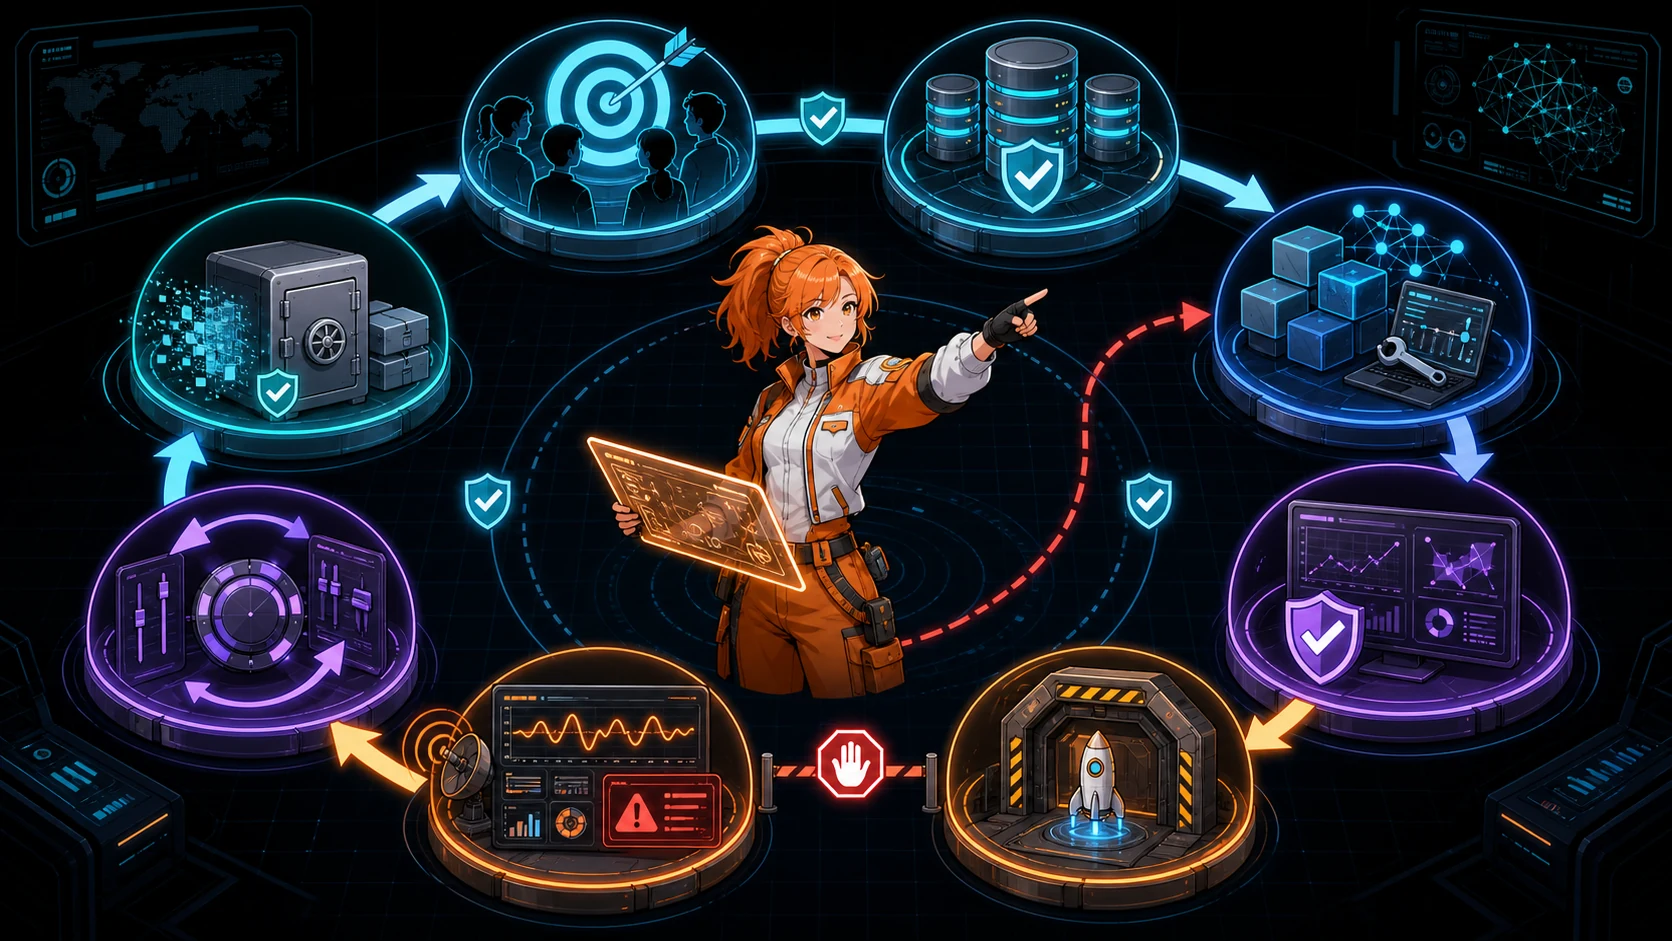
13. วาด Lifecycle Canvas: ให้ทุกช่วงมีผลส่งมอบ ประตู และทางย้อนกลับ
แผนที่ระบบที่มีประโยชน์ควรเริ่มจากขอบเขต วาดสิ่งที่อยู่ในระบบและสิ่งที่อยู่นอกระบบ ใส่ผู้ส่งอินพุต แหล่งข้อมูล การแปลง โมเดล กฎ เครื่องมือ เอาต์พุต ผู้ตัดสิน ผลกระทบ Feedback และทางหยุด ทุกกล่องควรมีชื่อที่บอกหน้าที่ ทุกลูกศรควรบอกว่าอะไรไหล เช่น ข้อความ คะแนน เอกสาร คำสั่ง หรือสิทธิ์
ขั้นแรก วาด Happy Path ของ Campus Help: นักศึกษาส่งข้อความ ระบบปกปิดข้อมูลที่ไม่จำเป็น ตัวจำแนกเลือกหัวข้อ ตัวค้นดึงเอกสารที่อนุมัติ โมเดลร่างคำตอบ ตัวตรวจขอบเขตและกฎทำงาน เจ้าหน้าที่ตรวจ แล้วส่งคำตอบ ขั้นที่สอง วาด Failure Path: ไม่พบเอกสาร เอกสารขัดกัน คะแนนต่ำ API ล่ม หรือเนื้อหาเสี่ยง แต่ละทางต้องจบที่ Fallback หรือเจ้าของ ไม่ควรจบที่คำว่า Error อย่างเดียว
ขั้นที่สาม ใส่ Feedback หลังการตัดสิน เช่น การแก้คำตอบ ข้อร้องเรียน ผลการสุ่มตรวจ และเหตุการณ์พลาดกำหนด แล้วแยก Feedback ที่ใช้ Monitoring ออกจากข้อมูลที่อนุมัติให้ใช้ปรับโมเดล ขั้นที่สี่ ใส่ Control Plane ได้แก่ Version, Access, Log, Alert, Approval, Rollback และ Retention ซึ่งอาจไม่อยู่ในเส้นทางผู้ใช้แต่ควบคุมความปลอดภัยของระบบ
ขั้นสุดท้าย ทำ Interface Review เดินตามลูกศรทุกเส้นแล้วถามว่า Schema คืออะไร เจ้าของคือใคร ตรวจความถูกต้องตรงไหน ถ้าช้าเกิดอะไร ถ้าขาดหายเกิดอะไร และเก็บหลักฐานอะไร การทบทวนนี้มักพบช่องว่างที่การประชุมดูโมเดลไม่พบ เช่น ไม่มีใครรับผิดชอบเอกสารที่ถูกแปลง ไม่รู้ว่าคะแนนถูกปัดก่อนตั้ง Threshold หรือระบบปลายทางตีความคำว่า “เร่งด่วน” ต่างกัน
Lifecycle Canvas แบบข้อความของ Campus Help
โจทย์และผู้ได้รับผล → ตรวจทางเลือกที่ไม่ใช้ AI → เตรียมข้อมูลและสิทธิ์ → สร้าง Baseline → พัฒนาระบบที่ระบุรุ่นได้ → ประเมิน Component และ End-to-End → อนุมัติ Pilot → Deploy แบบจำกัด → Monitoring และ Incident Response → ปรับปรุงหรือ Rollback → ทบทวนคุณค่า → เลิกใช้และตรวจบริการที่ยังพึ่งพา
ทางย้อนกลับ: ถ้าเอกสารไม่ครอบคลุมให้ย้อนสู่ข้อมูล ถ้าคนตรวจไม่ทันให้ย้อนสู่ Workflow ถ้าผลกระทบไม่ตรงเป้าหมายให้ย้อนสู่ Problem Statement และถ้าความเสี่ยงคงเหลือสูงกว่าที่องค์กรยอมรับให้หยุดก่อน Deploy ไม่ใช่ลดเกณฑ์เพื่อรักษากำหนดการ
สิบคำถามสำหรับอ่านแผนที่ระบบ
- ระบบพยายามสร้างผลลัพธ์อะไรให้ใคร และอะไรอยู่นอกขอบเขต
- อินพุตทุกชนิดมาจากไหน มีสิทธิ์และเวอร์ชันหรือไม่
- โมเดล กฎ Prompt และ Tool แต่ละชิ้นทำหน้าที่ใด
- จุดเชื่อมต่อใดแปลงหรือตัดข้อมูล
- คะแนนถูกเปลี่ยนเป็นการกระทำด้วยนโยบายใด
- ใครได้รับผลกระทบแม้ไม่เห็นหน้าจอ
- มนุษย์เห็นหลักฐาน มีเวลา และมีสิทธิ์ปฏิเสธหรือไม่
- Monitoring วัดสัญญาณใด ใครตอบสนอง และเร็วแค่ไหน
- Feedback ใดเป็น Ground Truth และใครอนุมัติให้นำกลับไปใช้
- ระบบหยุด Rollback และเลิกใช้อย่างไรโดยไม่ทิ้งข้อมูลหรือการพึ่งพา
14. แบบฝึกปฏิบัติ: ร่างวงจรชีวิตโครงการหนึ่งหน้า
เลือกหนึ่งระบบที่คุณรู้จัก เช่น ระบบคัดกรองอีเมล ระบบแนะนำสินค้า ระบบตรวจเอกสาร ระบบจัดลำดับลูกค้า หรือผู้ช่วยค้นความรู้ ห้ามเริ่มจากชื่อโมเดล ให้เริ่มจากสถานการณ์ผู้ใช้จริง แล้วทำแบบฝึกหัดต่อไปนี้บนกระดาษหรือเอกสารหนึ่งหน้า
- เขียน Goal Card หนึ่งประโยค ระบุผู้ใช้ งาน เอาต์พุต คนอนุมัติ สิ่งที่ห้าม และ Fallback
- วาดอินพุต แหล่งข้อมูล การแปลง โมเดล กฎ Tool เอาต์พุต ผู้ตัดสิน และผู้ได้รับผลกระทบ
- เขียนชื่อลูกศรทุกเส้นว่าอะไรไหล และระบุจุดที่ Schema หรือ Version อาจไม่ตรงกัน
- เลือก Failure Case สามกรณีจากข้อมูล โมเดล จุดเชื่อมต่อ หน้าจอ คน หรือ Governance
- กำหนด Metric ระดับส่วนย่อยหนึ่งตัว ระดับ End-to-End หนึ่งตัว ระดับผู้ใช้หนึ่งตัว และระดับผลกระทบหนึ่งตัว
- เขียน Alert, Threshold, เจ้าของ, การลดผลกระทบ และเกณฑ์กลับมาใช้สำหรับเหตุร้ายหนึ่งกรณี
- ระบุ Feedback ที่เก็บได้ แล้วแยกว่าส่วนใดเป็นเพียงพฤติกรรม ส่วนใดเป็น Ground Truth ที่ตรวจแล้ว
- เขียนแผนเลิกใช้สั้น ๆ ว่าต้องปิดบัญชี หยุดข้อมูล เก็บหรือลบอะไร และแจ้งใคร
ตัวอย่างคำตอบย่อสำหรับ Campus Help
Goal Card คือ “ช่วยเจ้าหน้าที่ค้นเอกสารที่ประกาศใช้แล้วและร่างคำตอบเรื่องลงทะเบียนทั่วไป โดยเจ้าหน้าที่ตรวจทุกครั้ง ห้ามตัดสินสิทธิ์หรือข้อยกเว้น และส่งต่อเมื่อหลักฐานไม่ครบหรือขัดกัน” Metric ส่วนย่อยคือ Recall ของกรณีเร่งด่วน Metric End-to-End คือสัดส่วนร่างที่อ้างเอกสารถูกและพร้อมให้เจ้าหน้าที่ตรวจ Metric ผู้ใช้คือเวลาอ่านกับอัตราการแก้ Metric ผลกระทบคือเหตุการณ์ที่นักศึกษาพลาดกำหนดเพราะคำตอบ
Failure Case คือเอกสารร่างถูกนำเข้าดัชนี Alert ทำงานเมื่อพบ Source Status ไม่ใช่ Approved แม้แต่หนึ่งครั้ง การลดผลกระทบคือปิดการร่างอัตโนมัติและให้เจ้าหน้าที่ค้นเอง เจ้าของเหตุคือ Data Owner ร่วมกับ Policy Owner ระบบกลับมาใช้เมื่อเอาเอกสารออก สร้างดัชนีใหม่ รัน Regression Test ผ่าน และมีผู้อนุมัติสองบทบาท หลักฐานประกอบด้วย Incident ID รุ่นดัชนี ผลทดสอบ และเวลาที่แจ้งผู้ใช้
คำตอบนี้ยังไม่สมบูรณ์จนกว่าจะทดสอบกับคนและข้อมูลจริงในขอบเขตที่ปลอดภัย แบบฝึกหัดมีหน้าที่ทำให้คำถามสำคัญปรากฏ ไม่ใช่ทำให้เรามั่นใจเกินหลักฐาน หากช่องใดตอบไม่ได้ ให้ทำเครื่องหมายว่า “ยังไม่ทราบ” พร้อมเจ้าของและกำหนดเวลาหาคำตอบ นั่นซื่อสัตย์และมีประโยชน์กว่าการเติมข้อความให้แผนที่ดูเต็ม
15. แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่ดีที่สุดให้ครบ 5 ข้อ แล้วกด “ตรวจคำตอบ” ระบบจะแสดง Feedback รายข้อ คะแนน และจำนวนข้อที่ยังไม่ตอบ คุณใช้แป้น Tab เลื่อนไปแต่ละตัวเลือกและใช้ปุ่มลูกศรเปลี่ยนคำตอบได้
16. คำถามที่พบบ่อย
ทุกโครงการต้องใช้ขั้นเหมือนกันและเรียงเหมือนกันหรือไม่
ไม่จำเป็น ทีมเล็กอาจรวมหลายหน้าที่ไว้ในช่วงเดียว และบางโครงการต้องย้อนกลับหลายรอบก่อน Pilot สิ่งสำคัญไม่ใช่ชื่อเฟส แต่คือหน้าที่ต้องไม่หายไป: รู้โจทย์และผู้ได้รับผล ตรวจข้อมูลและสิทธิ์ สร้าง Baseline ประเมินก่อนใช้ มีผู้อนุมัติ ติดตามหลังใช้ รับเหตุการณ์ ควบคุมการเปลี่ยน และเลิกใช้อย่างปลอดภัย หากรวมขั้น ควรระบุผลส่งมอบ เจ้าของ และเกณฑ์ผ่านให้ชัด
ถ้าใช้บริการ AI สำเร็จรูป เรายังต้องสนใจองค์ประกอบภายในหรือไม่
ยังต้องสนใจในระดับที่เปลี่ยนการตัดสินใจ แม้ไม่เห็นน้ำหนักโมเดล เราต้องรู้ขอบเขตข้อมูล การเก็บรักษา รุ่นที่เปลี่ยนได้ ข้อจำกัด API วิธีทดสอบ Log ที่เข้าถึงได้ และ Fallback ความไม่โปร่งใสบางส่วนเป็นข้อจำกัดที่ต้องบันทึกและชดเชย ไม่ใช่เหตุผลให้ถือว่าผู้ขายรับความเสี่ยงทั้งหมด
Human-in-the-loop แก้ปัญหาทุกอย่างได้หรือไม่
ไม่ได้ มนุษย์อาจเหนื่อย ขาดข้อมูล ถูกแรงกดดันด้านเวลา หรือเชื่อระบบมากเกินไป การเพิ่มคนยังเพิ่มต้นทุนและความไม่สม่ำเสมอ Human Oversight ต้องออกแบบงาน ข้อมูล อำนาจ การฝึก และ Feedback พร้อมวัดผลจริง บางงานควรห้ามระบบตัดสินตั้งแต่ต้นแทนการหวังให้คนแก้ทุกครั้ง
Monitoring ต่างจาก Evaluation อย่างไร
Evaluation มักตอบก่อนเปิดหรือก่อนเปลี่ยนรุ่นว่า ระบบผ่านเกณฑ์ภายใต้ชุดและเงื่อนไขที่กำหนดหรือไม่ Monitoring ตอบต่อเนื่องว่าโลกจริงยังคล้ายเงื่อนไขนั้นหรือไม่ คุณภาพกำลังเปลี่ยนหรือไม่ และต้องทำอะไร ทั้งสองเชื่อมกัน เพราะ Monitoring ต้องใช้เกณฑ์จาก Evaluation และเหตุการณ์จริงต้องกลับไปปรับชุดทดสอบ
ควรเก็บ Log ทุกอย่างเพื่อสอบสวนหรือไม่
ไม่ การเก็บมากเกินจำเป็นเพิ่มความเสี่ยง ความเป็นส่วนตัว และต้นทุน ควรเริ่มจากคำถามสอบสวนและการควบคุมที่ต้องรองรับ แล้วเก็บข้อมูลขั้นต่ำที่เพียงพอ พร้อมสิทธิ์ ระยะเวลา การปกปิด และการลบ Log ที่ดีช่วยเชื่อม Version กับเหตุการณ์โดยไม่กลายเป็นคลังข้อมูลส่วนบุคคลไร้เจ้าของ
เมื่อใดควรใช้วิธีที่ไม่ใช่ AI
เมื่อกฎชัด เปลี่ยนน้อย และวิธีธรรมดาตรวจสอบง่ายกว่า เมื่อไม่มีข้อมูลหรือสิทธิ์ที่เหมาะสม เมื่อผลผิดสูงแต่ไม่มี Oversight หรือทางอุทธรณ์ หรือเมื่อประโยชน์เพิ่มไม่คุ้มภาระประเมินและดูแล การเลือกไม่ใช้ AI อาจเป็นการออกแบบระบบที่รับผิดชอบที่สุด ไม่ใช่การพลาดนวัตกรรม
สรุปบทเรียน: โครงการ AI ที่ดีเดินหน้าได้ ย้อนกลับได้ และหยุดได้
วงจรชีวิตเริ่มจากการทำความเข้าใจปัญหา ผู้ใช้ ผู้ได้รับผล และทางเลือกที่ไม่ใช้ AI จากนั้นจึงเตรียมข้อมูล สร้าง Baseline พัฒนาและประกอบระบบ ประเมินหลายชั้น แล้วตัดสิน Go/No-Go จากหลักฐาน ไม่ใช่จากความตื่นเต้นของเดโม เมื่อผ่านจึง Deploy แบบจำกัด พร้อม Version, Runbook, Monitoring, Feedback, Incident Response และ Rollback
หลังเปิดใช้ ทีมต้องเฝ้าทั้งสุขภาพเทคนิค คุณภาพเอาต์พุต พฤติกรรมของคน และผลกระทบ โลกจริงอาจบอกว่าปัญหาอยู่ที่หน้าจอ ข้อมูล กฎ หรือขั้นตอนงาน ไม่ใช่โมเดล ลูกศรย้อนกลับช่วยให้ทีมแก้ถูกช่วง ส่วน Change Management ป้องกันไม่ให้การเปลี่ยนเล็กสร้างความเสี่ยงใหม่โดยไม่มีใครเห็น
ท้ายที่สุด การเลิกใช้เป็นส่วนหนึ่งของการออกแบบตั้งแต่ต้น ระบบต้องมีเกณฑ์ว่าเมื่อไรประโยชน์ไม่คุ้ม เมื่อไรความเสี่ยงเกินยอมรับ และจะปิด Endpoint ถอนสิทธิ์ จัดการข้อมูล แจ้งผู้ใช้ เก็บหลักฐาน และตรวจบริการปลายทางอย่างไร ทีมที่ทำสิ่งเหล่านี้ได้ไม่ได้เพียงสร้าง AI เก่งขึ้น แต่สร้างความสามารถในการรับผิดชอบต่อ AI ตลอดชีวิตของมัน
Insight Gate: เลือกโครงการ AI หนึ่งโครงการแล้วลองวาดวงจรตั้งแต่โจทย์ถึงการเลิกใช้ หากคุณระบุผลส่งมอบ เจ้าของ เกณฑ์ผ่าน สัญญาณเตือน และทางย้อนกลับของทุกช่วงได้ พร้อมอธิบายว่าเหตุใด Deploy จึงเป็นการเริ่มความรับผิดชอบระยะใหม่ คุณเข้าใจวงจรชีวิตของโครงการ AI แล้ว
ภารกิจหลังเรียน: นำ Lifecycle Canvas จากแบบฝึกไปคุยกับเจ้าของงานจริงหนึ่งคน แล้ววงกลมช่องที่ยังไม่มีหลักฐาน เลือกหนึ่งช่องเพื่อกำหนดเจ้าของ วันตรวจ และ Stop Rule ที่ทีมทำตามได้จริง
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงหลักและหมายเหตุบรรณาธิการ
- ISO/IEC 5338:2023 — AI system life cycle processes ใช้รองรับแนวคิดกระบวนการ การควบคุม การจัดการ การดำเนินงาน และการปรับปรุงระบบ AI ตลอดวงจรชีวิต
- NIST — Artificial Intelligence Risk Management Framework (AI RMF 1.0) ใช้รองรับกรอบ Govern, Map, Measure และ Manage รวมถึงการมองความเสี่ยงตลอดวงจรระบบ
- NIST AI Resource Center — AI RMF Core ใช้รองรับหน้าที่ บทบาท การจัดทำบริบท การวัด และการจัดการความเสี่ยงในระดับองค์กรและระบบ
- NIST CAISI — Challenges to Monitoring Deployed AI Systems (NIST AI 800-4) ใช้รองรับความท้าทายของ Monitoring หลังนำระบบไปใช้จริง เช่น การเปลี่ยนข้อมูล Ground Truth ที่ล่าช้า และความซับซ้อนของระบบ
- ISO/IEC 8183:2023 — Artificial intelligence data life cycle framework ใช้รองรับการจัดการข้อมูลตั้งแต่การได้มา การสร้าง การพัฒนา การใช้งาน การบำรุงรักษา และการเลิกใช้
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 6 สิงหาคม 2026 · SOLA นำการอธิบายวงจรงาน · MIRA ตรวจความนำไปใช้จริง · SHIRO ตรวจนิยาม หลักฐาน และขอบเขตคำกล่าว · Campus Help เป็นกรณีสมมติเพื่อการศึกษา ไม่ใช่ผลทดสอบผลิตภัณฑ์ · ภาพสรุปสร้างด้วย ImageGen แบบไม่มีข้อความในภาพ และใช้ Alt Text กับคำบรรยายภาษาไทยเพื่ออธิบายความหมาย
