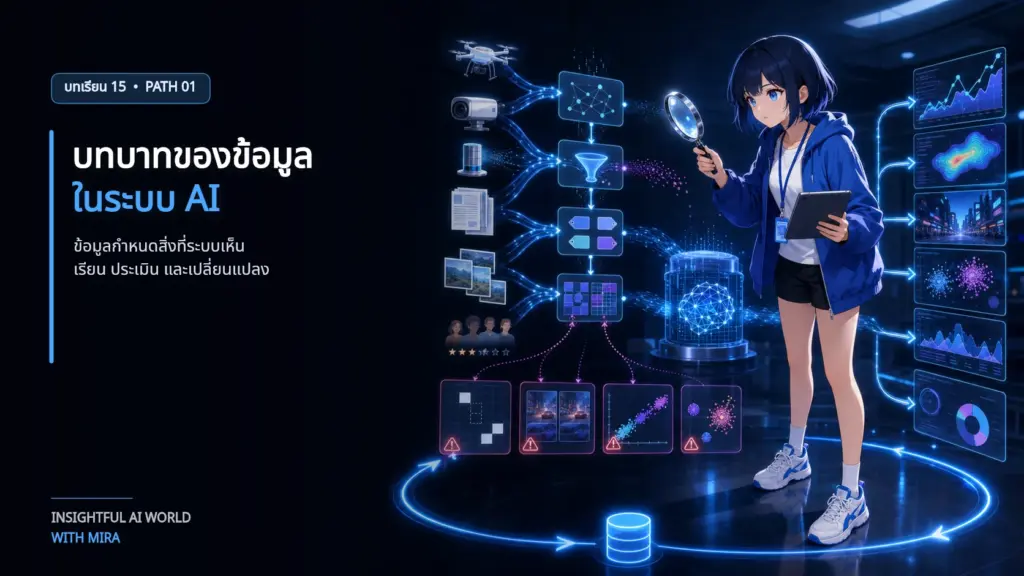
ถ้าระบบคัดแยกผลไม้เคยเห็นแต่ภาพบนโต๊ะที่สว่างและจัดฉากไว้ มันอาจทำงานดีในห้องทดลอง แต่ผิดพลาดเมื่อเจอโกดังมืด หากชุดทดสอบถ่ายด้วยกล้องเดียวกับชุดฝึก คะแนนก็อาจสูงเกินจริง และเมื่อโรงงานเปลี่ยนกล้อง ข้อมูลที่ระบบพบระหว่างใช้งานก็เปลี่ยนไปด้วย
ข้อมูลจึงไม่ใช่แค่ “เชื้อเพลิง” ที่ยิ่งเติมมากยิ่งดี แต่เป็น หลักฐานที่กำหนดสิ่งซึ่งระบบเห็น เรียนรู้ ประเมิน และติดตาม เราต้องพิจารณาที่มา บริบท การแปลง ป้ายกำกับ ความเป็นตัวแทน เวลา สิทธิ์ และข้อจำกัดตลอดวงจรชีวิต
ความรู้ก่อนเรียน: หากทบทวนองค์ประกอบของระบบ AI และวงจรชีวิตโครงการจากหัวข้อ 13–14 มาก่อน จะช่วยให้เห็นว่าข้อมูลเปลี่ยนบทบาทไปอย่างไรในแต่ละช่วง
เมื่ออ่านจบบทนี้ คุณจะทำอะไรได้
- แยกบทบาทของข้อมูลฝึก ตรวจสอบ ทดสอบ เรียกใช้ Feedback และ Monitoring ได้
- อธิบายคุณภาพข้อมูลตามบริบท โดยไม่ตัดสินจากคำว่า “สะอาด” เพียงอย่างเดียวได้
- ตรวจสอบที่มา การแปลง ป้ายกำกับ และความเป็นตัวแทนของข้อมูลได้
- มองเห็น Leakage, Drift และกลุ่มย่อยที่ขาดหายจากข้อมูลได้
- วางเอกสาร ระบุเจ้าของข้อมูล และกำหนดการดูแลตลอดวงจรชีวิตได้
1. ข้อมูลคือร่องรอยของโลก ไม่ใช่โลกทั้งใบ
ลองนึกถึงแผนที่รถไฟ แผนที่ทำให้เราเห็นสถานี เส้นทาง และจุดเชื่อม แต่ไม่ได้บันทึกเสียงคนบนชานชาลา สภาพอากาศ หรือเหตุขัดข้องทุกอย่าง ข้อมูลก็เช่นกัน มันคือร่องรอยที่ถูกเลือก วัด และบันทึกผ่านเครื่องมือบางชนิด ภายใต้ช่วงเวลาและวัตถุประสงค์ที่กำหนด สิ่งที่ไม่ได้วัดจะไม่ปรากฏ แม้จะมีอยู่จริง ส่วนสิ่งที่วัดผิดก็อาจดูน่าเชื่อเพียงเพราะอยู่ในรูปตัวเลข
อุปมานี้ช่วยให้เราเลิกถามเพียงว่า “มีข้อมูลมากไหม” แล้วหันมาถามว่า “ข้อมูลนี้มาจากโลกส่วนไหน ผ่านเครื่องมืออะไร และยังขาดอะไร” อย่างไรก็ตาม ข้อมูลต่างจากแผนที่ตรงที่มันมักถูกนำไปเปลี่ยนพฤติกรรมของโลกด้วย เมื่อระบบใช้คะแนนคัดสินค้า หรือจัดลำดับคน ผลลัพธ์ก็อาจย้อนกลับไปกำหนดสิ่งที่จะถูกเก็บในอนาคต จึงเกิดวงจร Feedback ที่ช่วยให้ระบบเรียนรู้ได้ แต่ก็อาจขยายอคติไปพร้อมกัน
ในระบบ AI ข้อมูลมีอย่างน้อยหกบทบาท ได้แก่ ตัวอย่างให้โมเดลเรียนรู้ หลักฐานสำหรับเลือกเวอร์ชัน ข้อสอบที่กันไว้ อินพุตของงานจริง สัญญาณสำหรับติดตาม และคำตอบย้อนกลับ บทบาทเหล่านี้สลับกันตามสะดวกไม่ได้ เพราะการนำข้อสอบไปช่วยฝึกก็เหมือนบอกเฉลยก่อนสอบ คะแนนอาจสูงขึ้น แต่ไม่ได้แปลว่าโมเดลเข้าใจโลกจริงดีขึ้น
2. กรณีศึกษาหลัก: FreshSort ผู้ช่วยคัดผลไม้ในโกดัง
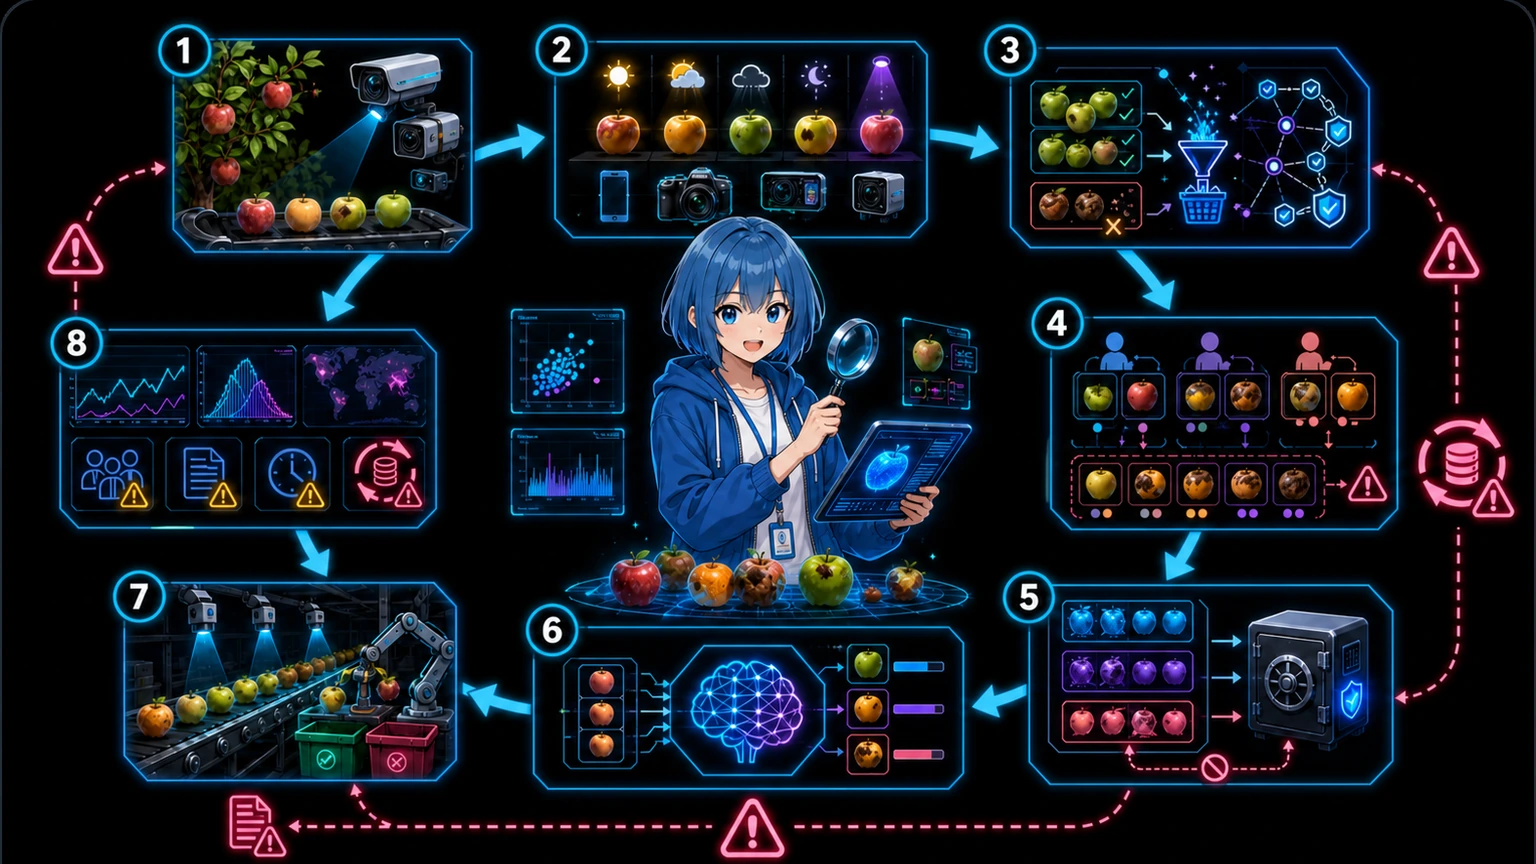
ตลอดบทนี้เราจะติดตามโครงการสมมติชื่อ FreshSort บริษัทรับซื้อผลไม้ต้องการใช้กล้องช่วยแยกผลไม้ออกเป็นสามกลุ่ม ได้แก่ พร้อมจำหน่าย ควรตรวจซ้ำ และควรคัดออก เป้าหมายไม่ใช่แทนที่คนทั้งหมด แต่ช่วยให้พนักงานเห็นรายการที่มีความเสี่ยงก่อน และลดโอกาสที่ผลไม้เสียจะหลุดไปถึงลูกค้า ระบบจะถ่ายภาพผลไม้บนสายพาน ส่งภาพเข้าโมเดล แล้วแสดงผลให้พนักงานยืนยันหรือแก้ไข
ในการสาธิต FreshSort ทำงานได้ดีมาก ภาพทั้งหมดมาจากกล้องตัวเดียว แสงคงที่ ผลไม้ถูกวางไว้กลางเฟรม และมีผู้เชี่ยวชาญสองคนช่วยติดป้าย แต่ในโลกจริงมีทั้งโกดังหลายแห่ง กล้องหลายรุ่น ผลไม้เปียก ใบไม้บัง สายพานสั่น และความสว่างที่เปลี่ยนไปตามเวลา แม้ความหมายของคำว่า “เสีย” ก็อาจต่างกันตามชนิดผลไม้และปลายทาง หากเก็บแต่ภาพที่สวยและควบคุมได้ ระบบก็จะเรียนรู้โลกที่ถูกจัดฉาก ไม่ใช่สภาพงานที่ต้องรับมือจริง
ผู้ที่ได้รับผลกระทบจึงไม่ได้มีแค่บริษัท พนักงานคัดสินค้าอาจต้องรับภาระตรวจซ้ำ เกษตรกรอาจถูกหักราคา ลูกค้าอาจได้รับสินค้าที่ไม่ได้คุณภาพ และทีมซ่อมบำรุงต้องดูแลกล้องให้พร้อมใช้งาน ดังนั้น Data Owner ต้องรู้แหล่งข้อมูล สิทธิ์ การเก็บรักษา และผลกระทบที่อาจเกิดขึ้น ส่วน Model Owner ต้องติดตามว่าคะแนนเปลี่ยนไปอย่างไรเมื่อข้อมูลเปลี่ยน และฝ่ายปฏิบัติการต้องมีสิทธิ์หยุดระบบเมื่อพบว่าภาพผิดปกติ
FreshSort จะเป็นเส้นเรื่องที่เชื่อมทุกส่วนของบทเรียน เราจะถามซ้ำว่าแต่ละชุดข้อมูลมาจากกล้องใด ใครเป็นผู้ติดป้าย กลุ่มใดหายไป ชุดทดสอบเป็นอิสระจริงหรือไม่ ข้อมูลระหว่างใช้งานเปลี่ยนอย่างไร และ Feedback ใดน่าเชื่อถือ คำถามเหล่านี้ทำให้ Provenance, Leakage และ Drift ไม่ใช่ศัพท์ที่ลอยแยกกัน แต่เป็นมุมมองที่ใช้ตรวจสอบเหตุการณ์เดียวกันได้
3. ข้อมูลหลายชุดทำหน้าที่ต่างกัน
| ชนิดข้อมูล | หน้าที่ | ความผิดพลาดที่พบบ่อย |
|---|---|---|
| ข้อมูลฝึก | ปรับพารามิเตอร์หรือเรียนกฎ | มีข้อมูลซ้ำ คำตอบรั่วไหล หรือครอบคลุมบางกลุ่มแคบเกินไป |
| ข้อมูลตรวจสอบ | เลือกโมเดลและตั้งค่า | ปรับตามชุดนี้หลายรอบจนชุดตรวจสอบกลายเป็นส่วนหนึ่งของการฝึก |
| ข้อมูลทดสอบ | ประมาณผลกับข้อมูลที่ไม่เคยใช้ตัดสินใจพัฒนา | คล้ายชุดฝึกเกินไป หรือถูกใช้ซ้ำจนทีมรู้คำตอบ |
| ข้อมูลเรียกใช้ | อินพุตจริงเมื่อระบบทำงาน | รูปแบบ หน่วย ภาษา หรืออุปกรณ์ต่างจากตอนทดลอง |
| Feedback | บอกผลลัพธ์ การแก้ไข และประสบการณ์ผู้ใช้ | เก็บเฉพาะคนที่ร้องเรียน หรือใช้ปุ่มที่ตีความได้หลายแบบ |
| ข้อมูล Monitoring | ติดตามสุขภาพ คุณภาพ และผลกระทบ | มี Log แต่ไม่มีคำตอบจริงหรือบริบทของการตัดสินใจ |
4. คุณภาพข้อมูลต้องตอบให้ได้ว่า “ดีพอสำหรับงานใด”
ความถูกต้องเป็นเพียงมิติหนึ่งของคุณภาพข้อมูล ยังมีความครบถ้วน ความสอดคล้อง ความเป็นปัจจุบัน ความละเอียด ความเป็นตัวแทน ความเกี่ยวข้อง ความปลอดภัย และความสามารถในการย้อนกลับไปยังแหล่งเดิม ข้อมูลที่เหมาะสำหรับสรุปแนวโน้ม อาจไม่ดีพอสำหรับการตัดสินใจรายบุคคล
NIST AI RMF Playbook เน้นให้บันทึกแหล่งกำเนิด การแปลง การเพิ่มข้อมูล ป้ายกำกับ การพึ่งพา ข้อจำกัด และ Metadata เพราะคุณภาพกับความเป็นตัวแทนของข้อมูลเชื่อมโยงโดยตรงกับรูปแบบที่ AI อาจล้มเหลว
5. ที่มาและการแปลงทำให้เราตรวจสอบข้อมูลย้อนหลังได้
Provenance ตอบว่าใครสร้างข้อมูล เก็บเมื่อไร ใช้เครื่องมือใด ภายใต้เงื่อนไขอะไร และข้อมูลผ่านการเปลี่ยนแปลงขั้นใดบ้าง ส่วน Lineage แสดงเส้นทางตั้งแต่แหล่งต้นทาง ผ่านการรวม กรอง ลบข้อมูลซ้ำ แปลงหน่วย และสร้างฟีเจอร์ จนกลายเป็นชุดข้อมูลที่นำไปใช้จริง
เมื่อพบผลลัพธ์ผิด เราต้องย้อนกลับไปดูได้ว่าอินพุตมาจากข้อมูลรุ่นใด ผ่านโค้ดใด และกระทบชุดข้อมูลใดบ้าง หากไม่มีร่องรอยเหล่านี้ การแก้ปัญหาก็จะเหลือเพียงการคาดเดา
6. ป้ายกำกับไม่ใช่ความจริงที่ไร้ข้อจำกัด
ป้ายกำกับอาจมาจากผู้เชี่ยวชาญ ผู้รับจ้าง กฎ Heuristic เหตุการณ์ในระบบ หรือการอนุมานย้อนหลัง แหล่งที่มาแต่ละแบบมีทั้งความไม่แน่นอน ความเห็นต่าง และแรงจูงใจที่ต่างกัน ตัวอย่างเช่น คำว่า “เนื้อหาไม่เหมาะสม” อาจขึ้นอยู่กับบริบท ภาษา วัฒนธรรม และนโยบายที่ใช้ตัดสิน
จึงควรบันทึกคำแนะนำสำหรับผู้ติดป้าย ระดับความเชี่ยวชาญ ความเห็นพ้อง กรณีที่ไม่แน่ใจ วิธีจัดการข้อขัดแย้ง และเวอร์ชันของนโยบาย สำหรับบางงาน ควรเก็บการกระจายของความเห็นไว้ แทนการบีบทุกกรณีให้เหลือคำตอบเดียว
7. ความเป็นตัวแทนต้องสัมพันธ์กับประชากรและบริบทเป้าหมาย
ชุดข้อมูลไม่จำเป็นต้องสะท้อนทุกคนบนโลก แต่ต้องเหมาะกับผู้ใช้ สภาพแวดล้อม และการตัดสินใจภายในขอบเขตที่ประกาศไว้ เราจึงต้องตรวจทั้งจำนวนของแต่ละกลุ่ม คุณภาพภายในกลุ่ม และสถานการณ์ที่กลุ่มนั้นพบ ไม่ใช่ดูเพียงสัดส่วนรวม
MIRA ชวนถาม: ใครอยู่ในข้อมูล ใครหายไป ใครถูกวัดผิด และโลกจริงวันนี้ต่างจากวันที่เก็บข้อมูลอย่างไร
8. เมื่อโลกเปลี่ยน ข้อมูลก็เปลี่ยนตาม
Data Drift คือรูปแบบของอินพุตเปลี่ยน Concept Drift คือความสัมพันธ์ระหว่างอินพุตกับคำตอบเปลี่ยน และ Label Shift คือสัดส่วนของคำตอบเปลี่ยน การพบ Drift ไม่ได้หมายความว่าต้องฝึกโมเดลใหม่ทันที ต้องตรวจสาเหตุ ผลกระทบ คุณภาพของ Ground Truth และความเสี่ยงของแต่ละทางแก้ก่อน
Feedback ที่ดีควรรวมผลลัพธ์จริง การแก้ไขของมนุษย์ เหตุผลที่ Override เหตุการณ์ร้องเรียน และข้อมูลของกลุ่มย่อย พร้อมมาตรการป้องกันไม่ให้ผู้โจมตีหรือวงจรอคติป้อนข้อมูลกลับเข้าไปจนระบบแย่ลง
9. สิทธิ์ ความปลอดภัย และอายุข้อมูลก็เป็นส่วนหนึ่งของคุณภาพ
ข้อมูลที่ใช้ได้ในทางเทคนิค อาจใช้ไม่ได้ตามสิทธิ์ สัญญา ความยินยอม หรือวัตถุประสงค์เดิม จึงต้องกำหนดการเข้าถึง การเก็บรักษา การส่งต่อ การลบ และการใช้ข้อมูลอ่อนไหวอย่างชัดเจน พร้อมป้องกันข้อมูลรั่วจาก Log, Cache, Prompt หรือโมเดล
ISO/IEC 8183 วางกรอบการดูแลข้อมูลตั้งแต่การได้มา การสร้าง การพัฒนา การใช้งาน การบำรุงรักษา ไปจนถึงการเลิกใช้ ดังนั้นต้องมีแผน Archive หรือแผนทำลายข้อมูลอย่างปลอดภัยเมื่อข้อมูลหมดประโยชน์
10. ทดลองทำ: สร้าง Datasheet ฉบับย่อสำหรับข้อมูลหนึ่งชุด
- ระบุผู้สร้าง วัตถุประสงค์ แหล่งที่มา และช่วงเวลาที่เก็บข้อมูล
- อธิบายองค์ประกอบ หน่วย การสุ่มตัวอย่าง และสิ่งที่ถูกตัดออก
- ระบุวิธีติดป้าย ความไม่แน่นอน และกลุ่มที่ข้อมูลครอบคลุม
- บันทึกการทำความสะอาด การแปลง การลบข้อมูลซ้ำ และการเพิ่มข้อมูล
- ระบุการใช้งานที่แนะนำ การใช้งานที่ห้าม ข้อจำกัด และอายุของข้อมูล
- กำหนดเจ้าของข้อมูล ช่องทางรายงานปัญหา และเงื่อนไขการอัปเดตหรือเลิกใช้
11. จากค่าเฉลี่ยสู่คุณภาพที่มองเห็นกลุ่มย่อย
คะแนนรวมอาจซ่อนความเสียหายของบางกลุ่มไว้ได้ สมมติว่า FreshSort มีความแม่นยำโดยรวม 94% แต่เมื่อแยกดูพบว่า ผลไม้สีเข้มในกะกลางคืนมีความแม่นยำเพียง 62% ค่าเฉลี่ยยังสูงเพราะกลุ่มนี้มีจำนวนน้อย หากผลไม้กลุ่มนี้มีราคาสูง ความผิดพลาดแต่ละครั้งก็ยิ่งมีความหมาย การประเมินจึงควรแยกตามมิติที่เชื่อมโยงกับสาเหตุและผลกระทบ ไม่ใช่แบ่งกลุ่มจำนวนมากเพียงเพื่อทำตารางโดยไม่มีคำถามที่ชัดเจน
มิติที่เลือกควรเชื่อมกับสมมติฐาน เช่น กล้องเกี่ยวข้องกับคุณภาพของเซนเซอร์ กะเวลาเกี่ยวข้องกับแสง ชนิดผลไม้เกี่ยวข้องกับลักษณะรอยเสีย และโกดังเกี่ยวข้องกับสายพานกับวิธีทำงาน เราควรดูทั้งจำนวนตัวอย่าง อัตราความผิดพลาด ช่วงความไม่แน่นอน และชนิดของความผิดพลาด เพราะกลุ่มเล็กอาจให้ค่าผันผวนจนยังสรุปไม่ได้ ในกรณีนี้ควรระบุว่า “หลักฐานยังไม่พอ” แทนการตีความว่าความแตกต่างทุกอย่างเป็นปัญหา
Intersection หรือจุดตัดของกลุ่ม มักเผยปัญหาที่ค่าเฉลี่ยชั้นเดียวมองไม่เห็น ตัวอย่างเช่น ระบบไม่ได้พลาดกับผลไม้สีเข้มทุกภาพ แต่พลาดกับผลไม้สีเข้มที่ถ่ายจากกล้องรุ่นเก่าในกะกลางคืน การเก็บ Metadata ที่เหมาะสมจึงช่วยค้นหาสาเหตุได้ แต่ต้องระวังไม่เก็บข้อมูลส่วนบุคคลเกินจำเป็น หากมิติใดมีความอ่อนไหว ควรกำหนดสิทธิ์และระบุวัตถุประสงค์ให้ชัดเจนเมื่อใช้เพื่อประเมินความเป็นธรรม
Coverage ไม่ได้หมายความว่าแต่ละกลุ่มมีตัวอย่างอย่างน้อยหนึ่งรายการเท่านั้น แต่ต้องถามว่าข้อมูลครอบคลุมความหลากหลายและกรณีขอบเขตเพียงพอหรือไม่ FreshSort ควรมีทั้งผลไม้ปกติ รอยช้ำ เชื้อรา ใบไม้บัง ภาพเบลอ ผลไม้ซ้อน และกรณีที่มนุษย์ยังเห็นต่างกัน หากไม่มีกรณียาก ชุดข้อมูลอาจดูเป็นระเบียบ แต่โมเดลจะไม่ได้เรียนรู้วิธีรับมือกับความไม่แน่นอน
เมื่อพบกลุ่มที่ขาด การคัดลอกตัวอย่างเดิมเพื่อเพิ่มจำนวนไม่ใช่ทางแก้ เพราะไม่ได้เพิ่มความหลากหลาย ควรวางแผนเก็บข้อมูลเพิ่มจากโลกจริง ใช้ Active Sampling เพื่อเลือกกรณีที่โมเดลไม่แน่ใจหรือผิดบ่อย และกำหนด Stop Condition ว่าหลักฐานระดับใดจึงเพียงพอสำหรับการใช้งานแบบจำกัด หากยังเก็บข้อมูลไม่ได้ ควรลดขอบเขตการใช้งานหรือส่งต่อให้มนุษย์ แทนการประกาศว่าระบบใช้ได้กับทุกกรณี
คุณภาพข้อมูลคือสัญญา ไม่ใช่คะแนนเดียว
ทีมควรสร้าง Data Quality Contract ระหว่างแหล่งต้นทางกับ Pipeline โดยระบุ Schema หน่วย ช่วงค่า ความถี่ เวลา ความสด รหัสกล้อง อัตราค่าว่าง และเงื่อนไขที่ต้องหยุดงาน ตัวอย่างเช่น ภาพต้องมีขนาดขั้นต่ำ เวลาของกล้องต้องคลาดเคลื่อนไม่เกินเกณฑ์ และรหัสล็อตต้องเชื่อมกับคลังสินค้าได้ หากละเมิดสัญญา ระบบควรกักข้อมูลไว้ ไม่ควรเดาแล้วเดินหน้าต่อโดยไม่แจ้งใคร
สัญญานี้ควรแยก Hard Check ออกจาก Soft Check ไฟล์เสียหรือ Schema ไม่ตรงอาจเป็น Hard Check ที่ปฏิเสธข้อมูล ส่วนสัดส่วนภาพมืดที่เพิ่มขึ้นเล็กน้อยอาจเป็น Soft Check ซึ่งใช้แจ้งเตือนและสุ่มตรวจ หากกำหนดทุกอย่างเป็น Hard Check งานจะหยุดบ่อยเกินไป แต่ถ้าทำทุกอย่างเป็นเพียงคำเตือน Alert ก็อาจถูกมองข้าม เจ้าของข้อมูลจึงต้องระบุระดับการตอบสนองและเวลาที่ต้องแก้ให้ชัด
การทำความสะอาดข้อมูลทุกครั้งเป็นการตัดสินใจเชิงความหมาย การลบค่าผิดปกติอาจลบเหตุการณ์สำคัญ การเติมค่าที่หายอาจทำให้กลุ่มหนึ่งดูเหมือนกลุ่มส่วนใหญ่ และการลบข้อมูลซ้ำอาจผิดหากหลายเหตุการณ์จริงมีค่าเหมือนกัน FreshSort จึงต้องบันทึกจำนวนรายการที่ถูกกรอง เหตุผล ตัวอย่างก่อนและหลัง รวมถึงผลต่อกลุ่มย่อย เพื่อให้ย้อนกลับไปตรวจได้เมื่อกฎทำความสะอาดผิดพลาด
Data Augmentation เช่น การหมุนภาพ ปรับแสง หรือเติม Noise ช่วยให้โมเดลเห็นความแปรผันมากขึ้น แต่ต้องไม่ทำให้ป้ายกำกับเปลี่ยนความหมาย การกลับภาพอาจไม่เป็นปัญหาสำหรับผลไม้ ทว่าการปรับสีมากเกินไปอาจทำลายสัญญาณเรื่องความสุก การเพิ่มข้อมูลจึงควรตั้งอยู่บนสมมติฐานว่าโลกจริงเปลี่ยนแปลงแบบใด และต้องทดสอบว่าตัวอย่างใหม่ยังสมจริง ไม่ใช่เพิ่มเพียงเพราะไลบรารีมีปุ่มให้กด
ท้ายที่สุด คำว่า “ดีพอ” ต้องเชื่อมโยงกับการตัดสินใจ หาก FreshSort เพียงจัดลำดับรายการให้คนตรวจ ความผิดพลาดบางชนิดอาจยอมรับได้มากกว่าระบบที่คัดทิ้งโดยอัตโนมัติ ยิ่งผลลัพธ์ย้อนกลับได้ยากหรือส่งผลกระทบมาก เกณฑ์ข้อมูล การประเมินอิสระ และ Fallback ก็ต้องเข้มงวดขึ้น ข้อมูลชุดเดียวจึงอาจดีพอสำหรับการทดลอง แต่ยังไม่ดีพอสำหรับอนุมัติใช้งานเต็มรูปแบบ
12. แบ่งข้อมูลอย่างซื่อสัตย์: ฝึก เลือก ทดสอบ และเฝ้าดู
การแบ่งชุดไม่ใช่พิธีกรรมทางสถิติ แต่เป็นการแยกหน้าที่เพื่อป้องกันไม่ให้เราหลอกตัวเอง ชุดฝึกใช้ปรับพารามิเตอร์ ชุดตรวจสอบใช้เลือกโมเดลและตั้งค่า ชุดทดสอบใช้ประเมินครั้งสุดท้าย โดยไม่ควรถูกนำไปตัดสินใจพัฒนา ส่วนข้อมูลใช้งานจริงใช้ติดตามระบบหลัง Deploy และมักยังไม่มีคำตอบจริงให้เห็นทันที
ถ้า FreshSort สุ่มภาพทีละไฟล์ ภาพต่อเนื่องของผลไม้ลูกเดียวกันอาจกระจายไปอยู่ทั้งชุดฝึกและชุดทดสอบ โมเดลจึงอาจจำพื้นหลัง รอยบนสายพาน หรือมุมกล้อง แทนที่จะเรียนรู้ลักษณะของผลไม้ที่เสีย วิธีที่ซื่อสัตย์กว่าคือแบ่งตามหน่วยที่ทำให้ข้อมูลมีความสัมพันธ์กัน เช่น ล็อตผลไม้ วันถ่าย กล้อง โกดัง หรือฤดูกาล แล้วเลือกหน่วยให้ใกล้เคียงกับคำถามการใช้งานจริง
Time Split มีความสำคัญเมื่อโลกเปลี่ยนไปตามเวลา เราอาจฝึกจากสามเดือนแรก ตรวจสอบจากเดือนที่สี่ และทดสอบจากเดือนที่ห้าเพื่อจำลองอนาคต แต่ถ้าต้องเปิดโกดังใหม่ ก็ควรมี Location Holdout ที่กันโกดังหนึ่งไว้ทั้งแห่ง การแบ่งชุดที่ดีจึงควรเริ่มจาก Deployment Question ไม่ใช่ยึดสูตร 80/10/10 ว่าใช้ได้กับทุกงาน
ชุดทดสอบควรมีทะเบียนว่าใครเข้าถึง เมื่อใด และถูกใช้กี่ครั้ง หากทีมเปิดดูผลทุกวันแล้วปรับโมเดลตาม ชุดนั้นก็กลายเป็นชุดตรวจสอบโดยพฤตินัย จึงต้องสร้างชุดทดสอบใหม่ หรือใช้การประเมินที่เป็นอิสระ สำหรับงานที่มีความเสี่ยงสูง ควรมี Shadow Test ซึ่งรันระบบกับข้อมูลจริง แต่ยังไม่นำผลไปตัดสินสินค้า
| ชุดข้อมูล | ใช้ตัดสินใจอะไร | คำถามควบคุม | สัญญาณผิดปกติ |
|---|---|---|---|
| ฝึก | ปรับสิ่งที่โมเดลเรียน | ตัวอย่างซ้ำและกลุ่มย่อยสมดุลหรือไม่ | จำภาพเดิมได้แต่พังกับล็อตใหม่ |
| ตรวจสอบ | เลือกเวอร์ชันและ Threshold | ปรับตามชุดนี้กี่รอบ | คะแนนดีขึ้นเฉพาะชุดเดิม |
| ทดสอบ | ประเมินก่อนอนุมัติ | แยกตามกล้อง เวลา และล็อตหรือไม่ | ทีมรู้คำตอบและเลือกโมเดลจากผลนี้ |
| ใช้งานจริง | สร้างผลลัพธ์และ Monitoring | รูปแบบต่างจากการทดลองตรงไหน | สัดส่วนภาพมืดหรือเบลอเพิ่ม |
13. Leakage และทางลัด: โมเดลตอบถูกด้วยเหตุผลผิด
Data Leakage คือการที่ข้อมูลซึ่งไม่ควรมีในเวลาที่ใช้งานจริง หลุดเข้าไปช่วยการฝึกหรือการประเมิน ตัวอย่างที่เห็นได้ชัดคือการใส่ผลตรวจสุดท้ายของผู้เชี่ยวชาญเป็นฟีเจอร์ เพื่อทำนายผลตรวจเดียวกันนั้น แต่ Leakage ที่อันตรายกว่ามักซ่อนอยู่ในสิ่งที่ดูธรรมดา เช่น ชื่อไฟล์ วันที่หลังเหตุการณ์ หรือการแปลงข้อมูลที่คำนวณจากทั้งชุดก่อนแบ่ง
FreshSort พบว่าภาพผลไม้เสียมักถ่ายบนถาดสีแดง ส่วนผลไม้ดีอยู่บนถาดสีเขียว โมเดลจึงเรียนรู้สีถาดแทนที่จะดูรอยช้ำ เมื่อย้ายไปโกดังที่ใช้ถาดสีเดียวกันทั้งหมด คะแนนก็ตกทันที นี่คือ Shortcut Learning หรือการเรียนรู้ทางลัด โมเดลไม่ได้โกงอย่างมีเจตนา แต่มันเลือกใช้สัญญาณที่ทำนายได้ง่ายที่สุดจากหลักฐานที่เราให้
เราตรวจหาทางลัดได้หลายวิธี เช่น ปิดบังพื้นหลัง สลับสีถาด ทดสอบกับกล้องรุ่นใหม่ ดูตัวอย่างที่โมเดลมั่นใจแต่ตอบผิด ตรวจภาพอธิบายอย่างระมัดระวัง และเปรียบเทียบกับ Baseline ที่ใช้ข้อมูลพื้นหลังเท่านั้น หาก Baseline แบบง่ายทำคะแนนได้สูง ก็เป็นสัญญาณว่าชุดข้อมูลอาจมีเบาะแสรั่ว
Preprocessing Leakage เกิดเมื่อเราคำนวณค่าเฉลี่ย เติมค่าที่หาย หรือเลือกฟีเจอร์จากข้อมูลทั้งหมดก่อนแบ่งชุด ชุดทดสอบจึงส่งข้อมูลเชิงสถิติย้อนกลับเข้าไปในกระบวนการฝึก ทางแก้คือแบ่งหน่วยข้อมูลก่อน แล้ว Fit ขั้นตอนการแปลงบนชุดฝึกเท่านั้น จากนั้นใช้พารามิเตอร์เดิม Transform ชุดตรวจสอบและชุดทดสอบ พร้อมบันทึก Version ของ Pipeline
คำถามสำคัญจึงไม่ใช่แค่ “มีคอลัมน์คำตอบรั่วหรือไม่” แต่คือ “โมเดลเข้าถึงสัญญาณใดที่โลกจริงจะไม่มี หรือเข้าถึงสัญญาณนั้นก่อนเวลาใช้งานหรือไม่” การวาด Lineage ตั้งแต่แหล่งต้นทางจนถึงฟีเจอร์ ช่วยค้นหาการรั่วที่ซ่อนอยู่ใน Job รวมข้อมูลและ Cache ได้ดีกว่าการดูเฉพาะตารางสุดท้าย
14. Monitoring และ Feedback ที่นำไปสู่การตัดสินใจ
หลัง Deploy เรามักเห็นอินพุตและ Prediction ได้ทันที แต่ Ground Truth อาจมาช้าหลายชั่วโมงหรือหลายวัน FreshSort จึงรู้ได้เร็วว่าภาพมืดขึ้น ไฟล์เสีย หรือสัดส่วนความมั่นใจเปลี่ยน แต่จะรู้ว่าคัดถูกหรือไม่ก็ต่อเมื่อมีการตรวจซ้ำ ดังนั้น Dashboard ควรแยก Leading Indicator เช่น ความสว่าง ความเบลอ Schema และ Drift ออกจาก Outcome Indicator เช่น ของเสียที่หลุดไป หรือของดีที่ถูกคัดทิ้ง
Drift Metric เพียงตัวเดียวไม่เพียงพอ ทีมควรดูการเปลี่ยนแปลงทั้งระดับอินพุต ฟีเจอร์ คะแนน และผลลัพธ์ พร้อมเทียบกับ Baseline ที่มีบริบทเดียวกัน การเปรียบเทียบกะกลางคืนกับค่าเฉลี่ยทั้งปีอาจทำให้แจ้งเตือนตลอดโดยไม่ช่วยตัดสินใจ จึงควรมี Seasonal Baseline และบันทึกการเปลี่ยนอุปกรณ์ โปรโมชั่น ฤดูกาล และนโยบายที่อาจอธิบายการเปลี่ยนแปลงได้
Alert ที่ดีควรตอบให้ได้ว่าเกิดอะไรขึ้น ที่ไหน รุนแรงเพียงใด ใครเป็นเจ้าของ และต้องทำอะไรต่อ ตัวอย่างเช่น “ค่า Drift สูง” ยังนำไปใช้ไม่ได้ แต่ข้อความว่า “ภาพจากกล้อง B ในกะกลางคืนมีความสว่างต่ำกว่า Baseline ต่อเนื่อง 30 นาที ให้ฝ่ายปฏิบัติการเปลี่ยนเป็นการตรวจด้วยคนและแจ้ง Data Owner” เป็นสัญญาณที่เชื่อมกับการลงมือทำ
Feedback Channel ต้องเปิดโอกาสให้คนบอกเหตุผล ไม่ใช่มีเพียงปุ่มถูกหรือผิด พนักงานอาจแก้ผลเพราะภาพผิด ป้ายสินค้าไม่ตรง โมเดลสับสน หรือข้อกำหนดของปลายทางเปลี่ยน เหตุผลแต่ละแบบชี้ไปยังจุดแก้ที่ต่างกัน หากเก็บแค่คำตอบสุดท้าย เราจะรู้ว่ามีความแตกต่าง แต่ไม่รู้ว่าควรแก้ข้อมูล โมเดล หน้าจอ หรือ Workflow
ก่อนนำ Feedback กลับไปฝึก ต้องผ่าน Quarantine หรือพื้นที่พัก เพื่อตรวจความสมบูรณ์ ตรวจผู้ส่ง ตรวจการโจมตี และสุ่มประเมินโดยอิสระก่อนรวมเข้ากับชุดหลัก ต้องรักษาแหล่งกำเนิดและน้ำหนักของข้อมูล ไม่ให้ Feedback ปริมาณมากจากกลุ่มเดียวกลบข้อมูลอื่น และต้องนำชุดที่ปนเปื้อนออกได้ โดยรู้ว่าโมเดลเวอร์ชันใดได้รับผลกระทบ
Retraining ไม่ใช่คำตอบอัตโนมัติ ปัญหาบางอย่างแก้ได้ปลอดภัยกว่าด้วยการปรับกล้อง Schema กฎธุรกิจ Threshold หรือหน้าจอ การฝึกใหม่อาจทำให้กลุ่มเดิมแย่ลง และเปลี่ยนพฤติกรรมที่ผู้ใช้คุ้นเคย ทุกครั้งจึงต้องเปรียบเทียบกับ Champion Model บนชุดทดสอบอิสระ กลุ่มย่อย และเหตุการณ์ขอบเขต รวมถึงทำ Shadow Deployment พร้อมแผน Rollback
วงจร Monitoring ควรจบลงที่การตัดสินใจและการเรียนรู้ ไม่ใช่การสะสมกราฟ ทีมควรทบทวน Alert ที่ไม่ก่อให้เกิดการลงมือทำ เหตุการณ์ที่ตรวจไม่พบ เวลาตอบสนอง และต้นทุนของ False Alarm แล้วปรับเกณฑ์ให้เหมาะสม ระบบที่มี Dashboard สวยงาม แต่ไม่มีเจ้าของหรืออำนาจสั่งหยุด ก็ยังไม่มี Monitoring ที่ใช้ได้จริง
15. หกจุดพลาดที่ทำให้ข้อมูลดูดี แต่ระบบใช้จริงไม่ได้
กรณีที่ 1: Sampling Bias — เก็บข้อมูลเฉพาะช่วงที่สะดวก
ทีมเก็บภาพ FreshSort เฉพาะกะเช้าเพราะมีแสงดี ทั้งที่กะกลางคืนอาจเป็นช่วงที่ความผิดพลาดสร้างความเสียหายมากที่สุด คะแนนรวมจึงไม่สะท้อนความเสี่ยงจริง ทางควบคุมคือกำหนด Sampling Frame ตามโกดัง กะเวลา กล้อง ชนิดผลไม้ ฤดูกาล และสภาพผิดปกติ แล้วรายงาน Coverage ก่อนรายงาน Accuracy
กรณีที่ 2: Label Noise — ผู้ติดป้ายเห็นไม่ตรงกัน
ผู้ติดป้ายบางคนใช้สีเป็นเกณฑ์ บางคนใช้ความนิ่ม และบางคนยึดปลายทางของสินค้า หากไม่บันทึก Guideline กับความไม่แน่ใจ โมเดลก็อาจเรียนรู้ความขัดแย้งเหล่านี้ราวกับเป็นความจริง ทางควบคุมคือเตรียมตัวอย่างอ้างอิง ช่อง “ไม่แน่ใจ” การสุ่มตรวจ ความเห็นพ้อง และขั้น Escalation ไปยังผู้เชี่ยวชาญ
กรณีที่ 3: Duplicate Leakage — ผลไม้ลูกเดียวกันอยู่หลายชุด
ภาพต่อเนื่องสิบเฟรมของผลไม้ลูกเดียวกันอาจดูเหมือนสิบตัวอย่าง หากสุ่มทีละภาพ เฟรมที่เกือบเหมือนกันก็อาจข้ามไปอยู่ในชุดทดสอบ ทำให้คะแนนสูงเกินจริง ต้องสร้าง Group ID ของล็อตหรือวัตถุ แบ่งข้อมูลตามกลุ่ม และตรวจ Near-Duplicate ด้วยลายนิ้วมือภาพ
กรณีที่ 4: Stale Data — โลกเปลี่ยน แต่ชุดข้อมูลไม่เปลี่ยน
เมื่อเปลี่ยนกล้อง แสง บรรจุภัณฑ์ หรือสายพันธุ์ผลไม้ Distribution ก็อาจเปลี่ยน แม้โค้ดของโมเดลจะเหมือนเดิม ทางควบคุมคือบันทึกวันที่เริ่มมีผล Version ของอุปกรณ์ สัญญาณ Drift และอายุข้อมูล ไม่ควรฝึกใหม่โดยอัตโนมัติเพียงเพราะถึงกำหนดเวลา ต้องประเมินสาเหตุและคุณภาพของ Ground Truth ก่อน
กรณีที่ 5: Feedback Contamination — ส่งผลเดิมกลับไปเป็นคำตอบ
ถ้าถือว่าพนักงานไม่แก้ผลหมายความว่าโมเดลตอบถูก ระบบจะสะสม Automation Bias เพราะพนักงานอาจรีบหรือมองไม่เห็นรายละเอียด ต้องแยก “ถูกส่งต่อ” ออกจาก “ตรวจแล้วถูก” เก็บเหตุผลการแก้ไข และสุ่มตรวจตัวอย่างโดยผู้ประเมินที่ไม่เห็นคำตอบของโมเดล
กรณีที่ 6: Governance Gap — มีข้อมูล แต่ไม่มีสิทธิ์ใช้
ภาพอาจติดใบหน้าพนักงาน ป้ายทะเบียน หรือข้อมูลของคู่ค้า แม้ข้อมูลเหล่านี้จะช่วยโมเดลได้ แต่ก็อาจขัดกับวัตถุประสงค์เดิม ทางควบคุมคือใช้ Data Minimization การพรางข้อมูล การจำกัดสิทธิ์ Retention Schedule ช่องทางลบ และทะเบียนการส่งต่อ หากพิสูจน์สิทธิ์หรือแยกข้อมูลอ่อนไหวไม่ได้ ต้องหยุดใช้ชุดนั้น
กฎการตัดสินใจเมื่อพบปัญหา
- หยุดใช้ข้อมูลหรือผลลัพธ์ในขอบเขตที่มีความเสี่ยง
- ระบุชุดข้อมูล เวอร์ชัน กล้อง เวลา และกลุ่มที่ได้รับผลกระทบ
- แยกให้ออกว่าสาเหตุอยู่ที่การเก็บ ป้ายกำกับ การแบ่ง การแปลง หรือ Feedback
- แก้ที่ต้นเหตุ และสร้างชุดทดสอบที่เป็นอิสระ
- บันทึกการเปลี่ยนแปลง เจ้าของ ผู้อนุมัติ และเงื่อนไขสำหรับกลับมาใช้
16. แบบฝึกปฏิบัติ: ตรวจ FreshSort แบบนักสืบข้อมูล
สถานการณ์: หลังเปลี่ยนกล้องในโกดัง B อัตราการคัดออกเพิ่มขึ้นมาก พนักงานบอกว่าผลไม้ยังเหมือนเดิม แต่ภาพมีโทนสีน้ำเงิน และบางกะมืดกว่าก่อน คุณได้รับภาพตัวอย่าง 200 ภาพ Log การทำนาย และรายการแก้ไขของพนักงานตลอดหนึ่งสัปดาห์
- ตั้งสมมติฐานก่อนตรวจ: เขียนสมมติฐานสามข้อว่าอาจเกิด Data Drift, Label Shift, Concept Drift หรือปัญหา Workflow พร้อมระบุสัญญาณที่คาดว่าจะเห็น
- แบ่งตัวอย่างตามโกดัง กล้อง กะเวลา ชนิดผลไม้ และระดับความมั่นใจ อย่าดูเฉพาะค่าเฉลี่ยรวม
- ตรวจ Provenance ว่ากล้องเปลี่ยนเมื่อใด Pipeline สีและการปรับขนาดเป็น Version ใด และ Log เชื่อมกับภาพถูกต้องหรือไม่
- สุ่มให้ผู้เชี่ยวชาญติดป้ายใหม่โดยไม่เห็นคำตอบของโมเดล แล้วเปรียบเทียบกับ Feedback ของพนักงาน
- ตัดสินใจว่าจะ Rollback กล้อง ปรับ Pipeline ปรับ Threshold เก็บข้อมูลเพิ่ม หรือฝึกใหม่ พร้อมอธิบายเหตุผลและความเสี่ยง
เกณฑ์ตรวจคำตอบ
คำตอบที่ดีต้องแยกสัญญาณออกจากสาเหตุ ระบุกลุ่มย่อย ไม่ถือว่า Feedback เป็น Ground Truth โดยอัตโนมัติ มีการทดสอบที่ช่วยหักล้างสมมติฐาน และเสนอวิธีลดผลกระทบก่อนแก้ระยะยาว หากรีบตอบว่า “ฝึกใหม่” โดยยังไม่ตรวจกล้อง Pipeline และ Label คำตอบนั้นยังไม่ผ่าน
ตัวอย่างข้อสรุป: พบ Drift ของโทนสีหลังเปลี่ยนกล้องเฉพาะกะกลางคืน แต่เมื่อปรับสีด้วย Pipeline เดิม ผลลัพธ์ดีขึ้น จึง Rollback การตั้งค่ากล้องและเปิด Shadow Test ก่อนตัดสินใจเก็บข้อมูลเพิ่ม ขณะนี้ยังไม่มีหลักฐานว่า Concept เปลี่ยน จึงยังไม่ฝึกโมเดลใหม่
17. แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่ดีที่สุดให้ครบทุกข้อ แล้วกด “ตรวจคำตอบ” ระบบจะแสดง Feedback รายข้อ คะแนน และจำนวนข้อที่ยังไม่ตอบ
18. คำถามที่พบบ่อย
ข้อมูลมากขึ้นทำให้ AI ดีขึ้นเสมอหรือไม่
ไม่เสมอไป ข้อมูลที่ซ้ำ ผิด เก่า รั่วคำตอบ หรือไม่แทนบริบทจริง อาจทำให้ต้นทุนสูงขึ้นและทำให้ระบบมั่นใจผิดมากขึ้น สิ่งสำคัญคือ Coverage, Quality, Provenance และความสัมพันธ์กับงาน บางครั้งตัวอย่างใหม่จากกลุ่มที่ขาดหนึ่งพันรายการก็มีค่ามากกว่าภาพซ้ำหนึ่งล้านรายการ
ข้อมูลสะอาดหมายถึงข้อมูลคุณภาพดีหรือไม่
ไม่ใช่ คำว่า “สะอาด” มักหมายถึงรูปแบบสม่ำเสมอและมีค่าผิดพลาดน้อย แต่ยังไม่บอกว่าข้อมูลแทนประชากรได้ดี ใช้ตามสิทธิ์ หรือเหมาะกับการตัดสินใจหรือไม่ ตารางที่ไม่มีค่าว่างอาจยังเต็มไปด้วยป้ายกำกับที่ลำเอียง และขาดเหตุการณ์สำคัญ
Data Drift แปลว่าโมเดลผิดแล้วหรือไม่
ไม่จำเป็น Drift เป็นสัญญาณว่าอินพุตหรือสัดส่วนของข้อมูลเปลี่ยน ต้องตรวจต่อว่าความผิดพลาดและผลกระทบเปลี่ยนไปหรือไม่ Drift บางอย่างไม่มีผลเพราะโมเดลยังรับมือได้ แต่ Drift เล็ก ๆ ที่เกิดในกลุ่มสำคัญก็อาจอันตราย การวัดจึงควรเชื่อมกับ Ground Truth และบริบท
ใช้ข้อมูลสังเคราะห์แก้กลุ่มที่ขาดได้หรือไม่
ช่วยในการทดลองและเพิ่มความหลากหลายได้ แต่ข้อมูลสังเคราะห์อาจสะท้อนสมมติฐานของเครื่องมือ หรือสร้างตัวอย่างที่ไม่ตรงกับโลกจริง ต้องแยกแหล่งข้อมูล บันทึกวิธีสร้าง ตรวจสอบโดยผู้เชี่ยวชาญ และทดสอบกับข้อมูลจริงที่เป็นอิสระ ไม่ควรใช้ข้อมูลสังเคราะห์แทนการรับฟังกลุ่มที่ได้รับผลกระทบ
เก็บทุกอย่างไว้เผื่ออนาคตปลอดภัยกว่าหรือไม่
ไม่เสมอไป ข้อมูลที่มากเกินจำเป็นเพิ่มพื้นที่โจมตี ภาระด้านสิทธิ์ และความเสี่ยงที่จะถูกใช้ผิดวัตถุประสงค์ ควรกำหนด Retention ตามงาน กฎหมาย สัญญา และความจำเป็น พร้อมวิธีลบ สำรอง และพิสูจน์การทำลาย
ใครควรเป็นเจ้าของข้อมูล
ควรแยกบทบาทให้ชัด ผู้รับผิดชอบธุรกิจตัดสินวัตถุประสงค์และผลกระทบ Data Steward ดูแลนิยาม คุณภาพ และ Metadata เจ้าของระบบดู Pipeline กับสิทธิ์ ผู้เชี่ยวชาญโดเมนดูป้ายกำกับและข้อยกเว้น ส่วนฝ่ายกำกับดูการใช้งาน ทุกบทบาทต้องมีชื่อ ช่องทางติดต่อ และอำนาจสั่งหยุดที่ชัดเจน
สรุป: ข้อมูลคือหลักฐานและขอบเขตการมองเห็นของ AI
ข้อมูลทำหน้าที่หลายอย่าง ตั้งแต่สอนโมเดล ช่วยเลือกและทดสอบ ไปจนถึงป้อนงานจริงและติดตามผล แต่ละชุดต้องมีวัตถุประสงค์แยกจากกันและมีการป้องกันการรั่ว คุณภาพต้องวัดตามงาน ประชากร เวลา และความเสียหาย ไม่ใช่ดูจากความสะอาดหรือขนาดเพียงอย่างเดียว
เมื่อมี Datasheet, Provenance, Lineage เจ้าของข้อมูล และวงจรการอัปเดต เราจะรู้ว่าควรเชื่อผลลัพธ์มากน้อยเพียงใด ควรแก้ตรงไหนเมื่อเกิดข้อผิดพลาด และเมื่อไรควรหยุดใช้ข้อมูลที่โลกเปลี่ยนไปไกลกว่าหลักฐานเดิม
Insight Gate: ถ้าคุณตอบได้ว่าข้อมูลชุดหนึ่งมาจากไหน แทนใคร หายใคร ถูกแปลงอย่างไร ใช้เพื่ออะไร และควรเลิกใช้เมื่อไร คุณเข้าใจบทบาทของข้อมูลใน AI แล้ว
เรียนต่ออย่างเป็นระบบ: ทบทวนบทก่อนหน้า และเก็บแบบฝึก Datasheet ไว้ทดลองกับข้อมูลจริงของคุณ
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงหลัก
- ISO/IEC 8183:2023 — AI Data Life Cycle Framework
- NIST AI RMF Playbook — Measure
- Gebru et al. — Datasheets for Datasets
- NIST Research Data Framework
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 2 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 15 · PATH 01 · เนื้อหาเพื่อการศึกษา
