PATH 01 พื้นฐานดิจิทัล คอมพิวเตอร์ และภาพรวม AI · หัวข้อ 28 จาก 50 · เล่ม 1 · ระดับเริ่มต้น
เช้าวันจันทร์ กล่องอีเมลฝ่ายบริการลูกค้ามีข้อความใหม่หลายร้อยฉบับ บางฉบับถามเวลาจัดส่ง บางฉบับขอคืนเงิน และบางฉบับแจ้งว่าบัญชีอาจถูกขโมย ผู้จัดการจึงพูดว่า “เราน่าจะทำระบบอัตโนมัติมาช่วยคัดอีเมล” คนหนึ่งเสนอใช้กฎจากคำสำคัญ อีกคนเสนอใช้ AI และอีกคนอยากให้ระบบส่งอีเมลไปยังทีมปลายทางเองทั้งหมด สามข้อเสนอนี้ดูคล้ายกันเพราะต่างก็ลดงานมือ แต่จริง ๆ ใช้กลไกคนละแบบและสร้างความเสี่ยงคนละชนิด
คำตอบสั้น: ระบบอัตโนมัติแบบกฎทำตามขั้นตอนที่มนุษย์เขียนไว้ ส่วน AI ประมาณคำตอบจากรูปแบบในข้อมูล เมื่อโจทย์มีทั้งส่วนที่แน่นอนและส่วนที่กำกวม งานที่แข็งแรงมักใช้ระบบผสม: กฎตรวจสิ่งที่ห้ามผิด AI ช่วยประมาณในจุดที่เขียนกฎยาก มนุษย์ทบทวนกรณีเสี่ยง และ Automation ลงมือทำเฉพาะสิ่งที่ได้รับอนุญาตแล้ว
ความต่างนี้สำคัญกว่าป้ายว่า “มี AI” หรือ “ไม่มี AI” เพราะมันกำหนดวิธีพิสูจน์ว่าระบบทำงานถูก วิธีเฝ้าระวังหลังเปิดใช้ และคนที่ต้องรับผิดชอบเมื่อเกิดผลเสีย ถ้าเราเรียกทุกอย่างที่ทำงานเองว่า AI เราอาจใช้คะแนน Accuracy ตรวจระบบกฎทั้งที่ควรทดสอบ Expected Output รายกรณี หรือเชื่อว่า AI จะให้ผลเดิมเสมอทั้งที่ข้อมูล รุ่นโมเดล และบริบทเปลี่ยนได้
บทเรียนนี้จะใช้กรณีคัดอีเมลเป็นเส้นเรื่องเดียว เราจะเดินจาก Input ไปยัง Process, Output, การกระทำต่อ, Failure Case, Human Review และ Monitoring แล้วจึงแยกสีแต่ละช่วงว่าเป็นกฎ การประมาณของ AI การตัดสินใจของมนุษย์ หรือการทำงานอัตโนมัติ เป้าหมายไม่ใช่จำศัพท์ แต่คือมอง Workflow หนึ่งเส้นแล้วบอกได้ว่าจุดใดควรแน่นอน จุดใดยอมให้ประมาณ และจุดใดห้ามปล่อยให้เครื่องตัดสินใจลำพัง
อ่านจบบทนี้ คุณจะทำอะไรได้
- แยก Software, Automation แบบกฎ, AI และ Human Decision ออกจากกันด้วยกลไก ไม่ใช่ด้วยชื่อผลิตภัณฑ์
- อธิบาย Input → Process → Output → Action → Feedback ของระบบกฎ ระบบ AI และระบบผสมได้
- เลือกวิธีทดสอบและ Monitoring ให้ตรงกับชนิดของความแน่นอนและความผิดพลาดได้
- ออกแบบ Hybrid Workflow ที่มี Validation, Constraint, Human Review, Rollback และ Audit ได้
- ประเมินด้วยกรอบตัดสินใจว่าจุดใดควรใช้กฎ จุดใดควรใช้ AI และจุดใดต้องให้มนุษย์รับผิดชอบ
ภาพจำหลัก: สูตรอาหารกับผู้ช่วยที่เรียนจากตัวอย่าง
ลองนึกถึงเครื่องชงกาแฟที่ตั้งโปรแกรมไว้ว่า เมื่อผู้ใช้กดปุ่มลาเต้ ให้บดเมล็ด 18 กรัม ปล่อยน้ำร้อนตามเวลาที่กำหนด แล้วเติมนมตามปริมาณเดิม เครื่องไม่ได้มองรสชาติแล้ว “เข้าใจ” ว่าควรทำอย่างไร มันเพียงทำตามลำดับที่เขียนไว้ ถ้าเซนเซอร์และวัตถุดิบอยู่ในเงื่อนไขเดิม ผลก็มักเหมือนเดิม นี่คือภาพจำของ Automation แบบกฎ: เส้นทางถูกกำหนดไว้ก่อนและระบบวิ่งตามเส้นทางนั้น
ส่วน AI คล้ายผู้ช่วยที่เคยเห็นตัวอย่างเครื่องดื่มจำนวนมาก แล้วพยายามจำแนกจากภาพว่าแก้วไหนเป็นลาเต้ คาปูชิโน หรืออเมริกาโน ผู้ช่วยไม่ได้รับกฎที่เขียนครบทุกรูปทรงของแก้ว ทุกมุมกล้อง และทุกสภาพแสง แต่เรียนรู้ความสัมพันธ์จากตัวอย่าง เมื่อเจอภาพใหม่จึงคืนคำตอบที่มีระดับความมั่นใจ คำตอบนี้เป็นการประมาณจากรูปแบบ ไม่ใช่การเดินตามสูตรที่เรามองเห็นทุกข้อ
อุปมานี้ช่วยเปิดประตู แต่มีขอบเขต เครื่องชงกาแฟจริงอาจมีเซนเซอร์และวงจรควบคุมซับซ้อน ขณะที่ AI ก็ยังมีซอฟต์แวร์และกฎจำนวนมากอยู่รอบโมเดล สิ่งสำคัญจึงไม่ใช่ถามว่า “ระบบนี้เป็น AI ทั้งก้อนหรือไม่” แต่ถามว่า “ขั้นไหนสร้างผลจากกฎที่ระบุไว้ และขั้นไหนสร้างผลจากการประมาณตามรูปแบบข้อมูล” ระบบหนึ่งระบบอาจมีคำตอบทั้งสองแบบอยู่พร้อมกัน
ในกรณีอีเมล กฎว่า “ถ้าลูกค้ากดเมนูแจ้งบัญชีถูกขโมย ให้ส่งทีมความปลอดภัยทันที” เป็นเส้นทางที่ตั้งใจให้แน่นอน ส่วนการอ่านภาษาอิสระ เช่น “เมื่อเช้ามีคนเข้าใช้บัญชีจากอีกจังหวัด” แล้วเดาว่าเป็นเหตุการณ์ความปลอดภัย อาจใช้ AI เพราะถ้อยคำมีได้หลายรูปแบบ จุดเปลี่ยนจากคะแนนของ AI ไปสู่การส่งคิวจึงต้องมีกฎ Threshold, กรณีที่ห้ามอัตโนมัติ และช่องทางให้คนแก้ไข
ประโยคที่ควรจำ: Automation ตอบว่า “เมื่อเงื่อนไขนี้เกิด ให้ทำอะไร” ส่วน AI ตอบว่า “จากรูปแบบที่เคยเห็น สิ่งนี้น่าจะเป็นอะไร”
แยกสี่บทบาทก่อนเลือกเทคโนโลยี
คำว่า Software, Automation และ AI มักถูกใช้ปนกัน เพราะทั้งหมดทำงานบนคอมพิวเตอร์และอาจลดงานมือได้ แต่การแยกบทบาททำให้เราตั้งคำถามได้แม่นกว่า Software คือโครงสร้างคำสั่งและข้อมูลที่ทำให้ระบบทำงาน Automation คือการให้ระบบเริ่มหรือดำเนินขั้นตอนโดยไม่ต้องรอคนทำซ้ำทุกครั้ง AI คือส่วนที่ประมาณ จำแนก พยากรณ์ หรือสร้างผลจากรูปแบบ และ Human Decision คือจุดที่มนุษย์ใช้บริบท คุณค่า ความรับผิดชอบ หรือสิทธิในการเปลี่ยนผล
Software ไม่จำเป็นต้องเป็น Automation โปรแกรมคำนวณที่รอผู้ใช้กรอกข้อมูลและกดปุ่มเป็นซอฟต์แวร์ แต่ยังไม่ได้เริ่มงานเอง Automation ก็ไม่จำเป็นต้องมี AI การส่งใบเสร็จทันทีหลังสถานะชำระเงินเปลี่ยนเป็น “สำเร็จ” ทำงานอัตโนมัติด้วย Event และกฎที่ชัดเจน ไม่มีโมเดลเรียนรู้จากข้อมูลอยู่ในจุดตัดสินใจนั้น
AI เองอาจไม่ทำงานอัตโนมัติ โมเดลที่แนะนำหมวดอีเมลให้เจ้าหน้าที่อ่านแล้วกดเลือกยังเป็น AI เพราะผลมาจากการประมาณ แต่ยังไม่ใช่ Automation ของการส่งคิว หากระบบนำหมวดที่โมเดลทำนายไปส่งต่อทันทีโดยไม่มีคนกด จึงเกิด Automation รอบ Output ของ AI การแยกเช่นนี้ทำให้เราเห็นว่าความเสี่ยงไม่ได้มาจากโมเดลอย่างเดียว แต่มาจากสิทธิ์ที่ระบบได้รับหลังโมเดลตอบด้วย
Human Decision ไม่ได้หมายความว่าคนต้องตรวจทุกเคส บทบาทคนอาจอยู่ที่ออกแบบกฎ ตั้ง Threshold นิยามกรณีเสี่ยง ตรวจตัวอย่างแบบสุ่ม ทบทวน Appeal อนุมัติการเปลี่ยนเวอร์ชัน หรือสั่งหยุดระบบเมื่อ Guardrail แย่ลง จุดสำคัญคือคนต้องมีข้อมูลและอำนาจพอจะเปลี่ยนผล ไม่ใช่ถูกวางไว้ท้ายกระบวนการเพื่อรับผิดชอบแทนระบบที่ตนควบคุมไม่ได้
| บทบาท | คำถามที่ตอบ | ตัวอย่างในระบบอีเมล | สิ่งที่ต้องตรวจ |
|---|---|---|---|
| Software | ข้อมูลและคำสั่งถูกจัดการอย่างไร | หน้ารับข้อความ ฐานข้อมูล Ticket และ API | ความถูกต้อง ความปลอดภัย Integration และสิทธิ์ |
| Rule-based Automation | เมื่อเงื่อนไขเกิด ระบบต้องทำอะไร | ส่งเคสที่เลือก “บัญชีถูกขโมย” ไปคิวเร่งด่วน | Expected Output, Edge Case, Timeout และ Recovery |
| AI | จากรูปแบบในข้อมูล สิ่งนี้น่าจะเป็นอะไร | อ่านภาษาอิสระแล้วประมาณหมวดและความมั่นใจ | Metric, ชุดทดสอบ, กลุ่มย่อย, Drift และความไม่แน่นอน |
| Human Decision | เมื่อใดควรยืนยัน แก้ หยุด หรือรับผิดชอบ | ตรวจเคสเสี่ยง แก้หมวด และอนุมัติการเปลี่ยนรุ่น | ข้อมูลที่คนเห็น อำนาจเปลี่ยนผล SLA และภาระงาน |
กลไก Automation แบบกฎ: ความแน่นอนเกิดจากเส้นทางที่เขียนไว้
Automation แบบกฎเริ่มจาก Trigger หรือเหตุการณ์ เช่น อีเมลใหม่เข้าระบบ จากนั้นอ่าน Input ที่กำหนด เช่น ช่องประเภทปัญหา สถานะสมาชิก หรือเวลาที่ส่ง แล้วประเมินเงื่อนไข If–Then หากเข้าเงื่อนไขก็เรียก Action เช่น สร้าง Ticket ส่งคิว เปลี่ยนสถานะ หรือแจ้งเตือน เมื่อ Input และสถานะระบบเหมือนเดิม เส้นทางที่ถูกเลือกควรเหมือนเดิมด้วย คุณสมบัตินี้เรียกว่า Deterministic ในขอบเขตของ Logic ที่กำหนด
คำว่าแน่นอนไม่ได้แปลว่าไม่มีวันผิด กฎอาจผิดเพราะ Requirement ไม่ครบ เขียนเงื่อนไขกลับด้าน ใช้หน่วยผิด หรือไม่คิดถึงกรณีขอบ Integration อาจล้ม API อาจตอบช้า ข้อมูลอาจว่างหรือผิดรูปแบบ และระบบหลายตัวอาจเปลี่ยนสถานะพร้อมกันจนเกิด Race Condition ความผิดพลาดของ Automation จึงมักสืบย้อนผ่านเส้นทาง Logic, Log และสถานะได้ แม้การหาสาเหตุจะยากในระบบใหญ่ก็ตาม
จุดแข็งของกฎคือความชัด เมื่อข้อกำหนดนิ่งและครอบคลุม เราสามารถเขียน Test Case ว่า Input ชุดนี้ต้องได้ Output ใดได้โดยตรง เช่น ถ้าช่องประเภทเท่ากับ “บัญชีถูกขโมย” ต้องได้ Priority สูงสุดและห้ามส่งคิวทั่วไป ถ้าระบบทำอย่างอื่นถือว่าผิด ไม่ต้องถกเถียงเรื่อง Accuracy เฉลี่ย เพราะความคาดหวังของแต่ละกรณีระบุไว้แล้ว
กฎเหมาะกับข้อบังคับที่ห้ามต่อรอง เช่น ตรวจรูปแบบเลขคำสั่งซื้อ ตรวจสิทธิ์ผู้ใช้ บังคับให้มีข้อมูลที่จำเป็น จำกัดยอดเงิน ปิดกั้น Action ต้องห้าม หรือกำหนดว่าคิวความปลอดภัยต้องมีคนรับภายในเวลาหนึ่ง จุดเหล่านี้ต้องการความสม่ำเสมอและ Audit ได้ การใช้ AI มาประมาณสิ่งที่เขียนเป็นกฎได้ชัดอาจเพิ่มความไม่แน่นอนโดยไม่สร้างคุณค่าเพิ่ม
ข้อจำกัดของกฎปรากฏเมื่อโลกมีความหลากหลายสูง ถ้าต้องอ่านภาษาอิสระ ผู้ใช้สามารถใช้คำต่างกันมากเพื่อบอกความหมายเดียวกัน กฎคำสำคัญ “ขโมย” อาจพลาดประโยค “มีคนเข้าใช้บัญชีโดยไม่ได้รับอนุญาต” และอาจจับประโยค “ฉันไม่ได้ถูกขโมยบัญชี แค่ลืมรหัส” ผิดเป็นเคสเร่งด่วน ยิ่งเพิ่มกฎเพื่อปิดรูใหม่ กฎอาจชนกัน ดูแลยาก และสร้างพฤติกรรมที่ไม่มีใครกล้าแก้
ดังนั้นคำถามไม่ใช่ “เขียนกฎได้ไหม” เพราะเกือบทุกอย่างเขียนกฎหยาบ ๆ ได้ แต่คือ “กฎนั้นชัด ครอบคลุม ดูแลได้ และให้คุณภาพพอหรือไม่” หากกฎง่ายชนะ Baseline ได้แล้ว การเพิ่ม AI ต้องพิสูจน์ว่าคุณค่าที่เพิ่มคุ้มกับต้นทุนข้อมูล การประเมิน Monitoring ความเสี่ยง และการดูแลรุ่นโมเดล
กลไก AI: ผลลัพธ์เป็นการประมาณจากรูปแบบ
AI สำหรับจัดหมวดอีเมลรับข้อความหรือคุณลักษณะของข้อความเป็น Input แล้วแปลงสิ่งเหล่านั้นเป็นตัวแทนที่โมเดลใช้คำนวณ จากนั้นโมเดลคืนคะแนนของแต่ละหมวด เช่น ทั่วไป 0.08 การเงิน 0.20 การจัดส่ง 0.12 และความปลอดภัย 0.60 ตัวเลขเหล่านี้ไม่ใช่คำรับรองว่าความปลอดภัยถูกต้อง 60 เปอร์เซ็นต์ในทุกบริบท แต่เป็น Output ของโมเดลที่ต้องผ่านการประเมิน Calibration และเงื่อนไขการใช้งานก่อนตีความ
โมเดลเรียนจากตัวอย่างในอดีต หากข้อมูลอดีตสะท้อน Workflow ที่ดี โมเดลอาจจับรูปแบบที่ช่วยงานได้ แต่ถ้าป้ายหมวดในอดีตไม่สม่ำเสมอ ทีมแต่ละกะใช้มาตรฐานต่างกัน หรือเคสหายากถูกปิดผิดคิว โมเดลก็เรียนความไม่สม่ำเสมอนั้นด้วย AI ไม่สามารถแยก “รูปแบบที่เกิดขึ้น” ออกจาก “รูปแบบที่ควรเกิดขึ้น” ได้เองโดยอัตโนมัติ ผู้เชี่ยวชาญงานและผู้ได้รับผลกระทบจึงต้องช่วยนิยาม Label และทบทวนตัวอย่าง
ผลของ AI อาจเปลี่ยนเมื่อข้อมูลเปลี่ยน คำที่ลูกค้าใช้เปลี่ยน สินค้าใหม่เปิดตัว นโยบายคืนเงินเปลี่ยน คู่โจมตีเปลี่ยนวิธีเขียน หรือทีมอัปเดตโมเดลและ Prompt แม้ Code รอบระบบไม่เปลี่ยน คุณภาพก็อาจเสื่อมได้ ปรากฏการณ์ที่ความสัมพันธ์ในข้อมูลการใช้งานต่างจากช่วงพัฒนาเรียกอย่างกว้าง ๆ ว่า Drift การ Monitoring จึงต้องดูทั้งสุขภาพระบบและสัญญาณคุณภาพของข้อมูลกับผลลัพธ์
AI มีประโยชน์เมื่อเขียนกฎครบได้ยาก แต่มีตัวอย่างที่เกี่ยวข้อง มีผลจริงให้ตรวจ และความผิดพลาดถูกควบคุมได้ เช่น แนะนำหมวดให้เจ้าหน้าที่ เลือกเคสให้ตรวจเพิ่มเติม หรือเรียงลำดับคิวโดยไม่ตัดสิทธิ์ลูกค้าโดยตรง หาก Output นำไปสู่การปฏิเสธบริการ การลงโทษ ความเสียหายทางการเงิน หรือความเสี่ยงด้านความปลอดภัย เกณฑ์การตรวจ คนรับผิดชอบ และช่องทางอุทธรณ์ต้องเข้มขึ้น
Generative AI เพิ่มความไม่แน่นอนอีกชั้น เพราะ Output เป็นข้อความใหม่ ไม่ใช่เพียงหมวดที่มีชุดคำตอบจำกัด การตรวจจึงต้องดูความถูกต้อง การยึดข้อมูลอ้างอิง ความครบถ้วน รูปแบบ ภาษาอ่อนไหว และการเปิดเผยข้อมูล หากใช้ให้ร่างคำตอบลูกค้า ควรแยกการ “ร่าง” ออกจากการ “ส่ง” ชัดเจน กฎและคนต้องตรวจข้อมูลส่วนตัว ข้อผูกพัน และข้อความที่มีผลทางกฎหมายก่อน Action
อีกจุดที่มักมองข้ามคือ AI ก็อยู่ใน Software System ที่มี API, Database, Queue, Permission และ UI ผลเสียอาจเกิดแม้โมเดลทำนายถูก เช่น ระบบจับคู่ Ticket ผิดบัญชี ส่งผลไปปลายทางผิด หรือ UI แสดงคะแนนโดยไม่มีคำอธิบายจนคนกดตามอย่างอัตโนมัติ การประเมินโมเดลจึงจำเป็นแต่ไม่พอ ต้องทดสอบ Workflow ปลายทางทั้งหมด
เปรียบเทียบด้วยเกณฑ์เดียวกัน ไม่ตัดสินจากความทันสมัย
| มิติ | Automation แบบกฎ | AI/ML | ผลต่อการออกแบบ |
|---|---|---|---|
| แหล่งของ Logic | เงื่อนไขและขั้นตอนที่มนุษย์ระบุ | พารามิเตอร์หรือรูปแบบที่เรียนจากข้อมูล | กฎต้องทบทวน Requirement; AI ต้องทบทวนข้อมูลและการประเมิน |
| Input เดิม | ควรเลือกเส้นทางเดิมเมื่อสถานะอื่นเท่ากัน | อาจต่างตามรุ่น การสุ่ม Prompt หรือบริบท | AI ต้องควบคุม Version และเงื่อนไขการทำซ้ำ |
| กรณีกำกวม | ต้องเพิ่มกฎหรือส่งให้คน | คืนคะแนนหรือคำตอบประมาณ | ต้องกำหนด Threshold และเส้นทางความไม่แน่ใจ |
| หลักฐานการทดสอบ | Expected Output รายกรณี | Metric บนชุดทดสอบ กลุ่มย่อย และการตรวจโดยคน | ระบบผสมต้องใช้ทั้งสองแบบและทดสอบปลายทาง |
| ความเสื่อม | มักเกิดจาก Logic, Config, Dependency หรือข้อมูลผิดรูปแบบ | เพิ่ม Data Drift, Concept Drift และคุณภาพตามรุ่น | Monitoring ต้องดูสัญญาณต่างกัน |
| การอธิบาย | ไล่กฎและสถานะได้โดยตรงมากกว่า | อธิบายเป็นปัจจัย ตัวอย่าง คะแนน และข้อจำกัด | ระดับคำอธิบายต้องเหมาะกับผลกระทบ |
| ต้นทุนระยะยาว | ดูแลกฎ การทดสอบ Integration และ Exception | เพิ่มข้อมูล การประเมิน Model Registry และ Monitoring | AI ต้องชนะ Baseline มากพอคุ้มต้นทุนเพิ่ม |
| การย้อนกลับ | ย้อน Config หรือ Code รุ่นเดิม | ย้อน Model/Prompt/Data Version และกฎรอบระบบ | ต้องบันทึก Version ครบทั้ง Pipeline |
ตารางนี้ไม่ได้บอกว่าแบบใดดีกว่าเสมอ ระบบกฎอาจแย่มากหาก Requirement เปลี่ยนทุกวัน และ AI อาจเหมาะกว่าหากมีข้อมูลคุณภาพสูงกับความหลากหลายที่กฎดูแลไม่ไหว ในทางกลับกัน AI ที่แม่นเฉลี่ยสูงอาจไม่เหมาะหากความผิดพลาดหนึ่งครั้งสร้างความเสียหายที่ย้อนกลับไม่ได้หรือไม่มีคนตรวจทันเวลา
ให้เปรียบเทียบทางเลือกด้วย Outcome เดียวกัน เช่น เวลาที่อีเมลไปถึงทีมแรก ความถูกต้องของคิวเคสเร่งด่วน ภาระงานแก้หมวด และจำนวน Incident อย่าเปรียบเทียบกฎด้วยเวลาเฉลี่ย แต่เปรียบเทียบ AI ด้วย Accuracy อย่างเดียว เพราะ Metric คนละชนิดตอบคนละคำถาม ทางเลือกที่ชนะควรทำให้ผลในโลกจริงดีขึ้นภายใต้ Guardrail เดียวกัน
กรณีหลัก: คัดอีเมลโดยไม่ปล่อยให้คะแนน AI กลายเป็นคำสั่งทันที
บริบท: ฝ่ายบริการลูกค้ารับข้อความจากอีเมลและแบบฟอร์ม ทีมต้องจัดแต่ละข้อความเข้า 8 คิว ได้แก่ บัญชี การชำระเงิน การจัดส่ง คืนสินค้า ข้อมูลผลิตภัณฑ์ ความปลอดภัย ข้อร้องเรียน และเรื่องทั่วไป ปัญหาเดิมคือคิวแรกผิดบ่อยในข้อความที่ใช้ภาษากำกวม ทำให้ลูกค้ารอนานและเจ้าหน้าที่ต้องส่งต่อหลายครั้ง
ผู้ใช้และการตัดสินใจ: ผู้ใช้หลักของระบบคือเจ้าหน้าที่คัดคิวและหัวหน้ากะ การตัดสินใจไม่ใช่ “ตอบลูกค้าอย่างไร” แต่คือ “ข้อความนี้ควรไปทีมใดก่อน และต้องเร่งด่วนเพียงใด” การจำกัด Scope เช่นนี้ทำให้ Output มีขอบเขต ตรวจผลจริงได้ และย้อนกลับได้ง่ายกว่าการให้ AI ร่างและส่งคำตอบทั้งหมดในครั้งเดียว
Input: ระบบใช้หัวเรื่อง เนื้อหา ภาษาที่ตรวจได้ ช่องทาง ประเภทที่ลูกค้าเลือก และสถานะบัญชีเท่าที่มีสิทธิ์ใช้ในเวลารับข้อความ ไม่ใช้ทีมที่ปิดเคสหรือเวลาปิดเคสเป็น Input เพราะข้อมูลเหล่านั้นเกิดหลังการตัดสินใจและจะทำให้เกิด Leakage ต้องบันทึกว่าฟิลด์ใดเข้าระบบ ใครเข้าถึงได้ และเก็บนานเท่าไร
Baseline: ก่อนใช้ AI ทีมต้องวัดวิธีเดิม เช่น กฎจากช่องประเภทปัญหาร่วมกับการคัดโดยคน วัดเวลาถึงทีมแรก อัตราส่งต่อซ้ำ อัตราเคสเร่งด่วนตกคิว และเวลาที่เจ้าหน้าที่ใช้ต่อเคส หากไม่มี Baseline เราจะรู้เพียงว่าโมเดลได้คะแนนหนึ่ง แต่ไม่รู้ว่าช่วยงานจริงหรือคุ้มต้นทุนหรือไม่
Process: เมื่อข้อความเข้ามา กฎตรวจรูปแบบ ไฟล์แนบ สิทธิ์ และสัญญาณที่ต้องส่งตรง เช่น ผู้ใช้เลือก “บัญชีถูกขโมย” จากแบบฟอร์มที่ยืนยันแล้ว ข้อความที่ไม่เข้ากฎตรงจึงส่งเข้าโมเดลเพื่อประมาณหมวดและความมั่นใจ โมเดลไม่ได้รับอนุญาตให้ส่งคิวเองทุกกรณี Output ต้องผ่าน Constraint และ Policy อีกชั้น
Output: โมเดลคืนหมวดที่แนะนำ คะแนนของแต่ละหมวด และเหตุผลที่ UI แสดงได้อย่างเหมาะสม เช่น คำสำคัญหรือประโยคที่เกี่ยวข้อง ข้อมูลนี้ช่วยคนตรวจ แต่ไม่ควรทำให้คนเข้าใจว่าคะแนนคือความจริงแน่นอน UI ต้องบอกเมื่อความมั่นใจต่ำ เมื่อข้อความมีหลายประเด็น และเมื่อข้อมูลไม่ครบ
Action: หากคะแนนสูงและหมวดมีความเสี่ยงต่ำ ระบบอาจส่งคิวอัตโนมัติ หากคะแนนต่ำหรือสองหมวดใกล้กัน ให้เสนอแก่เจ้าหน้าที่ หากเกี่ยวกับความปลอดภัย การชำระเงินผิดปกติ หรือข้อร้องเรียนร้ายแรง ให้มนุษย์ตรวจไม่ว่าคะแนนสูงเท่าไร กฎนี้แยกการประมาณออกจากสิทธิ์ในการกระทำ
ผลจริงและ Feedback: เมื่อทีมปลายทางรับเคส เจ้าหน้าที่สามารถยืนยันหรือแก้หมวดและระบุเหตุผลสั้น ๆ ผลนี้ใช้ตรวจคุณภาพและหากผ่านการกลั่นกรองจึงอาจเป็นข้อมูลสำหรับปรับโมเดล ไม่ควรนำทุกการคลิกกลับไปฝึกทันที เพราะคนอาจกดตามคำแนะนำเพื่อประหยัดเวลา หรือแก้หมวดตามภาระงานแทนความหมายจริง
Failure Mode: โมเดลอาจพลาดข้อความใหม่ แยกเรื่องที่มีสองปัญหาไม่ได้ หรือแม่นในภาษาไทยมาตรฐานแต่พลาดภาษาถิ่นและการสะกดผิด ระบบรอบโมเดลอาจจับ Ticket ผิดลูกค้า Queue อาจค้าง หรือกฎ Threshold อาจส่งเคสจำนวนมากไปคิวเดียว แม้โมเดลไม่เปลี่ยน คุณภาพธุรกิจก็แย่ลงได้
Human Role: เจ้าของกระบวนการนิยามหมวดและ Guardrail ทีมข้อมูลตรวจชุดทดสอบ วิศวกรดู Version และ Reliability หัวหน้ากะดู Incident กับภาระงาน เจ้าหน้าที่แก้ผลและลูกค้ามีช่องทางติดตามหรืออุทธรณ์เมื่อได้รับผลกระทบ ทุกบทบาทต้องมีอำนาจและเวลาพอ ไม่ใช่ใส่คำว่า Human-in-the-loop ในแผนผังแล้วจบ
เงื่อนไขที่ทำให้ข้อสรุปเปลี่ยน: หากแบบฟอร์มสามารถบังคับให้ลูกค้าเลือกหมวดได้ถูกเกือบทั้งหมด การปรับ UX และกฎอาจคุ้มกว่า AI หากข้อความมีภาษาอิสระจำนวนมากและกฎพลาดบ่อย AI อาจเพิ่มคุณค่า หากไม่มี Label ที่เชื่อถือได้หรือผลเสียสูงเกินกว่าจะทดลอง ระบบควรเริ่มจาก Decision Support และ Shadow Mode แทน Automation เต็มรูปแบบ
ระบบผสมหกขั้น: ให้ AI อยู่ตรงจุดที่ต้องประมาณ
Validate — ตรวจสิ่งที่รู้แน่นอน
ตรวจรูปแบบข้อมูล ไฟล์แนบ สิทธิ์ ช่องที่จำเป็น สัญญาณต้องห้าม และเงื่อนไขที่ส่งตรงได้ กฎชั้นนี้ป้องกันขยะและความเสี่ยงไม่ให้เข้าโมเดลโดยไม่จำเป็น พร้อมบันทึกเหตุผลเมื่อปฏิเสธหรือส่งเส้นทางพิเศษ
Estimate — ให้ AI ประมาณ
ใช้โมเดลอ่านภาษาอิสระแล้วคืนหมวด คะแนน และสัญญาณความไม่แน่ใจ จุดนี้ทำหน้าที่แคบ ไม่อนุมัติการกระทำและไม่ซ่อนความไม่แน่นอน การเปลี่ยนโมเดลต้องมี Version และชุดทดสอบเดิมเพื่อเทียบอย่างยุติธรรม
Constrain — จำกัดสิทธิ์ของ Output
กฎหลังโมเดลแปลงคะแนนเป็นเส้นทาง เช่น คะแนนต่ำให้คนตรวจ หมวดเสี่ยงห้ามอัตโนมัติ จำนวนเคสต่อคิวมีเพดาน และ Action ที่ย้อนกลับไม่ได้ต้องขออนุมัติ Constraint คือรั้วระหว่างคำแนะนำกับผลกระทบ
Review — ให้คนเปลี่ยนผลได้
เจ้าหน้าที่เห็นข้อความ คำแนะนำ ความมั่นใจ และบริบทที่จำเป็น แล้วสามารถยืนยัน แก้ ส่งต่อ หรือหยุดได้ ต้องวัดเวลาตรวจและอัตราที่คนแก้คำแนะนำเพื่อให้ Human Review เป็นงานจริง ไม่ใช่พิธีกรรมที่คนกดตามระบบ
Execute — ทำงานที่อนุมัติแล้ว
Automation สร้าง Ticket ส่งคิว ตั้ง SLA แจ้งเตือน และบันทึกสถานะตามผลที่ผ่านกฎหรือคนแล้ว ชั้นนี้ควร Idempotent เท่าที่ทำได้ เพื่อไม่ส่งซ้ำเมื่อระบบ Retry และมี Recovery เมื่อ Integration ล้ม
Audit — เรียนจากผลจริง
บันทึก Input Version, Model Version, กฎ, Output, ผู้แก้, Action, Incident และผลปลายทาง แล้วติดตาม Metric ของโมเดล Workflow และ Outcome หาก Guardrail เกินเกณฑ์ให้หยุดหรือลด Automation ก่อนวิเคราะห์สาเหตุ
ลำดับนี้ไม่ใช่สูตรตายตัว แต่ช่วยให้เห็นเส้นแบ่งความรับผิดชอบชัด AI อยู่ในขั้น Estimate เพราะตรงนั้นต้องรับมือกับรูปแบบที่กฎเขียนยาก กฎอยู่ก่อนและหลังเพื่อจัดการสิ่งที่ระบุได้ มนุษย์อยู่ในจุดที่ต้องใช้บริบทหรือรับผลกระทบ และ Automation อยู่ในขั้น Execute เพื่อทำสิ่งที่ผ่านการควบคุมแล้วอย่างสม่ำเสมอ
บางงานอาจไม่มี AI เลย หากกฎและแบบฟอร์มแก้โจทย์ได้ บางงานอาจมี AI แต่ไม่มี Automation เช่น โมเดลเสนอหมวดให้คนเลือก และบางงานอาจอัตโนมัติสูงเมื่อผลเสียต่ำ คุณภาพคงที่ และ Rollback เร็ว ระดับ Automation จึงควรเป็นผลจากหลักฐานและความเสี่ยง ไม่ใช่เป้าหมายทางการตลาด
Failure Case: คะแนนดีแต่ระบบยังทำร้ายงานได้อย่างไร
1. กฎคำสำคัญดูแม่นเพราะข้อมูลทดสอบง่ายเกินไป
ทีมสร้างชุดทดสอบจากข้อความที่มีชื่อหมวดตรง ๆ กฎจึงดูแม่นมาก แต่ข้อความจริงใช้สำนวน การปฏิเสธ และหลายประเด็น เมื่อเปิดใช้ อัตราส่งผิดคิวเพิ่มขึ้น กลไกของภาพลวงตาคือชุดทดสอบไม่แทนความหลากหลายจริง วิธีตรวจคือเก็บตัวอย่างตามช่วงเวลา ภาษา ช่องทาง และความยาก พร้อมแยกเคสที่กฎกับคนไม่เห็นตรงกัน
2. โมเดลแม่นเฉลี่ยสูงแต่พลาดหมวดที่ต้นทุนสูง
เคสทั่วไปมีจำนวนมาก โมเดลตอบถูกเกือบทั้งหมดจึงดัน Accuracy รวมสูง แต่เคสความปลอดภัยมีน้อยและพลาดบ่อย การดูค่าเฉลี่ยอย่างเดียวซ่อนความเสียหาย วิธีตรวจคือตั้ง Metric แยกกลุ่ม เช่น Recall ของเคสความปลอดภัย อัตราเร่งด่วนตกคิว และเวลาถึงคนรับผิดชอบ พร้อมให้ Guardrail สำคัญกว่าคะแนนรวม
3. คนตรวจทุกเคสแต่ไม่ช่วยลดความเสี่ยง
UI ทำให้คำแนะนำของ AI เด่นมาก ไม่มีเหตุผลหรือปุ่มแก้ง่าย เจ้าหน้าที่ต้องรีบทำ SLA จึงกดยืนยันตามระบบเกือบทั้งหมด แม้มีคำว่า Human Review คนก็ไม่ได้ใช้วิจารณญาณจริง กลไกคือ Automation Bias และการออกแบบงานที่ไม่ให้เวลา วิธีตรวจคือดูอัตราแก้ผล เวลาตรวจ คุณภาพเมื่อซ่อนคำแนะนำบางส่วน และสัมภาษณ์ความเข้าใจของผู้ใช้
4. Feedback Loop ทำให้ความผิดเดิมยิ่งแข็งแรง
ระบบนำหมวดที่โมเดลแนะนำและคนไม่ได้แก้กลับไปฝึกเป็น Label ใหม่ หากคนกดตามโมเดลเพราะรีบ ข้อมูลรอบถัดไปจะยืนยันคำตอบเดิมแม้มันผิด กลไกคือการใช้พฤติกรรมที่ได้รับอิทธิพลจากโมเดลเป็น Ground Truth วิธีลดคือแยก Label ที่ผ่านการตรวจ ใช้ตัวอย่าง Audit แบบอิสระ และบันทึกที่มาของ Feedback
5. โมเดลไม่เปลี่ยนแต่ Workflow เปลี่ยน
องค์กรรวมสองทีมและเปลี่ยนความหมายของหมวด “บัญชี” แต่ Label, กฎ และ Dashboard ยังใช้แบบเดิม โมเดลอาจทำนายตามนิยามเก่าอย่างสม่ำเสมอ คะแนนจากชุดทดสอบเก่ายังดี แต่ผลธุรกิจแย่ลง กลไกคือ Concept Drift และความไม่สอดคล้องของกระบวนการ วิธีตรวจคือทบทวนนิยามหมวดเมื่อ Policy เปลี่ยนและผูกการเปลี่ยนกระบวนการกับการประเมินใหม่
6. โมเดลถูกแต่ Action ผิด
AI ทำนาย “คืนสินค้า” ถูกต้อง แต่ Integration ใช้รหัสคิวเก่าจึงส่งไปทีมการเงิน หรือระบบ Retry สร้าง Ticket ซ้ำสองใบ ถ้าดูเฉพาะ Model Accuracy จะไม่เห็นปัญหา กลไกคือความผิดพลาดหลังโมเดล วิธีตรวจคือ End-to-end Test ที่ตามข้อมูลตั้งแต่รับข้อความจนถึงคิวปลายทาง รวม Log, Idempotency และ Recovery
มุมที่มักมองข้าม
ความผิดพลาดของระบบ AI ไม่ได้มีแค่ “โมเดลตอบผิด” แต่รวมถึง Input ไม่ครบ การตีความคะแนนผิด กฎหลังโมเดลไม่เหมาะ คนไม่มีอำนาจแก้ Integration พัง และไม่มีใครสังเกตว่าผลลัพธ์เสื่อม การออกแบบจึงต้องตามเส้นทางความเสียหายครบทั้งระบบ
การทดสอบต้องตรงกับธรรมชาติของกลไก
ระบบกฎใช้ Unit Test เพื่อยืนยันเงื่อนไขย่อย ใช้ Integration Test เพื่อดูว่าบริการคุยกันถูก และใช้ Scenario Test เพื่อเดินเหตุการณ์ครบเส้น Test ควรมีทั้งกรณีปกติ กรณีขอบ Input ว่าง ข้อมูลผิดรูปแบบ Timeout การ Retry และ Dependency ล้ม คำตอบของแต่ละกรณีระบุได้ว่าต้องเกิดอะไรจึงผ่าน
AI ต้องใช้ชุดข้อมูลที่แยกจากการฝึกและแทนบริบทใช้งาน วัด Metric ให้ตรงต้นทุน เช่น Precision เมื่อต้องลดการแจ้งเกิน Recall เมื่อต้องจับเคสสำคัญ หรือ Calibration เมื่อนำคะแนนไปตั้ง Threshold ต้องดู Confusion Matrix กลุ่มย่อย ภาษาที่ต่างกัน เคสหายาก ความทนต่อการสะกดผิด และตัวอย่างที่มนุษย์ยังเห็นไม่ตรงกัน
ระบบผสมต้องรวมสองโลกเข้าด้วยกัน เริ่มจากทดสอบโมเดล Offline แต่ห้ามหยุดตรงนั้น จากนั้นทดสอบ Policy ว่าคะแนนแต่ละช่วงเลือก Action ถูก ทดสอบ UI และ Human Review ทดสอบ Queue/Integration และรัน Shadow Mode บนข้อมูลจริงโดยยังไม่เปลี่ยนงาน เมื่อหลักฐานดีจึงเปิด Decision Support หรือ Automation ในขอบเขตเล็กพร้อม Stop Rule
| ระดับการทดสอบ | คำถาม | หลักฐาน | ตัวอย่างเกณฑ์ |
|---|---|---|---|
| Logic | กฎเลือกเส้นทางถูกทุกกรณีที่ระบุหรือไม่ | Unit/Scenario Test และ Expected Output | เคสความปลอดภัยจากช่องยืนยันต้องไม่เข้าคิวทั่วไป |
| Model | AI ประมาณได้ดีพอในข้อมูลที่แทนการใช้จริงหรือไม่ | Test Set, Metric, Slice, Error Analysis | Recall หมวดเสี่ยงผ่านเกณฑ์และกลุ่มภาษาหลักไม่ต่างเกินขอบเขต |
| Policy | คะแนนถูกแปลงเป็น Action อย่างปลอดภัยหรือไม่ | Threshold Test และ Simulation | คะแนนต่ำหรือหมวดเสี่ยงต้องส่งให้คนตรวจ |
| Human | คนเข้าใจและเปลี่ยนผลได้จริงหรือไม่ | Usability Test, เวลาตรวจ, อัตราแก้ | ผู้ใช้ระบุเหตุผลและกู้ Workflow ได้โดยไม่พึ่งทีมพัฒนา |
| End-to-end | ผลถึงปลายทางถูกและย้อนกลับได้หรือไม่ | Shadow/Canary, Incident Drill, Rollback Test | ไม่สร้าง Ticket ซ้ำและกลับสู่วิธีเดิมภายในเวลาที่กำหนด |
การได้คะแนนเต็มใน Demo ไม่ใช่หลักฐานว่าพร้อม Production เพราะ Demo มักเลือกตัวอย่างที่รู้คำตอบและไม่เจอความผิดพลาดของระบบจริง หลักฐานที่ดีควรบอกทั้งสิ่งที่ผ่าน สิ่งที่ยังไม่ทดสอบ เงื่อนไขที่ทำให้ข้อสรุปเปลี่ยน และความเชื่อมั่นของทีม อย่าเปลี่ยนข้อสังเกตจากตัวอย่างไม่กี่เคสให้เป็นคำรับรองทั่วไป
Monitoring คนละสัญญาณ แต่ต้องกลับมาที่ผลจริงเดียวกัน
Automation แบบกฎต้องเฝ้าดู Error Rate, Latency, Queue Depth, Timeout, Retry, Dependency และจำนวนกรณีที่ตกลงเส้นทาง Default หากกฎทำงานตามที่เขียนแต่ Default เพิ่มขึ้นมาก อาจแปลว่า Input ใหม่ไม่เข้าเงื่อนไขเดิม การดูเพียงว่า Server ยังทำงานจึงไม่พอ ต้องดูการกระจายของเส้นทางด้วย
AI เพิ่มสัญญาณด้านข้อมูลและคุณภาพ เช่น Missing Value, Distribution Shift, ภาษาหรือหัวข้อใหม่ การกระจายคะแนน ความไม่มั่นใจ อัตราที่คนแก้ผล Performance บนข้อมูลที่ได้ Label ภายหลัง และความต่างระหว่างกลุ่ม ควรบันทึก Model, Prompt, Data และ Policy Version เพื่อแยกว่าสาเหตุเกิดจากส่วนใด
ทั้งสองระบบต้องกลับมาดู Outcome เดียวกัน ได้แก่ เวลาถึงทีมแรก จำนวนส่งต่อซ้ำ เคสเร่งด่วนตกคิว ภาระงานเจ้าหน้าที่ ความพึงพอใจลูกค้า และ Incident หาก Model Metric ดีขึ้นแต่ลูกค้ารอนานขึ้น ระบบยังไม่สำเร็จ อาจเกิดเพราะคิวหนึ่งรับงานไม่ไหวหรือ Threshold ส่งงานผิดสมดุล
Dashboard ที่ดีจึงมีสามชั้น: ชั้นสุขภาพเทคนิคบอกว่าระบบทำงานหรือไม่ ชั้นคุณภาพการตัดสินบอกว่ากฎและ AI เลือกผลอย่างไร และชั้นผลธุรกิจหรือผลต่อคนบอกว่า Workflow สร้างคุณค่าหรือความเสียหายอะไร ทุก Metric ต้องมีเจ้าของ รอบทบทวน เกณฑ์เตือน และ Action เมื่อเกินขอบเขต
Stop Rule ต้องกำหนดก่อนเปิดใช้ เช่น หากอัตราเคสความปลอดภัยตกคิวเกินเกณฑ์สองวันติด ให้ปิด Auto-routing สำหรับหมวดนั้นและกลับสู่ Human Review หาก Queue ล้น ให้ลดขอบเขต Automation หากตรวจพบข้อมูลส่วนตัวไหลไปยังระบบที่ไม่ได้รับอนุญาต ให้หยุด Pipeline และเริ่ม Incident Response คำว่า Monitor ไม่มีความหมายถ้าไม่มีคนและการกระทำต่อจากสัญญาณ
ข้อจำกัด ความเสี่ยง และความรับผิดชอบของมนุษย์
AI ไม่รู้เป้าหมายขององค์กรจากธรรมชาติของมันเอง มันเพิ่มประสิทธิภาพตามข้อมูล Objective และ Feedback ที่เราให้ หาก Metric ไม่สะท้อนคุณค่า ระบบอาจทำคะแนนดีแต่สร้างพฤติกรรมผิด เช่น ลดเวลาเฉลี่ยด้วยการส่งเคสยากไปคิวทั่วไป หรือเพิ่มอัตรา Automation ด้วยการซ่อนความไม่แน่ใจ ความรับผิดชอบในการนิยามเป้าหมายและตรวจผลยังเป็นของมนุษย์
ข้อมูลไม่เป็นกลางโดยอัตโนมัติ Label อาจสะท้อนการตัดสินที่ไม่สม่ำเสมอ กลุ่มลูกค้าบางกลุ่มอาจมีตัวอย่างน้อย ภาษาถิ่น การสะกดผิด และผู้พิการอาจถูกระบบเข้าใจยากกว่า การวัดแยกกลุ่มต้องเคารพความเป็นส่วนตัวและเหตุผลที่ชอบธรรม แต่การไม่ตรวจเลยก็อาจซ่อนผลเสียต่อคนที่ปรากฏน้อยในข้อมูลรวม
ความโปร่งใสต้องเหมาะกับผู้ใช้ เจ้าหน้าที่ควรรู้ว่าเมื่อใดกำลังเห็นคำแนะนำจาก AI คะแนนหมายถึงอะไร และข้อจำกัดคืออะไร ลูกค้าที่ได้รับผลกระทบควรรู้ช่องทางแก้ไขหรืออุทธรณ์เมื่อจำเป็น ทีมเทคนิคต้องตาม Version และข้อมูลได้ ผู้บริหารต้องเห็น Residual Risk ที่ยังเหลือ ไม่ใช่รับเพียงคำว่า “โมเดลผ่าน QA”
Human Review ต้องออกแบบจากต้นทุนความผิดพลาดและความสามารถจริงของคน หากส่งทุกเคสให้คนตรวจ อาจไม่ลดงานและคนอาจกดผ่านอย่างรีบ หากส่งเฉพาะเคสคะแนนต่ำ โมเดลอาจมั่นใจผิดในบางกลุ่ม จึงควรผสมการตรวจตามความเสี่ยง การสุ่ม Audit และการตรวจเคสใหม่ พร้อมวัดภาระงานและคุณภาพการตัดสินของคนด้วย
เจ้าของระบบต้องระบุว่าใครดูข้อมูล ใครอนุมัติกฎ ใครอนุมัติโมเดล ใครตอบ Incident ใครสื่อสารกับผู้ได้รับผลกระทบ และใครสั่ง Decommission ระบบได้ การกระจายงานให้หลายทีมทำได้ แต่ความรับผิดชอบต้องไม่หายไปในช่องว่างระหว่างทีม
สุดท้าย ไม่มีระบบใดปลอดภัยหรือแม่นยำอย่างสมบูรณ์ เป้าหมายคือเลือกกลไกที่เหมาะ ลดโอกาสและขนาดความเสียหาย ตรวจพบได้เร็ว ย้อนกลับได้ และเรียนรู้จากผลจริง NIST AI RMF จึงเน้นการ Govern, Map, Measure และ Manage อย่างต่อเนื่อง ไม่ใช่ Checklist ครั้งเดียวก่อนเปิดใช้
กรอบเลือกกลไกที่เรียบง่ายที่สุดซึ่งผ่านเกณฑ์
- เขียนการตัดสินใจและ Action ก่อน: ระบบต้องเลือกอะไร แล้ว Output จะเปลี่ยนอะไรในโลกจริง หากยังตอบไม่ได้ อย่าเลือก AI หรือ Automation
- แยกส่วนที่ห้ามผิด: สิทธิ์ ข้อบังคับ Safety Limit และรูปแบบข้อมูลที่ชัดควรเป็นกฎหรือการตรวจแบบกำหนดได้
- ลอง Baseline ง่าย: ปรับแบบฟอร์ม กฎ Heuristic หรือ Decision Support อาจแก้ปัญหาได้เร็วกว่าและเป็นเกณฑ์ให้ AI ต้องชนะ
- ถามว่าความกำกวมมาจากรูปแบบหรือไม่: ถ้าภาษา ภาพ เสียง หรือข้อมูลซับซ้อนจนกฎดูแลยาก และมีตัวอย่างที่เหมาะ AI จึงมีเหตุผล
- วัดต้นทุนผิดสองด้าน: False Positive และ False Negative สร้างผลต่างกัน กำหนด Metric, Threshold และเส้นทางคนตรวจตามต้นทุน
- จำกัดสิทธิ์ของ AI: แยกคำแนะนำออกจาก Action ใส่ Constraint, Approval และ Rollback ก่อนเปิด Automation
- กำหนดหลักฐานและเจ้าของ: Test, Monitor, Incident, Feedback, Version และผู้สั่งหยุดต้องมีชื่อและรอบทบทวน
ใช้ Decision Rule สั้น ๆ ว่า ถ้าเงื่อนไขชัดและห้ามคลาดเคลื่อน ให้เริ่มจากกฎ; ถ้ารูปแบบซับซ้อนและยอมรับการประมาณได้ ให้พิจารณา AI; ถ้าผลกระทบสูงหรือบริบทไม่อยู่ในข้อมูล ให้มนุษย์รับผิดชอบ; แล้วใช้ Automation ทำเฉพาะสิ่งที่ผ่านการควบคุมแล้ว
คำว่าเริ่มจากกฎไม่ได้หมายความว่าต้องติดอยู่กับกฎตลอดไป Baseline ช่วยเก็บข้อมูลและเปิดเผยข้อยกเว้น เมื่อกฎเริ่มซับซ้อนหรือคุณภาพตัน เราจึงมีหลักฐานว่าจุดใดคุ้มใช้ AI ในทางกลับกัน หาก AI ไม่ชนะ Baseline หรือสร้างต้นทุนดูแลสูงกว่าคุณค่า การถอยกลับไปใช้กฎไม่ใช่ความล้มเหลว แต่เป็นการตัดสินใจที่มีวินัย
ความเข้าใจผิดที่พบบ่อยและวิธีตรวจ
“ระบบทำงานเอง แปลว่าเป็น AI”
กลไกที่ทำให้คิดเช่นนั้น: ผู้ใช้เห็นเพียงว่าไม่มีคนกด ไม่เห็น Logic ภายใน สิ่งที่ถูกต้อง: Automation อาจเป็น Event กับกฎธรรมดา วิธีตรวจ: ถามว่า Output มาจากเงื่อนไขที่เขียนไว้หรือการประมาณจากรูปแบบข้อมูล
“AI ฉลาดกว่า จึงควรแทนกฎ”
กลไกที่ทำให้คิดเช่นนั้น: Demo แสดงความยืดหยุ่นแต่ไม่แสดงความไม่แน่นอน สิ่งที่ถูกต้อง: จุดที่เขียนกฎชัดและห้ามผิดมักไม่ต้องเพิ่มการประมาณ วิธีตรวจ: เทียบ Outcome, Guardrail และต้นทุนรวมกับ Baseline
“Input เดิมต้องได้ Output เดิมเสมอ”
กลไกที่ทำให้คิดเช่นนั้น: ผู้ใช้คุ้นกับโปรแกรม Deterministic สิ่งที่ถูกต้อง: Generative AI อาจต่างจากการสุ่ม และระบบ AI เปลี่ยนตาม Version, Prompt หรือบริบท วิธีตรวจ: บันทึก Version/Parameter และรันทดสอบซ้ำภายใต้เงื่อนไขควบคุม
“มีคนตรวจแล้วจึงปลอดภัย”
กลไกที่ทำให้คิดเช่นนั้น: แผนผังมี Human-in-the-loop แต่ไม่วัดงานจริง สิ่งที่ถูกต้อง: คนต้องเห็นข้อมูล มีเวลา มีทักษะ และเปลี่ยนผลได้ วิธีตรวจ: วัดอัตราแก้ เวลาตรวจ ความผิดพลาดหลังตรวจ และทดสอบ Recovery
“Accuracy สูงหมายถึงโครงการสำเร็จ”
กลไกที่ทำให้คิดเช่นนั้น: คะแนนเดียวสื่อสารง่าย สิ่งที่ถูกต้อง: ต้องดูกลุ่มย่อย Workflow Outcome และต้นทุนผิด วิธีตรวจ: เชื่อม Model Metric กับเวลาถึงทีม อัตราส่งต่อ เคสเสี่ยงตกคิว และ Incident
Worksheet: ระบายสี Workflow ของคุณ
เลือกกระบวนการหนึ่งที่มีหลายขั้น เช่น คัดเอกสาร อนุมัติค่าใช้จ่าย รับคำร้อง หรือจัดลำดับงาน เขียนแต่ละขั้นลงบนกระดาษ แล้วใช้สี่สี: กฎแน่นอน, AI ประมาณ, มนุษย์ตัดสินใจ และ Automation ลงมือทำ เป้าหมายคือเห็นรอยต่อ ไม่ใช่รีบเพิ่ม AI ให้ทุกช่อง
1. Task และ Action
เขียนว่าใครกำลังตัดสินใจอะไร Output จะถูกใช้ทำอะไร และผลเสียเกิดกับใครถ้าผิด หลีกเลี่ยงคำกว้างอย่าง “ทำให้ฉลาดขึ้น”
2. Input ตามเวลา
รายการข้อมูลที่มีจริงในขณะตัดสินใจ แยกข้อมูลที่เกิดภายหลังออกเพื่อป้องกัน Leakage ระบุสิทธิ์และข้อมูลอ่อนไหว
3. จุดที่เขียนเป็นกฎได้
ทำเครื่องหมายข้อบังคับ รูปแบบ ขีดจำกัด และกรณีห้ามอัตโนมัติ เขียน Expected Output อย่างน้อยสามกรณี รวมกรณีขอบ
4. จุดที่ต้องประมาณ
ระบุว่าความกำกวมมาจากภาษา ภาพ เสียง หรือรูปแบบใด มีตัวอย่างที่ตรวจแล้วหรือไม่ และผลผิดสองด้านมีต้นทุนอย่างไร
5. Human Review และ Recovery
ใครตรวจกรณีใด เห็นข้อมูลอะไร แก้ผลอย่างไร และกลับสู่วิธีเดิมได้ภายในเวลาเท่าไรเมื่อระบบล้มเหลว
6. Test และ Monitor
เลือกหลักฐานสำหรับ Logic, Model, Policy, Human และ End-to-end กำหนด Metric เจ้าของ เกณฑ์เตือน Stop Rule และรอบทบทวน
หลักฐานว่าทำสำเร็จ
คุณควรอธิบาย Workflow ได้โดยไม่ใช้ชื่อผลิตภัณฑ์ ชี้ได้ว่าทุกขั้นรับอะไร ทำอะไร ส่งอะไรออก พลาดแบบใด และเมื่อพลาดย้อนกลับไปแก้ตรงไหน อีกคนควรอ่านแผนแล้วบอกได้ว่าจุดใดเป็นคำแนะนำ จุดใดเป็นคำสั่ง และใครรับผิดชอบ
คำถาม Why/How
ทำไมขั้นนี้ต้องแน่นอน? ถ้าใช้ AI แทนกฎจะเพิ่มคุณค่าอะไร? คะแนนถูกแปลงเป็น Action อย่างไร? ใครได้รับผลเมื่อผิด? เรารู้ได้อย่างไรว่าคุณภาพเสื่อม? เงื่อนไขใดจะทำให้เปลี่ยนจาก Automation กลับสู่ Human Review?
Recovery Step
ถ้าระบายสีไม่ได้ ให้สังเกตงานจริงหนึ่งรอบ เก็บตัวอย่าง Input–Output อย่างน้อย 10 เคส และถามคนทำงานว่าเคสใดต้องใช้วิจารณญาณ เคสใดทำตามกฎ และเคสใดผิดแล้วแก้ไม่ได้ จากนั้นค่อยแบ่ง Workflow ใหม่ อย่าเดากระบวนการจากชื่อระบบ
แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบให้ครบแล้วกด “ตรวจคำตอบ” ระบบจะแสดงคะแนนรวม เฉลย และเหตุผลรายข้อ หากเว้นไว้จะบอกจำนวนข้อที่ยังไม่ได้ตอบ คุณสามารถกด “ทำแบบทดสอบใหม่” เพื่อล้างคำตอบและเริ่มอีกครั้ง
สรุป: AI เป็นหนึ่งกลไกในระบบอัตโนมัติ ไม่ใช่คำพ้องกัน
ย้อนกลับไปที่กล่องอีเมลเช้าวันจันทร์ หากทีมถามเพียงว่า “จะใช้ AI รุ่นไหนดี” ทีมอาจได้โมเดลที่จัดหมวดได้สวยใน Demo แต่ยังไม่รู้ว่าควรเชื่อคะแนนแค่ไหน เคสใดห้ามส่งเอง และใครรับผิดชอบเมื่อ Queue ผิด การแยกกลไกทำให้คำถามเปลี่ยนเป็นเรื่องที่ตรวจได้: อะไรเป็นกฎ อะไรเป็นการประมาณ Output ถูกแปลงเป็น Action อย่างไร และผลจริงบอกอะไรกลับมา
Mental Model ที่ควรจำคือ Validate → Estimate → Constrain → Review → Execute → Audit กฎตรวจสิ่งที่รู้แน่นอน AI ช่วยในจุดที่รูปแบบซับซ้อน กฎจำกัดสิทธิ์ คนทบทวนกรณีเสี่ยง Automation ลงมือทำสิ่งที่อนุมัติ และผลจริงย้อนกลับไปปรับระบบ วงจรนี้ช่วยรักษาความแน่นอนในจุดสำคัญโดยไม่ทิ้งประโยชน์ของการเรียนจากข้อมูล
การเลือกกลไกที่ง่ายที่สุดซึ่งผ่านเกณฑ์ไม่ใช่การต่อต้าน AI แต่เป็นการใช้ AI อย่างมีเหตุผล หากกฎแก้ได้ดี ให้ใช้กฎ หากความกำกวมต้องอาศัยรูปแบบและมีหลักฐานพอ ให้ใช้ AI หากผลกระทบสูง ให้คนมีอำนาจตรวจและหยุด และไม่ว่าจะเลือกอะไร ให้ทดสอบ Monitoring และ Rollback ตรงกับธรรมชาติของระบบ
Insight Gate: ถ้าคุณมอง Workflow หนึ่งเส้นแล้วชี้ได้ว่าแต่ละขั้นรับอะไร ทำงานด้วยกฎหรือการประมาณ ส่งอะไรออก ใครเปลี่ยนผลได้ พลาดแบบใด และใช้หลักฐานอะไรตรวจ คุณไม่ได้เพียงจำความต่างระหว่าง AI กับ Automation แต่เริ่มออกแบบระบบที่รับผิดชอบต่อโลกจริงได้แล้ว
ภาพสรุป: จากกฎและการประมาณสู่ระบบผสมที่ควบคุมได้
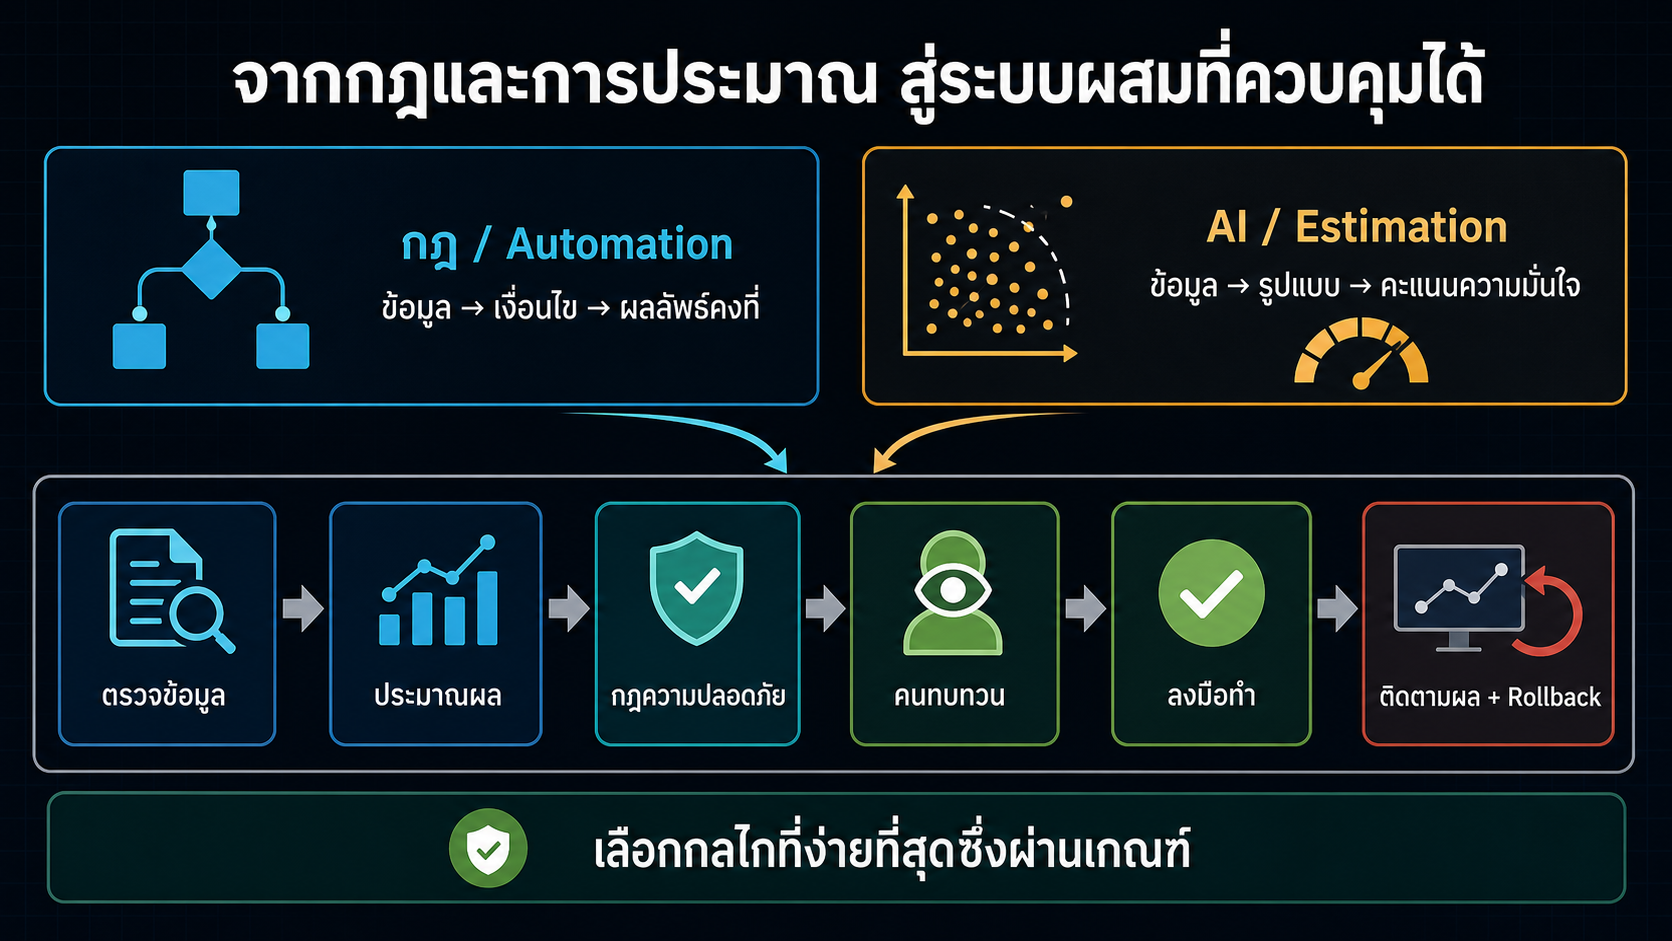
สิ่งที่ควรสังเกต: เส้นทางไม่ได้จบที่โมเดล Output ของ AI ต้องผ่านการตรวจและข้อจำกัดก่อนถึงคนและเครื่องมือที่ลงมือทำ ส่วนผลจริงด้านล่างย้อนกลับเข้าสู่วงจร Monitoring เพื่อบอกว่าควรคง ลด หยุด หรือปรับ Automation จุดใด
เรียนต่ออย่างมีทิศทาง
บทถัดไปจะพาใช้กรอบคุณค่า ต้นทุน ความเสี่ยง และทางเลือกพื้นฐานเพื่อประเมินว่าโครงการ AI คุ้มทำหรือไม่ หลังจากบทนี้คุณจึงพร้อมแยกได้ก่อนว่าคุณกำลังจ่ายต้นทุนให้กฎ Software, AI หรือระบบผสมส่วนใด
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงและหมายเหตุบรรณาธิการ
- Google for Developers — ML Problem Framing Overview
- Google for Developers — Understand the Problem and Compare a Non-ML Approach
- Google for Developers — Rules of Machine Learning
- Google for Developers — Monitoring Production ML Pipelines
- NIST — Artificial Intelligence Risk Management Framework (AI RMF 1.0)
- NIST AI Resource Center — AI RMF Core: Govern, Map, Measure, Manage
- OECD — AI Principles
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 9 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 28 · PATH 01 · กรณีคัดอีเมลและตัวเลข Threshold เป็นสถานการณ์สมมติเพื่อการอธิบาย ไม่ใช่ผลทดสอบขององค์กรจริง · ภาพสรุปสร้างจาก ImageGen master แบบไม่มีข้อความ ครอปและแปลงไฟล์เพื่อเว็บ บันทึก Source/Version/QA ใน Visual Register ภายใน
