PATH 01 พื้นฐานระบบ AI · หัวข้อ 27 จาก 50 · เล่ม 1 · ระดับเริ่มต้น
เช้าวันจันทร์ กล่องอีเมลฝ่ายบริการลูกค้ามีข้อความใหม่ 1,200 ฉบับ ผู้จัดการบอกทีมว่า “เราน่าจะใช้ AI มาช่วย” ประโยคนี้ฟังดูเหมือนเริ่มโครงการแล้ว แต่จริง ๆ ยังไม่ได้บอกเลยว่า AI ต้องช่วยใคร ตัดสินใจอะไร หรือความสำเร็จหน้าตาเป็นแบบไหน
ถ้าเริ่มจากคำว่า Chatbot, Large Language Model หรือโมเดลจัดหมวด ทีมมักรีบสร้างสิ่งที่ดูเก่งใน Demo แต่ไม่แก้คิวงานจริง บทเรียนนี้จึงชวนย้อนลำดับใหม่: เริ่มจากคน งาน และการตัดสินใจ ระบุข้อมูลที่มีในเวลานั้น ผลจริงที่ใช้ตรวจ Baseline ที่ต้องชนะ และ Guardrail ที่ห้ามแย่ลง แล้วค่อยถามว่า AI เหมาะกว่ากฎ ซอฟต์แวร์ทั่วไป หรือการปรับกระบวนการหรือไม่
คำตอบสั้น: ปัญหาที่เหมาะกับ AI คือปัญหาที่มีงานหรือการตัดสินใจชัด มีตัวอย่างหรือสัญญาณให้ระบบเรียนรู้ มีผลลัพธ์ให้ตรวจภายหลัง และยอมรับความผิดพลาดได้ภายใต้การควบคุมที่กำหนดไว้ ถ้ายังไม่รู้ว่า Output จะถูกนำไปทำอะไร โครงการยังไม่พร้อมเลือกโมเดล
อ่านจบบทนี้ คุณจะทำอะไรได้
- เขียน Problem Statement ที่ระบุผู้ใช้ การตัดสินใจ ข้อมูล ผลจริง Baseline และ Guardrail ได้ครบ
- แยกได้ว่าโจทย์ควรแก้ด้วยการปรับกระบวนการ กฎ ซอฟต์แวร์ทั่วไป AI หรือระบบผสม
- ตรวจความพร้อมของข้อมูลโดยระวัง Leakage, Proxy, กลุ่มที่หาย และสิทธิ์การใช้งาน
- กำหนด Metric สามชั้นและออกแบบ Pilot ที่เรียนรู้ได้โดยจำกัดความเสียหาย
- อธิบายบทบาทมนุษย์ จุดส่งต่อ และ Stop Rule ที่ทำให้การใช้ AI รับผิดชอบได้
เริ่มจากการตัดสินใจ ไม่ใช่เริ่มจากความสามารถของโมเดล
คำว่า “ใช้ AI กับอีเมล” กว้างเกินไป เพราะอีเมลหนึ่งฉบับอาจเกี่ยวข้องกับงานหลายแบบ ตั้งแต่ตรวจสแปม จัดหมวด สรุปใจความ ร่างคำตอบ ค้นข้อมูลลูกค้า ไปจนถึงตัดสินใจคืนเงิน งานเหล่านี้ใช้ข้อมูลต่างกัน มีความผิดพลาดคนละแบบ และต้องการคนรับผิดชอบคนละจุด การเลือกโมเดลก่อนจึงเหมือนซื้อเครื่องมือช่างก่อนรู้ว่าจะซ่อมอะไร
ให้เริ่มจากประโยคที่บอกการกระทำในโลกจริง เช่น “ช่วยเจ้าหน้าที่จัดอีเมลใหม่เข้า 8 คิว เพื่อให้ทีมที่รับผิดชอบเห็นข้อความภายใน 10 นาที” ประโยคนี้ยังไม่สมบูรณ์ แต่ทำให้เรามองเห็นผู้ใช้ การตัดสินใจ Output และผลต่อ Workflow แล้ว จากนั้นจึงถามต่อว่าอีเมลที่ส่งผิดคิวสร้างความเสียหายเท่าไร คิวใดมีความเสี่ยงสูง และใครแก้เส้นทางได้
AI ในที่นี้ไม่ใช่ผู้ตัดสินที่มีเจตนา แต่เป็นระบบที่ประมาณ Output จากรูปแบบในข้อมูล เช่น เดาว่าอีเมลควรอยู่หมวดใด การประมาณมีประโยชน์เมื่อกฎเขียนได้ยากและมีตัวอย่างมากพอ แต่คำว่า “เดา” เตือนเราว่าผลลัพธ์อาจผิด ระบบจึงต้องเชื่อมกับกระบวนการที่ตรวจ แก้ และเรียนรู้จากผลจริงได้
โจทย์ AI ที่ดีไม่ถามเพียงว่า “โมเดลทำได้ไหม” แต่ถามว่า “เมื่อโมเดลผิด ใครเห็น ใครหยุด ใครแก้ และเรารู้ได้อย่างไรว่าผลจริงดีขึ้น”
อุปมาเรื่องเครื่องมือช่วยเปิดภาพได้ แต่มีขอบเขต: ค้อนทำงานตามแรงที่คนออก ส่วนโมเดลเรียนรู้รูปแบบจากข้อมูลและอาจให้ผลต่างกันเมื่อข้อมูลเปลี่ยน การกำหนดปัญหาจึงต้องรวมวิธีตรวจการเปลี่ยนแปลงและ Feedback หลังใช้งาน ไม่ใช่จบเมื่อสร้างโมเดลเสร็จ
Problem Statement ที่ใช้ทำงานได้มีหกส่วน
Problem Statement ไม่ใช่คำอธิบายยาวเพื่อให้เอกสารดูเป็นทางการ หน้าที่ของมันคือทำให้ทีมธุรกิจ ผู้ใช้ นักข้อมูล วิศวกร ฝ่ายกฎหมาย และผู้รับผิดชอบความเสี่ยงพูดถึงปัญหาเดียวกันได้ หากหกส่วนต่อไปนี้ยังตอบไม่ตรงกัน การทดลองโมเดลจะผลิตคะแนนมากมายแต่ไม่ตอบคำถามขององค์กร
ผู้ใช้และผู้ได้รับผล
ใครใช้ Output เพื่อทำงาน ใครได้รับผลจากการตัดสินใจ และใครมีสิทธิ์คัดค้านหรือขอแก้ เช่น เจ้าหน้าที่คัดคิวเป็นผู้ใช้หลัก แต่ลูกค้าที่อีเมลถูกส่งผิดคือผู้ได้รับผลโดยตรง
การตัดสินใจหรืองาน
ระบบช่วยเลือก จัดอันดับ พยากรณ์ สร้าง หรือค้นหาอะไร ต้องระบุการกระทำหลังเห็น Output ด้วย เช่น จัดอีเมลเข้าคิว ไม่ใช่เพียง “วิเคราะห์ข้อความ”
ข้อมูลที่มีในเวลานั้น
สัญญาณใดเกิดขึ้นก่อนการตัดสินใจและมีสิทธิ์ใช้จริง เช่น หัวเรื่อง เนื้อหา ภาษา ช่องทาง และประวัติการติดต่อที่ได้รับอนุญาต ห้ามเผลอใช้ข้อมูลที่เกิดหลังปิดเคส
ผลจริงที่ใช้ตรวจ
ภายหลังเราจะรู้ได้อย่างไรว่าการจัดคิวถูก เช่น ทีมปลายทางยืนยันหมวด การโอนคิวซ้ำลดลง หรือปัญหาถูกแก้โดยไม่ส่งต่อ ผลจริงนี้เรียก Ground Truth เมื่อมีนิยามและกระบวนการเก็บที่น่าเชื่อถือ
Baseline และเป้าหมาย
วันนี้ทำงานอย่างไร ใช้เวลาเท่าไร ผิดแบบใด และต้นทุนอยู่ตรงไหน Baseline เป็นจุดอ้างอิงที่ทำให้รู้ว่าระบบใหม่ดีกว่าวิธีเดิมจริง ไม่ใช่เพียงมี Accuracy ที่ดูสูง
Guardrail และจุดหยุด
อะไรห้ามแย่ลง เช่น อีเมลเร่งด่วนห้ามตกคิว ข้อมูลส่วนตัวห้ามถูกส่งผิดทีม และภาระตรวจของพนักงานห้ามเพิ่มเกินกำหนด พร้อมระบุว่าเมื่อใดต้องหยุดหรือย้อนกลับ
เมื่อรวมกัน เราอาจเขียนว่า: “ช่วยเจ้าหน้าที่บริการลูกค้าจัดอีเมลใหม่เข้า 8 คิวจากข้อมูลที่มีขณะรับข้อความ เพื่อให้ทีมที่รับผิดชอบเห็นเคสภายใน 10 นาที ลดอัตราโอนคิวซ้ำจาก Baseline โดยไม่เพิ่มอีเมลเร่งด่วนที่ตกคิว และส่งให้มนุษย์ตรวจเมื่อความมั่นใจต่ำหรือพบข้อมูลอ่อนไหว”
ประโยคนี้ยังไม่ตัดสินว่าจะใช้ AI เพราะ Problem Framing ที่ดีต้องเปิดพื้นที่ให้ทางเลือกอื่นแข่งขันกัน หากจัดคิวได้จากที่อยู่อีเมลหรือประเภทแบบฟอร์มที่ชัด กฎธรรมดาอาจถูกกว่า อธิบายง่ายกว่า และเสถียรกว่าโมเดล
กรณีศึกษาหลัก: อีเมลหนึ่งฉบับเดินผ่านระบบอย่างไร
กรณีนี้เป็นตัวอย่างสมมติเพื่อการอธิบาย บริษัทหนึ่งมีคิวบริการ 8 ประเภท เช่น การชำระเงิน การยกเลิก การคืนเงิน ปัญหาบัญชี และเหตุเร่งด่วน ปัจจุบันเจ้าหน้าที่หน้าคิวอ่านข้อความแล้วเลือกทีมปลายทาง บางวันข้อความเพิ่มขึ้นรวดเร็ว ทำให้เคสสำคัญรอนานและเกิดการโอนคิวหลายรอบ
Input ที่ระบบเห็น
ระบบอาจเห็นหัวเรื่อง เนื้อหา ภาษาที่ใช้ เวลาที่ส่ง ช่องทาง และข้อมูลบัญชีบางส่วนที่ได้รับอนุญาต แต่ไม่ควรสมมติว่าทุกฟิลด์มีอยู่เสมอ ลูกค้าอาจเขียนสั้น ใช้คำประชด แนบภาพแทนข้อความ หรือพูดหลายเรื่องในอีเมลเดียว ข้อมูลบางส่วนยังเป็นข้อมูลส่วนบุคคลที่ต้องจำกัดการเข้าถึงและระยะเวลาเก็บ
Process ที่ระบบทำ
โมเดลแปลงข้อความเป็นตัวแทนเชิงตัวเลข แล้วประมาณคะแนนของแต่ละหมวด จากนั้น Workflow ใช้คะแนนร่วมกับกฎ เช่น ถ้าพบคำที่เกี่ยวกับความปลอดภัยหรือยอดเงินสูง ให้ส่ง Human Review แม้หมวดที่ได้คะแนนสูงจะดูชัด การตัดสินใจสุดท้ายจึงมาจากระบบผสม ไม่ใช่จากโมเดลเดี่ยว
Output ที่คนใช้
Output ที่เหมาะอาจเป็น “หมวดแนะนำ + ระดับความมั่นใจ + เหตุผลเชิงหลักฐานที่ตรวจได้ + ทางเลือกส่งต่อ” ไม่ใช่เพียงชื่อหมวด หากหน้าจอบังคับให้เจ้าหน้าที่กดยอมรับโดยไม่เห็นข้อความต้นฉบับ Human Review จะมีชื่อแต่ไม่มีอำนาจจริง
ผลจริงและ Feedback
หลังทีมปลายทางทำงาน เราจึงเห็นว่าอีเมลอยู่ถูกคิวหรือถูกโอนซ้ำ ใช้เวลากี่นาที และลูกค้าต้องติดต่ออีกหรือไม่ Feedback ที่ใช้เรียนรู้ต้องแยก “คำแนะนำของโมเดล”, “การตัดสินใจของเจ้าหน้าที่” และ “ผลจริง” ออกจากกัน มิฉะนั้นระบบอาจเรียนว่าคนยอมรับคำแนะนำเท่ากับคำแนะนำนั้นถูก
เงื่อนไขที่ทำให้ข้อสรุปเปลี่ยน
หากแบบฟอร์มใหม่บังคับให้ลูกค้าเลือกประเภทปัญหาได้แม่น การปรับกระบวนการอาจลดความจำเป็นของ AI หากอีเมลหลายภาษาเพิ่มขึ้นหรือหมวดงานเปลี่ยน โมเดลเดิมอาจเสื่อม หากความผิดพลาดในคิวหนึ่งสร้างความเสียหายสูง เราอาจใช้ AI เฉพาะคิวความเสี่ยงต่ำและคง Human Review สำหรับคิวสำคัญ
ก่อนเลือกโมเดล ต้องเลือกชนิด Output ให้ตรงงาน
คำว่า “ให้ AI ช่วย” ซ่อนชนิดของ Output หลายแบบ แต่ละแบบมีวิธีวัดและความเสี่ยงต่างกัน การจัดหมวดต้องตอบว่าหมวดถูกหรือผิด การจัดอันดับต้องดูว่ารายการสำคัญขึ้นมาก่อนหรือไม่ การพยากรณ์ต้องตรวจค่าคลาดเคลื่อนตามช่วงเวลา ส่วนการสร้างข้อความต้องตรวจความถูกต้อง ความเหมาะสม และการอ้างแหล่งข้อมูล
| ชนิด Output | คำถามที่ระบบตอบ | ตัวอย่างในกรณีอีเมล | ความผิดพลาดที่ต้องระวัง |
|---|---|---|---|
| จัดหมวด | รายการนี้อยู่กลุ่มใด | ส่งอีเมลเข้าคิวคืนเงิน | ส่งผิดทีม หรือบังคับหนึ่งหมวดทั้งที่มีหลายประเด็น |
| จัดอันดับ | รายการใดควรมาก่อน | เรียงเคสเร่งด่วนบนสุด | ให้คะแนนสูงกับภาษาบางแบบจนกลุ่มอื่นรอนาน |
| พยากรณ์ | ค่าในอนาคตน่าจะเท่าไร | คาดเวลาปิดเคส | ประเมินต่ำจนสัญญาบริการผิด |
| สร้างข้อความ | ควรร่างคำตอบอย่างไร | ร่างคำตอบเบื้องต้น | แต่งข้อมูล นโยบาย หรือคำสัญญาที่ไม่มีจริง |
| ค้นคืนข้อมูล | หลักฐานใดเกี่ยวข้อง | ค้นนโยบายคืนเงินเวอร์ชันล่าสุด | หยิบเอกสารเก่า หรือไม่มีสิทธิ์ให้ผู้ใช้นั้นเห็น |
บางโครงการล้มเพราะวัด Output คนละชนิดกับสิ่งที่ Workflow ต้องใช้ เช่น โมเดลสรุปอีเมลได้สวย แต่ปัญหาจริงคือการจัดคิวช้า การสรุปอาจเพิ่มขั้นตอนโดยไม่ลดเวลารอ ดังนั้น Output ต้องเชื่อมกับการกระทำและ Outcome เสมอ
เปรียบเทียบทางเลือกก่อนเลือก AI
AI ไม่ได้ชนะโดยอัตโนมัติเพียงเพราะงานเกี่ยวกับข้อความหรือข้อมูลจำนวนมาก ทางเลือกที่ดีคือทางเลือกที่แก้สาเหตุของปัญหาได้ด้วยต้นทุน ความเสี่ยง และภาระดูแลที่เหมาะสม บางครั้งคำตอบคือปรับแบบฟอร์ม บางครั้งคือกฎ และบ่อยครั้งคือระบบผสม
| ทางเลือก | เหมาะเมื่อ | หลักฐานที่ควรเห็น | ข้อแลกเปลี่ยน |
|---|---|---|---|
| ปรับกระบวนการ | สาเหตุเกิดจากขั้นตอนซ้ำ ข้อมูลไม่ถึงคน หรือแบบฟอร์มกำกวม | ปัญหาลดลงเมื่อเปลี่ยนทางเข้าโดยไม่ต้องทำนาย | อาจต้องเปลี่ยนนิสัยและความรับผิดชอบของหลายทีม |
| กฎ | เงื่อนไขชัด เปลี่ยนน้อย และต้องอธิบายตรง | กฎจำนวนจำกัดครอบคลุมกรณีหลักได้ | เปราะเมื่อภาษาและบริบทหลากหลาย |
| ซอฟต์แวร์ทั่วไป | งานเป็นการค้น คำนวณ ตรวจความครบ หรือเชื่อมระบบแบบแน่นอน | ผลลัพธ์เดียวกันเมื่อ Input เหมือนกัน | ไม่เหมาะกับรูปแบบกำกวมที่เขียนกฎไม่ไหว |
| AI | รูปแบบซับซ้อน มีตัวอย่างมากพอ และการประมาณสร้างคุณค่า | ผล Offline ดีกว่า Baseline และ Failure จัดการได้ | ต้องดูแลข้อมูล Drift การตรวจ และความไม่แน่นอน |
| ระบบผสม | ต้องใช้ AI หาแบบแผนร่วมกับกฎและคนคุมความเสี่ยง | แต่ละชั้นมีหน้าที่และจุดส่งต่อชัด | ซับซ้อนด้าน Workflow และความรับผิดชอบ |
สำหรับกรณีอีเมล เราอาจใช้กฎกับผู้ส่งที่รู้จักและเคสความปลอดภัย ใช้ AI จัดหมวดข้อความทั่วไป และให้คนตรวจเคสความมั่นใจต่ำ วิธีนี้ไม่ได้ทำให้ AI ดูเด่นที่สุด แต่ทำให้ระบบทั้งหมดน่าเชื่อถือกว่า
ข้อมูลต้องสัมพันธ์กับการตัดสินใจและมีในเวลาจริง
ชุดข้อมูลเก่าอาจมีคอลัมน์มากมาย แต่ไม่ใช่ทุกคอลัมน์ใช้ได้ตอนตัดสินใจ หากฟิลด์ “ทีมที่ปิดเคส” ถูกเขียนหลังงานเสร็จ แล้วนำไปฝึกโมเดลจัดคิว โมเดลจะดูแม่นในอดีตเพราะเห็นคำตอบล่วงหน้า ปัญหานี้เรียก Data Leakage หรือการรั่วไหลของข้อมูลจากอนาคตเข้าสู่การทำนาย
ต้องตรวจที่มาของป้ายกำกับด้วย หมวดเดิมอาจสะท้อนโครงสร้างองค์กร ไม่ใช่เจตนาของลูกค้า เจ้าหน้าที่แต่ละทีมอาจใช้เกณฑ์ต่างกัน และบางเคสถูกย้ายเพราะกำลังคน ไม่ใช่เพราะหมวดผิด ถ้านำป้ายเหล่านี้ไปฝึกโดยไม่ตรวจ โมเดลจะเรียนความไม่สม่ำเสมอเป็นกฎ
กลุ่มที่หายสำคัญไม่แพ้กลุ่มที่มี เช่น อีเมลภาษาถิ่น ลูกค้าที่ใช้ข้อความสั้น หรือผู้ใช้ที่ส่งภาพหน้าจออาจมีตัวอย่างน้อย คะแนนเฉลี่ยทั้งระบบจึงซ่อนความล้มเหลวเฉพาะกลุ่มได้ การแบ่งผลตามภาษา ช่องทาง ประเภทเคส และระดับความเสี่ยงช่วยให้เห็นว่าใครรับต้นทุนของความผิดพลาด
สิทธิ์ใช้ข้อมูลเป็นเงื่อนไขก่อนความแม่น ต้องตอบว่าข้อมูลถูกเก็บด้วยวัตถุประสงค์ใด ใครเข้าถึงได้ ต้องลบเมื่อใด และมีข้อมูลอ่อนไหวหรือความลับธุรกิจหรือไม่ การมีข้อมูลในฐานไม่ได้แปลว่ามีสิทธิ์นำไปฝึกหรือส่งให้บริการภายนอก
คำถามตรวจข้อมูลหกข้อ
- ข้อมูลนี้มีอยู่ก่อนตัดสินใจจริงหรือไม่
- ป้ายกำกับหมายถึงผลจริงหรือเพียงการกระทำของคนในอดีต
- กลุ่มใดมีตัวอย่างน้อยหรือหายไป
- ช่วงเวลาใดไม่ถูกแทนในข้อมูล
- มีสิทธิ์ใช้เพื่อวัตถุประสงค์นี้และจำกัดผู้เข้าถึงแล้วหรือไม่
- เมื่อโลกเปลี่ยน เราจะรู้ได้อย่างไรว่าข้อมูลไม่แทนปัจจุบันแล้ว
วัดคุณภาพโมเดล กระบวนการ และผลลัพธ์แยกกัน
Accuracy เพียงค่าเดียวไม่พอ เพราะถ้าหมวดทั่วไปมี 90% โมเดลที่ทายหมวดนั้นตลอดอาจได้คะแนนสูงแต่ไม่มีประโยชน์ ต้องดู Precision ว่าคำทำนายของหมวดสำคัญถูกกี่ครั้ง และ Recall ว่าเคสจริงของหมวดนั้นถูกค้นพบกี่ส่วน เกณฑ์ที่เหมาะขึ้นอยู่กับต้นทุนของ False Positive และ False Negative
แต่คะแนนโมเดลยังไม่ตอบว่ากระบวนการดีขึ้นหรือไม่ ทีมอาจต้องเปิดอ่านและแก้ทุกครั้งจนเวลารวมเพิ่ม จึงต้องวัดสามชั้นร่วมกัน
Model Metric
วัดคุณภาพการประมาณ เช่น Precision, Recall, Calibration และผลแยกกลุ่ม บอกว่าโมเดลให้สัญญาณดีเพียงใดภายใต้ชุดทดสอบที่กำหนด
Workflow Metric
วัดสิ่งที่คนและระบบทำร่วมกัน เช่น เวลาถึงทีมแรก อัตรา Override จำนวนการโอนคิว ภาระตรวจ และคิวค้าง
Outcome Metric
วัดผลต่อโลกจริง เช่น เวลาปิดเคส การติดต่อซ้ำ ความพึงพอใจ ความเสียหาย และผลต่อกลุ่มผู้ใช้ต่าง ๆ
Baseline ต้องวัดด้วยนิยามและช่วงเวลาเดียวกับ Pilot หาก Baseline วัดช่วงงานน้อย แต่ Pilot วัดช่วงเทศกาล การเปรียบเทียบจะไม่ยุติธรรม ควรเก็บทั้งค่ากลาง การกระจาย และกรณีรุนแรง ไม่ใช่ใช้ค่าเฉลี่ยเดียวลบภาพคิวที่รอนานมาก
Guardrail เป็น Metric ที่ไม่จำเป็นต้องดีขึ้น แต่ห้ามแย่เกินเกณฑ์ เช่น เคสความปลอดภัยตกคิวไม่เกินค่าที่กำหนด ข้อมูลอ่อนไหวไม่ส่งออกนอกทีม และเวลา Human Review ไม่เกินกำลังคนจริง Guardrail ทำให้คำว่า “สำเร็จ” ไม่แลกกับความเสียหายที่ทีมไม่ได้ตั้งใจวัด
Failure Case: คะแนนดีได้อย่างไรทั้งที่โครงการไม่ช่วยงาน
เห็นคำตอบจากอนาคต
โมเดลใช้ฟิลด์ที่เกิดหลังปิดเคส จึงได้คะแนนสูงในชุดทดสอบ แต่เมื่อใช้งานจริงฟิลด์นั้นยังว่าง ผลลัพธ์ตกทันที วิธีตรวจคือเขียนเส้นเวลาของทุกฟีเจอร์และจำลองข้อมูลตามเวลาตัดสินใจจริง
Baseline อ่อนเกินจริง
ทีมเทียบ AI กับการสุ่มหรือขั้นตอนที่ไม่ได้รับการปรับปรุง ทั้งที่กฎง่าย ๆ ทำได้ดีเกือบเท่ากัน วิธีตรวจคือสร้าง Baseline หลายระดับ ตั้งแต่ค่าคงที่ กฎง่าย กระบวนการที่ปรับแล้ว ไปจนถึงระบบเดิมของผู้เชี่ยวชาญ
Metric ไม่ตรงต้นทุน
Accuracy สูงเพราะหมวดใหญ่แม่น แต่เคสเร่งด่วนถูกพลาด วิธีตรวจคือทำ Cost Matrix ของความผิดพลาดแต่ละแบบและรายงานผลแยกตามคิวความเสี่ยง ไม่เฉลี่ยทุกอย่างเข้าด้วยกัน
คนกลายเป็นตัวกันชน
ระบบประกาศว่ามี Human Review จึงดูปลอดภัย แต่เจ้าหน้าที่มีเวลาไม่พอ เห็นหลักฐานไม่ครบ หรือถูกกดดันให้ยอมรับคำแนะนำ วิธีตรวจคือวัดคิว เวลา Override เหตุผลที่แก้ และทดสอบว่าคนหยุดระบบได้จริง
Demo ไม่มี Workflow จริง
ทีมเลือกตัวอย่างสะอาดและแสดงผลทีละเคส แต่โลกจริงมีอีเมลซ้ำ ไฟล์แนบ ภาษาแปลก ระบบปลายทางล่ม และปริมาณพุ่ง วิธีตรวจคือ Pilot ใน Shadow Mode กับกระแสข้อมูลจริงโดยไม่ให้ผลโมเดลเปลี่ยนงานก่อน
Feedback Loop ขยายความผิด
โมเดลส่งอีเมลเข้าคิวหนึ่ง คนเห็นเฉพาะคิวนั้นและยืนยันหมวดเดิม ข้อมูลรอบใหม่จึงยิ่งสนับสนุนคำทำนายเดิม วิธีตรวจคือเก็บผลจริงจากแหล่งอิสระ สุ่มตรวจ และติดตามการโอนข้ามคิว ไม่ใช้การยอมรับคำแนะนำเป็น Ground Truth โดยตรง
ข้อจำกัด ความเสี่ยง และบทบาทมนุษย์ที่ต้องออกแบบ
โมเดลไม่รู้เป้าหมายองค์กรด้วยตนเอง มันไม่รู้ว่าความล่าช้าของเคสหนึ่งสำคัญกว่าความแม่นเฉลี่ย และไม่รับผิดชอบต่อผลกระทบทางกฎหมายหรือความเป็นธรรม มนุษย์จึงต้องกำหนดสิ่งที่นับว่าเป็นความสำเร็จ เลือกข้อมูล อนุมัติขอบเขต และเป็นเจ้าของเมื่อผลลัพธ์เริ่มเสื่อม
ความเสี่ยงด้านความเป็นธรรมอาจเกิดเมื่อรูปแบบภาษา ช่องทาง หรือประวัติลูกค้าสัมพันธ์กับกลุ่มคนบางกลุ่ม ระบบอาจทำให้กลุ่มหนึ่งถูกจัดลำดับต่ำอย่างสม่ำเสมอ แม้ไม่ได้ใช้คุณลักษณะอ่อนไหวโดยตรง การตรวจต้องดูผลแยกกลุ่มและกลไกของ Proxy ไม่ใช่เพียงลบคอลัมน์ที่ดูอ่อนไหว
ความเสี่ยงด้านความเป็นส่วนตัวเกิดตั้งแต่การรวบรวม การฝึก การส่งข้อมูลไปยังผู้ให้บริการ การบันทึก Log ไปจนถึงหน้าจอของผู้ตรวจ ต้องใช้ข้อมูลเท่าที่จำเป็น จำกัดสิทธิ์ และกำหนดอายุข้อมูล หากต้องใช้ข้อความจริงในการทดสอบ ควรมีแผนลดหรือปกปิดข้อมูลส่วนบุคคลตามบริบท
การอธิบายต้องเหมาะกับคนที่ใช้ผล ไม่จำเป็นต้องแสดงรายละเอียดทางคณิตศาสตร์ทั้งหมด เจ้าหน้าที่ต้องเห็นหลักฐานที่ช่วยตรวจว่าหมวดเหมาะหรือไม่ ผู้ดูแลระบบต้องเห็นข้อมูลเวอร์ชันและความผิดปกติ ผู้บริหารต้องเห็นผลลัพธ์และความเสี่ยง ส่วนผู้ได้รับผลควรรู้ช่องทางขอแก้หรืออุทธรณ์เมื่อการตัดสินใจสำคัญ
มนุษย์ต้องอยู่ตรงไหน
- ก่อนสร้าง: ยืนยันโจทย์ สิทธิ์ข้อมูล Baseline และผู้ได้รับผล
- ระหว่างพัฒนา: ตรวจป้าย ตัวอย่างผิด กลุ่มที่หาย และ Metric
- ระหว่างใช้: แก้ Output ส่งต่อ และหยุดเคสเสี่ยง
- หลังเกิดผล: ตรวจ Outcome รับเรื่องร้องเรียน และแยก Feedback จากการยอมตาม
- ระดับองค์กร: ตัดสินใจขยาย จำกัด หยุด หรือเลิกระบบ พร้อมเจ้าของที่ชัดเจน
Pilot ต้องตอบสมมติฐาน ไม่ใช่แค่สร้าง Demo
Pilot ที่ดีเป็นการทดลองเพื่อเรียนรู้ภายใต้ความเสียหายจำกัด ก่อนเริ่มต้องเขียนสมมติฐาน เช่น “ระบบจัดคิวแบบผสมจะลดเวลาถึงทีมแรกโดยไม่เพิ่มอัตราพลาดเคสเร่งด่วนและไม่เพิ่มภาระตรวจเกินกำลังคน” ประโยคนี้บอกทั้งคุณค่าและความเสี่ยงที่ต้องวัด
เก็บ Baseline
วัดวิธีเดิมในช่วงเวลาที่เป็นตัวแทน แยกตามคิว ภาษา ช่องทาง และความรุนแรง พร้อมบันทึกนิยาม Metric ให้ทำซ้ำได้
เริ่ม Offline
ทดสอบกับข้อมูลที่แยกจากการฝึก เปรียบเทียบกับกฎและวิธีเดิม ตรวจ Leakage, Calibration และความผิดพลาดเชิงต้นทุน
ใช้ Shadow Mode
ให้ระบบรับข้อมูลจริงและสร้างคำแนะนำ แต่ยังไม่เปลี่ยนเส้นทางงาน เปรียบเทียบกับการตัดสินจริงและตรวจภาระระบบ
เป็น Decision Support
แสดงคำแนะนำกับหลักฐาน ให้คนแก้ได้ เก็บเหตุผล Override และจำกัดคิวที่อนุญาตตามระดับความเสี่ยง
กำหนด Go/No-Go
ตั้งเกณฑ์ขยาย ปรับ หรือหยุดล่วงหน้า ห้ามเปลี่ยนเกณฑ์หลังเห็นผลเพียงเพื่อให้ Pilot ดูสำเร็จ
ติดตามและย้อนกลับ
มี Dashboard, Incident Path, เวอร์ชันโมเดล และวิธีกลับสู่วิธีเดิมเมื่อข้อมูลหรือผลลัพธ์ผิดปกติ
ขอบเขตเล็กไม่ได้หมายถึงเลือกเฉพาะเคสง่ายจนไม่เป็นตัวแทน Pilot ควรครอบคลุมความหลากหลายที่จำเป็นต่อข้อสรุป แต่จำกัดการกระทำที่ย้อนกลับยาก เช่น เริ่มจากแนะนำคิว ไม่เริ่มจากส่งคำตอบอัตโนมัติหรือปฏิเสธสิทธิ์ลูกค้า
Checklist ความพร้อมก่อนอนุมัติให้ทดลอง
- ปัญหา: ระบุผู้ใช้ การกระทำ และ Outcome ที่ต้องการเปลี่ยนได้ในหนึ่งประโยค
- ทางเลือก: เปรียบเทียบการปรับกระบวนการ กฎ ซอฟต์แวร์ AI และระบบผสมด้วยเกณฑ์เดียวกัน
- ข้อมูล: ยืนยันว่าข้อมูลมีในเวลาตัดสินใจ มีสิทธิ์ใช้ และครอบคลุมกลุ่มสำคัญ
- ผลจริง: มีวิธีเก็บ Ground Truth หรือ Feedback ที่ไม่ใช่การยอมตามคำแนะนำ
- Baseline: วัดวิธีเดิมด้วยนิยาม Metric และช่วงเวลาเดียวกับ Pilot
- ความผิดพลาด: ทำ Cost Matrix และระบุเคสที่ต้องส่งคนหรือห้ามอัตโนมัติ
- คนและคิว: คำนวณกำลัง Human Review และให้สิทธิ์ Override/Stop จริง
- ความปลอดภัย: จำกัดข้อมูล สิทธิ์เข้าถึง Log และผู้ให้บริการภายนอก
- เกณฑ์ตัดสิน: มี Go/No-Go, Stop Rule, เจ้าของ และแผนย้อนกลับ
- การติดตาม: รู้ว่าใครตรวจ Drift, Incident, Outcome และข้อร้องเรียนหลังเปิดใช้
ถ้าข้อใดตอบไม่ได้ ให้ตีความว่าเป็นข้อมูลสำหรับออกแบบงานต่อ ไม่ใช่สัญญาณว่าต้องยกเลิก AI เสมอ แต่ห้ามข้ามช่องว่างแล้วใช้ความแม่นของ Demo แทนหลักฐานความพร้อม
ความเข้าใจผิดที่ทำให้เริ่มโครงการผิดจุด
“มีข้อมูลเยอะ แปลว่าเหมาะกับ AI”
กลไกที่ทำให้คิดเช่นนั้น: จำนวนข้อมูลมองเห็นง่ายกว่าคุณภาพและความสัมพันธ์กับการตัดสินใจ สิ่งที่ถูกต้อง: ข้อมูลต้องมีในเวลาจริง แทนประชากรเป้าหมาย มีป้ายที่น่าเชื่อถือ และมีสิทธิ์ใช้ วิธีตรวจ: ทำ Data Timeline และสุ่มตรวจตัวอย่างตามกลุ่ม
“โมเดลแม่นที่สุดคือทางออกดีที่สุด”
กลไกที่ทำให้คิดเช่นนั้น: Benchmark ให้ตัวเลขเดียวที่เปรียบเทียบง่าย สิ่งที่ถูกต้อง: ทางออกต้องชนะ Baseline ใน Workflow และ Outcome ภายใต้ Guardrail วิธีตรวจ: วัดสามชั้นและรวมต้นทุนคน ระบบ และความผิดพลาด
“เริ่มจาก Chatbot แล้วค่อยหา Use Case”
กลไกที่ทำให้คิดเช่นนั้น: รูปแบบผลิตภัณฑ์มองเห็นและ Demo ได้เร็ว สิ่งที่ถูกต้อง: Interface ไม่ใช่ Problem Statement วิธีตรวจ: ลบชื่อเทคโนโลยีออกแล้วดูว่ายังอธิบายผู้ใช้ การตัดสินใจ และผลที่ต้องการได้หรือไม่
“มีคนตรวจทุกเคสจึงปลอดภัย”
กลไกที่ทำให้คิดเช่นนั้น: การมีคนอยู่ในแผนภาพดูเหมือนควบคุมได้ สิ่งที่ถูกต้อง: คนต้องมีเวลา หลักฐาน อำนาจ และ Feedback ที่ใช้ได้ วิธีตรวจ: ทดสอบคิวจริง วัด Override และจำลองเหตุที่ต้องหยุด
“Pilot สำเร็จจึงขยายได้ทันที”
กลไกที่ทำให้คิดเช่นนั้น: ทีมอยากเปลี่ยนผลทดลองเป็นความคืบหน้า สิ่งที่ถูกต้อง: Pilot ให้หลักฐานภายใต้ขอบเขตหนึ่ง การขยายเปลี่ยนปริมาณ ผู้ใช้ และความเสี่ยง วิธีตรวจ: ระบุเงื่อนไขที่ข้อสรุปยังใช้ได้และเพิ่มขอบเขตทีละขั้น
ลงมือทำ: เปลี่ยน “อยากใช้ AI” ให้เป็นโจทย์ที่ทดสอบได้
ใช้เวลา 30–45 นาที เลือกงานจริงหนึ่งงาน อย่าเริ่มจากชื่อเครื่องมือ หากไม่มีงานในองค์กร ให้ใช้กรณีอีเมลบริการลูกค้าของบทเรียนนี้
1. ผู้ใช้และการกระทำ
เขียนว่าใครกำลังทำงาน ตัดสินใจอะไร และใครได้รับผล หลีกเลี่ยงคำกว้างอย่าง “เพิ่มประสิทธิภาพ”
2. Input ณ เวลาตัดสินใจ
ลิสต์เฉพาะข้อมูลที่มีอยู่จริงก่อนตัดสินใจ พร้อมที่มา ความสดใหม่ และสิทธิ์ใช้
3. Output และการนำไปใช้
ระบุรูปแบบ Output และการกระทำถัดไป หากไม่มีใครใช้ Output ให้หยุดและทบทวนโจทย์
4. ผลจริงและ Baseline
บอกว่าจะรู้ภายหลังได้อย่างไรว่าถูก วัดวิธีเดิมอย่างไร และต้องดีขึ้นเท่าไรจึงมีความหมาย
5. Failure และ Guardrail
เขียนความผิดพลาดสองทิศ ใครรับผล อะไรห้ามแย่ลง และเงื่อนไขใดต้องส่งคนหรือหยุด
6. ทางเลือกและ Pilot
เทียบอย่างน้อยสามทางเลือก แล้ววางขั้น Offline → Shadow → Decision Support พร้อม Go/No-Go
แม่แบบหนึ่งประโยค
“ช่วย [ผู้ใช้] ทำ [การตัดสินใจ/งาน] จาก [ข้อมูลที่มีในเวลานั้น] เพื่อเปลี่ยน [Outcome] จาก Baseline [ค่าเดิม] เป็น [เป้าหมาย] โดยไม่ทำให้ [Guardrail] แย่ลง และส่งต่อมนุษย์เมื่อ [เงื่อนไข]”
หลักฐานว่าทำสำเร็จ
ผู้ร่วมงานอีกคนอ่านแล้วสามารถบอกได้ว่า Output ถูกนำไปทำอะไร วิธีเดิมคืออะไร ความผิดพลาดแบบใดแพงกว่า และ Pilot จะหยุดเมื่อใด โดยไม่ต้องเดาชื่อโมเดล
คำถาม Why/How
เหตุใดข้อมูลแต่ละฟิลด์จึงช่วยการตัดสินใจ? ถ้าตัดฟิลด์นั้นออกจะเกิดอะไร? ทำไมทางเลือก AI จึงคุ้มกว่ากฎหรือการปรับกระบวนการ? ใครเป็นผู้รับผิดชอบเมื่อผลลัพธ์เริ่มเสื่อม?
Recovery Step
ถ้ายังเขียนไม่ได้ ให้กลับไปสังเกต Workflow จริงหนึ่งรอบ คุยกับคนทำงาน เก็บตัวอย่างความผิดพลาด 10–20 เคส และวัด Baseline เล็ก ๆ ก่อน อย่าเติมคำตอบจากการคาดเดาเพื่อให้ Worksheet ดูครบ
แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบให้ครบแล้วกด “ตรวจคำตอบ” ระบบจะแสดงคะแนนรวม เฉลย และเหตุผลรายข้อ หากเว้นไว้จะบอกจำนวนข้อที่ยังไม่ได้ตอบ คุณสามารถกด “ทำแบบทดสอบใหม่” เพื่อเริ่มอีกครั้ง
สรุป: โจทย์ชัดทำให้ทั้งคุณค่าและความเสี่ยงวัดได้
ย้อนกลับไปที่กล่องอีเมล 1,200 ฉบับ หากทีมเริ่มจากคำว่า “ทำ Chatbot” ทีมอาจได้หน้าจอสวยแต่ยังมีคิวรอเหมือนเดิม เมื่อเริ่มจากการตัดสินใจ เรากลับเห็นคำถามที่สำคัญกว่า: เจ้าหน้าที่ต้องส่งข้อความไปไหน ใช้ข้อมูลอะไรในเวลานั้น รู้ผลจริงเมื่อใด และความผิดพลาดแบบใดห้ามเกิด
Mental Model ที่ควรจำคือ งานจริง → กรอบปัญหาหกส่วน → เปรียบเทียบทางเลือก → Pilot ที่ย้อนกลับได้ → วัดผลและเรียนรู้ AI เป็นหนึ่งในทางเลือกตรงกลาง ไม่ใช่จุดเริ่มหรือคำตอบล่วงหน้า
ถ้าคุณเขียน Problem Statement ได้ครบ เปรียบเทียบทางเลือกด้วยเกณฑ์เดียว ตรวจข้อมูลตามเวลา วัด Model–Workflow–Outcome และกำหนด Guardrail, Human Review กับ Stop Rule ได้ คุณพร้อมตัดสินใจอย่างมีหลักฐานว่าปัญหานั้นเหมาะกับ AI หรือไม่
ภาพสรุป: จากปัญหายุ่งเหยิงสู่การทดลองที่ควบคุมได้
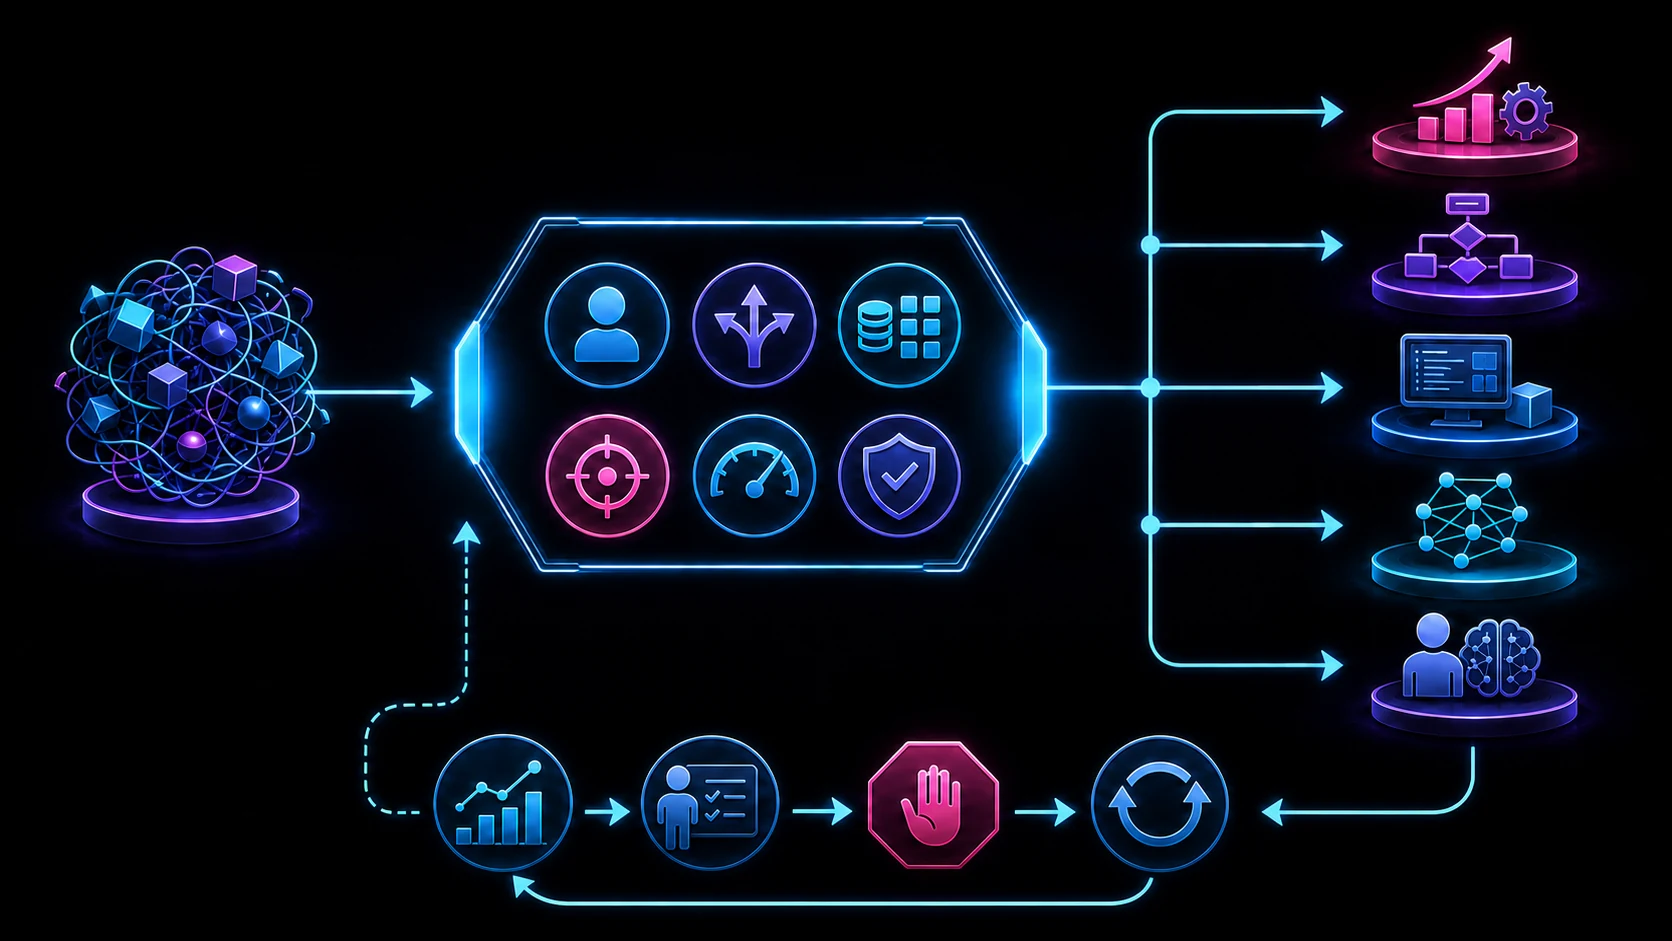
สิ่งที่ควรสังเกต: เส้นทางด้านขวาไม่ได้จบที่ AI เพราะการปรับกระบวนการ กฎ ซอฟต์แวร์ทั่วไป และระบบผสมอาจเหมาะกว่า ส่วนวงจรด้านล่างย้ำว่า Pilot ต้องย้อนกลับได้และใช้หลักฐานกลับไปแก้ Problem Framing ไม่ใช่เพียงสะสมคะแนนโมเดล
เรียนต่ออย่างมีทิศทาง
บทถัดไปจะพาแยกปัญหา AI ออกจากระบบอัตโนมัติทั่วไปให้ชัดขึ้น เพื่อให้คุณเลือกได้ว่าตรงไหนต้องเรียนรู้จากข้อมูล และตรงไหนใช้กฎหรือซอฟต์แวร์ธรรมดาก็พอ
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงและหมายเหตุบรรณาธิการ
- Google for Developers — ML Problem Framing
- Google for Developers — Managing ML Projects
- NIST — Artificial Intelligence Risk Management Framework (AI RMF 1.0)
- NIST AI RMF Playbook — Govern, Map, Measure, Manage
- OECD — AI Principles
ตรวจข้อเท็จจริงและทบทวนภาษาไทย: 9 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 27 · PATH 01 · กรณีอีเมลเป็นสถานการณ์สมมติเพื่อการอธิบาย ตัวเลขและเกณฑ์ในตัวอย่างไม่ใช่ผลทดสอบขององค์กรจริง
