บทก่อนหน้าช่วยให้เห็นเส้นทางความเสียหายจาก AI บทนี้จะถามต่อว่า “คนต้องอยู่ตรงไหนจึงหยุดหรือเปลี่ยนเส้นทางนั้นได้จริง”
ลูกค้าขอคืนเงินเพราะได้รับสินค้าผิด แต่ระบบ AI ขึ้นคำเตือนว่า “เสี่ยงทุจริต” พนักงานเห็นคะแนนสูง มีคิวรออีกหลายร้อยรายการ และมีปุ่มให้เลือกเพียง “ยืนยันตามระบบ” กับ “ส่งกลับ” ถ้าพนักงานไม่มีรูปถ่ายสินค้า ประวัติการจัดส่ง หรืออำนาจอนุมัติคืนเงิน เขาอยู่ในวงจรจริงหรือเป็นเพียงคนที่ช่วยให้ระบบดูน่าเชื่อถือ?
คำตอบสั้น: Human-in-the-loop ไม่ได้แปลว่าแค่มีคนปรากฏใน Workflow มนุษย์ต้องเห็นหลักฐานที่จำเป็น มีเวลาคิด มีความสามารถเปลี่ยนหรือหยุดผล และมีช่องทางส่งผลจริงกลับไปแก้กฎ คิว หรือโมเดล ถ้าขาดองค์ประกอบเหล่านี้ จุดอนุมัติอาจเป็นตราประทับของระบบอัตโนมัติมากกว่าการกำกับโดยมนุษย์
บทเรียนนี้จะเดินตามคำขอคืนเงินสมมติหนึ่งรายการตั้งแต่เข้าระบบจนจบ เพื่อดูว่า AI ส่งอะไรให้คน คนเพิ่มบริบทอะไรได้ จุดใดควรอัตโนมัติ จุดใดต้องส่งต่อ และจะรู้ได้อย่างไรว่าวงจรนี้ช่วยลดความผิดพลาดจริง ไม่ใช่เพียงย้ายภาระจากโมเดลไปให้พนักงาน
อ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบาย Human-in-the-loop, Human-on-the-loop และ Human-out-of-the-loop ด้วยบทบาท อำนาจ และจังหวะการตัดสินใจที่ต่างกันได้
- วาดวงจร Input → AI Process → Output → Human Decision → Real Outcome → Feedback และระบุจุดที่มนุษย์เปลี่ยนผลได้
- ตรวจจุดอนุมัติด้วยหลักฐาน เวลา อำนาจ ความรับผิดชอบ และกำลังคน โดยไม่หลงคำว่า “มีคนตรวจแล้ว”
- อธิบาย Automation Bias, Algorithm Aversion และ Alert Fatigue พร้อมออกแบบมาตรการลดความเสี่ยงจากกลไกเหล่านี้ได้
- ออกแบบ Escalation, Override, Stop Rule, Audit และ Feedback ที่ตรวจสอบย้อนหลังและนำไปปรับระบบได้
Human-in-the-loop คืออะไร เมื่อคำว่า “คนตรวจ” ยังไม่พอ
ลองนึกถึง AI เป็นผู้ช่วยที่อ่านคำขอจำนวนมากแล้วชี้ว่าเรื่องใดดูปกติ เรื่องใดน่าสงสัย และเรื่องใดไม่แน่ใจ ผู้ช่วยคนนี้ทำงานเร็ว เห็นรูปแบบจากข้อมูลจำนวนมาก และช่วยลดงานซ้ำได้ แต่เขาไม่รู้ทุกบริบท ไม่เห็นเหตุผลที่ไม่ได้อยู่ในข้อมูล และไม่ใช่ผู้รับผิดชอบต่อคนที่ได้รับผล Human-in-the-loop จึงเป็นการออกแบบให้มนุษย์เข้ามาใช้บริบท ตรวจหลักฐาน และตัดสินใจในจุดที่ความผิดพลาดมีความหมาย
คำว่า “Loop” สำคัญพอ ๆ กับคำว่า “Human” เพราะวงจรไม่ได้จบเมื่อคนกดปุ่ม การตัดสินของคน เหตุผลที่ใช้ ผลจริงหลังตัดสิน การอุทธรณ์ และเหตุผิดพลาดควรถูกเก็บอย่างมีโครงสร้างแล้วกลับไปปรับระบบ หากข้อมูลเหล่านี้หายไป คนอาจแก้ผลเฉพาะหน้าได้ แต่ระบบจะทำผิดรูปแบบเดิมต่อไป และทีมจะไม่รู้ว่าความผิดพลาดเกิดจากข้อมูล กฎ Threshold หน้าจอ หรือภาระงาน
ในความหมายที่ใช้งานได้ จุด Human-in-the-loop ต้องตอบได้อย่างน้อยหกคำถาม: ใครเป็นคนตรวจ เขาเห็นหลักฐานอะไร ต้องตัดสินภายในเวลาเท่าไร เปลี่ยนผลได้แค่ไหน ส่งต่อเมื่อใด และผลหลังการตัดสินกลับไปปรับอะไร ถ้าคำตอบคือ “เจ้าหน้าที่คนใดก็ได้ เห็นเพียงคะแนน ต้องรีบกดตามคิว และแก้ได้แค่เลือกเหตุผลสำเร็จรูป” เรามีมนุษย์อยู่บนหน้าจอ แต่ยังไม่มีการกำกับที่มีความหมาย
แบบจำลองที่ควรจำ: AI เสนอหรือจัดเส้นทาง มนุษย์เพิ่มบริบทและรับผิดชอบ ผลจริงตรวจทั้งสองฝ่าย แล้ว Feedback ปรับวงจรรอบต่อไป
สามรูปแบบหลัก: In-the-loop, On-the-loop และ Out-of-the-loop
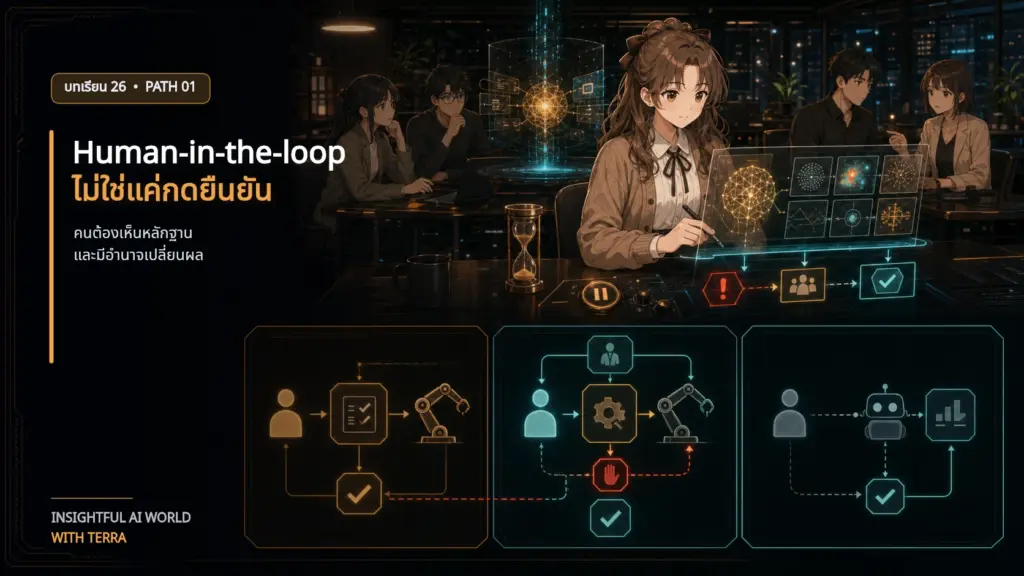
คำสามคำนี้ไม่มีเส้นแบ่งสากลที่แข็งตายตัวในทุกองค์กร จึงควรอ่านจาก “ใครทำอะไร เมื่อใด และเปลี่ยนผลได้หรือไม่” มากกว่าจำชื่อ Human-in-the-loop หมายถึงคนตัดสินหรืออนุมัติก่อนการกระทำสำคัญ Human-on-the-loop หมายถึงระบบทำงานไปก่อนแต่คนเฝ้าระวัง แทรกแซง และหยุดได้ ส่วน Human-out-of-the-loop หมายถึงระบบจัดการกรณีนั้นโดยไม่ต้องมีคนตรวจทีละรายการ แต่มนุษย์ยังต้องกำหนดขอบเขต ตรวจประสิทธิภาพ และรับผิดชอบระดับระบบ
| รูปแบบ | จังหวะของมนุษย์ | อำนาจที่ต้องมี | เหมาะเมื่อ | ความเสี่ยงหากออกแบบผิด |
|---|---|---|---|---|
| Human-in-the-loop | ก่อนผลสำคัญถูกนำไปใช้ | ขอข้อมูลเพิ่ม แก้ ปฏิเสธ ส่งต่อ หรือหยุด | ผลกระทบสูง กรณีก้ำกึ่ง หลักฐานไม่ครบ หรือย้อนกลับยาก | กลายเป็น Rubber Stamp เพราะคิวล้นหรือเห็นแต่คะแนน |
| Human-on-the-loop | เฝ้าระวังขณะระบบทำงาน | เปลี่ยน Threshold จำกัดขอบเขต Pause และ Rollback | งานเร็ว ปริมาณมาก แต่มีสัญญาณเตือนและหยุดได้ทัน | คนตอบสนองไม่ทันหรือชินกับ Alarm จนมองข้ามเหตุจริง |
| Human-out-of-the-loop | กำกับก่อนใช้และตรวจย้อนหลังเป็นรอบ | กำหนดนโยบาย Audit ปิดระบบ และเยียวยา | ผลกระทบต่ำ กฎชัด ย้อนกลับง่าย และมีหลักฐานรองรับมาก | ขยายอัตโนมัติไปยังกรณีใหม่โดยไม่มีคนเห็นผลกระทบ |
ระบบเดียวใช้หลายโหมดได้ ในร้านค้าออนไลน์ คำขอคืนเงินมูลค่าต่ำที่หลักฐานครบอาจทำงานอัตโนมัติ คำขอที่รูปถ่ายกับข้อมูลจัดส่งขัดกันอาจส่งพนักงานตรวจ และการเพิ่มขึ้นผิดปกติของการปฏิเสธในบางพื้นที่อาจให้ทีมเฝ้าระวังหยุดกฎทั้งชุด การเลือกโหมดจึงเป็นการจัดสรรความสนใจของมนุษย์ตามความเสี่ยง ไม่ใช่การประกาศว่าทั้งระบบ “มีคน” หรือ “ไม่มีคน” เพียงแบบเดียว
หลักตัดสินที่ใช้ได้คือดูสี่แกนพร้อมกัน: ความรุนแรงหากผิด ความสามารถย้อนกลับ ความไม่แน่นอนของหลักฐาน และเวลาที่มีให้แทรกแซง ยิ่งผลเสียสูง ย้อนกลับยาก หลักฐานกำกวม และมีเวลาพอให้ตรวจ ยิ่งมีเหตุผลส่งกรณีเข้าจุด Human-in-the-loop หากผลเสียต่ำ ย้อนกลับได้ และเงื่อนไขชัด เราอาจใช้อัตโนมัติแล้วสุ่ม Audit แทน เพื่อไม่ให้ทีมใช้เวลาตรวจสิ่งที่ไม่เพิ่มคุณค่า
กรณีศึกษาหลัก: คำขอคืนเงินหนึ่งรายการเดินผ่านระบบอย่างไร
กรณีนี้เป็นสถานการณ์สมมติเพื่อการอธิบาย ลูกค้าซื้อเครื่องใช้ไฟฟ้าชิ้นเล็กจากร้านค้าออนไลน์ เมื่อเปิดกล่องพบว่าสินค้าผิดรุ่น จึงอัปโหลดรูปสินค้า รูปฉลาก และข้อความขอคืนเงิน ระบบมีโมเดลคัดกรองการทุจริตซึ่งใช้ประวัติคำขอ มูลค่าสินค้า ความสอดคล้องของรูป เส้นทางจัดส่ง และรูปแบบบัญชีเพื่อเสนอระดับความเสี่ยง เป้าหมายของระบบไม่ใช่ตัดสินว่าลูกค้าโกง แต่ช่วยจัดคิวและบอกว่ากรณีใดควรดูหลักฐานเพิ่ม
Input ที่ระบบเห็นและสิ่งที่ระบบอาจมองไม่เห็น
อินพุตประกอบด้วยเลขคำสั่งซื้อ เวลาและสถานะจัดส่ง รูปภาพที่ลูกค้าส่ง ประวัติคืนสินค้า มูลค่า และสัญญาณจากบัญชี โมเดลอาจเห็นว่าบัญชีเพิ่งสร้างและภาพไม่ตรงกับรูปสินค้าในแคตตาล็อก จึงให้คะแนนเสี่ยงสูง แต่โมเดลอาจไม่รู้ว่าร้านเพิ่งเปลี่ยนบรรจุภัณฑ์ คลังสินค้าติดฉลากผิด หรือภาพแคตตาล็อกยังไม่อัปเดต บริบทเหล่านี้อยู่ในระบบคลัง ข้อร้องเรียนจากลูกค้ารายอื่น หรือความรู้ของเจ้าหน้าที่ ไม่ได้อยู่ในฟีเจอร์ของโมเดล
Process และ Output ที่ควรเป็นคำแนะนำ
โมเดลแปลงอินพุตเป็นสัญญาณ เปรียบเทียบกับรูปแบบในข้อมูลฝึก แล้วส่งออกคะแนนพร้อมเหตุผลระดับสัญญาณ เช่น บัญชีใหม่ รูปไม่ตรง และมีการขอคืนภายในเวลาสั้น Output ที่เหมาะคือ “ส่งตรวจพร้อมสัญญาณสามข้อ” ไม่ใช่ “ลูกค้าทุจริต” เพราะคะแนนเป็นค่าประมาณจากข้อมูลและวัตถุประสงค์ของโมเดล การเปลี่ยนค่าประมาณให้เป็นคำตัดสินทางศีลธรรมหรือข้อเท็จจริงทำให้หน้าจอนำผู้ตรวจไปไกลกว่าหลักฐาน
Human Decision ที่เพิ่มบริบท
พนักงานเปิดดูรูปต้นฉบับ ประวัติการจัดส่ง ข้อมูลการเปลี่ยนแพ็กเกจ และคำขอคล้ายกันในวันเดียวกัน เขาพบว่ามีลูกค้าหลายรายรายงานรุ่นผิดจากคลังเดียวกัน จึงอนุมัติคืนเงิน เปลี่ยนเหตุผลจาก “ความเสี่ยงลูกค้า” เป็น “ตรวจพบความผิดพลาดของคลัง” ส่ง Incident ให้ทีมปฏิบัติการ และระงับกฎที่ผลักกรณีจากคลังนี้ไปคิวทุจริต นี่คือการเปลี่ยนเส้นทางของงาน ไม่ใช่เพียงยืนยันหรือปฏิเสธคะแนน
Real Outcome, Baseline และ Metric
ผลจริงที่ควรติดตามไม่ใช่เพียงอัตราที่พนักงานเห็นด้วยกับ AI แต่รวมเวลารอ การคืนเงินที่ถูกต้อง การปฏิเสธที่ถูกกลับผลภายหลัง จำนวนการอุทธรณ์ เหตุจากคลัง ความผิดพลาดแยกตามประเภทสินค้า และภาระงานของผู้ตรวจ Baseline คือกระบวนการเดิมก่อนใช้โมเดล เช่น เวลาตรวจเฉลี่ย คุณภาพการคืนเงิน และจำนวนข้อร้องเรียน การเปรียบเทียบกับ Baseline ช่วยตอบว่า AI เพิ่มคุณค่าแก่ทั้งลูกค้าและทีมจริงหรือเพียงทำให้หน้า Dashboard ดูเร็วขึ้น
Failure Mode และเงื่อนไขที่ทำให้ข้อสรุปเปลี่ยน
ถ้าหน้าจอแสดงคะแนนใหญ่กว่าหลักฐาน พนักงานอาจเชื่อตาม ถ้าคิวเพิ่มแต่กำลังคนเท่าเดิม เขาอาจกดยืนยันเพื่อให้ทัน SLA ถ้าการ Override ถูกนับเป็นผลงานลบ เขาอาจมีปุ่มแต่ไม่มีอำนาจจริง และถ้าผลการกดถูกใช้เป็นป้ายกำกับใหม่ทันที โมเดลอาจเรียนรู้ความเอนเอียงของพนักงาน เงื่อนไขเหล่านี้ทำให้ระบบที่ดูเป็น Human-in-the-loop บนแผนภาพกลายเป็นระบบอัตโนมัติที่ใช้คนรับผิดแทน
วงจรการตัดสินใจหกขั้นที่คนเปลี่ยนผลและระบบเรียนรู้ได้
กำหนดการกระทำและความเสียหายก่อนดูโมเดล
รับเข้า: งานคืนเงิน วิธีเดิม ผู้ได้รับผล และความเสียหายหากอนุมัติหรือปฏิเสธผิด กระบวนการ: แยก “จัดคิว” ออกจาก “ตัดสิน” แล้วกำหนดสิ่งที่ AI ห้ามทำ ส่งออก: ขอบเขตและ Baseline วิธีตรวจ: ทุกฝ่ายตอบได้ว่าผลใดเกิดกับลูกค้าจริง จุดพลาด: เริ่มจากคำถามว่าใช้โมเดลอะไร ย้อนกลับ: ลดขอบเขตเหลือ Shadow Mode หากยังอธิบายความเสียหายไม่ได้
รวบรวม Input พร้อมที่มาและความสดใหม่
รับเข้า: รูปสินค้า ข้อมูลจัดส่ง ประวัติคำขอ และข้อมูลคลัง กระบวนการ: ตรวจสิทธิ์ แหล่ง วันที่ คุณภาพ และสิ่งที่ขาด ส่งออก: Evidence Pack ที่ระบุที่มา วิธีตรวจ: สุ่มเทียบกับต้นฉบับ จุดพลาด: ถือว่าข้อมูลในฐานเป็นความจริงล่าสุดเสมอ ย้อนกลับ: ขอข้อมูลเพิ่มหรือหยุดใช้ฟีเจอร์ที่ไม่น่าเชื่อถือ
ให้ AI สร้างคำแนะนำที่เห็นความไม่แน่นอน
รับเข้า: ข้อมูลที่ผ่านการตรวจ กระบวนการ: ประเมินสัญญาณและจัดระดับความเสี่ยง ส่งออก: คะแนน ช่วงความไม่แน่นอน เหตุผลระดับสัญญาณ และเงื่อนไขส่งต่อ วิธีตรวจ: เทียบชุดทดสอบและกรณียาก จุดพลาด: ใช้คะแนนเดียวแทนหลักฐาน ย้อนกลับ: ปรับ Threshold หรือบังคับตรวจเมื่อข้อมูลสำคัญหาย
ให้มนุษย์ตรวจ เปลี่ยนผล และบันทึกเหตุผล
รับเข้า: ต้นฉบับ คำแนะนำ และบริบทนอกโมเดล กระบวนการ: ตรวจความขัดแย้ง ขอข้อมูลเพิ่ม แก้ ปฏิเสธ หรือส่งผู้เชี่ยวชาญ ส่งออก: การตัดสินที่มีเจ้าของและเหตุผล วิธีตรวจ: Second Review และสุ่ม Blind Audit จุดพลาด: กดตาม AI เพราะเวลาไม่พอ ย้อนกลับ: หยุดคิว ลด Alert และเพิ่มทรัพยากร
ติดตามผลจริงและเปิดทางแก้ไข
รับเข้า: ผลคืนเงิน การอุทธรณ์ ข้อร้องเรียน และเหตุจากคลัง กระบวนการ: เชื่อมคำตัดสินกับผลหลังใช้งานโดยไม่ลบประวัติเดิม ส่งออก: Ground Truth ที่ผ่านการตรวจและ Incident Record วิธีตรวจ: เทียบหลายแหล่งและสุ่มอ่านเคส จุดพลาด: ถือว่าการไม่อุทธรณ์แปลว่าตัดสินถูก ย้อนกลับ: สืบหาคนอาจเข้าไม่ถึงช่องทางอุทธรณ์
ปรับกฎ โมเดล หน้าจอ และ Workflow อย่างมีเวอร์ชัน
รับเข้า: Error Pattern ภาระงาน และผลจริง กระบวนการ: แยกว่าปัญหาเกิดจากข้อมูล โมเดล Threshold UI นโยบาย หรือกำลังคน ส่งออก: การเปลี่ยนแปลงที่มีเจ้าของ วันเริ่ม และ Rollback วิธีตรวจ: ทดลองแบบจำกัดขอบเขต จุดพลาด: ฝึกโมเดลใหม่โดยไม่แก้กระบวนการ ย้อนกลับ: คืนเวอร์ชันและทบทวน Root Cause
มนุษย์ไม่ได้มีบทบาทเฉพาะปลายทาง แต่กำกับตลอดวงจรชีวิต
ภาพจำที่พบบ่อยคือ AI ทำงานก่อนแล้วส่งผลให้คนตรวจท้ายสุด แต่การตัดสินใจสำคัญของมนุษย์เกิดก่อนโมเดลทำงานนานมาก คนเลือกปัญหา กำหนดว่าความสำเร็จคืออะไร เลือกข้อมูล สร้างป้ายกำกับ ตั้ง Threshold และนิยามว่ากรณีใดต้องส่งต่อ หากเลือกผิดตั้งแต่ต้น ผู้ตรวจปลายทางต้องรับภาระแก้ข้อผิดพลาดเชิงโครงสร้างทีละรายการ ซึ่งไม่ยั่งยืน
ก่อนสร้าง
เจ้าของงานและผู้ได้รับผลช่วยกำหนดเป้าหมาย ขอบเขต ความเสียหาย Baseline และสิ่งที่ห้ามอัตโนมัติ เพื่อไม่ให้ทีมวัดความสำเร็จจาก Accuracy อย่างเดียว
ระหว่างพัฒนา
ผู้เชี่ยวชาญโดเมนช่วยตีความข้อมูลกำกวม ตรวจป้ายกำกับ สร้าง Failure Case และทดสอบว่าคำอธิบายบนหน้าจอสอดคล้องกับหลักฐานจริง
ระหว่างตัดสิน
ผู้ตรวจใช้ข้อมูลต้นฉบับและบริบท เลือกยืนยัน แก้ ขอข้อมูลเพิ่ม ปฏิเสธ หรือส่งต่อ โดยไม่ถูกบังคับให้ตามคำแนะนำของ AI
ระหว่างใช้งาน
ทีมปฏิบัติการดู Drift คิวล้น อัตรา Override เหตุผิดปกติ และผลแยกกลุ่ม พร้อม Pause หรือ Rollback เมื่อเกินเกณฑ์
หลังเกิดผล
ทีมบริการและผู้รับผิดชอบรับการอุทธรณ์ แก้ผลรายกรณี วิเคราะห์ Root Cause และส่งผลจริงกลับไปปรับระบบโดยไม่ซ่อนความผิดพลาดเดิม
ระดับองค์กร
ผู้บริหารกำหนดเจ้าของความเสี่ยง งบกำลังคน อำนาจหยุดระบบ และความรับผิดชอบสุดท้าย ไม่ผลักภาระให้พนักงานหน้าจอเพียงคนเดียว
NIST AI RMF เน้นให้กำหนดและแยกบทบาทของมนุษย์กับ AI ให้ชัด รวมทั้งวางโครงสร้างความรับผิดชอบและการติดตามตลอดวงจร ไม่ได้สรุปว่าทุกระบบต้องมีคนตรวจทุกผล บางงานผลกระทบต่ำอาจเหมาะกับระบบอัตโนมัติ แต่การตัดสินใจว่าจะใช้โหมดใดและเมื่อใดต้องมีเจ้าของ มีเหตุผล และทบทวนได้เมื่อบริบทเปลี่ยน
การกำกับที่มีความหมายต้องมีหลักฐาน เวลา อำนาจ และความรับผิดชอบ
คำว่า Oversight ฟังเหมือน “มีคนมองอยู่” แต่การมองโดยเปลี่ยนอะไรไม่ได้ไม่ช่วยลดความเสี่ยง เราจึงตรวจสี่ทรัพยากรที่ทำให้การกำกับเกิดผลจริง หากขาดข้อใดข้อหนึ่ง จุดตรวจจะอ่อนลงทันที และการเพิ่มการฝึกอบรมอย่างเดียวไม่ชดเชยข้อจำกัดเชิงระบบได้
หลักฐาน: เห็นสิ่งที่จำเป็นต่อคำถาม ไม่ใช่เห็นทุกข้อมูล
ผู้ตรวจคำขอคืนเงินต้องเห็นรูปต้นฉบับ แหล่งและเวลาของข้อมูล สัญญาณที่ AI ใช้ ประวัติการจัดส่ง และความขัดแย้งสำคัญ ไม่จำเป็นต้องเห็นพารามิเตอร์ทุกตัวของโมเดล แต่ต้องเห็นพอที่จะทดสอบคำแนะนำ หากหน้าจอแสดงเพียงคะแนน 92% พร้อมสีแดง ผู้ตรวจถูกผลักให้เชื่อค่าที่ตรวจไม่ได้ การอธิบายที่ดีจึงต้องช่วยให้คนถามต่อ ไม่ใช่ทำให้คำตอบของ AI ดูเด็ดขาดขึ้น
เวลา: SLA ต้องสอดคล้องกับความยากและคิว
คนที่ต้องตัดสินในสิบวินาทีท่ามกลางคิวหลายร้อยรายการไม่มีเวลาตรวจหลักฐาน แม้คู่มือจะบอกให้พิจารณาอย่างรอบคอบ การออกแบบต้องกำหนดเวลาตามระดับความเสี่ยง ลดงานซ้ำ จัดกลุ่มกรณีคล้าย และให้พักจากงานที่ต้องใช้สมาธิสูง หากธุรกิจต้องการคำตอบเร็วกว่าเวลาที่ใช้ตรวจจริง ทางเลือกคือจำกัดขอบเขตหรือปรับบริการ ไม่ใช่เรียกการกดเร็ว ๆ ว่า Human Review
อำนาจ: Override ต้องใช้ได้โดยไม่ถูกลงโทษทางอ้อม
ปุ่มแก้ผลไม่มีความหมายหากพนักงานไม่มีสิทธิ์อนุมัติ ต้องขอหัวหน้าทุกครั้ง หรือถูกวัดผลงานจากอัตราการทำตาม AI อำนาจที่แท้รวมการขอข้อมูลเพิ่ม เลื่อนการตัดสิน เปลี่ยนผล ส่งต่อผู้เชี่ยวชาญ Pause กฎ และแจ้ง Incident นโยบายต้องคุ้มครองการใช้สิทธิเหล่านี้อย่างมีเหตุผล ไม่ทำให้ผู้ตรวจเลือกระหว่างความถูกต้องกับคะแนนผลงานส่วนตัว
ความรับผิดชอบ: คนตัดสินไม่ควรถูกปล่อยให้รับผิดคนเดียว
องค์กรต้องระบุว่าใครเป็นเจ้าของโมเดล ใครเป็นเจ้าของ Workflow ใครอนุมัติ Threshold ใครดูคิว และใครเยียวยาเมื่อลูกค้าเสียประโยชน์ บันทึกควรเชื่อมเวอร์ชันโมเดล หลักฐาน คำแนะนำ การตัดสิน เหตุผล และผลจริงเข้าด้วยกัน ความรับผิดชอบจึงไม่ใช่การหาคนผิดหลังเกิดเหตุ แต่เป็นโครงสร้างที่ทำให้คนมีทรัพยากรตัดสินและระบบมีทางแก้ไข
หน้าจอที่ดีแยกคำแนะนำออกจากหลักฐาน และเปิดพื้นที่ให้คนคิด
Interface เป็นส่วนหนึ่งของโมเดลการตัดสิน ไม่ใช่เปลือกตกแต่ง ตำแหน่ง สี ลำดับข้อมูล และค่าเริ่มต้นเปลี่ยนวิธีที่คนใช้คำแนะนำได้ หากคะแนน AI อยู่ด้านบน ตัวใหญ่ สีแดง และปุ่มยืนยันถูกเน้น คนมีแนวโน้มเริ่มจากข้อสรุปของระบบแล้วค้นหลักฐานมายืนยัน แทนที่จะอ่านหลักฐานก่อนสร้างความเห็นของตนเอง นี่ทำให้ความผิดพลาดของโมเดลส่งอิทธิพลต่อมนุษย์ได้แม้พนักงานมีความรู้
สำหรับกรณีคืนเงิน หน้าจอควรแยกสี่ชั้น ชั้นแรกคือข้อเท็จจริงต้นฉบับพร้อมแหล่งและวันที่ ชั้นที่สองคือสิ่งที่ขัดแย้งหรือขาด ชั้นที่สามคือคำแนะนำของ AI พร้อมความไม่แน่นอน และชั้นที่สี่คือการกระทำของมนุษย์ ได้แก่ อนุมัติ แก้ ขอข้อมูลเพิ่ม ส่งต่อ และแจ้งเหตุ หลีกเลี่ยงคำตีตราอย่าง “คนโกง” เมื่อระบบเพียงตรวจพบรูปแบบผิดปกติ เพราะถ้อยคำทำให้ผู้ตรวจมองบุคคลผ่านข้อสรุปที่โมเดลพิสูจน์ไม่ได้
อีกวิธีลดการยึดติดคือให้ผู้ตรวจบันทึกความเห็นเบื้องต้นก่อนเปิดคำแนะนำ AI ในกรณีสำคัญ หรือสุ่มกรณีที่ AI ไม่ส่งเตือนให้ตรวจด้วย หากคนเห็นเฉพาะสิ่งที่โมเดลเลือก เขาจะไม่พบ Error แบบ Omission ซึ่งระบบพลาดเหตุจริงโดยไม่เตือน การสุ่ม Blind Review ช่วยสร้างภาพว่าทั้ง AI และคนพลาดตรงไหนโดยไม่ให้คำแนะนำฝ่ายหนึ่งกำหนดคำตอบของอีกฝ่ายตั้งแต่ต้น
วิธีตรวจ Interface แบบง่าย: ปิดคะแนน AI แล้วถามว่าผู้ตรวจยังอธิบายเหตุผลจากหลักฐานได้หรือไม่ จากนั้นเปิดคะแนนและดูว่าคำตัดสินเปลี่ยนโดยมีหลักฐานใหม่หรือเปลี่ยนเพราะตัวเลขเพียงอย่างเดียว
กำลังคนและคิว: Human Review ที่คำนวณไม่ลงตัวคือคำสัญญาที่ทำไม่ได้
การออกแบบจุดตรวจต้องเริ่มจากคณิตศาสตร์พื้นฐาน สมมติระบบส่ง 600 กรณีต่อชั่วโมง และแต่ละกรณีใช้เวลาตรวจเฉลี่ยสองนาที ภาระรวมคือ 1,200 นาทีผู้ตรวจต่อหนึ่งชั่วโมง หรือ 20 คนทำงานเต็มเวลาในชั่วโมงนั้น หากต้องเผื่อเวลาพัก กรณียาก การประชุม และงานอื่น โดยให้ผู้ตรวจใช้เวลาตรวจจริงไม่เกิน 75% ทีมต้องมีประมาณ 27 คน ไม่ใช่ห้าคน ตัวเลขนี้เป็นตัวอย่างสมมติ แต่แสดงว่า “มีคนตรวจ” ต้องพิสูจน์ด้วยอัตราเข้า เวลาบริการ และความสามารถของทีม
คิวไม่ได้ล้นเพียงเพราะคนไม่พอ แต่อาจเกิดจาก Threshold ต่ำเกินไป Alert ซ้ำ ข้อมูลหายทำให้ทุกกรณีต้องขอเพิ่ม หรือโมเดลถูกใช้กับงานกว้างเกินขอบเขต การแก้จึงมีหลายทาง: ลด Alert ที่ไม่เพิ่มคุณค่า จัดกลุ่มเหตุเดียวกัน อนุมัติอัตโนมัติเฉพาะกรณีผลกระทบต่ำ เพิ่ม Second-line reviewer สำหรับเคสยาก หรือหยุดรับกรณีใหม่เมื่อ Backlog เกินจุดปลอดภัย การเพิ่มคนอย่างเดียวอาจซ่อนปัญหาออกแบบและสร้างต้นทุนถาวร
Metric ของคิวควรรวม Arrival Rate, เวลาเฉลี่ยและช่วงกระจาย, Backlog, อายุของเคสเก่าสุด, สัดส่วนส่งต่อ, เวลาพัก, อัตราแก้ผล และคุณภาพหลังตัดสิน ดูค่าเฉลี่ยอย่างเดียวไม่พอ เพราะเคสยากอาจค้างนานแม้ค่าเฉลี่ยดูดี เมื่อคิวสูง ความผิดพลาดอาจเพิ่มจากความล้าและแรงกดดัน จึงควรกำหนด Stop Rule เช่น หยุดการปฏิเสธอัตโนมัติเมื่อคิวเกินระดับที่คนตรวจทัน และเปลี่ยนเป็นรับคำขอไว้ก่อนแทน
งานวิจัยเรื่อง Alarm และ Alert ในบริบทสุขภาพเตือนว่าการแจ้งเตือนจำนวนมาก โดยเฉพาะที่ไม่เกี่ยวข้องหรือผิดบ่อย ทำให้ผู้ใช้ตอบสนองลดลง บทเรียนไม่ได้สรุปตัวเลขจากโรงพยาบาลมาใช้กับร้านค้าโดยตรง แต่กลไกทั่วไปมีประโยชน์: ความสนใจมนุษย์มีจำกัด การเพิ่ม Alert ไม่ได้เพิ่มความปลอดภัยเสมอ และคุณภาพสัญญาณสำคัญพอ ๆ กับจำนวนคนที่มองหน้าจอ
Automation Bias, Algorithm Aversion และ Alert Fatigue ทำให้คนใช้ AI ผิดสองทิศ
Automation Bias คือแนวโน้มพึ่งคำแนะนำจากระบบมากเกินไป จนยอมรับคำแนะนำผิดหรือไม่ค้นหาสิ่งที่ระบบไม่ได้เตือน ในกรณีคืนเงิน พนักงานอาจเปลี่ยนจาก “ตรวจหลักฐาน” เป็น “หาหลักฐานสนับสนุนคะแนนสูง” เพราะระบบถูกต้องบ่อยและองค์กรนำเสนอว่าเป็นเครื่องมือแม่นยำ Error แบบ Commission เกิดเมื่อคนทำตามคำแนะนำผิด ส่วน Error แบบ Omission เกิดเมื่อคนไม่ลงมือเพราะระบบไม่เตือน ทั้งสองแบบแสดงว่าการมีคนไม่ได้ลบข้อผิดพลาดของระบบโดยอัตโนมัติ
อีกทิศคือ Algorithm Aversion หรือการไม่เชื่อระบบมากเกินไป หลังเจอความผิดพลาดที่เด่นชัด พนักงานอาจปฏิเสธคำแนะนำแม้ในกรณีที่ระบบมีหลักฐานดี การออกแบบจึงไม่ควรตั้งเป้าว่า “ทำให้คนเชื่อ AI” แต่ควรทำให้ความเชื่อสอดคล้องกับความน่าเชื่อถือในบริบทนั้น หรือเรียกว่า Calibration คนควรรู้ว่าโมเดลเก่งงานใด พลาดงานใด ข้อมูลแบบไหนอยู่นอกขอบเขต และเมื่อใดต้องพึ่งหลักฐานอื่น
Alert Fatigue เกิดเมื่อคนเผชิญการแจ้งเตือนมากหรือซ้ำจนความสนใจลดลง ระบบคืนเงินที่เตือนเกือบทุกกรณีบังคับให้พนักงานเรียนรู้ว่าการแจ้งเตือนไม่มีความหมาย ต่อให้มี Alert สำคัญจริงก็อาจถูกกดผ่าน การแก้ต้องลดสัญญาณไม่จำเป็น จัดลำดับความสำคัญ รวมเหตุที่เกี่ยวข้อง และวัดว่าคนตอบสนองอย่างไร ไม่ใช่เพียงเพิ่มสี เสียง หรือหน้าต่างขัดจังหวะซึ่งอาจทำให้ความล้ารุนแรงขึ้น
มาตรการลดอคติต้องแตะทั้งคนและระบบ ได้แก่ ฝึกด้วย Failure Case จริง แสดงข้อจำกัดของโมเดล ให้เหตุผลระดับหลักฐาน ไม่ใช้ Confidence เป็นคำรับรองความถูกต้อง สุ่ม Blind Review แยก Audit จากทีมปฏิบัติการ และวัดทั้ง Agreement กับ Correctness อัตราที่คนเห็นด้วยกับ AI สูงอาจหมายถึง AI ดี คนเชื่อเกินไป หรือพนักงานไม่มีอำนาจแก้ ต้องเชื่อมกับผลจริงก่อนตีความ
Feedback ที่เชื่อถือได้ต้องแยกคำแนะนำ การตัดสิน และผลจริงออกจากกัน
ข้อผิดพลาดอันตรายคือใช้การกดของพนักงานเป็นคำตอบจริงแล้วส่งกลับไปฝึกโมเดลทันที ถ้าพนักงานเชื่อตาม AI ป้ายกำกับใหม่จะสะท้อนคำแนะนำเดิมของโมเดล วงจรจึงขยายความผิดพลาดโดยดูเหมือนมีข้อมูลมนุษย์รับรอง เราควรเก็บอย่างน้อยสามสิ่งแยกกัน: AI แนะนำอะไร คนตัดสินอะไรและเพราะเหตุใด และภายหลังเกิดอะไรขึ้นจริง เช่น ลูกค้าส่งหลักฐานเพิ่ม คลังยืนยันแพ็กผิด หรือการอุทธรณ์กลับผล
Ground Truth ในงานจริงมักไม่สมบูรณ์ การไม่อุทธรณ์ไม่ได้แปลว่าปฏิเสธถูก ลูกค้าอาจไม่รู้ช่องทาง ไม่มีเวลา หรือเห็นว่ามูลค่าไม่คุ้ม การคืนเงินสำเร็จก็ไม่ได้พิสูจน์ว่าไม่มีการทุจริต ทีมจึงต้องใช้หลายแหล่ง เช่น ผลตรวจคลัง การติดตามพัสดุ การสุ่มติดต่อ การตรวจโดยผู้เชี่ยวชาญ และรูปแบบระยะยาว พร้อมระบุระดับความมั่นใจของป้ายกำกับ ไม่ทำให้สิ่งที่ยังไม่แน่กลายเป็นคำตอบแข็ง
Feedback ที่ดีต้องผ่านการคัดกรองก่อนนำไปเปลี่ยนระบบ แยก Error รายกรณีจาก Pattern เชิงระบบ ตรวจความขัดแย้งระหว่างผู้ตรวจ และบันทึกว่าการเปลี่ยนแปลงแก้สาเหตุใด ถ้าปัญหาเกิดจากข้อมูลคลังล้าสมัย การฝึกโมเดลใหม่อาจไม่ช่วย ถ้าปัญหาเกิดจากพนักงานไม่มีเวลา การเพิ่มฟีเจอร์อธิบายอาจเพิ่มภาระมากกว่าเดิม Root Cause จึงอาจอยู่ที่ข้อมูล โมเดล UI นโยบาย คิว หรือแรงจูงใจ
เมื่อปรับระบบ ต้องเก็บเวอร์ชัน วันเริ่ม กลุ่มที่ได้รับผล และแผน Rollback เปรียบเทียบก่อนและหลังกับ Baseline และดูผลแยกตามประเภทสินค้า ช่องทาง ภาษา พื้นที่ หรือกลุ่มผู้ใช้ที่เกี่ยวข้อง การปรับที่ทำให้ค่าเฉลี่ยดีขึ้นอาจทำให้บางกลุ่มแย่ลง หากทีมดูเฉพาะ Accuracy รวม วงจร Feedback อาจเรียนรู้ให้ระบบเก่งขึ้นตาม Metric แต่ไกลจากเป้าหมายบริการ
Escalation, Override และ Stop Rule เปลี่ยนคำว่า “คนอยู่ในวงจร” ให้เป็นการกระทำ
Escalation คือเส้นทางเมื่อผู้ตรวจคนแรกไม่ควรหรือไม่สามารถตัดสินต่อ กรณีอาจส่งต่อเพราะหลักฐานขัดแย้ง มูลค่าสูง เกี่ยวข้องกับนโยบายใหม่ มีผลกระทบซ้ำ หรือสงสัยเหตุเชิงระบบ เส้นทางต้องระบุผู้รับ เวลาตอบ ข้อมูลที่ต้องแนบ และสิ่งที่เกิดกับลูกค้าระหว่างรอ หากมีเพียงปุ่ม “ส่งต่อ” แต่ไม่รู้ว่าใครรับ คิวไหน หรือหมดเวลาเมื่อใด งานไม่ได้ปลอดภัยขึ้น เพียงย้ายความไม่แน่นอนไปอีกกล่อง
Override คือการที่มนุษย์เปลี่ยนผลจากคำแนะนำ AI แต่ต้องไม่ถูกมองว่าเป็นความผิดของพนักงานโดยอัตโนมัติ อัตรา Override สูงอาจชี้ว่าโมเดลไม่เหมาะ Threshold ผิด บริบทเปลี่ยน หรือมนุษย์ใช้ดุลยพินิจไม่สม่ำเสมอ ต้องอ่านเหตุผลและผลจริงจึงสรุปได้ ควรมีหมวดเหตุผลที่ช่วยวิเคราะห์ พร้อมช่องข้อความเมื่อกรณีไม่เข้าหมวด ห้ามบังคับเลือกเหตุผลสำเร็จรูปที่ผิดเพียงเพื่อปิดงาน
Stop Rule คือเกณฑ์ที่กำหนดล่วงหน้าว่าเมื่อใดต้อง Pause จำกัดขอบเขต หรือกลับไปวิธีเดิม ตัวอย่างสมมติ ได้แก่ Backlog เกินระดับที่ตรวจทัน อัตราปฏิเสธเพิ่มผิดปกติในประเภทสินค้าเดียว ข้อมูลต้นทางขาดเป็นวงกว้าง การอุทธรณ์กลับผลสูงเกินเกณฑ์ หรือพบ Incident ที่อาจกระทบหลายคน เกณฑ์จริงต้องมาจากความเสี่ยงและ Baseline ขององค์กร ไม่ควรคัดตัวเลขตัวอย่างไปใช้ตรง ๆ
การหยุดต้องซ้อมได้ ทีมควรรู้ว่าใครกด Pause ระบบส่วนใดหยุด ผลค้างถูกจัดการอย่างไร ผู้ใช้ได้รับแจ้งอะไร และจะย้อนกลับเวอร์ชันใด หากการหยุดต้องรอผู้บริหารหลายชั้นหรือทำให้บริการทั้งหมดล่ม คนเฝ้าระวังมีอำนาจบนกระดาษแต่ใช้ไม่ทัน เหตุการณ์จำลองและ Tabletop Exercise ช่วยพบช่องว่างก่อนเกิดเหตุจริง โดยไม่ต้องรอความเสียหายมาสอน
ข้อจำกัด ความเสี่ยง และความรับผิดชอบที่ไม่ควรโยนให้ผู้ตรวจ
Human-in-the-loop ไม่ใช่ยาวิเศษสำหรับทำให้ระบบ AI ปลอดภัย คนอาจเหนื่อย มีอคติ ขาดข้อมูล ถูกแรงกดดัน หรือไม่เห็นผลกระทบระยะยาว การเพิ่มคนลงใน Workflow อาจเพิ่มความไม่สม่ำเสมอและเวลารอ ถ้าองค์กรไม่วาง Baseline และวัดผล เราอาจไม่รู้ว่าทีม Human-AI ดีกว่าคนหรือ AI แยกกันจริงหรือไม่ NIST ชี้ว่าผลของ Human-AI interaction ขึ้นกับเงื่อนไข และบางสถานการณ์อาจขยายอคติแทนที่จะหักล้างกัน
ไม่ใช่ทุกงานต้องตรวจทีละรายการ งานปรับคุณภาพวิดีโอหรือจัดรูปแบบข้อมูลที่ผลกระทบต่ำอาจไม่ต้องมีคนอนุมัติทุกครั้ง การบังคับ Human Review ทุกจุดทำให้ความสนใจถูกใช้กับงานมูลค่าต่ำและลดความพร้อมต่อกรณีสำคัญ หลักที่เหมาะคือ Proportionality: ระดับการกำกับสอดคล้องกับผลกระทบ ความไม่แน่นอน ความสามารถย้อนกลับ และบริบท ไม่ใช่ใช้คำว่า “มนุษย์” เป็นเครื่องหมายรับรองเดียวกันทุกระบบ
ผู้ที่ได้รับผลควรมีทางรู้ว่า AI มีบทบาทอย่างไร แก้ข้อมูล ขอเหตุผล และขอทบทวนโดยผู้มีอำนาจได้เมื่อเหมาะสม OECD เน้น Human Agency และ Oversight ตามบริบท ส่วน UNESCO ย้ำว่า AI ไม่ควรแทนที่ความรับผิดชอบสุดท้ายของมนุษย์ แนวทางเหล่านี้เป็นกรอบหลักการ ไม่ใช่คำปรึกษากฎหมายเฉพาะประเทศ องค์กรต้องตรวจข้อกฎหมาย สิทธิผู้บริโภค และกฎเฉพาะอุตสาหกรรมของตนเพิ่มเติม
ความรับผิดชอบสุดท้ายอยู่กับองค์กรและบุคคลตามบทบาท ไม่ใช่กับโมเดล ผู้ตรวจหน้าจอไม่ควรถูกใช้เป็นเกราะว่า “มีคนอนุมัติแล้ว” เมื่อองค์กรตั้งคิวที่เป็นไปไม่ได้ ซ่อนข้อจำกัด หรือไม่ให้อำนาจหยุด ผู้บริหารและเจ้าของระบบต้องรับผิดชอบต่อทรัพยากร นโยบาย การเยียวยา และการตัดสินว่าจะใช้ AI ต่อหรือไม่ มนุษย์ในวงจรจึงเป็นโครงสร้างความรับผิดชอบหลายระดับ ไม่ใช่คนคนเดียวรับความเสี่ยงทั้งหมด
Checklist ก่อนเรียก Workflow ว่า Human-in-the-loop
- การกระทำชัด: ระบุว่า AI เสนอ จัดคิว หรือทำอะไร และผลใดต้องมีคนอนุมัติก่อนนำไปใช้
- หลักฐานครบ: ผู้ตรวจเห็นต้นฉบับ แหล่ง วันที่ ความขัดแย้ง และข้อจำกัดที่จำเป็นต่อคำถาม
- เวลาคำนวณได้: Arrival Rate × เวลาตรวจ สอดคล้องกับกำลังคน พัก และกรณียาก โดยมีแผนเมื่อคิวพุ่ง
- อำนาจใช้ได้จริง: ขอข้อมูลเพิ่ม แก้ ปฏิเสธ ส่งต่อ Pause และแจ้ง Incident ได้โดยไม่ถูกลงโทษทางอ้อม
- Escalation มีปลายทาง: ระบุผู้รับ เส้นตาย หลักฐาน และสถานะของผู้ได้รับผลระหว่างรอ
- Stop Rule ล่วงหน้า: มีเกณฑ์หยุด ขอบเขตที่หยุด เจ้าของปุ่ม และขั้นตอน Rollback ที่เคยซ้อม
- Feedback แยกชั้น: เก็บคำแนะนำ AI การตัดสินคน เหตุผล และผลจริงแยกกันก่อนใช้ปรับระบบ
- Audit เห็นสิ่งที่ AI ไม่เตือน: สุ่มตรวจทั้งกรณีเตือนและไม่เตือน พร้อม Second Review สำหรับความเสี่ยงสูง
- Metric ครบวงจร: วัดคุณภาพ เวลา การอุทธรณ์ ภาระงาน ผลแยกกลุ่ม และการเยียวยา ไม่ดู Agreement อย่างเดียว
- ผู้ได้รับผลเปลี่ยนสถานการณ์ได้: มีคำแจ้ง ช่องทางแก้ข้อมูล ขอทบทวน และติดต่อมนุษย์ที่เข้าถึงได้
วิธีใช้ Checklist ไม่ใช่ติ๊กให้ครบเพื่อผ่าน หากข้อใดตอบไม่ได้ ให้ระบุเจ้าของหลักฐานและการกระทำถัดไป เช่น ถ้ายังคำนวณคิวไม่ได้ ให้รัน Shadow Mode เพื่อวัดจำนวนกรณีและเวลาตรวจ ถ้ายังไม่มี Stop Rule ให้จำกัดระบบไม่ให้ปฏิเสธอัตโนมัติ เกณฑ์ผ่านคือทีมสาธิตได้ว่ากรณีหนึ่งเดินทางอย่างไร ใครเปลี่ยนผลตรงไหน และเมื่อระบบเสื่อมจะหยุดอย่างไร
ความเข้าใจผิดที่ทำให้จุด Human Review กลายเป็นฉากประกอบ
“มีปุ่มอนุมัติ แปลว่าคนควบคุมแล้ว”
กลไกที่ทำให้คิดเช่นนั้น: ทีมมองสิทธิ์ในหน้าจอแทนอำนาจในงานจริง สิ่งที่ถูกต้อง: คนต้องเห็นหลักฐาน มีเวลา และใช้ Override หรือ Escalation ได้โดยไม่ถูกลงโทษ วิธีตรวจ: สังเกตหนึ่งกะงาน วัดเวลาต่อเคส และถามว่าครั้งล่าสุดที่พนักงานเปลี่ยนผลเกิดอะไรต่อ
“คนกับ AI เห็นด้วยกันมาก แปลว่าระบบแม่น”
กลไกที่ทำให้คิดเช่นนั้น: Agreement วัดความเหมือนของคำตอบ ไม่ได้วัดความจริง สิ่งที่ถูกต้อง: ทั้งสองฝ่ายอาจผิดเหมือนกันเพราะข้อมูลหรือ Automation Bias วิธีตรวจ: ใช้ผลจริง Second Review และ Blind Audit เทียบทั้งกรณีเห็นด้วยและไม่เห็นด้วย
“ให้คนตรวจทุกกรณีปลอดภัยที่สุด”
กลไกที่ทำให้คิดเช่นนั้น: นับจำนวนจุดตรวจ แต่ไม่คำนวณความสนใจและคิว สิ่งที่ถูกต้อง: การตรวจงานผลกระทบต่ำจำนวนมากอาจทำให้เคสสำคัญรอและเพิ่ม Alert Fatigue วิธีตรวจ: จัดระดับความเสี่ยงแล้วเปรียบเทียบคุณภาพต่อเวลาระหว่างตรวจทั้งหมดกับตรวจตามความเสี่ยงพร้อม Audit
“การ Override คือพนักงานต่อต้านเทคโนโลยี”
กลไกที่ทำให้คิดเช่นนั้น: องค์กรใช้โมเดลเป็นค่าเริ่มต้นที่ถูกและมองความต่างเป็นข้อผิดพลาดมนุษย์ สิ่งที่ถูกต้อง: Override เป็นสัญญาณที่ต้องสืบเหตุ อาจเกิดจากบริบทใหม่ ข้อมูลล้า หรือคนตัดสินผิด วิธีตรวจ: อ่านเหตุผลและผลจริง แยกตามประเภทก่อนเปลี่ยนนโยบายหรือฝึกโมเดล
“Feedback จากคนเอาไปฝึกได้ทันที”
กลไกที่ทำให้คิดเช่นนั้น: ถือว่าคนคือ Ground Truth สิ่งที่ถูกต้อง: คนอาจได้รับอิทธิพลจากคำแนะนำเดิมและไม่เห็นผลหลังตัดสิน วิธีตรวจ: แยก AI Output, Human Decision และ Real Outcome แล้วสุ่มทบทวนคุณภาพป้ายกำกับก่อนใช้
ลงมือทำ: ออกแบบจุดตรวจหนึ่งจุดให้เปลี่ยนผลได้จริง
Worksheet 30–45 นาที
เลือก Workflow ที่คุณรู้จักหนึ่งงาน เช่น คืนสินค้า ตรวจเอกสาร คัดกรองอีเมล หรืออนุมัติเนื้อหา ใช้ข้อมูลสมมติหรือข้อมูลของตนเองที่ไม่อ่อนไหว ห้ามนำข้อมูลส่วนบุคคลของผู้อื่นมาใส่ในเครื่องมือ AI จุดเริ่มต้นคือวาดกล่อง “การกระทำที่เกิดกับผู้ใช้” ก่อนวาดโมเดล
1. การกระทำและผลเสีย
AI เสนอหรือทำอะไร ใครได้รับผล ถ้าผิดสองทิศจะเสียอะไร และผลย้อนกลับได้แค่ไหน เขียน Baseline ของวิธีเดิมอย่างน้อยสอง Metric
2. Input และหลักฐาน
แยกข้อมูลต้นฉบับ สัญญาณที่โมเดลสร้าง บริบทที่ระบบไม่เห็น แหล่ง วันที่ และข้อมูลที่ผู้ตรวจต้องขอเพิ่มเมื่อขัดแย้ง
3. เลือกโหมด
แบ่งกรณีเป็น In, On หรือ Out-of-the-loop ตามผลกระทบ ความไม่แน่นอน เวลาตอบ และความสามารถย้อนกลับ พร้อมอธิบายเหตุผล
4. อำนาจของผู้ตรวจ
ระบุปุ่มหรือการกระทำจริง: ยืนยัน แก้ ปฏิเสธ ขอข้อมูล ส่งต่อ Pause และแจ้ง Incident ใครใช้ได้ และต้องมีหลักฐานอะไร
5. คิวและจุดหยุด
ประมาณกรณีต่อชั่วโมง เวลาต่อกรณี กำลังคน Backlog ที่ยอมรับได้ และ Stop Rule เมื่อคุณภาพหรือความเร็วต่ำกว่าระดับปลอดภัย
6. ผลจริงและ Feedback
กำหนดว่าจะรู้ผลจริงจากไหน เก็บคำแนะนำกับคำตัดสินแยกอย่างไร ใครทบทวน และการค้นพบแต่ละแบบจะกลับไปแก้ข้อมูล โมเดล UI หรือนโยบาย
หลักฐานว่าทำสำเร็จ
ให้คนที่ไม่รู้ระบบอ่าน Worksheet แล้ววาดเส้น Input → AI Recommendation → Human Action → Real Outcome → Feedback ได้โดยไม่เดา เขาต้องตอบได้ว่าใครเปลี่ยนผล ใครรับ Escalation เมื่อใดต้องหยุด และผู้ได้รับผลแก้ข้อมูลหรือขอทบทวนอย่างไร หากตอบไม่ได้ จุดนั้นยังไม่พร้อม
คำถามอธิบาย Why/How
- เหตุใด Output ของ AI จึงควรเป็นคำแนะนำหรือการจัดเส้นทาง ไม่ใช่คำตัดสินสุดท้ายในกรณีที่เลือก
- ข้อมูลใดที่หายแล้วทำให้คนไม่สามารถตรวจคำแนะนำได้
- แรงกดดันด้านเวลา Metric หรือวัฒนธรรมใดอาจทำให้ปุ่ม Override ใช้ไม่ได้จริง
- คุณจะตรวจ Error ที่ AI ไม่ส่ง Alert ได้อย่างไร
- Feedback ใดเป็นเพียงความเห็น และ Feedback ใดใกล้ผลจริงมากกว่า
Recovery Step
ถ้ายังไม่รู้จำนวนเคส เวลาตรวจ หรือผลจริง อย่าเดาแล้วเปิดอัตโนมัติ ให้ลดขอบเขตเป็น Observation Task หรือ Shadow Mode หนึ่งสัปดาห์ บันทึก Arrival Rate เวลาต่อเคส เหตุส่งต่อ ข้อมูลที่ขาด และผลกระทบโดยยังไม่ให้ AI เปลี่ยนผลผู้ใช้ จากนั้นกลับมาเติมช่อง 3–6 และตั้งเกณฑ์ทดลองแบบจำกัดก่อน
แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่ดีที่สุดให้ครบทั้งห้าข้อ แล้วกด “ตรวจคำตอบ” ระบบจะแสดงคะแนนรวม ข้อที่ยังไม่ได้ตอบ เฉลย และเหตุผลรายข้อ คุณสามารถกด “ทำแบบทดสอบใหม่” เพื่อเริ่มต้นอีกครั้ง
สรุป: มนุษย์ไม่ได้อยู่ในวงจรเพื่อรับรอง AI แต่เพื่อเปลี่ยนเส้นทางได้
กลับไปที่ลูกค้าซึ่งได้รับสินค้าผิด หากพนักงานเห็นเพียงคะแนนและกดยืนยันตามคิว การมีคนไม่ได้เพิ่มบริบทหรือหยุดความเสียหาย แต่เมื่อพนักงานเห็นหลักฐานจากหลายระบบ เชื่อมคำขอคล้ายกัน เปลี่ยนผล ส่งเหตุให้คลัง และระงับกฎที่ผิด คนกำลังทำสิ่งที่โมเดลทำไม่ได้: เข้าใจบริบทใหม่ รับผิดชอบต่อผล และเปลี่ยนระบบแทนการแก้เคสเดียว
Human-in-the-loop ที่ดีจึงมีสามชั้นพร้อมกัน ชั้นการตัดสินรายกรณีทำให้คนแก้หรือส่งต่อได้ ชั้นการปฏิบัติการทำให้ทีมเฝ้าระวังคิว Drift และ Incident พร้อมหยุดได้ และชั้นองค์กรทำให้เจ้าของระบบรับผิดชอบต่อทรัพยากร นโยบาย การอุทธรณ์ และการเยียวยา การขาดชั้นใดชั้นหนึ่งทำให้พนักงานปลายทางต้องรับปัญหาที่ตนไม่มีอำนาจแก้
Decision Rule ที่ควรจำคือ จัดระดับตามผลกระทบ → ให้หลักฐานก่อนคะแนน → คำนวณเวลาคน → ให้อำนาจเปลี่ยนผล → แยกผลจริงจากความเห็น → วางจุดส่งต่อและหยุด ถ้าคุณวาดเส้นทางเหล่านี้ได้พร้อมชื่อเจ้าของ หลักฐาน และเกณฑ์ตรวจ คุณไม่ได้เพียงเพิ่มมนุษย์ลงในผัง แต่กำลังออกแบบวงจรที่มนุษย์กับ AI ตรวจสอบและแก้ข้อจำกัดของกันและกันได้
ภาพสรุป: คนเปลี่ยนผล จุดหยุดจำกัดความเสียหาย และ Feedback ปรับรอบถัดไป
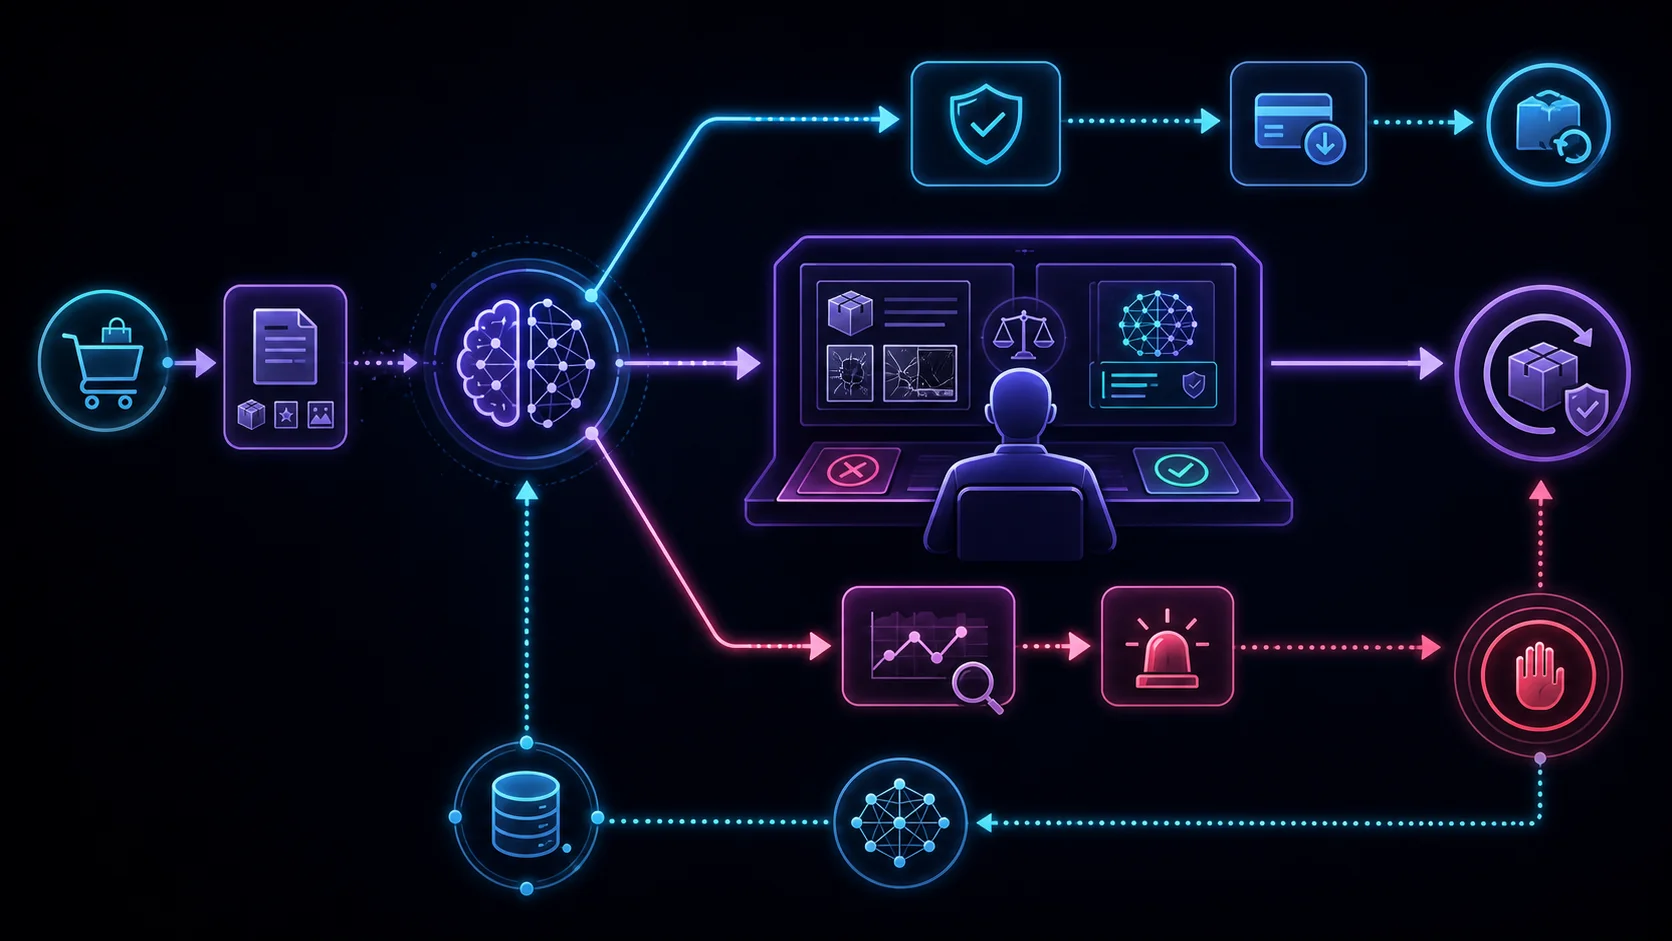
ภาพสรุปกลไกต้นฉบับสำหรับบทเรียนหัวข้อ 26 · เวอร์ชัน 1 · ไม่มีข้อความในภาพ
เรียนต่ออย่างมีทิศทาง
เมื่อรู้แล้วว่ามนุษย์ควรอยู่ตรงไหน คำถามถัดไปคือเรากำลังเลือกปัญหาที่เหมาะกับ AI หรือพยายามใช้ AI กับงานที่เป้าหมาย ข้อมูล และความรับผิดชอบยังไม่ชัด บทที่ 27 จะพาเริ่มจาก Problem Framing ก่อนเลือกเทคโนโลยี หากต้องการเห็นลำดับ 50 หัวข้อทั้งหมด ให้กลับไปยัง Learning Pack PATH 01
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงและหมายเหตุบรรณาธิการ
- NIST AI Resource Center — AI RMF Core ใช้รองรับการกำหนดบทบาทและความรับผิดชอบของ Human-AI configuration, การกำกับตลอดวงจร และการนำ Feedback ที่ผ่านการพิจารณากลับไปปรับระบบ
- NIST AI 100-1 — Artificial Intelligence Risk Management Framework 1.0 ใช้รองรับข้อจำกัดของ Human-AI interaction, Human Baseline, ความแตกต่างของระดับอัตโนมัติ และความจำเป็นในการกำหนดบทบาทมนุษย์ตามบริบท
- OECD AI Principle — Human-centred values and fairness ใช้รองรับ Human Agency และ Oversight ที่เหมาะกับบริบท
- OECD AI Principle — Accountability ใช้รองรับ Traceability, บทบาทของ AI actors และการจัดการความเสี่ยงตลอดวงจร
- UNESCO Recommendation on the Ethics of Artificial Intelligence ใช้รองรับหลัก Human Oversight and Determination, Ultimate Human Responsibility, Auditability และช่องทางเยียวยา
- Mosier et al. — Automation Bias: Decision Making and Performance in High-Tech Cockpits งานวิจัยต้นฉบับที่ใช้เป็นฐานอธิบายการพึ่งระบบอัตโนมัติมากเกินไป
- Drew et al. — Insights into the Problem of Alarm Fatigue งานสังเกตการณ์ที่ใช้รองรับกลไกภาระ Alarm จำนวนมากและการลดความสนใจ โดยบทเรียนไม่ย้ายตัวเลขจาก ICU ไปสรุปกับธุรกิจโดยตรง
ตรวจข้อเท็จจริงและทบทวนภาษาไทยล่าสุด: 9 สิงหาคม 2026 · AI Encyclopedia หัวข้อ 26 · PATH 01 · กรณีคำขอคืนเงินและตัวเลขคิวเป็นตัวอย่างสมมติเพื่อการศึกษา ไม่ใช่ผลทดสอบของระบบจริงหรือคำปรึกษากฎหมาย
บันทึกภาพ: Featured Image เดิมคงไว้ตามไฟล์ที่อนุมัติ · Summary Visual สร้างใหม่ด้วย ImageGen แบบไม่มีข้อความ เวอร์ชัน 1 · ไฟล์และ Manifest อยู่ใน Visual Register ของโครงการ · unique-across-lessons: pass
