หัวข้อ 25 จาก 50 · PATH 01
พื้นฐานดิจิทัล คอมพิวเตอร์ และภาพรวม AI · เล่ม 1 · ระดับเริ่มต้น
สมมติว่าสหกรณ์แห่งหนึ่งใช้ AI ช่วยจัดลำดับคำขอสินเชื่อ ระบบให้คะแนนผู้สมัครคนหนึ่งต่ำกว่าปกติ เจ้าหน้าที่เห็นคะแนนแล้วปฏิเสธคำขอภายในไม่กี่วินาที หากคะแนนนั้นผิด ความเสียหายเกิดจากโมเดลเพียงอย่างเดียวหรือไม่?
คำตอบสั้นคือ ไม่ใช่ ความเสี่ยงจาก AI เกิดเมื่อข้อจำกัดของข้อมูลหรือโมเดลเดินทางผ่านหน้าจอ กฎธุรกิจ คน และระบบอัตโนมัติ จนกลายเป็นการกระทำที่กระทบชีวิตจริง เราจึงต้องมองทั้งเส้นทาง ไม่ใช่ดู Accuracy หรือคะแนนความมั่นใจเพียงตัวเดียว
บทเรียนนี้จะพาคุณไล่เส้นทางนั้นตั้งแต่ข้อมูลเข้าสู่ระบบ ไปจนถึงคนที่รับผล แล้ววางจุดควบคุมสี่ชั้นคือ ป้องกัน ตรวจพบ ตอบสนอง และฟื้นฟู เพื่อให้ความผิดพลาดหนึ่งจุดไม่ขยายเป็นความเสียหายทั้งระบบ
อ่านจบบทนี้ คุณจะทำอะไรได้
- อธิบายความต่างระหว่าง Hazard, Exposure, Action, Impact และ Risk ด้วยภาษาของตนเองได้
- วาดเส้นทางจากข้อมูลและผลลัพธ์ของ AI ไปถึงคนหรือกระบวนการที่ได้รับผลได้
- แยกความเสี่ยงด้านคุณภาพ ความเป็นธรรม ความเป็นส่วนตัว ความปลอดภัย และการพึ่งพาระบบได้
- เลือกมาตรการ Prevent, Detect, Respond และ Recover ให้ตรงกับจุดเสี่ยงได้
- เขียน Risk Scenario ที่มีเจ้าของ หลักฐาน เกณฑ์เตือน และเกณฑ์หยุดได้
ความเสี่ยงเป็นเส้นทาง ไม่ใช่ตำหนิหนึ่งจุดในโมเดล
เวลาพูดถึงความเสี่ยงจาก AI หลายคนเริ่มจากคำถามว่า “โมเดลแม่นกี่เปอร์เซ็นต์” คำถามนี้มีประโยชน์ แต่ยังมองเห็นเพียงชิ้นส่วนเดียวของระบบ โมเดลอาจทำคะแนนดีในชุดทดสอบ ทว่าเมื่อนำไปใช้กับข้อมูลจริงที่เปลี่ยนไป ผลลัพธ์อาจคลาดเคลื่อน หรือแม้ผลลัพธ์จะถูกต้อง ระบบก็อาจนำผลนั้นไปใช้ผิดบริบท ให้สิทธิ์มากเกินไป หรือทำให้คนเชื่อโดยไม่ตรวจหลักฐาน
ลองนึกถึงน้ำรั่วบนชั้นบนของอาคาร จุดรั่วคือสาเหตุเริ่มต้น แต่น้ำจะสร้างความเสียหายมากน้อยเพียงใดขึ้นกับทางที่มันไหล มีพื้นกันน้ำหรือไม่ มีเซนเซอร์เตือนหรือไม่ มีคนปิดวาล์วทันหรือไม่ และของสำคัญวางอยู่ตรงไหน ความผิดพลาดของ AI ก็คล้ายกัน ผลทำนายที่ผิดเป็นเพียงจุดเริ่ม เส้นทางผ่าน Workflow เป็นตัวกำหนดว่าความผิดนั้นจะถูกหยุด กลายเป็นคำแนะนำ หรือกลายเป็นการตัดสินใจที่ย้อนกลับยาก
NIST AI Risk Management Framework จึงวางการจัดการความเสี่ยงเป็นงานต่อเนื่องตลอดวงจรชีวิต ผ่านการกำกับดูแล ทำความเข้าใจบริบท วัด และจัดการ ไม่ใช่การตรวจโมเดลครั้งเดียวก่อนเปิดใช้แล้วจบ หลักคิดนี้ช่วยให้ทีมสนใจทั้งเทคโนโลยี คน กระบวนการ และผลกระทบที่เกิดจริง
ระบบรับข้อมูลจากไหน ครบหรือไม่ สะท้อนคนที่จะใช้จริงหรือไม่ และมีข้อจำกัดใดติดมาด้วย
โมเดลจำแนก ให้คะแนน สรุป หรือแนะนำอะไร พร้อมความไม่แน่นอนแบบใด
หน้าจอ กฎธุรกิจ เจ้าหน้าที่ หรือระบบอัตโนมัตินำผลไปทำอะไรต่อ
ใครได้โอกาส ใครเสียสิทธิ ใครต้องทำงานเพิ่ม และใครไม่มีช่องทางโต้แย้ง
ผลอาจกระทบเงิน สุขภาพ ความเป็นส่วนตัว ความปลอดภัย ความไว้วางใจ หรือทางเลือกในอนาคต
หัวใจสำคัญคือ ความเสี่ยงไม่ได้เท่ากับความผิดพลาด ความผิดพลาดเป็นเหตุการณ์หนึ่ง ส่วนความเสี่ยงคือความเป็นไปได้ที่เหตุการณ์หรือเงื่อนไขบางอย่างจะนำไปสู่ผลเสียภายใต้บริบทจริง โมเดลเดียวกันจึงมีความเสี่ยงไม่เท่ากันเมื่ออยู่คนละงาน ใช้กับคนละกลุ่ม หรือได้รับอำนาจต่างกัน
แยก Hazard, Exposure, Action, Impact, Control และ Risk ให้ชัด
ศัพท์ด้านความเสี่ยงมักถูกใช้ปนกันจนทีมคุยเรื่องเดียวกันแต่เข้าใจคนละอย่าง การแยกคำเหล่านี้ไม่ใช่การท่องนิยาม แต่ช่วยให้เรารู้ว่าควรแก้ตรงไหน หากเห็นเพียง Impact เราอาจแก้ปลายเหตุ หากเห็นเพียง Hazard เราอาจลืมว่าบาง Hazard ถูกจำกัดอยู่ใน Sandbox และไม่มีทางไปกระทบใคร
| คำ | ความหมายที่ใช้ในบทเรียน | ตัวอย่างในกรณีสินเชื่อ | คำถามที่ควรถาม |
|---|---|---|---|
| Hazard | สิ่งหรือเงื่อนไขที่อาจก่ออันตราย | คะแนนความเสี่ยงคลาดเคลื่อนเพราะข้อมูลรายได้ไม่ครบ | อะไรอาจผิดหรือถูกใช้ผิด? |
| Exposure | ช่องทางที่คนหรือระบบสัมผัส Hazard | คะแนนถูกแสดงเป็นสีแดงเด่นบนหน้าจอเจ้าหน้าที่ | ผลเดินทางผ่านใครหรือระบบใด? |
| Action | การตัดสินใจหรือคำสั่งที่เกิดจากผล AI | ระบบปฏิเสธอัตโนมัติเมื่อคะแนนต่ำกว่าเกณฑ์ | ผล AI ถูกแปลงเป็นการกระทำอย่างไร? |
| Impact | ผลที่เกิดกับคน องค์กร หรือสังคม | ผู้สมัครเสียโอกาสทางการเงินและต้องยื่นใหม่ | ใครเสียอะไร รุนแรงและย้อนกลับได้แค่ไหน? |
| Control | มาตรการที่ตัด ลด ตรวจพบ หรือฟื้นฟูเส้นทาง | ห้ามปฏิเสธอัตโนมัติและเปิดช่องอุทธรณ์พร้อมตรวจเอกสาร | เราหยุดหรือจำกัดผลเสียตรงไหน? |
| Risk | ความเป็นไปได้และขนาดของผลเสียในบริบทหนึ่ง | ผู้สมัครบางกลุ่มถูกปฏิเสธผิดซ้ำโดยไม่รู้เหตุผล | เส้นทางใดน่ากังวลและควรจัดการก่อน? |
อีกสองคำที่ควรแยกคือ ความไม่แน่นอน กับ ความเสียหาย ความไม่แน่นอนหมายถึงเรายังไม่รู้ผลหรือเชื่อมั่นได้ไม่เต็มที่ แต่ไม่ใช่ทุกความไม่แน่นอนจะทำให้เกิดความเสียหาย ขณะเดียวกันระบบที่ให้ผลสม่ำเสมอมากอาจสร้างความเสียหายได้ หากเป้าหมายหรือกฎธุรกิจตั้งผิดตั้งแต่ต้น
วิธีตรวจความเข้าใจ: หากคุณระบุได้เพียงว่า “AI อาจตอบผิด” คุณยังเห็นแค่ Hazard ลองเขียนต่อให้ครบว่าใครเห็นคำตอบ นำไปทำอะไร กระทบใคร และมีจุดใดหยุดผลนั้นได้
กรณีศึกษาหลัก: AI ช่วยคัดกรองคำขอสินเชื่อของสหกรณ์เมือง
ขอบเขตของกรณีศึกษา
กรณีนี้เป็น สถานการณ์สมมติเพื่อการอธิบาย ไม่ใช่ผลทดสอบของสถาบันการเงินจริง และไม่ใช่คำแนะนำทางการเงินหรือกฎหมาย สมมติว่าสหกรณ์ต้องตรวจคำขอจำนวนมาก จึงใช้โมเดลช่วยจัดลำดับเคสที่ควรตรวจเอกสารเพิ่ม โมเดลรับข้อมูลรายได้ ภาระหนี้ ประวัติการชำระ และความครบถ้วนของเอกสาร แล้วสร้างคะแนนความเสี่ยง เจ้าหน้าที่ยังคงเป็นผู้ตัดสินใจขั้นสุดท้าย
เป้าหมายที่ประกาศคือช่วยให้เจ้าหน้าที่ทำงานเร็วขึ้น ไม่ใช่แทนที่การพิจารณาทั้งหมด ในเวอร์ชันแรก คะแนนถูกวางบนหน้าจอพร้อมสีเขียว เหลือง แดง แม้คู่มือบอกว่าเป็นเพียงตัวช่วย แต่หน้าจอกลับทำให้คะแนนดูเหมือนคำตัดสิน เจ้าหน้าที่ที่มีเวลาจำกัดจึงเริ่มใช้สีแดงเป็นเหตุผลหลักในการปฏิเสธ
วันหนึ่งผู้สมัครอาชีพอิสระส่งหลักฐานรายได้หลายรูปแบบ ระบบอ่านเอกสารบางส่วนไม่สำเร็จ จึงเห็นรายได้น้อยกว่าความจริง โมเดลให้คะแนนต่ำ หน้าจอขึ้นสีแดง เจ้าหน้าที่ไม่ได้เห็นสัญญาณว่าเอกสารอ่านไม่ครบและกดปฏิเสธ ผู้สมัครได้รับข้อความสั้น ๆ ว่าไม่ผ่านเกณฑ์ แต่ไม่มีเหตุผลที่ตรวจสอบได้และไม่มีทางแก้ข้อมูลทันที
หากมองเฉพาะโมเดล ทีมอาจสรุปว่า “ต้องเพิ่ม Accuracy” แต่เส้นทางจริงมีจุดเสี่ยงหลายชั้น ได้แก่ การอ่านเอกสาร การออกแบบคะแนน การใช้สีบนหน้าจอ เวลาที่เจ้าหน้าที่มี กฎปฏิเสธ ช่องทางแจ้งเหตุผล และการอุทธรณ์ การปรับโมเดลอย่างเดียวจึงไม่พอ แม้โมเดลดีขึ้น เหตุการณ์คล้ายกันยังเกิดได้เมื่อข้อมูลไม่ครบหรือคนตีความคะแนนเกินบทบาท
| ชั้นของระบบ | Input | Process | Output | Failure ที่ต้องเฝ้า |
|---|---|---|---|---|
| รับเอกสาร | เอกสารรายได้และข้อมูลสมัคร | ตรวจรูปแบบและแปลงข้อมูล | ข้อมูลที่ระบบอ่านได้ | เอกสารบางประเภทถูกอ่านไม่ครบ |
| โมเดล | คุณลักษณะที่ผ่านการเตรียม | คำนวณคะแนนความเสี่ยง | คะแนนและระดับความมั่นใจ | ข้อมูลนอกกลุ่มฝึกทำให้คะแนนคลาด |
| หน้าจอ | คะแนนและสัญญาณคุณภาพ | จัดลำดับและใช้สี | คำแนะนำแก่เจ้าหน้าที่ | สีทำให้คนเชื่อคะแนนมากเกินไป |
| การตัดสินใจ | ข้อมูล คำแนะนำ และกฎ | เจ้าหน้าที่ตรวจและให้เหตุผล | อนุมัติ ขอข้อมูลเพิ่ม หรือปฏิเสธ | เวลาน้อยจนข้ามการตรวจหลักฐาน |
| หลังการตัดสินใจ | เหตุผลและข้อมูลติดต่อ | แจ้งผล รับอุทธรณ์ และแก้ข้อมูล | ผลที่ผู้สมัครเข้าใจและท้าทายได้ | ไม่มีเหตุผลหรือทางกลับที่ใช้ได้จริง |
เริ่มจากขอบเขต ผู้ใช้ และผู้ได้รับผล ไม่ใช่เริ่มจากรายการความเสี่ยงสำเร็จรูป
ความเสี่ยงขึ้นกับบริบท ระบบช่วยค้นเอกสารภายในกับระบบปฏิเสธสิทธิอัตโนมัติอาจใช้โมเดลคล้ายกัน แต่ผลเสียและมาตรการที่ต้องมีต่างกันมาก ก่อนประเมินความเสี่ยง ทีมจึงต้องเขียนให้ชัดว่าระบบมีไว้ทำอะไร ไม่ได้มีไว้ทำอะไร ใครใช้ ผลลัพธ์ไปไหน และใครได้รับผลแม้ไม่ได้แตะระบบโดยตรง
ในกรณีสหกรณ์ ผู้ใช้โดยตรงคือเจ้าหน้าที่สินเชื่อ แต่ผู้ได้รับผลหลักคือผู้สมัครและครอบครัว ผู้ดูแลระบบ ฝ่ายตรวจสอบ ผู้ให้บริการ Cloud และทีมที่จัดเตรียมข้อมูลก็เป็น AI Actor ที่มีบทบาทคนละส่วน หากไม่มีคนรับผิดชอบการแก้ข้อมูล การตรวจโมเดล หรือการแจ้งผู้สมัคร ความรับผิดชอบอาจกระจายจนสุดท้ายไม่มีใครมีอำนาจแก้ปัญหา
การทำ Context Map ที่ดีควรรวม Baseline หรือวิธีเดิมด้วย หากก่อนใช้ AI เจ้าหน้าที่ใช้เวลานานและตัดสินไม่สม่ำเสมอ เราต้องรู้ปัญหาเดิม ไม่เช่นนั้นอาจเปรียบเทียบ AI กับโลกสมบูรณ์แบบที่ไม่เคยมีอยู่จริง ในทางกลับกัน คำว่า “มนุษย์ก็ผิด” ไม่ใช่เหตุผลให้ยอมรับระบบใหม่โดยไม่วัดว่าความผิดเปลี่ยนรูป ขยายเร็วขึ้น หรือกระจุกตัวกับกลุ่มใด
- วัตถุประสงค์: ใช้ช่วยจัดลำดับเคสและชี้จุดตรวจเพิ่ม ไม่ใช่ตัดสินแทนเจ้าหน้าที่
- ขอบเขตที่ห้ามใช้: ห้ามปฏิเสธอัตโนมัติจากคะแนนเพียงอย่างเดียว
- ผู้ได้รับผล: ผู้สมัคร เจ้าหน้าที่ ผู้อนุมัติ ผู้ตรวจสอบ และผู้ดูแลข้อมูล
- ผลที่ยอมรับไม่ได้: ปฏิเสธผิดโดยไม่มีเหตุผล ไม่มีช่องอุทธรณ์ หรือเปิดเผยข้อมูลเกินจำเป็น
- ทางเลือกที่ไม่ใช้ AI: Manual Review สำหรับข้อมูลไม่ครบ เคสขอบ และผู้ขอทบทวน
ความเสี่ยงด้านคุณภาพเริ่มก่อนโมเดลและจบหลังโมเดล
คุณภาพไม่ได้หมายถึง Accuracy อย่างเดียว ระบบอาจรับข้อมูลผิดคอลัมน์ ใช้ข้อมูลล้าสมัย อ่านเอกสารไม่ครบ หรือสร้างคะแนนถูกแต่ส่งให้ Workflow ผิดคน ปัญหาเหล่านี้เกิดทั้งก่อน ระหว่าง และหลังการอนุมาน การทดสอบจึงต้องครอบคลุม Pipeline ตั้งแต่รับข้อมูลจนถึงการกระทำจริง
ข้อมูลฝึกมักสะท้อนโลกในอดีต หากเกณฑ์เดิมเคยให้โอกาสบางกลุ่มน้อยกว่า Label ที่เรียกว่า “คำตอบจริง” อาจเก็บรอยของการตัดสินใจเดิมไว้ โมเดลที่เลียนแบบ Label ได้ดีอาจทำคะแนนสูงโดยรักษาปัญหาเดิมอย่างสม่ำเสมอ นี่คือเหตุผลที่ทีมต้องถามว่า Label หมายถึงอะไร ใครสร้าง และสัมพันธ์กับผลลัพธ์ที่เราต้องการจริงหรือไม่
อีกปัญหาคือ Distribution Shift หรือโลกใช้งานเปลี่ยนจากโลกที่ใช้ทดสอบ ผู้สมัครอาจส่งเอกสารรูปแบบใหม่ ภาวะเศรษฐกิจเปลี่ยน หรือช่องทางสมัครดึงคนกลุ่มใหม่เข้ามา คะแนน Test เดิมไม่สามารถรับประกันอนาคตได้ ทีมจึงต้องวัดสัญญาณข้อมูลขาเข้า อัตราอ่านเอกสารไม่สำเร็จ คุณภาพผลแยกตามกลุ่ม และผลลัพธ์ปลายทางหลังใช้งาน
Input Quality
ข้อมูลครบ ถูกหน่วย สดพอ มีสิทธิ์ใช้ และครอบคลุมเคสจริงหรือไม่
Model Quality
วัดข้อผิดพลาดแต่ละแบบ ความไม่แน่นอน Calibration และผลแยกตามกลุ่มหรือไม่
Workflow Quality
คนเห็นหลักฐาน เข้าใจข้อจำกัด และมีเวลาตรวจหรือไม่
Decision Quality
ผล AI ช่วยให้การตัดสินใจจริงดีขึ้นเทียบ Baseline หรือไม่
Outcome Quality
คนได้รับผลดีขึ้น ลดภาระ หรือลดความเสียหายจริงหรือไม่
Recovery Quality
เมื่อผิด ตรวจพบ แก้ผล แจ้งผู้ได้รับผล และคืนสถานะได้เร็วเพียงใด
ในกรณีสหกรณ์ อัตราการอ่านเอกสารไม่สำเร็จอาจสำคัญกว่าคะแนนโมเดล เพราะหากข้อมูลรายได้หาย ผลที่ตามมาจะผิดตั้งแต่ต้น วิธีควบคุมที่ตรงจุดคือแสดงสถานะความครบถ้วน บังคับให้ขอข้อมูลเพิ่ม และห้ามตัดสินเมื่อข้อมูลสำคัญไม่ผ่าน ไม่ใช่เพียงฝึกโมเดลใหม่ทุกครั้ง
อคติไม่ได้อยู่ในคอลัมน์เดียว และความเป็นธรรมไม่ได้มี Metric เดียว
หลายทีมเริ่มจัดการอคติด้วยการลบข้อมูลเพศ อายุ หรือเชื้อชาติออกจากชุดข้อมูล วิธีนี้อาจจำเป็นในบางบริบทแต่ยังไม่พอ เพราะตัวแปรอื่นอาจทำหน้าที่เป็น Proxy หรือข้อมูลตัวแทน เช่น พื้นที่อยู่ ประเภทอาชีพ ประวัติการใช้บริการ และรูปแบบอุปกรณ์ นอกจากนี้ ความเหลื่อมล้ำอาจเกิดจากช่องทางสมัครหรือการเข้าถึงเอกสาร ไม่ใช่จากโมเดลเพียงจุดเดียว
คะแนนเฉลี่ยรวมอาจดูดีแต่ซ่อนความผิดพลาดของกลุ่มเล็ก หากผู้สมัครอาชีพอิสระมีข้อมูลรูปแบบต่างจากพนักงานประจำ ระบบอาจอ่านเอกสารของกลุ่มแรกผิดบ่อยกว่า แม้ไม่ได้ใช้คำว่า “อาชีพ” โดยตรง ผลเสียจึงเกิดจาก Pipeline และการออกแบบบริการร่วมกัน การวัดผลต้องแยกตามกลุ่มที่มีเหตุผลทางบริบท พร้อมระวังไม่ทำให้การวิเคราะห์กลายเป็นการเก็บข้อมูลอ่อนไหวเกินจำเป็น
ความเป็นธรรมมีหลายความหมาย บางงานต้องการให้โอกาสได้รับผลบวกใกล้เคียงกัน บางงานสนใจอัตราความผิดพลาด บางงานต้องเน้นสิทธิในการได้รับเหตุผลและอุทธรณ์ Metric เหล่านี้อาจขัดกันได้ จึงต้องเริ่มจากผลกระทบและคุณค่าที่ต้องปกป้อง ไม่ใช่เลือกสูตรหนึ่งแล้วประกาศว่าระบบยุติธรรม
มุมที่มักมองข้าม: หากผู้สมัครกลุ่มหนึ่งรู้วิธีเตรียมเอกสารดิจิทัลมากกว่า ระบบอาจดูแม่นกับกลุ่มนั้น ไม่ใช่เพราะโมเดลเข้าใจความน่าเชื่อถือดีกว่า แต่เพราะบริการทำให้ข้อมูลของเขาอ่านง่ายกว่า การแก้จึงอาจเป็นการปรับแบบฟอร์มและช่วยเตรียมเอกสาร ไม่ใช่แตะโมเดลเท่านั้น
มาตรการสำคัญคือวิเคราะห์ผลแยกกลุ่ม ตรวจสาเหตุที่ Pipeline เปิดทางให้ความต่าง เพิ่ม Manual Route สำหรับเคสที่ข้อมูลไม่เข้ารูปแบบ อธิบายเหตุผลในภาษาคน และให้ผู้ได้รับผลแก้ข้อมูลหรือขอทบทวนได้ ความเป็นธรรมจึงเป็นทั้งเรื่องข้อมูล โมเดล UX กระบวนการ และอำนาจของผู้ได้รับผล
ข้อมูลมากขึ้นอาจช่วยโมเดล แต่เพิ่มความเสี่ยงด้านความเป็นส่วนตัว
ทีมอาจอยากเก็บข้อมูลเพิ่มเพราะคิดว่าโมเดลจะฉลาดขึ้น แต่ข้อมูลทุกชิ้นมีต้นทุนด้านสิทธิ์ การดูแล การรั่วไหล และการใช้ผิดวัตถุประสงค์ หลัก Data Minimization จึงถามว่าเราจำเป็นต้องเก็บอะไรเพื่อเป้าหมายที่ชัด และควรลบเมื่อใด ไม่ใช่เก็บทุกอย่างเผื่อวันหนึ่งอาจมีประโยชน์
ในกรณีสินเชื่อ Prompt, เอกสารแนบ, Log การตัดสินใจ และคำอธิบายของเจ้าหน้าที่อาจมีข้อมูลละเอียดอ่อน แม้ตัดชื่อออก การเชื่อมหลายจุดอาจทำให้ระบุตัวบุคคลกลับได้ การส่งข้อมูลไปยังผู้ให้บริการภายนอกยังเพิ่มคำถามว่าใครเข้าถึง เก็บไว้นานเท่าไร ใช้ฝึกระบบต่อหรือไม่ และเกิดอะไรเมื่อสัญญาสิ้นสุด
ความเป็นส่วนตัวไม่ได้เท่ากับ “มี Consent แล้วจบ” ผู้สมัครอาจยินยอมเพราะไม่มีทางเลือก หรือข้อความยินยอมอาจกว้างจนไม่ช่วยให้เข้าใจการใช้จริง ทีมต้องจำกัดวัตถุประสงค์ แยกสิทธิ์ตามหน้าที่ เข้ารหัสข้อมูล กำหนด Retention และตรวจเส้นทางข้อมูลตั้งแต่รับเข้า สำรอง ส่งต่อ วิเคราะห์ จนถึงลบ
| คำถาม | หลักฐานที่ควรมี | สัญญาณอันตราย |
|---|---|---|
| เก็บข้อมูลนี้ทำไม | วัตถุประสงค์และความจำเป็นที่เขียนชัด | คำตอบว่า “อาจใช้ในอนาคต” โดยไม่มีขอบเขต |
| ใครเข้าถึงได้ | Role, Permission และ Access Log | บัญชีร่วม สิทธิ์กว้าง หรือไม่มีการทบทวน |
| ส่งไปที่ใด | Data Flow และรายชื่อผู้ประมวลผล | ข้อมูลออกนอกระบบโดยทีมไม่เห็นเส้นทาง |
| เก็บนานเท่าไร | Retention Schedule และหลักฐานการลบ | Log และเอกสารสะสมไม่มีกำหนด |
| เจ้าของข้อมูลแก้หรือท้าทายได้อย่างไร | ช่องทางติดต่อ ขั้นตอนยืนยัน และ SLA | มีแบบฟอร์มแต่ไม่มีผู้รับผิดชอบแก้จริง |
เมื่อ AI รับไฟล์ เรียกเครื่องมือ หรือสั่งระบบอื่น ความปลอดภัยกลายเป็นส่วนของความเสี่ยงโดยตรง
ระบบ AI สมัยใหม่มักไม่หยุดที่การให้คะแนน มันอาจอ่านเอกสาร ค้นฐานข้อมูล เรียก API ส่งข้อความ หรือสร้างคำสั่งให้ระบบอื่น เมื่อโมเดลมี Agency หรืออำนาจทำสิ่งต่าง ๆ ผลลัพธ์ที่ผิดจึงเปลี่ยนจากข้อความบนจอเป็นการกระทำได้เร็วขึ้น หลัก Least Privilege จึงสำคัญ: ให้ระบบเข้าถึงเฉพาะสิ่งที่จำเป็นและแยกการอนุมัติสำหรับงานเสี่ยงสูง
Prompt Injection เป็นตัวอย่างหนึ่ง เนื้อหาจากผู้ใช้ เว็บไซต์ หรือเอกสารอาจมีคำสั่งที่ทำให้โมเดลเปลี่ยนพฤติกรรม OWASP แยกทั้งแบบตรงและแบบอ้อม และชี้ว่าความรุนแรงขึ้นกับบริบทธุรกิจและอำนาจที่ระบบได้รับ การเพิ่ม System Prompt อย่างเดียวไม่ใช่การป้องกันที่สมบูรณ์ ต้องแยกข้อมูลออกจากคำสั่ง ตรวจ Input และ Output จำกัดเครื่องมือ ใช้ Allowlist และขอการอนุมัติจากมนุษย์ก่อนการกระทำที่มีผลสูง
ในกรณีสหกรณ์ หากใช้โมเดลภาษาอ่านเอกสารเพิ่มเติม เอกสารที่อัปโหลดต้องถูกมองเป็นข้อมูลที่ไม่ไว้ใจ ไม่ควรมีสิทธิ์เรียกฐานข้อมูลหรือเปลี่ยนสถานะคำขอโดยตรง ขั้นตอนอ่านเอกสารควรอยู่ใน Sandbox ส่งออกโครงสร้างข้อมูลที่ตรวจรูปแบบได้ และให้บริการฝั่ง Server เป็นผู้ตัดสินว่าฟิลด์ใดใช้ต่อได้
- แยกข้อมูลภายนอกจากคำสั่งควบคุมระบบอย่างชัดเจน
- จำกัด API Token, Tool และฐานข้อมูลตามหน้าที่ที่เล็กที่สุด
- ตรวจรูปแบบ Output ด้วยโค้ดก่อนนำไปใช้ ไม่เชื่อข้อความจากโมเดลโดยตรง
- บันทึก Log ที่เพียงพอต่อการสืบเหตุ แต่ไม่เก็บข้อมูลส่วนบุคคลเกินจำเป็น
- ทดสอบกรณีโจมตี ข้อมูลหลอก และไฟล์ผิดรูปแบบเป็นประจำ
- ให้มนุษย์ยืนยันการกระทำที่เปลี่ยนสิทธิ โอนเงิน ส่งข้อมูล หรือควบคุมอุปกรณ์
มีคนอยู่ในวงจรไม่พอ คนต้องมีเวลา ข้อมูล อำนาจ และทางเลือก
ประโยคว่า “มี Human-in-the-loop แล้ว” ฟังดูปลอดภัย แต่คำว่าอยู่ในวงจรอาจหมายถึงเพียงกดปุ่มยืนยัน หากหน้าจอแสดงคะแนนใหญ่กว่าหลักฐาน เจ้าหน้าที่มีเวลาไม่กี่วินาที และการเลือกต่างจาก AI ต้องเขียนเหตุผลยาว คนมักทำตามคำแนะนำเดิม นี่คือ Automation Bias หรือแนวโน้มเชื่อระบบอัตโนมัติมากเกินไป
คนตรวจที่มีคุณภาพต้องเข้าใจวัตถุประสงค์และข้อจำกัด เห็นข้อมูลที่จำเป็น รู้ว่าส่วนใดไม่แน่นอน มีเวลาพอ และมีอำนาจเปลี่ยนผลโดยไม่ถูกลงโทษ การออกแบบต้องช่วยให้ตรวจจริง เช่น แสดงหลักฐานต้นทาง สัญญาณข้อมูลไม่ครบ ทางเลือกขอข้อมูลเพิ่ม และเหตุผลที่อธิบายต่อผู้สมัครได้
อีกด้านหนึ่งคือ Under-reliance หรือไม่ใช้คำแนะนำที่มีประโยชน์เพราะไม่ไว้ใจระบบ หาก AI เตือนบ่อยเกินไปหรืออธิบายไม่ได้ เจ้าหน้าที่อาจปิดการเตือนทั้งหมด ดังนั้นเป้าหมายไม่ใช่ทำให้คนเชื่อ AI มากที่สุด แต่ทำให้เขาปรับระดับความเชื่อให้ตรงกับหลักฐานและบริบท
เวลา
มีเวลาตรวจหลักฐานจริง ไม่ใช่กดยืนยันตามคิวงาน
ข้อมูล
เห็นที่มา ความครบถ้วน ความไม่แน่นอน และข้อจำกัดที่เกี่ยวข้อง
อำนาจ
เปลี่ยน หยุด ขอข้อมูลเพิ่ม หรือส่งต่อผู้เชี่ยวชาญได้
ความรับผิดชอบ
รู้ว่าใครตัดสิน ใครตรวจ และใครแก้เมื่อเกิดผลเสีย
การฝึก
ฝึกจาก Failure Case ไม่ใช่เพียงสาธิตเคสที่ระบบทำได้ดี
Feedback
การแก้ของคนถูกนำไปปรับระบบโดยไม่เปลี่ยนเป็น Label อย่างมืดบอด
หัวข้อถัดไปจะลงลึกเรื่อง Human-in-the-loop โดยเฉพาะ แต่ในบทนี้ให้จำว่า “มีคน” เป็นเพียงชื่อ Control คุณภาพของ Control ต้องพิสูจน์ด้วยการทดสอบว่าคนสังเกตข้อผิดพลาด ตัดสินต่าง และหยุดผลเสียได้จริง
การพึ่งพาระบบมากเกินไปทำให้ทักษะ ทางเลือก และทางกลับหาย
เมื่อองค์กรปรับ Workflow รอบ AI มากขึ้น งานเดิมอาจค่อย ๆ หายไป คนใหม่ไม่เคยเรียนวิธีตรวจด้วยตนเอง คู่มือสำรองล้าสมัย และข้อมูลถูกผูกกับผู้ให้บริการรายเดียว หากระบบล่ม รุ่นเปลี่ยน ราคาเพิ่ม หรือคุณภาพลด งานทั้งสายอาจหยุด แม้ไม่มีการโจมตีหรือความผิดพลาดของโมเดล
ความเสี่ยงนี้เรียกได้ว่า Dependency หรือ Vendor/Model Dependency การจัดการต้องมองทั้งเทคนิคและคน เช่น เก็บวิธี Export ข้อมูล บันทึก Version ที่ใช้ ทดสอบ Manual Mode รักษาทักษะสำคัญ และกำหนดเงื่อนไขย้ายหรือหยุดบริการ อย่ารอให้เกิด Incident แล้วค่อยพบว่าไม่มีใครรู้วิธีทำงานโดยไม่ใช้ AI
ในกรณีสหกรณ์ ทีมอาจใช้บริการอ่านเอกสารจากภายนอก หากผู้ให้บริการเปลี่ยนโมเดลโดยไม่แจ้ง รูปแบบผลลัพธ์อาจเปลี่ยนเล็กน้อยจนคะแนน downstream ผิด วิธีลดความเสี่ยงคือ Contract Test, Version Pinning เมื่อทำได้, Monitoring ที่ระดับฟิลด์, แผน Rollback และคิว Manual Review สำหรับช่วงที่บริการไม่พร้อม
การมีสำรองไม่ใช่แค่สำเนาโมเดลอีกตัว เพราะโมเดลสำรองอาจพึ่ง Cloud, ข้อมูล และ Pipeline เดียวกัน Resilience ที่แท้ต้องแยก Failure Domain และซ้อมสลับกลับ โดยวัดว่างานสำคัญยังเดินต่อได้ในระดับที่ยอมรับ ไม่ใช่เพียงมีเอกสาร Incident Plan อยู่ในโฟลเดอร์
ประเมินมากกว่าความน่าจะเป็นคูณความรุนแรง
สูตรโอกาสคูณความรุนแรงช่วยจัดลำดับเบื้องต้น แต่ความเสี่ยงจาก AI มีมิติที่สูตรเดียวจับไม่ครบ ผลกระทบอาจกระจายกับคนจำนวนมาก สะสมช้า ย้อนกลับยาก หรือเกิดกับกลุ่มที่ไม่มีอำนาจร้องเรียน เหตุการณ์ความน่าจะเป็นต่ำจึงอาจสำคัญมากเมื่อกระทบสิทธิ สุขภาพ หรือชีวิต
การให้คะแนนควรเป็นจุดเริ่มสนทนา ไม่ใช่เครื่องจักรผลิตความแน่นอน ตัวเลข 3×4 อาจซ่อนสมมติฐานว่าใครเป็นคนให้คะแนน ใช้หลักฐานอะไร และมองข้ามใคร ทีมควรเก็บเหตุผลและระดับความมั่นใจของการประเมิน พร้อมทบทวนเมื่อมีข้อมูลใหม่
ขนาด
คน ธุรกรรม หรือระบบกี่รายได้รับผล และผลแพร่ซ้ำได้เร็วเพียงใด
ความรุนแรง
กระทบความสะดวก รายได้ สิทธิ สุขภาพ ความปลอดภัย หรือชีวิตระดับใด
ระยะเวลา
ผลอยู่ชั่วคราว สะสม หรือเปลี่ยนเส้นทางชีวิตระยะยาว
การย้อนกลับ
ตรวจพบ แก้ผล ชดเชย และคืนสถานะได้จริงหรือไม่
การกระจาย
กลุ่มใดรับประโยชน์ กลุ่มใดรับความเสี่ยง และใครไม่มีเสียง
หลักฐาน
ข้อมูลใดรองรับการประเมิน สมมติฐานใดยังไม่ผ่านการทดสอบ
สำหรับผู้สมัครสินเชื่อ การปฏิเสธผิดหนึ่งครั้งอาจแก้ได้หากมีทางอุทธรณ์เร็ว แต่หากผู้สมัครไม่รู้ว่าข้อมูลผิด ไม่มีเหตุผล และต้องรอนาน โอกาสทางการเงินอาจหายไปก่อนการแก้ ผลจึงไม่ได้วัดจากจำนวนเคสผิดเท่านั้น ต้องดูเวลาในการตรวจพบและฟื้นฟูด้วย
Decision Rule: ยิ่งผลกระทบรุนแรง ย้อนกลับยาก กระทบสิทธิ หรือเกิดกับคนที่โต้แย้งลำบาก ระบบยิ่งต้องจำกัดอำนาจ AI เพิ่มการตรวจจากคน และมีหลักฐานก่อนขยายการใช้งาน
มาตรการที่ดีวางหลายชั้นและตัดเส้นทางคนละจุด
ไม่มี Control เดียวรับมือทุก Failure ได้ การวางหลายชั้นช่วยให้เมื่อชั้นหนึ่งพลาด ชั้นถัดไปยังจำกัดผลเสีย หลัก Prevent, Detect, Respond และ Recover ทำให้ทีมคิดครบตั้งแต่ก่อนเกิดเหตุจนถึงหลังเกิดผลกระทบ
| ชั้น | เป้าหมาย | ตัวอย่างในระบบสินเชื่อ | หลักฐานว่าทำงาน |
|---|---|---|---|
| Prevent | ลดโอกาสที่เส้นทางอันตรายจะเริ่ม | ตรวจความครบถ้วน แยกข้อมูลไม่ไว้ใจ ห้ามปฏิเสธอัตโนมัติ จำกัดสิทธิ์ | Test Case, Access Review, Validation Log และนโยบายที่บังคับจริง |
| Detect | พบความผิดหรือการเสื่อมก่อนผลขยาย | เตือนข้อมูลหาย วัดผลแยกกลุ่ม ตรวจ Drift และสุ่ม Audit | Alert ที่มีผู้รับ ค่า Baseline Dashboard และผลการทดสอบแจ้งเตือน |
| Respond | หยุด จำกัด และสื่อสารเมื่อเกิดเหตุ | Pause การตัดสิน ส่ง Manual Review ปิดฟังก์ชัน และแจ้งผู้ได้รับผล | Runbook, ผู้มีอำนาจตัดสิน และเวลาตอบสนองที่ซ้อมแล้ว |
| Recover | แก้ผล คืนสถานะ และเรียนรู้ | แก้ข้อมูล ทบทวนคำขอ ชดเชย Rollback และอัปเดต Control | หลักฐานการคืนสถานะ Post-incident Review และการป้องกันซ้ำ |
แต่ละ Control ต้องมีเจ้าของ เงื่อนไขเริ่มทำงาน และวิธีตรวจ หากบอกเพียง “ทีม Data ตรวจ” คำอธิบายยังไม่พอ ต้องระบุว่าตรวจอะไร บ่อยแค่ไหน เกณฑ์ใดถือว่าผิด ใครได้รับ Alert และมีอำนาจทำอะไรต่อ Control ที่ไม่มีเจ้าของหรือไม่มีหลักฐานอาจมีอยู่บนกระดาษแต่ไม่อยู่ในระบบจริง
อย่าใช้ Control ที่อยู่หลังผลเสียทั้งหมด เช่น รอรับ Complaint อย่างเดียว การร้องเรียนมีประโยชน์แต่ผู้ได้รับผลอาจไม่รู้ว่า AI มีส่วน หรือไม่มีกำลังติดตาม ทีมต้องมีทั้งสัญญาณเชิงรุกและทางให้คนแจ้งปัญหา
Trade-off ก็สำคัญ การเพิ่ม Manual Review ทุกเคสอาจลดความเร็วและเพิ่มภาระจนคนกดผ่านโดยไม่อ่าน ทางเลือกที่ดีกว่าอาจเป็นการจัดระดับความเสี่ยง ให้เคสข้อมูลไม่ครบหรือผลกระทบสูงได้รับการตรวจเข้ม ส่วนงานความเสี่ยงต่ำใช้ Automation ในขอบเขตจำกัด พร้อมสุ่มตรวจและทางหยุด
การเปิดใช้งานคือจุดเริ่มของการเฝ้าระวัง ไม่ใช่เส้นชัย
ก่อนใช้งาน เราทดสอบได้เพียงตัวอย่างและสมมติฐานบางส่วน โลกจริงจะนำข้อมูล คน และพฤติกรรมที่ไม่อยู่ในห้องทดลองเข้ามา Monitoring จึงต้องดูสามระดับพร้อมกัน ได้แก่ ระบบทำงานหรือไม่ การตัดสินใจดีขึ้นหรือไม่ และผลกระทบต่อคนเป็นอย่างไร
System Metric เช่น Latency, Error Rate หรืออัตราอ่านเอกสารสำเร็จบอกสุขภาพทางเทคนิค Model Metric บอกคุณภาพการทำนาย แต่ Outcome Metric บอกว่าผู้สมัครได้รับผลอย่างไร เช่น อัตราขอทบทวน เวลาจนแก้ผลสำเร็จ ความแตกต่างระหว่างกลุ่ม และจำนวนเคสที่เจ้าหน้าที่ตัดสินต่างจาก AI หากดูระดับเดียว ทีมอาจเห็นระบบสีเขียวทั้งที่คนกำลังได้รับผลเสีย
Alert ต้องเชื่อมกับการกระทำ ไม่ใช่เพียงส่งอีเมลไปกล่องที่ไม่มีคนอ่าน ตัวอย่างเช่น หากอัตราอ่านเอกสารอาชีพอิสระไม่สำเร็จเกิน Baseline ให้หยุดการใช้คะแนนในกลุ่มนั้นและส่ง Manual Review หากอัตราปฏิเสธผิดจากการ Audit เกินเกณฑ์ ให้ลดขอบเขตหรือ Rollback เวอร์ชันล่าสุด
Incident Management ต้องรวมการสื่อสารกับผู้ได้รับผล ไม่ใช่คุยเฉพาะทีมเทคนิค การแก้โมเดลไม่ได้ย้อนผลที่เกิดแล้ว ทีมต้องหาว่าใครได้รับผล แจ้งอย่างเข้าใจง่าย เปิดทางแก้ข้อมูลและทบทวนคำตัดสิน พร้อมบันทึกเหตุเพื่อปรับทั้งโมเดล หน้าจอ กฎ และการฝึกคน
ตัวอย่างเกณฑ์หยุดของกรณีศึกษา
หากพบว่าข้อมูลรายได้ของเอกสารชนิดใดชนิดหนึ่งอ่านไม่ครบมากกว่าค่า Baseline ที่กำหนด ระบบต้องหยุดสร้างคะแนนสำหรับเอกสารชนิดนั้น ส่งเคสค้างทั้งหมดเข้าสู่ Manual Review แจ้งเจ้าของระบบและเจ้าของกระบวนการ แล้วทบทวนคำขอที่ได้รับผลตั้งแต่ Version ล่าสุดเริ่มใช้งาน
ความเข้าใจผิดที่ทำให้การจัดการความเสี่ยงดูดีแต่หยุดอันตรายไม่ได้
ความเข้าใจผิด: Accuracy สูง แปลว่าความเสี่ยงต่ำ
กลไกที่ทำให้คิดเช่นนั้น: Accuracy เป็นตัวเลขเดียวที่สื่อสารง่ายและเปรียบเทียบสะดวก สิ่งที่ถูกต้อง: ต้องดูชนิดความผิด บริบท ผลกระทบ คุณภาพ Workflow และการย้อนกลับ วิธีตรวจ: แยก False Positive/False Negative ตามกลุ่มและจำลองผลที่เกิดเมื่อแต่ละแบบเดินทางผ่านระบบ
ความเข้าใจผิด: ลบข้อมูลอ่อนไหวแล้ว ระบบไม่มีอคติ
กลไกที่ทำให้คิดเช่นนั้น: เรามองอคติเป็นคุณลักษณะหนึ่งคอลัมน์ สิ่งที่ถูกต้อง: Proxy, Label, ช่องทางบริการ และการเข้าถึงยังสร้างความแตกต่างได้ วิธีตรวจ: วิเคราะห์ผลแยกกลุ่ม หาเหตุใน Pipeline และตรวจว่าคนทุกกลุ่มมีทางเลือกและอุทธรณ์จริง
ความเข้าใจผิด: มีคนกดอนุมัติ จึงเป็น Human-in-the-loop ที่ปลอดภัย
กลไกที่ทำให้คิดเช่นนั้น: เรานับจำนวนจุดที่มีคน แทนการวัดอำนาจและคุณภาพการตรวจ สิ่งที่ถูกต้อง: คนต้องมีเวลา ข้อมูล ทักษะ และอำนาจเปลี่ยนผล วิธีตรวจ: ใช้ Failure Case แบบไม่บอกล่วงหน้าแล้วดูว่าคนสังเกต หยุด และอธิบายเหตุผลได้หรือไม่
ความเข้าใจผิด: ใส่ Disclaimer แล้วความรับผิดชอบลดลง
กลไกที่ทำให้คิดเช่นนั้น: ข้อความเตือนทำให้รู้สึกว่าได้สื่อสารข้อจำกัด สิ่งที่ถูกต้อง: หาก Workflow ยังคงเปลี่ยนผล AI เป็นการกระทำอัตโนมัติ Disclaimer ไม่ได้ตัดเส้นทาง วิธีตรวจ: ตามผลลัพธ์จริงหลังข้อความเตือนและดูว่าผู้ใช้มีทางเลือกที่เป็นไปได้หรือไม่
ความเข้าใจผิด: เมื่อ Pilot ผ่านแล้ว ความเสี่ยงคงที่
กลไกที่ทำให้คิดเช่นนั้น: เราคิดว่าระบบซอฟต์แวร์เหมือนสินค้าที่ทดสอบเสร็จครั้งเดียว สิ่งที่ถูกต้อง: ข้อมูล คน รุ่นโมเดล และบริบทเปลี่ยนได้ วิธีตรวจ: กำหนด Monitoring, Change Review, Version Record และเกณฑ์หยุดตั้งแต่ก่อนเปิดใช้
Checklist ก่อนให้ AI มีอำนาจใน Workflow จริง
Checklist นี้ไม่ใช่ใบรับรองความปลอดภัย แต่เป็นคำถามเพื่อหยุดการรีบขยายระบบ หากข้อใดยังตอบไม่ได้ ให้ถือว่านั่นคือข้อมูลที่ทีมต้องหา ไม่ใช่ช่องว่างที่ควรเดา
- เป้าหมาย: ระบุการตัดสินใจ ผู้ใช้ และผลลัพธ์ที่ต้องการได้โดยไม่พูดชื่อโมเดล
- Baseline: รู้ว่าวิธีเดิมผิดอย่างไร ใช้เวลาเท่าไร และกระทบใครบ้าง
- ขอบเขต: เขียนสิ่งที่ AI ทำได้ ทำไม่ได้ และงานที่ห้ามทำอัตโนมัติ
- ข้อมูล: มี Data Flow, สิทธิ์ใช้, Retention และวิธีจัดการข้อมูลไม่ครบ
- คุณภาพ: วัดข้อผิดพลาดที่สัมพันธ์กับต้นทุนจริง ไม่พึ่ง Metric เดียว
- กลุ่มผู้ได้รับผล: วิเคราะห์ความต่างและมีทางเลือกสำหรับข้อมูลที่ไม่เข้ารูปแบบ
- คนตรวจ: มีเวลา ข้อมูล ทักษะ และอำนาจหยุดหรือเปลี่ยนผล
- ความปลอดภัย: จำกัดสิทธิ์ ตรวจ Input/Output และแยกข้อมูลไม่ไว้ใจ
- Monitoring: มี Baseline, Alert, ผู้รับ และการกระทำที่ชัดเมื่อเกินเกณฑ์
- Incident: รู้ว่าใครหยุด ใครแจ้ง ใครแก้ผล และใครทบทวนคนที่ได้รับผลย้อนหลัง
- Recovery: มี Manual Mode, Rollback และทดสอบทางกลับจริง
- Accountability: ทุกความเสี่ยงและ Control มีเจ้าของ หลักฐาน และรอบทบทวน
เกณฑ์ Go/No-Go แบบง่าย: ถ้าทีมยังวาดเส้นทางจากผล AI ไปถึงผลกระทบไม่ได้ ยังไม่มีเจ้าของเกณฑ์หยุด หรือยังคืนสถานะให้ผู้ได้รับผลไม่ได้ ให้หยุดที่ Offline/Shadow Mode และอย่าเพิ่มอำนาจการตัดสินใจ
ทดลองทำ: เขียน Risk Scenario หนึ่งรายการจากระบบของคุณ
โจทย์
เลือก AI หนึ่งระบบที่คุณใช้หรือกำลังพิจารณา อาจเป็น Chatbot ระบบคัดกรอง เอกสารอัตโนมัติ ระบบแนะนำ หรือโมเดลพยากรณ์ แล้วเขียนสถานการณ์ความเสี่ยงให้ครบเส้นทาง โดยไม่เริ่มจากคำกว้าง ๆ ว่า “AI อาจผิด”
- เลือกการตัดสินใจหนึ่งอย่าง ที่ผล AI มีอิทธิพล เช่น ส่งข้อความ อนุมัติ จัดลำดับ หรือเรียกเครื่องมือ
- เขียน Input ว่าข้อมูลมาจากไหน ใครสร้าง และอาจขาดหรือผิดแบบใด
- ระบุ Hazard ที่เฉพาะเจาะจงหนึ่งข้อ
- วาด Exposure และ Action ว่าผลเดินทางผ่านหน้าจอ คน กฎ หรือ API อย่างไร
- ระบุ Impact ว่าใครเสียอะไร รุนแรงนานแค่ไหน และย้อนกลับได้หรือไม่
- วาง Control อย่างน้อยหนึ่งชั้นใน Prevent, Detect, Respond และ Recover
- กำหนดเจ้าของ ของความเสี่ยง Alert การหยุด และการฟื้นฟู
- เขียนเกณฑ์หยุด ที่วัดได้ พร้อมหลักฐานว่าระบบกลับมาปลอดภัยแล้ว
แม่แบบคำตอบ
หาก [ข้อมูล/โมเดล/คน/ระบบ] เกิด [Hazard] ผลอาจเดินทางผ่าน [Exposure] และนำไปสู่ [Action] ทำให้ [ผู้ได้รับผล] เผชิญ [Impact] เราจะป้องกันด้วย […] ตรวจพบด้วย […] ตอบสนองด้วย […] และฟื้นฟูด้วย […] เจ้าของคือ […] และต้องหยุดเมื่อ […]
Success Signal
คุณทำสำเร็จเมื่อคนที่ไม่รู้ระบบมาก่อนอ่าน Scenario แล้วชี้ได้ว่าอันตรายเริ่มตรงไหน เดินทางอย่างไร ใครได้รับผล และ Control แต่ละชั้นตัดเส้นทางตรงจุดใด หากคำตอบยังใช้คำกว้าง เช่น “ตรวจให้ดี” หรือ “มีคนดู” ให้เติมเจ้าของ เกณฑ์ และหลักฐาน
Recovery Step
ถ้าคิดไม่ออก ให้เริ่มจากผลที่ยอมรับไม่ได้ก่อน เช่น “ห้ามส่งข้อมูลส่วนตัวออกนอกองค์กร” หรือ “ห้ามปฏิเสธสิทธิโดยไม่มีทางอุทธรณ์” จากนั้นย้อนกลับทีละขั้นว่าการกระทำใดทำให้ผลนั้นเกิด ผล AI เข้ามามีอิทธิพลตรงไหน และข้อมูลใดทำให้ AI ให้ผลเช่นนั้น
แบบทดสอบความเข้าใจ 5 ข้อ
เลือกคำตอบที่เหมาะสมที่สุดให้ครบทั้ง 5 ข้อ แล้วกด ตรวจคำตอบ ระบบจะแสดงคะแนนรวม จำนวนข้อที่ยังไม่ได้ตอบ เฉลย และเหตุผลรายข้อ
สรุป: อย่าถามเพียงว่า AI ผิดหรือไม่ ให้ถามว่าผลเดินทางไปไหน
กลับไปยังผู้สมัครในตอนต้น ปัญหาไม่ได้เริ่มและจบที่คะแนนต่ำ ข้อมูลอ่านไม่ครบสร้าง Hazard หน้าจอสีแดงทำให้เจ้าหน้าที่สัมผัสผลแบบที่ชวนเชื่อ กฎและเวลางานแปลงผลเป็นการปฏิเสธ ช่องทางอุทธรณ์ที่ไม่พร้อมทำให้ผลยาวนานขึ้น เมื่อเราเห็นเส้นทาง เราจึงเลือก Control ที่ตรงกว่าการพูดว่า “เพิ่ม Accuracy”
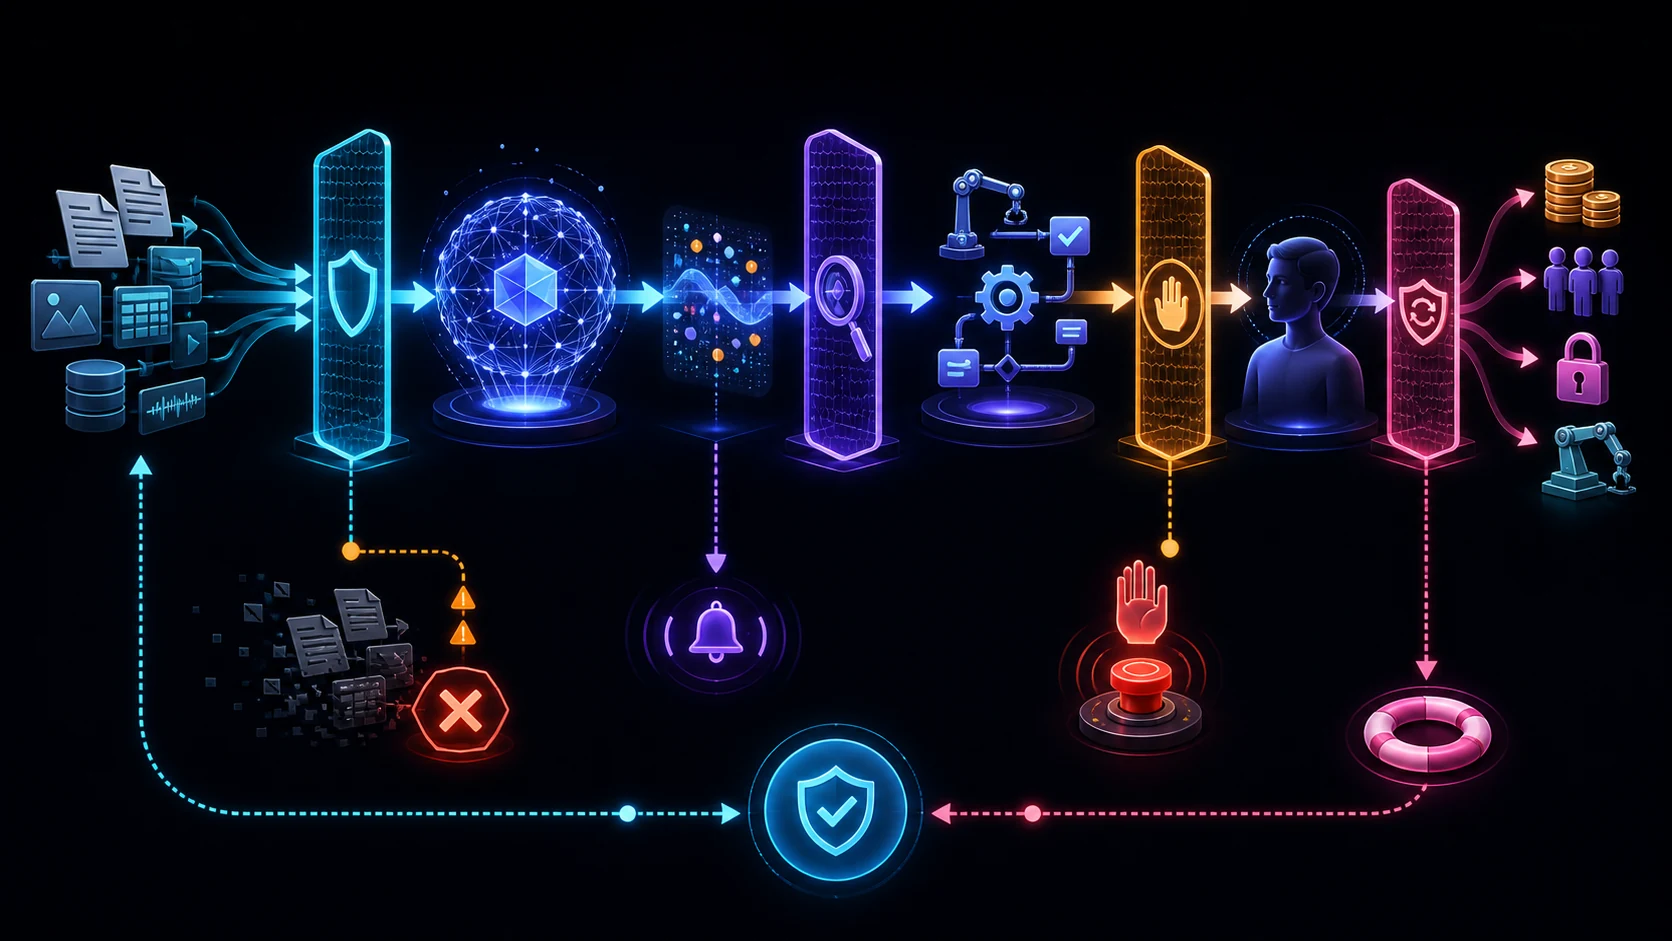
Mental Model ที่ควรจำคือ ข้อมูล → โมเดล → Workflow → การกระทำ → ผู้ได้รับผล → ผลกระทบ แล้ววาง Prevent, Detect, Respond และ Recover ตลอดทาง ทุก Control ต้องมีเจ้าของ เกณฑ์ และหลักฐานว่าทำงานจริง
การจัดการความเสี่ยงไม่ได้แปลว่าต้องกำจัดความไม่แน่นอนทั้งหมด ซึ่งเป็นไปไม่ได้ เป้าหมายคือทำให้ทีมรู้ว่าความเสียหายอาจเริ่มตรงไหน จำกัดอำนาจให้เหมาะกับบริบท ตรวจพบก่อนขยาย หยุดเมื่อหลักฐานไม่พอ และคืนสถานะให้คนที่ได้รับผลได้
Insight Gate: หากคุณวาดเส้นทางจาก Input ถึง Impact ได้ อธิบายว่าคนแต่ละกลุ่มได้รับผลอย่างไร และระบุได้ว่าใครหยุด แก้ และรับผิดชอบตรงไหน คุณเริ่มมองความเสี่ยงจาก AI เป็นระบบแล้ว
ภาพสรุป: ตัดเส้นทางความเสียหายให้ได้ก่อนผลขยาย
เรียนต่ออย่างไร
บทถัดไปจะลงลึกว่า Human-in-the-loop ที่มีคุณภาพต้องออกแบบอย่างไร เพื่อให้คนไม่ได้มีไว้เพียงกดยืนยัน แต่มีข้อมูล เวลา และอำนาจเปลี่ยนผลได้จริง
ดู Learning Pack ทั้งชุด →แหล่งอ้างอิงและหมายเหตุบรรณาธิการ
- NIST — Artificial Intelligence Risk Management Framework (AI RMF 1.0): กรอบการจัดการความเสี่ยง AI แบบสมัครใจและการมองความเสี่ยงตลอดวงจรชีวิต
- NIST AIRC — AI RMF Core: ฟังก์ชัน Govern, Map, Measure และ Manage; หน้า AIRC ระบุว่า AI RMF 1.0 อยู่ระหว่างการปรับปรุง
- NIST AI 600-1 — Generative AI Profile: ความเสี่ยงและการจัดการระบบ Generative AI ข้ามอุตสาหกรรม
- OECD AI Principles: หลัก Human Rights, Fairness, Privacy, Transparency, Robustness, Safety และ Accountability; หลักการปรับปรุงในปี 2024
- UNESCO — Recommendation on the Ethics of Artificial Intelligence: กรอบสิทธิมนุษยชน ศักดิ์ศรี การกำกับดูแล ผลกระทบ และ Human Oversight ตลอดวงจรชีวิต
- OWASP GenAI Security Project — LLM01:2025 Prompt Injection: Prompt Injection แบบตรงและแบบอ้อม ผลกระทบ และแนวทางลดความเสี่ยง เช่น จำกัดสิทธิ์ แยกข้อมูลภายนอก และขอ Human Approval สำหรับการกระทำเสี่ยงสูง
ตรวจข้อมูลล่าสุด: 9 สิงหาคม 2026 · กรณีสหกรณ์และตัวเลขเกณฑ์ต่าง ๆ ในบทเรียนเป็นสถานการณ์สมมติเพื่ออธิบายวิธีคิด ไม่ใช่ผลทดสอบจริง ไม่ใช่คำแนะนำทางการเงิน กฎหมาย ความปลอดภัยไซเบอร์ หรือการรับรองระบบสำหรับองค์กรใด
